· 强化学习 / 多智能体 / COMA / 反事实优势 / 信用分配
Day11 · COMA:从团队奖励到个体反事实优势
这一天解决的问题
“评价为负,但是不能归因为是谁失败了。”前面讨论共同奖励时,这个疑问已经出现:两个人共同完成一件事,环境只给一个分数,训练时该怎样分别评价他们的选择?
Day11 用 COMA,也就是 Counterfactual Multi-Agent Policy Gradients,把这个问题接到真实训练中。集中式 Critic 学习联合动作的价值;评价某个人时,固定队友当前动作,比较本人各个候选动作,再把相对评价交给局部 Actor。[1]
本课的实跑是一局一步的双人合作游戏。它保留了候选 Q、反事实参照、实际动作监督和策略更新;多步 TD(λ)、目标 Critic 与序列边界放在第9节,作为课堂扩展说明。
1. 一个团队奖励,可以对应两种个人评价
两名智能体同时选择动作 0 或 1,执行后得到一份共同奖励,随后真正终止:
| 智能体0的动作 | 智能体1选0 | 智能体1选1 |
|---|---|---|
| 0 | 4 | 0 |
| 1 | 6 | 10 |
最优组合是 (1,1),奖励为10。两名 Actor 只接收自己的常量观测 [1],没有队友动作、隐藏提示或消息通道。常量1表示同一个固定场景,不是奖励或正确答案;两份网络的参数独立。
环境内部保存奖励规则,但 Critic 训练时只能读取实际动作取得的奖励:
def step(self, actions):
    assert not self.finished
    rewards = self._payoffs[actions[:, 0], actions[:, 1]].clone()
    self.finished = True
    self.environment_steps += self.batch_size
    return rewards, torch.ones(self.batch_size, dtype=torch.bool)
这里 actions 为 [B,2],一行属于两人同一次共同经历;rewards 为 [B],每局只有一份团队奖励。真正终止后,要先重置再开始下一局。
Q 是动作价值:在给定状态执行某个联合动作,后续按双方策略行动,预计取得多少折扣团队回报。本游戏一步就终止,所以准确 Q 恰好等于奖励表;网络的预测值则需要从经验中学习。
设本次实际联合动作为 (1,0),团队取得6。如果两名 Actor 目前都以 0.5/0.5 选择动作,分别评价时会得到:
| 评价谁 | 固定队友什么动作 | 本人选0/选1的准确 Q | 本人的平均参照 | 实际动作的优势 |
|---|---|---|---|---|
| 智能体0 | 智能体1选0 | [4,6] |
5 | 6−5=+1 |
| 智能体1 | 智能体0选1 | [6,10] |
8 | 6−8=−2 |
智能体0这次选1,比自己改选0好;智能体1这次选0,比自己改选1差。因此,同一个团队结果可以给两人相反的相对评价。优势不是奖励分账,两份优势也不要求加起来等于6。
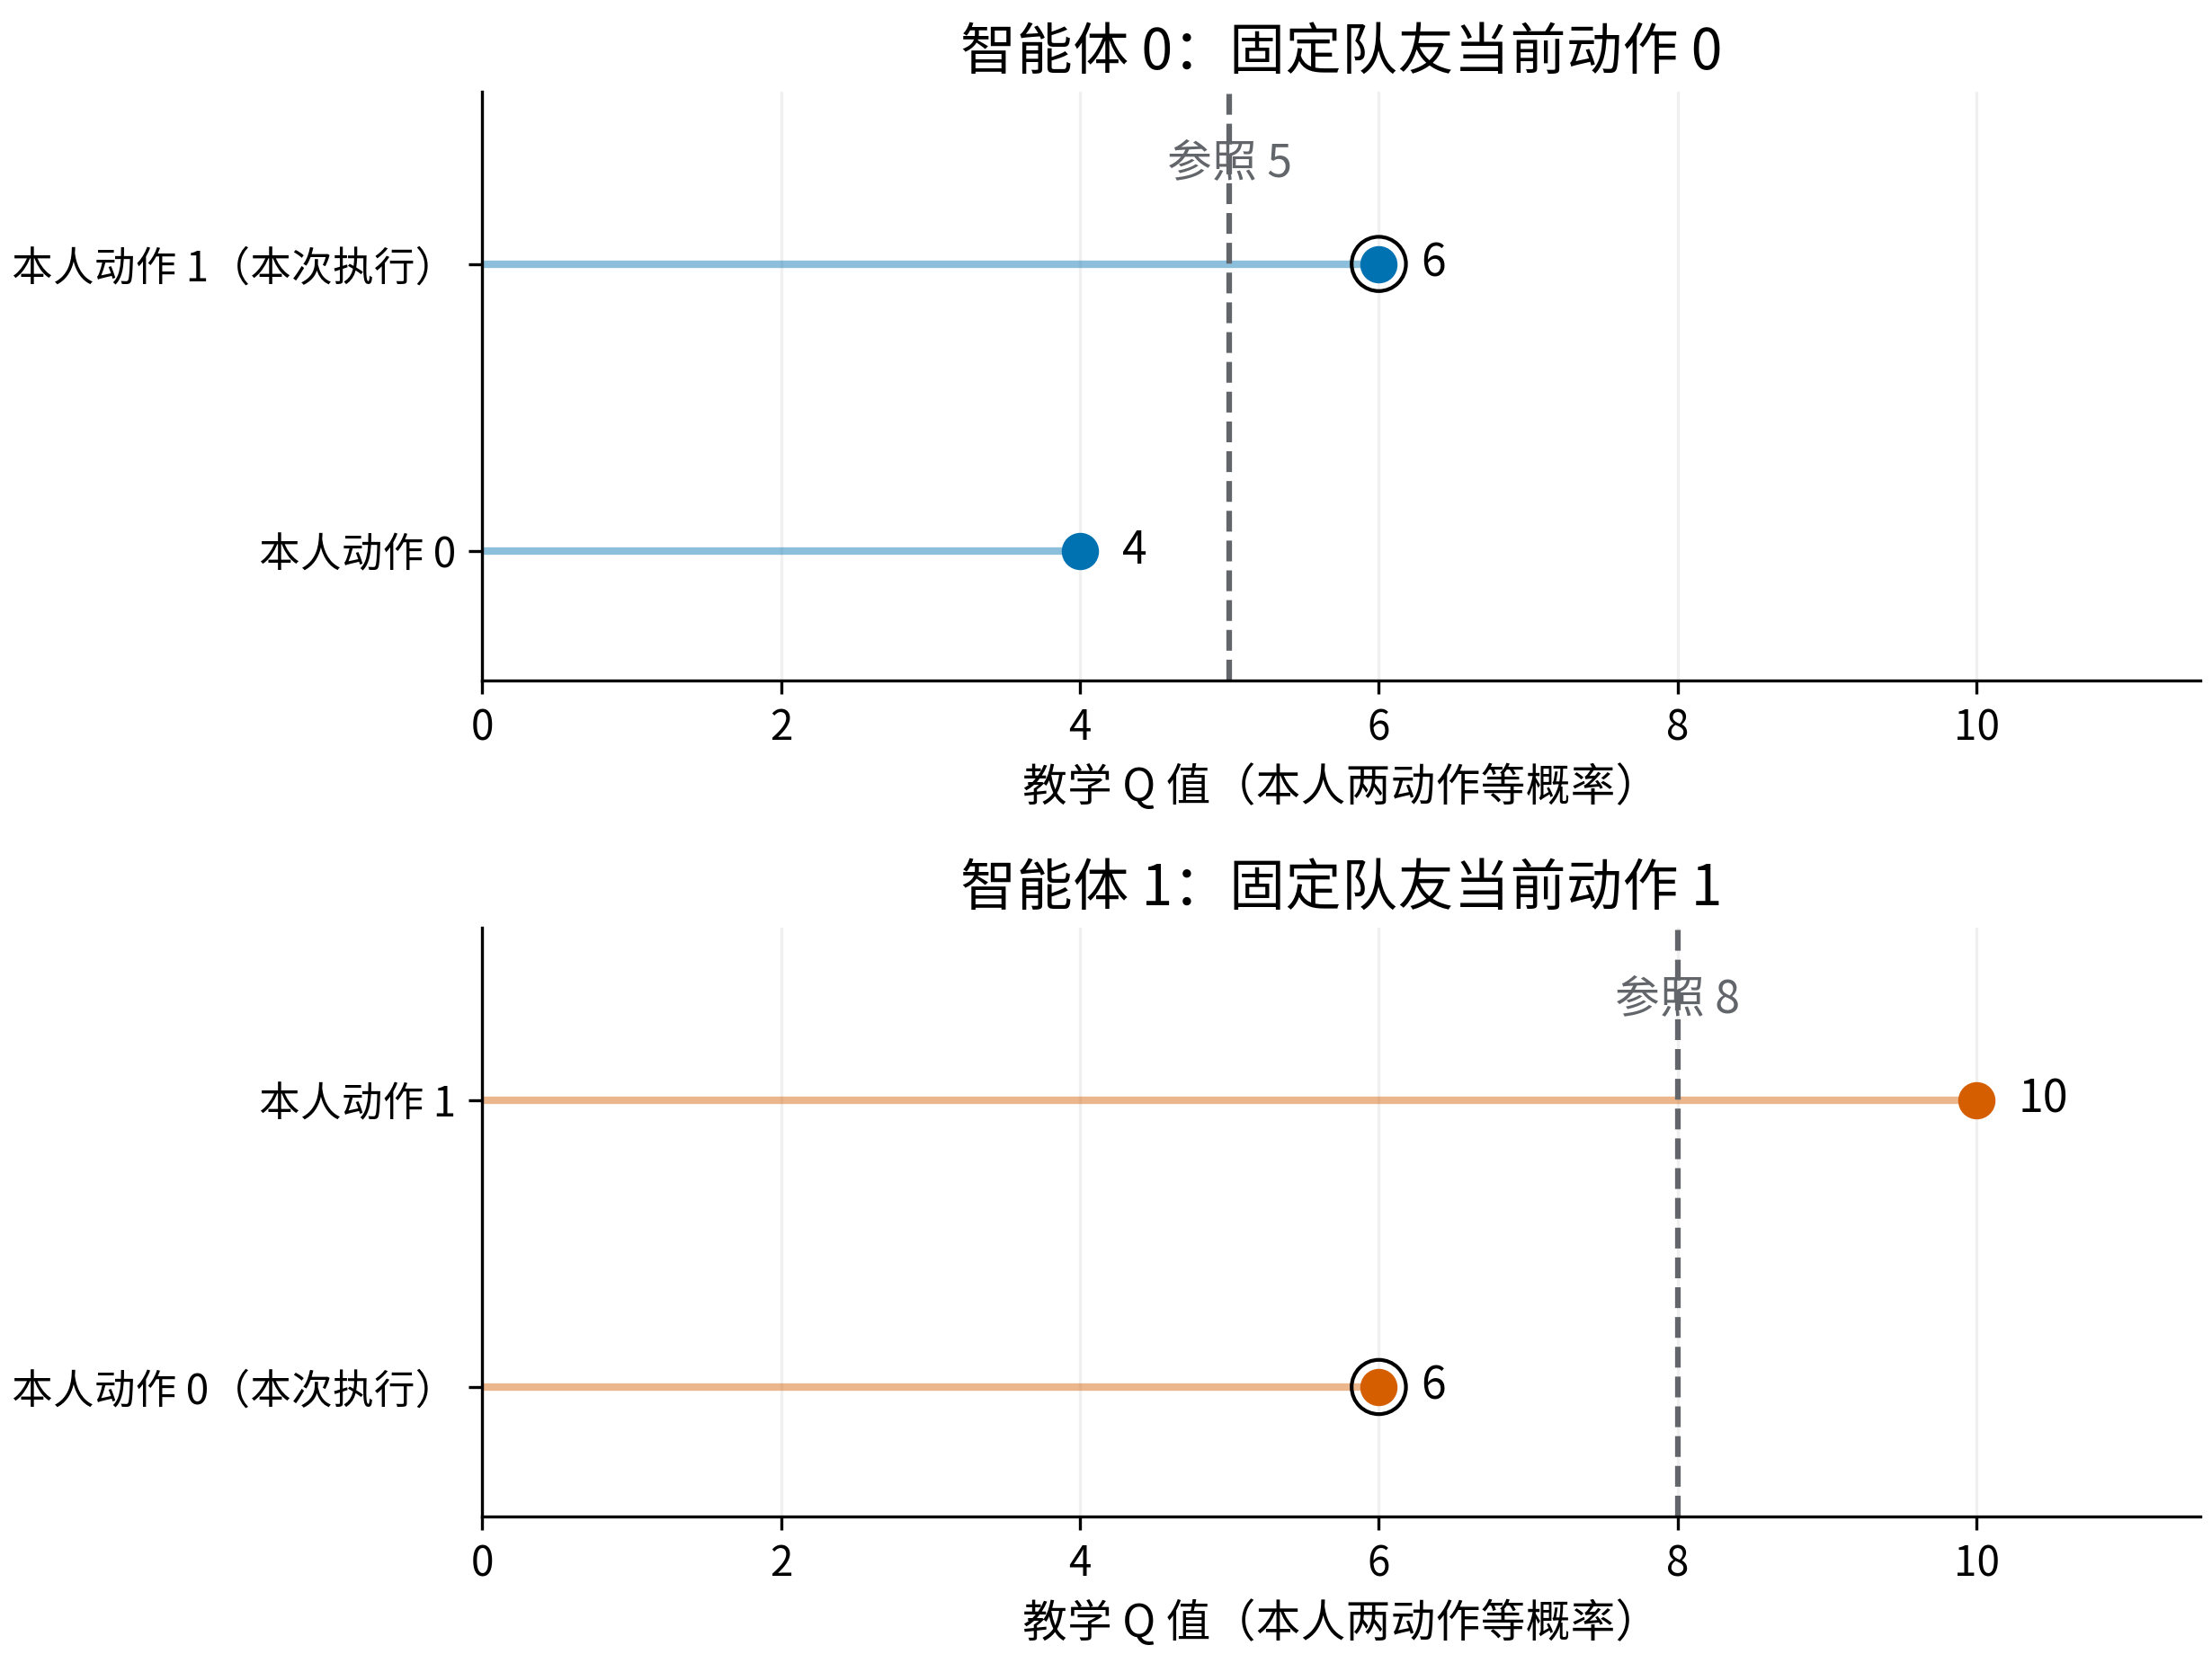
图中使用奖励规则对应的准确 Q 作教学计算。虚线是本人两动作等概率时的平均参照;黑圈都位于实际联合组合 (1,0),但一个在参照右侧,一个在左侧。
2. 反事实参照:固定队友,平均本人可能的选择
用 u 表示当前联合动作,u_-i 表示除本人以外的队友当前动作,τ_i 表示本人可见历史。COMA 为每名智能体计算:
第一式把本人的候选动作逐个换进去,按照本人当前策略概率加权;第二式再比较实际动作与这个参照。[1] 本文的两动作案例可以直接读成:
baseline = p0 * q_if_action0 + p1 * q_if_action1
advantage = q_of_actual_action - baseline
取平均是为了描述“本人按照当前策略行动,通常能达到什么水平”。如果改成最大 Q,参照就变成“本人能做出的最佳选择”,两者含义不同。
例如,智能体0以 [0.2,0.8] 选择动作,队友本次选0,候选 Q 仍是 [4,6]。参照变成 0.2×4+0.8×6=5.6;实际选1的优势是 +0.4。奖励6没有变,优势变小来自策略平均水平提高。
固定状态、队友动作和本人策略后,按本人策略加权的优势均值为0。策略仍能学习,因为更新使用的是“优势乘动作对数概率的梯度”。另设候选 Q 为 [9,2]、本人等概率,两动作优势为 [+3.5,−3.5]:选0时鼓励0,选1时抑制1,两种反馈都偏向动作0。
3. 局部 Actor:只从自己的输入产生动作概率
下面的代码共用这些导入,CPU 即可运行本例:
import torch
from torch import nn
from torch.nn import functional as F
from torch.distributions import Categorical
本例用两个独立线性层作为 Actor,输入维度1,输出两个动作得分:
def make_actors():
    actors = nn.ModuleList([nn.Linear(1, 2), nn.Linear(1, 2)])
    for actor in actors:
        nn.init.zeros_(actor.weight)
        nn.init.zeros_(actor.bias)
    return actors
零初始化让两个动作初始得分相同,经过 softmax 后各为0.5。这里没有预先写入最优动作。
两名 Actor 分别接收本人的观测,再把输出按角色堆叠:
def policy_probs(actors, obs):
    return torch.stack([
        actor(obs[:, i]).softmax(dim=-1)
        for i, actor in enumerate(actors)
    ], dim=1)
obs 为 [B,2,1],probs 为 [B,2,2]。前一个2表示两名智能体,最后一个2表示本人的两个动作。
两个人观测相同,仍可因独立参数而形成不同策略。如果换成共享 Actor,相同参数与相同输入会得到相同动作分布;需要角色分工时,应检查可见观测、角色标识或历史能否区分角色。分布相同也不要求每次随机抽到的动作相同。
4. 共享 Critic:一次输出本人的所有候选 Q
本例 Critic 对每名被评价者输出两个数,对应“本人选0”和“本人选1”的预计团队回报。每个角色的输入共有7项:
| 输入部分 | 项数 | 内容 |
|---|---|---|
| 全局状态 | 1 | 固定场景 [1] |
| 智能体0动作槽 | 2 | 本人时清零,队友时保留独热编码 |
| 智能体1动作槽 | 2 | 同上 |
| 角色标识 | 2 | [1,0] 或 [0,1],说明正在评价谁 |
动作0编码为 [1,0],动作1编码为 [0,1];被屏蔽的 [0,0] 表示这组动作槽不作为输入。
因此,实际动作 (1,0) 会形成:
排列:状态 | 智能体0动作槽 | 智能体1动作槽 | 角色标识
评价0:[1 |     0,0      |     1,0      | 1,0]
       输出 [Q(0,0), Q(1,0)]
评价1:[1 |     0,1      |     0,0      | 0,1]
       输出 [Q(1,0), Q(1,1)]
网络结构是 7 → 32 → 32 → 2,中间使用 ReLU。下面摘取输入构造,self.teammate_mask 按“被评价者、动作所属者、独热位置”排列,对角线位置为0:
joint_onehot = F.one_hot(actions, num_classes=2).float()
masked = joint_onehot[:, None] * self.teammate_mask[None]
inputs = torch.cat([
    states[:, None].expand(-1, 2, -1),
    masked.reshape(batch_size, 2, 4),
    self.agent_ids[None].expand(batch_size, -1, -1),
], dim=-1)
q_all = self.net(inputs)
q_all 为 [B,N,A],本例中 N=2、A=2。同一个共享网络按角色处理两组输入,角色标识使它分清表中的行角色与列角色。[2]
屏蔽本人动作适用于当前“同时输出本人全部候选值”的结构。另一种合法设计是输入完整联合动作、只输出一个标量 Q,再逐次替换本人动作进行枚举;两种表示都要保证每个候选值对应正确的联合动作。
5. 共同采样:只保存真正发生的动作与奖励
每批开始前,两名 Actor 参数固定,重新收集128个共同回合:
@torch.no_grad()
def collect_batch(env, actors, batch_size, generator):
    states, obs = env.reset(batch_size)
    probs = policy_probs(actors, obs)
    actions = torch.multinomial(
        probs.reshape(-1, 2), 1, generator=generator
    ).reshape(batch_size, 2)
    rewards, terminated = env.step(actions)
    return dict(states=states, obs=obs, actions=actions,
                rewards=rewards, terminated=terminated)
reshape(-1,2) 暂时把所有人的两动作分布排成一列,分别采样后再还原为 [B,2]。同一行的状态、观测、动作与奖励始终属于同一个共同回合。
采样阶段用 no_grad() 节省计算图;训练 Actor 时再根据相同观测重新计算概率。更新时使用的仍然是本批实际动作,不能重新抽动作后继续配原来的奖励。
Critic 也没有直接读取环境中的四格奖励表。它通过采到不同联合动作,逐渐取得这些组合对应的训练经验。训练后枚举奖励规则用于评估,是另一个独立步骤。
6. Critic 更新:监督实际输出,学习 Q 的数值
每名智能体有两个候选 Q,但一条经历只实际执行其中一个。先用动作下标取出对应值:
def selected_q(q_all, actions):
    return q_all.gather(-1, actions.unsqueeze(-1)).squeeze(-1)
actions.unsqueeze(-1) 把索引从 [B,2] 变成 [B,2,1],gather(-1,...) 沿本人动作轴取值,再压回 [B,2]。[3] 实际动作 (1,0) 会分别取第一个角色的动作1项、第二个角色的动作0项。
本环境一步真正终止,所以实际奖励就是回报目标。下面是 Critic 拟合的核心:
targets = batch["rewards"][:, None].expand(-1, 2)
q_all = critic(batch["states"], batch["actions"])
q_taken = selected_q(q_all, batch["actions"])
loss = (q_taken - targets).square().mean()
optimizer.zero_grad()
loss.backward()
optimizer.step()
原练习在 step() 前还对梯度范数做上限10的裁剪;上面省略该行以集中观察目标和预测。每批 Critic 拟合8次,这是本例配置。
实际奖励6复制成 [6,6],让两份角色视角的预测拟合同一个团队结果;奖励没有加倍。.mean() 对本批所有所选预测的平方误差取平均。
未执行动作没有这条样本的直接标签。如果只执行 (1,0) 得到6,不能同时把 (0,0) 的 Q 目标也设成6。共享参数更新可能顺带改变其他输出,但与给它们贴上相同标签是两回事。
7. Actor 更新:评分固定,概率保留梯度
Critic 拟合后,重新计算候选 Q 和反事实优势:
def actor_terms(actors, critic, batch):
    probs = policy_probs(actors, batch["obs"])
    with torch.no_grad():
        q_all = critic(batch["states"], batch["actions"])
        q_taken = selected_q(q_all, batch["actions"])
        baseline = (probs * q_all).sum(dim=-1)
        advantages = q_taken - baseline
    dist = Categorical(probs=probs)
    policy_loss = -(dist.log_prob(batch["actions"]) * advantages).mean()
    entropy = dist.entropy().mean()
    loss = policy_loss - entropy_coef * entropy
    return loss, policy_loss, entropy, advantages
probs 在 no_grad() 外计算,保留通向 Actor 参数的路径;块内新算出的 Q、参照和优势不连接梯度。退出代码块后,log_prob 继续使用那份保留计算图的概率。[3]
Actor 的训练路径是:
Actor 参数 → 动作概率 → 实际动作的 log_prob → 策略损失
优势作为本次更新的固定权重。正优势使该样本的梯度倾向于提高实际动作概率,负优势则倾向于降低;整批样本、熵项和优化器共同决定最终变化。
如果把 probs = policy_probs(...) 也移入 no_grad(),前向计算就不再建立回到 Actor 参数的路径。单独对这份损失调用 backward() 会因缺少计算图而报错;之后退出 no_grad() 也不会自动补回前面的连接。
Critic 用自己的平方误差训练。本例 Actor、Critic 参数独立,Actor loss 不会顺着评分分支更新 Critic。entropy_coef=0.01 另行鼓励探索,它不指定哪个动作更好。
训练后的真实网络重新评价 (1,0),得到以下值:
| 被评价者 | 本人选0/选1的预测 Q | 当前策略参照 | 实际动作优势 |
|---|---|---|---|
| 智能体0,实际选1 | [4.142062,5.992597] |
5.983436 | +0.009161 |
| 智能体1,实际选0 | [5.999420,9.987890] |
9.974158 | −3.974739 |
两份实际 Q 接近同一个真实奖励6,稍有不同来自网络近似。智能体0选1的概率已约为0.99505,参照几乎等于选1的价值,所以正优势很小。对两动作情形,实际选1时,优势可写成 p(0)×(Q(1)−Q(0));小优势反映当前策略已经经常选择这个好动作。
智能体1平时几乎都选1,此次罕见选0,明显低于自身平均表现,因此得到较大的负优势。两种评分依旧在各自固定队友动作的条件下计算。
8. Actor 看不到队友,怎样利用这种评分
Critic 在训练中能够按队友动作给出条件评价;局部 Actor 的能力取决于自己的可见信息。相同局部输入下,它学习的是不同队友情境中的平均表现。
仍用准确奖励规则手算,先设智能体1的本人策略等概率。如果它实际选0:
| 智能体0本次动作 | 智能体1的候选 Q | 参照 | 智能体1动作0的优势 |
|---|---|---|---|
| 0 | [4,0] |
2 | +2 |
| 1 | [6,10] |
8 | −2 |
两个条件评分都成立。智能体1的常量观测无法区分队友本次选了什么,所以会把这些样本提供的策略梯度汇总到同一个局部策略中。
设智能体0选择动作1的概率为 p,智能体1两种动作的平均收益分别为:
当 p=0.5 时,两种平均收益均为5;当 p=0.8 时,分别为5.6、8,动作1开始具有明确的平均收益优势。这里0.5和0.8是用于解释机制的教学概率。
智能体0自己有稳定的改进方向:队友选0时,选1得6比选0得4好;队友选1时,选1得10也比选0得0好。随着它更常选1,智能体1面对的队友分布随之变化,双方可以逐步形成 (1,1) 的共同选择。
训练评价没有给局部观测增加本局不可见信息。若任务必须依据对方每局新抽的随机提示行动,需要补充观测或通信;若信息曾经看过、后来消失,GRU 可以保留历史。COMA 的职责是构造个体训练评价。
和前面几天的练习对照:
| 方法 | 训练中的主要评价 | 执行方式 |
|---|---|---|
| 本系列 MAPPO 练习 | 集中式 V、GAE、逐角色 PPO;具体练习共用团队优势 | 各自运行局部 Actor |
| QMIX | 局部 utility 经单调 Mixer 得到团队 Q,拟合同一团队 TD 目标 | 各自选择局部 utility 最大的动作 |
| MADDPG | 集中式 Q 对本人连续动作求梯度,更新局部 Actor | 各自运行局部 Actor |
| COMA | 集中式候选 Q,减去本人策略加权的反事实参照 | 各自运行局部 Actor |
局部 utility、团队 Q、反事实优势与环境奖励各有含义,不能互相当作同一个量。COMA 的反事实优势也不要求使用 QMIX 的单调混合形式。
9. 多步扩展:时间目标和个体优势分别计算
本节把单步评分接到课堂讲过的多步回报。另设一条两步轨迹:第一步奖励0,第二步奖励10后真正终止,折扣率为0.9。
该轨迹给出的首步完整回报为9;假设目标 Critic 对下一状态、采样策略实际下一联合动作估值为8,一步目标为7.2。取 λ=0.5,混合目标为:
8.1是 Critic 拟合的回报目标。Actor 的优势仍然要用当前实际动作 Q 减去本人反事实参照,不能直接拿8.1当作优势。下一步按策略采样的联合动作,也不能换成 DQN 的联合动作最大值。[1]
对长度为 T 的一条轨迹,目标可以从末尾反向递推:
d_t=1 表示本步之后真正终止,Q̄ 由目标 Critic 提供。下面是课堂递推的可运行片段:单条非空轨迹、没有 padding;rewards、next_q 均为 [T],terminated 为 [T] 布尔张量。next_q[t] 对应下一状态、下一实际联合动作的预测:
@torch.no_grad()
def td_lambda_targets(rewards, next_q, terminated, gamma=0.9, lam=0.5):
    targets = torch.zeros_like(rewards)
    carry = next_q[-1].clone()
    for t in reversed(range(len(rewards))):
        if bool(terminated[t]):
            carry = rewards[t]
        else:
            carry = rewards[t] + gamma * (
                (1 - lam) * next_q[t] + lam * carry
            )
        targets[t] = carry
    return targets
完整终止轨迹的最后一步会直接使用真实奖励,末尾预测不会进入目标。若取的是未终止片段,next_q[-1] 必须来自合法的边界后续估值;它同时初始化 carry,使片段没有被误当成终点。
对 rewards=[0,10]、next_q=[8,0]、terminated=[False,True],结果为 [8.1,10];λ取0或1时,首步分别为7.2和9。再设三步奖励 [0,0,10],前两处下一预测为6、8,结果为 [6.345,8.1,10]。这些数值是独立教学核算。
实际批次还要处理:
- 真正终止步本身参与损失,只去掉它之后的未来价值。
- 变长回合的 padding 不参与损失,不能把下一局的值接进上一局。
- 循环 Actor 训练时按本人真实历史重建 hidden,保持时间顺序。
- 目标 Critic 按约定定期复制当前参数;Actor 更新后重新采样,保持策略评价与数据分布的关系。
比较候选动作时,固定的是队友同一时刻的动作。本人换动作可能改变之后的状态,后续双方也可能响应;不能锁死整条未来轨迹,再把原未来奖励复制给所有备选动作。
10. 完整训练与冻结评估:如何读这次结果
单步练习的外层循环如下,省略打印和曲线记录:
for update in range(1, num_updates + 1):
    batch = collect_batch(
        train_env, actors, episodes_per_batch, train_generator,
    )
    critic_mse = fit_critic(critic, critic_optimizer, batch)
    actor_log = update_actors(
        actors, critic, actor_optimizer, batch,
    )
每批先采样,Critic 拟合8次,两个 Actor 联合更新1次,再重新收集数据。Critic 更新期间 Actor 参数独立且保持不变,因此更新前重新计算的概率仍对应采样策略。Actor 若在旧批次上反复变化,需要另外处理策略分布不一致,不能直接照搬这里的拟合次数。
| 配置或计数 | 本次取值 |
|---|---|
| 随机种子 | 7 |
| 每批共同回合 / 新采样批次 | 128 / 400 |
| Critic 隐藏层宽度 | 32 |
| Actor / Critic 学习率 | 0.01 / 0.01 |
| 熵系数 / 梯度范数上限 | 0.01 / 10 |
| 训练共同回合 / 共同环境步 | 51200 / 51200 |
| 个体动作总数 | 102400 |
| Actor 联合更新 / Critic 更新 | 400 / 3200 |
当前 Notebook 保存输出为 CPU、PyTorch 2.10.0+cu128;同源代码在 CPU、PyTorch 2.11.0+cpu 的新内核复跑,下面的数值摘要一致。训练曲线来自这次新内核执行的完整历史。
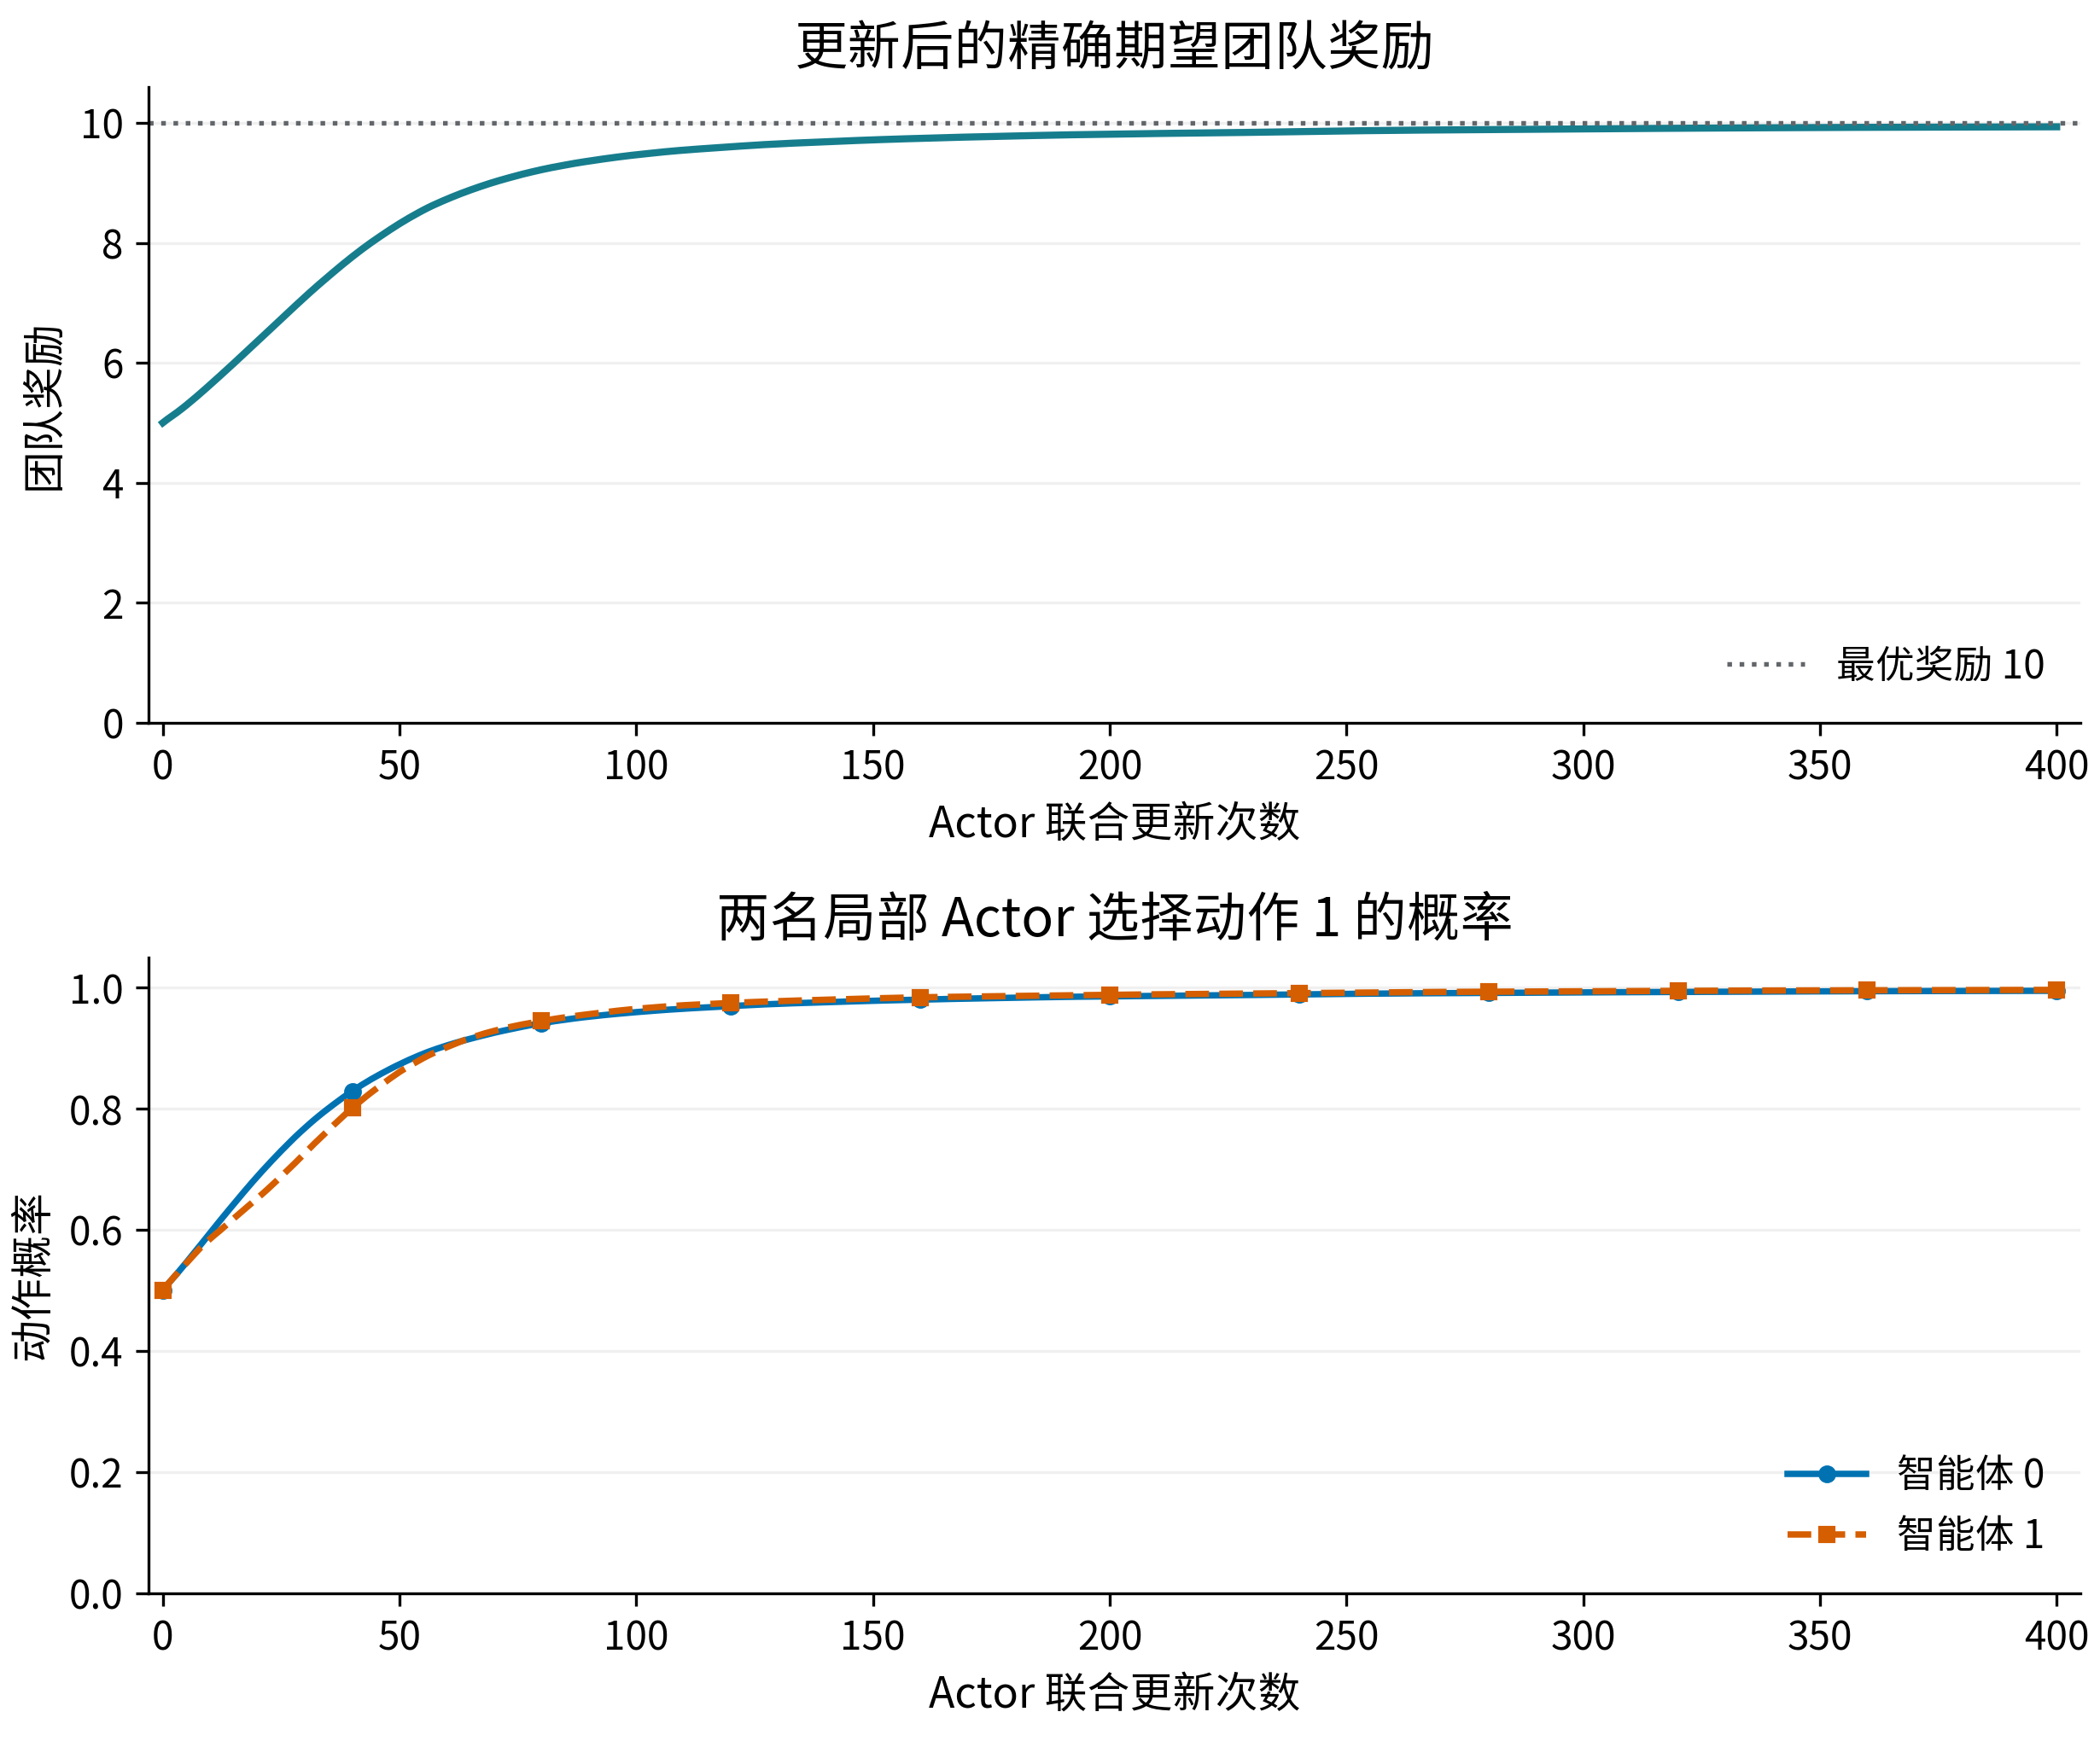
上图每个点都对应更新后的策略,精确期望由四种联合动作概率与奖励加权得出。下图是两名 Actor 的动作概率;一条默认种子的曲线没有跨种子误差带。
训练后的结果为:
| 指标 | 数值 |
|---|---|
| 精确期望团队奖励 | 5.0000 → 9.936864 |
最优组合 (1,1) 的概率 |
0.2500 → 0.991624 |
| 智能体0 / 智能体1选1概率 | 0.995050 / 0.996557 |
| 冻结采样取得最优组合 | 990/1000 |
| 冻结采样平均奖励 | 9.9180 |
| 贪心实际执行 | (1,1),奖励10,真正终止 |
| 执行阶段 Critic 调用次数 | 0 |
本例的精确期望计算可以写成:
\[J=4\,\pi_0(0)\pi_1(0) +6\,\pi_0(1)\pi_1(0) +10\,\pi_0(1)\pi_1(1).\]联合组合 (0,1) 的奖励为0,因而没有对应的非零项。实际代码用独立环境枚举奖励,只在评估时求和:
weights = probs[0, joint_cases[:, 0]] * probs[1, joint_cases[:, 1]]
env = MatrixTeamEnv()
env.reset(4)
rewards, _ = env.step(joint_cases)
expected_return = (weights * rewards).sum().item()
冻结执行接口只接收 Actor 和局部观测:
@torch.no_grad()
def decentralized_actions(actors, obs, generator=None, greedy=False):
    probs = policy_probs(actors, obs)
    if greedy:
        return probs.argmax(dim=-1)
    return torch.multinomial(
        probs.reshape(-1, 2), 1, generator=generator
    ).reshape(len(obs), 2)
随机评估按概率抽动作,仍可能出现非最优组合;贪心评估每次选当前概率最大的动作。两者使用不同决策方式,有限样本均值也与精确期望不同。评估保持参数固定,且真实执行到终止。
最后单独检查 Critic。四种组合的训练访问次数为 [703,2184,2226,46087],最近样本大多集中于 (1,1)。最后一批实际动作 MSE 约为0.000128,逐个审查全部组合时,两份角色预测的最大绝对误差仍约为0.1421、0.2306。
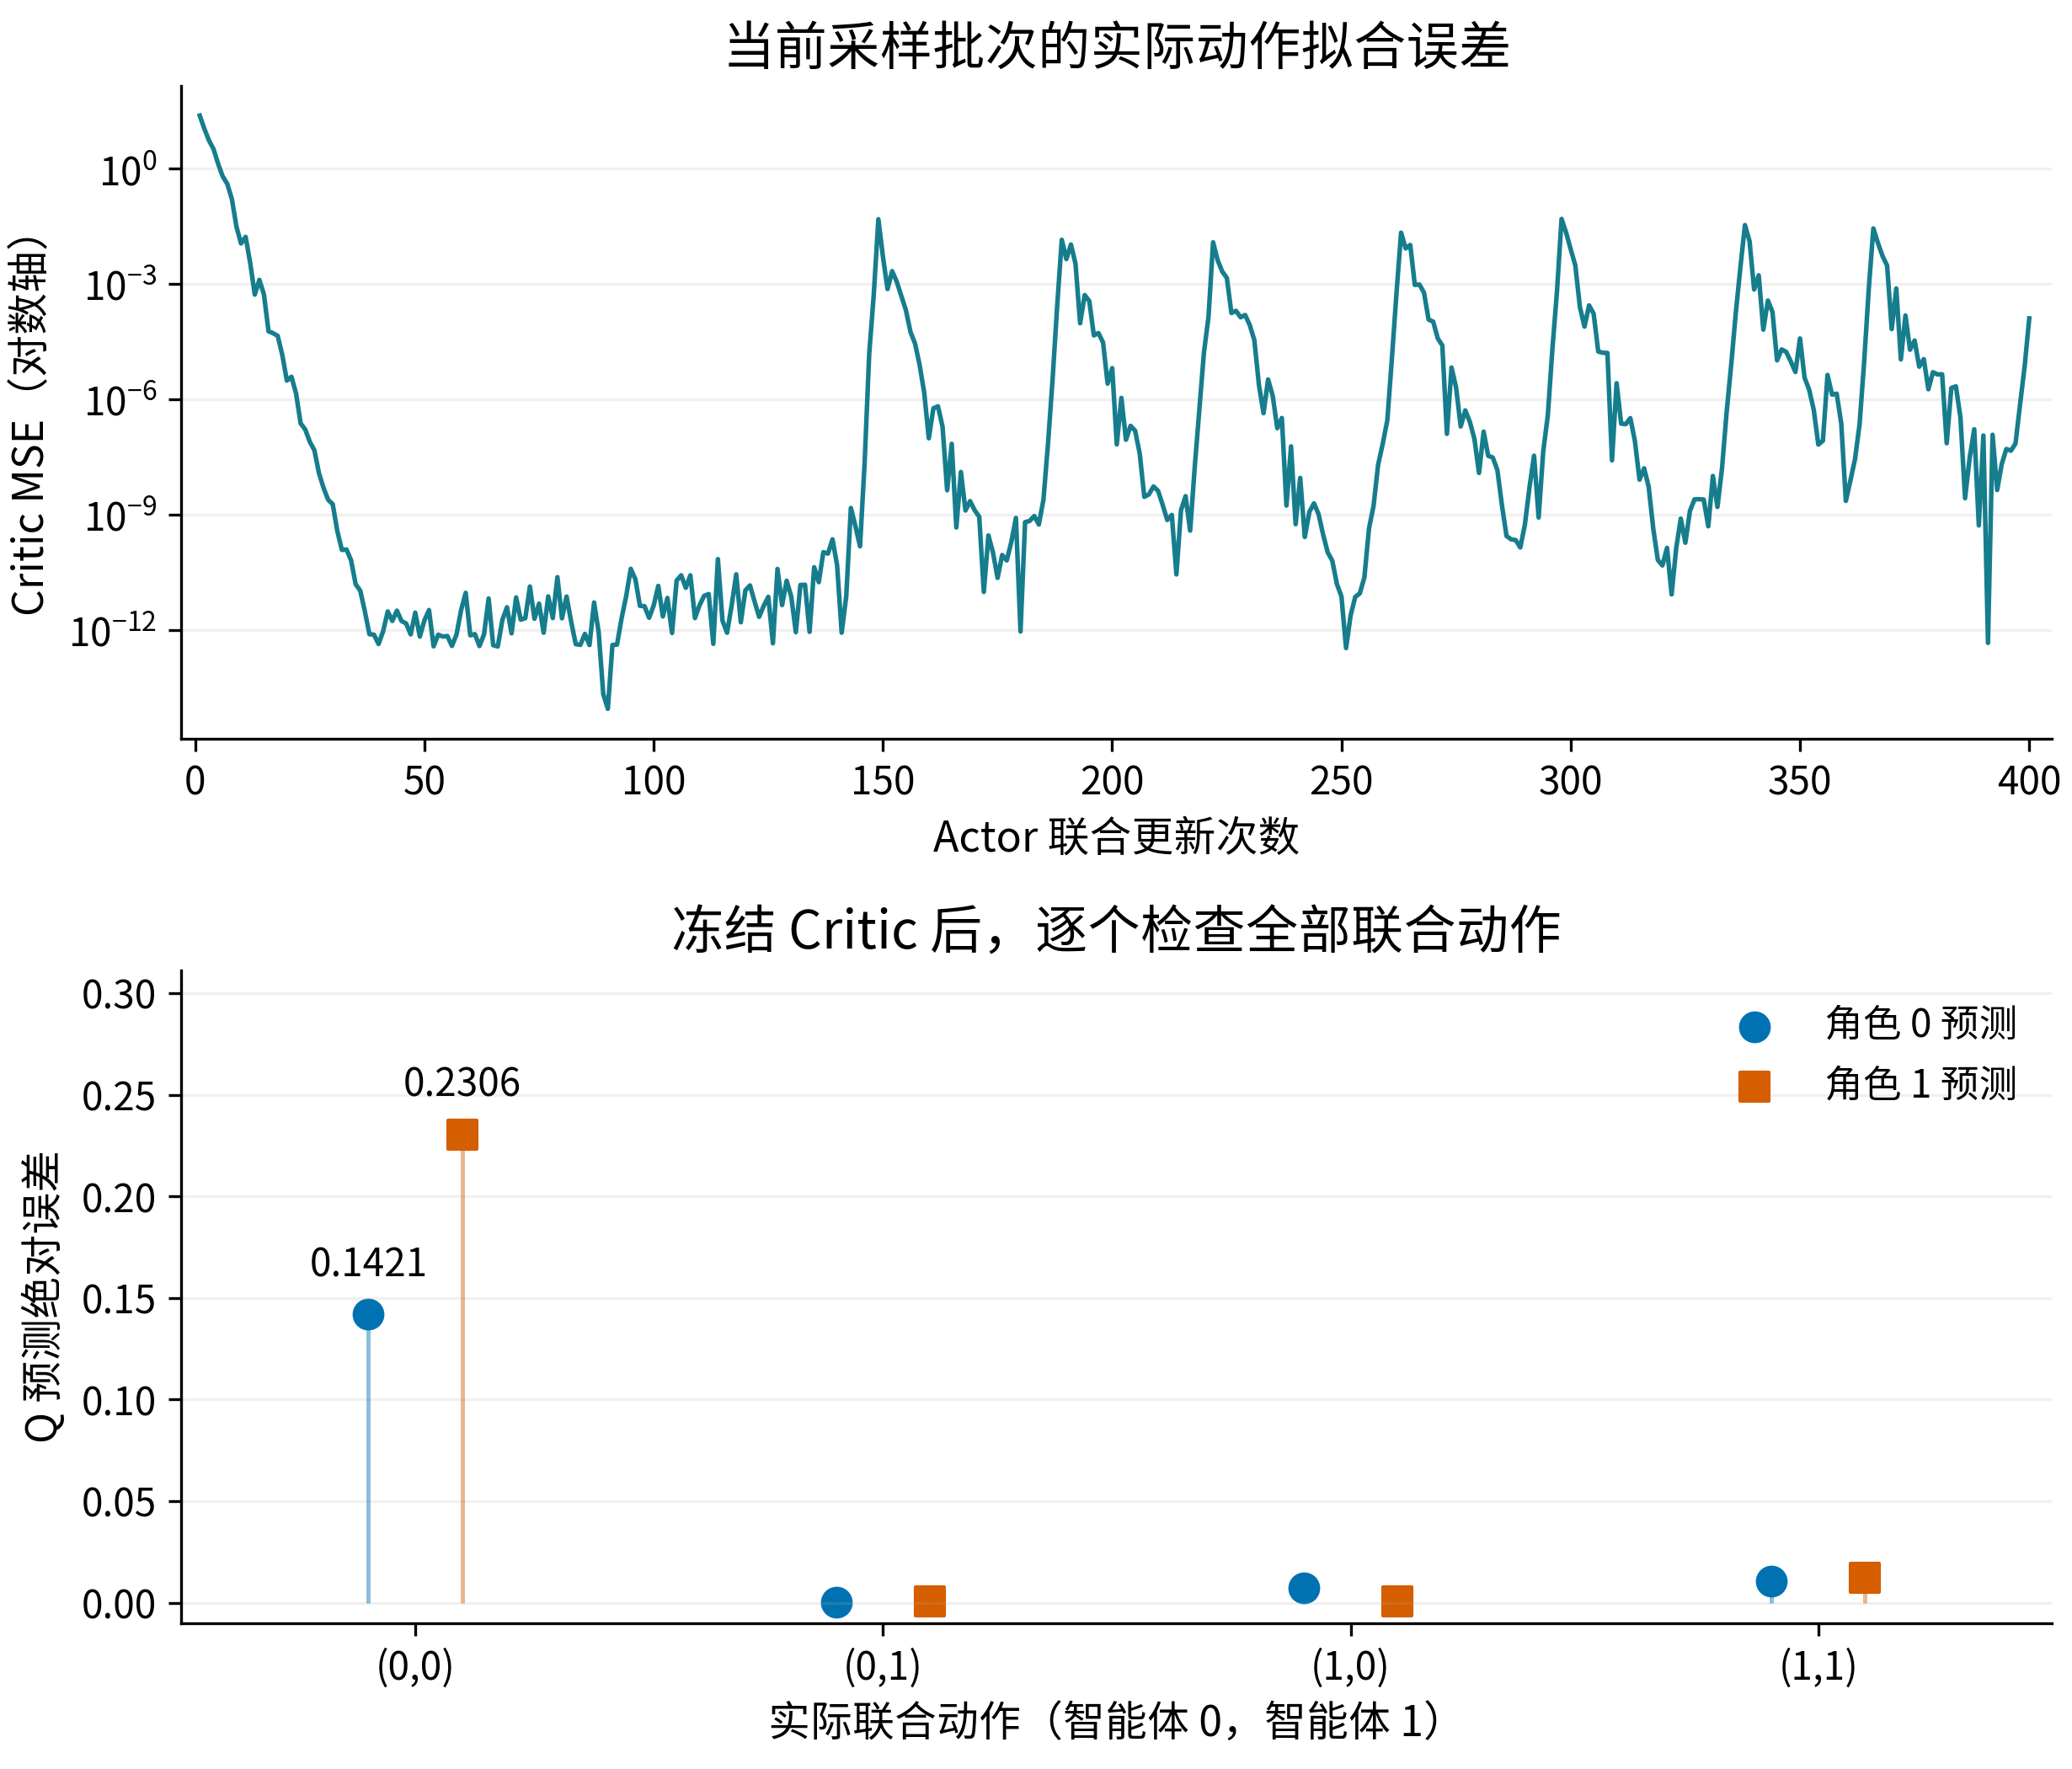
上图的尖峰是不同批次真实记录的损失变化,不能只凭尖峰判断策略退步。下图展示每个组合的误差原始点:两种统计覆盖的动作分布不同,均方误差与最大绝对误差的量纲也不同。当前批次拟合得好,并不等于用于反事实比较的所有候选值都同样准确。
这次训练把共同奖励转成了两类学习依据:Critic 从实际经历学习联合动作价值,Actor 从固定队友情境下的相对价值调整自己的选择。策略最终高概率选择 (1,1),执行时各自依靠局部网络。
参考资料
- Foerster et al. Counterfactual Multi-Agent Policy Gradients,第3节的回报目标与第4节的反事实优势。
- 原作者 PyMARL:COMA Critic、COMA learner、TD(λ) 工具函数。
- PyTorch:gather、no_grad、Score function / REINFORCE。