· 强化学习 / 多智能体 / GRU / PPO / 序列训练
Day9 · 记住消失的提示:循环 Actor 与完整序列训练
这一天解决的问题
前面的多智能体练习主要处理“当前观测能不能支持当前动作”。这次把问题往前推一步:
如果提示只在回合开头出现,真正行动时已经看不见了,Actor 还能不能根据这段历史做出正确选择?
任务专门制造了一个信息间隔。两名智能体分别在开头看到自己的 0/1 提示,提示 0 对应左门,提示 1 对应右门。之后提示消失,前三个时间步只能等待,第四个时间步才允许选门。两个人都选中各自提示对应的门,团队奖励为 1,否则为 0。
这次练习把前面几天的内容接到了一起:
局部观测
    -> GRU 记忆
    -> 最后一步动作概率
    -> PPO / GAE 训练
    -> 分散执行
重点不在于把网络换成 GRU,而在于理解四个边界:
- 网络参数保存跨回合学到的规律,
hidden保存当前回合的历史。 - 同一回合要按时间顺序传递
hidden,新回合开始前要重置。 - 只清空
hidden会丢失信息;detach会保留数值、截断梯度。 - 训练时可以打乱不同回合的顺序,但不能打乱同一回合内部的时间顺序。
1. 任务为什么必须隐藏提示
如果选门时提示仍然可见,普通 MLP 直接读取当前提示就能完成任务,无法说明它记住了过去。
环境故意把末步观测统一成相同形式:
[提示是否可见, 提示编码, 当前阶段]

t=0: [1, -1 或 +1, 0]
t=1: [0,  0,      1/3]
t=2: [0,  0,      2/3]
t=3: [0,  0,      1]
最后一步时,四种提示组合对应的局部观测完全相同。只看当前观测的网络无法知道本局开头见过 0 还是 1。在四种提示等概率的条件下,它平均只能达到 1/4 的双人精确成功概率。
这也是为什么中间需要等待。等待不是 PPO 或 GRU 的固定要求,而是人为设置的记忆间隔:
t=0 看到提示并等待
t=1 提示消失,继续等待
t=2 提示消失,继续等待
t=3 根据记忆选门
如果只安排“看提示并等待一次,再马上选择”,也能检查记忆。当前多放两步,是为了让提示经历多次隐藏状态更新,观察网络能否把它保留到最后。
2. 环境:共同奖励只在真实终止步产生
动作编号是:
LEFT, RIGHT, WAIT = 0, 1, 2
环境只在最后一步开放左右门,前三步只能等待。下面摘取 step 的奖励和终止逻辑,省略环境初始化与合法动作检查;奖励依赖两名智能体是否同时选对:
def step(self, actions):
    assert actions.shape == self.cues.shape

    reward = torch.zeros(self.batch_size)
    if self.phase == horizon - 1:
        # 两个人都选中自己的提示对应的门,团队奖励才为 1。
        reward = (actions == self.cues).all(dim=-1).float()

    self.phase += 1
    self.finished = self.phase == horizon
    terminated = torch.full(
        (self.batch_size,), self.finished, dtype=torch.bool,
    )
    return reward, terminated
这里的 actions 形状是 [B, 2]:
B是并行回合数;2是两名智能体;actions == self.cues先分别判断两个人是否选对;.all(dim=-1)再判断这一局是否两个人都选对。
前三步的奖励是 0,最后一步的奖励是 0 或 1。最后一步之后才是真正终止,所以最后一步仍然是有效训练样本。
3. 局部观测和集中式状态
每名 Actor 只看自己的局部观测,Critic 在训练时可以看到集中式状态:
obs = torch.zeros(self.batch_size, 2, 3)

# 每个人自己的观测:
# [提示是否可见, 自己提示的 -1/+1 编码, 公共阶段]
obs[:, :, 0] = float(self.phase == 0)
if self.phase == 0:
    obs[:, :, 1] = 2 * self.cues.float() - 1
obs[:, :, 2] = self.phase / (horizon - 1)

# Critic 的集中式输入:
# [智能体 0 的提示, 智能体 1 的提示, 公共阶段]
state = torch.cat([
    2 * self.cues.float() - 1,
    torch.full(
        (self.batch_size, 1),
        self.phase / (horizon - 1),
    ),
], dim=-1)
state 只给 Critic。它帮助 Critic 学习团队价值,但不会把队友或全局信息偷偷塞给执行时的 Actor。
这个任务里每个人只需要记住自己的提示,所以它检验的是局部记忆,不是通信。双方没有必须传递给对方的私有信息。
4. 参数和 hidden 不是一回事
循环 Actor 的结构如下:
class LocalActor(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(3, hidden_size),
            nn.Tanh(),
        )
        self.gru = nn.GRU(
            hidden_size,
            hidden_size,
            batch_first=True,
        )
        self.head = nn.Linear(hidden_size, 3)
        # 初始左右门概率均为 0.5,并没有写入正确动作。
        nn.init.zeros_(self.head.weight)
        nn.init.zeros_(self.head.bias)

    def initial_hidden(self, batch_size):
        # 每个新回合从空白记忆开始。
        return self.head.weight.new_zeros(
            1, batch_size, hidden_size,
        )

    def forward(self, own_obs, legal, hidden):
        encoded = self.encoder(own_obs)
        features, next_hidden = self.gru(encoded, hidden)
        logits = self.head(features)
        logits = logits.masked_fill(~legal, -1e9)
        return logits, next_hidden
两者的职责不同:
| 内容 | 保存什么 | 时间范围 |
|---|---|---|
| 网络参数 | 如何处理提示、怎样更新记忆、怎样从记忆选动作 | 跨多个回合保留 |
hidden |
当前这一局刚刚经历过的历史摘要 | 只属于当前回合 |
可以把参数理解成“记忆方法”,把 hidden 理解成“这一次具体记住了什么”。
这里 hidden_size=16。GRU 输入 own_obs 为 [B,T,3],输出 features 为 [B,T,16],动作得分为 [B,T,3]。单层 GRU 的 hidden 为 [1,B,16];batch_first=True 改变输入输出的顺序,不改变 hidden 的顺序。[2]
如果每个时间步都这样写:
hidden = actor.initial_hidden(batch_size)
那么网络每次行动都从空白开始,前面看到的提示就被删除了。训练再久也不能凭空恢复本局已经不可见的信息。
正确的回合边界如下。这是调用结构示意;每一步的 obs、legal 要从环境重新取得,并为本人增加长度为 1 的时间维度:
# 新回合开始时初始化一次。
hidden = actor.initial_hidden(batch_size)

for t in range(horizon):
    logits, hidden = actor(obs, legal, hidden)
    # 同一回合的下一步继续使用新的 hidden。
5. 采样:保存完整回合,而不是只保存最后一步
采样阶段要把一局从开头到终点的经历完整保存下来:
@torch.no_grad()
def collect_batch(model, cue_generator, batch_size):
    cues = torch.randint(
        0, 2, (batch_size, 2),
        generator=cue_generator,
    )
    env = ParallelCueEnv(cues)
    hidden = [
        actor.initial_hidden(batch_size)
        for actor in model.actors
    ]

    fields = {
        name: [] for name in (
            "obs", "states", "legal", "actions",
            "old_log_probs", "old_values",
            "rewards", "terminated",
        )
    }

    for t in range(horizon):
        obs, state, legal = env.observe()
        action_parts, log_prob_parts = [], []

        for i, actor in enumerate(model.actors):
            # T=1 表示本次只输入一个时间步。
            # hidden[i] 仍然把历史带进来了。
            logits, hidden[i] = actor(
                obs[:, i:i + 1],
                legal[:, None],
                hidden[i],
            )
            dist = Categorical(logits=logits[:, 0])
            action = dist.sample()
            action_parts.append(action)
            log_prob_parts.append(dist.log_prob(action))

        actions = torch.stack(action_parts, dim=-1)
        rewards, terminated = env.step(actions)

        rows = (
            obs, state, legal, actions,
            torch.stack(log_prob_parts, dim=-1),
            model.values(state), rewards, terminated,
        )
        for name, value in zip(fields, rows):
            fields[name].append(value)

    return {
        name: torch.stack(rows, dim=1)
        for name, rows in fields.items()
    }
批次中每个字段都有 B 和 T 两个重要维度:
| 字段 | 形状 | 含义 |
|---|---|---|
obs |
[B,T,2,3] |
回合、时间、智能体、局部观测 |
states |
[B,T,3] |
Critic 的集中式状态 |
actions |
[B,T,2] |
两名智能体实际执行的动作 |
old_log_probs |
[B,T,2] |
采样当时实际动作的对数概率 |
legal |
[B,T,3] |
双方共同使用的合法动作约束 |
old_values |
[B,T] |
采样当时的团队价值预测 |
rewards |
[B,T] |
每个共同时间步的团队奖励 |
terminated |
[B,T] |
该时间步之后是否真正结束 |
no_grad() 只是不保存采样阶段的反向图,不会阻止 hidden 的数值继续向后传递。
6. GAE:沿 TD 误差倒推,不能跨回合串联
这次每局完整走到终点,所以最后一步的未来价值为零。先构造 TD 误差,再沿每局自己的时间轴倒序计算 GAE:
\[\delta_t=r_t+\gamma(1-d_t)V_{\text{old}}(s_{t+1})-V_{\text{old}}(s_t), \qquad A_t=\delta_t+\gamma\lambda(1-d_t)A_{t+1}.\]$d_t=1$ 表示当前转移之后真正终止,$A_{t+1}$ 是下一时刻已累计好的优势。gamma=1.0 表示等待不受折扣,lam=0.95 控制后续 TD 误差的衰减。
@torch.no_grad()
def prepare_batch(batch):
    old_values = batch["old_values"]
    next_values = torch.cat([
        old_values[:, 1:],
        torch.zeros_like(old_values[:, :1]),
    ], dim=1)

    not_terminal = (~batch["terminated"]).float()
    deltas = (
        batch["rewards"]
        + gamma * not_terminal * next_values
        - old_values
    )

    advantages = torch.zeros_like(old_values)
    gae = torch.zeros(old_values.shape[0])

    for t in reversed(range(horizon)):
        gae = (
            deltas[:, t]
            + gamma * lam * not_terminal[:, t] * gae
        )
        advantages[:, t] = gae

    batch["advantages"] = advantages
    batch["targets"] = old_values + advantages
    return batch
这里有两个方向:
- GAE 沿奖励和 TD 误差的时间轴倒推;
- GRU 的计算图沿观测序列从前向后建立,再在训练时从后向前反传。
两者都使用时间顺序,但职责不同。GAE 负责构造动作评价,循环反向传播负责调整“早期观测如何影响后期动作”。
举一个独立的教学算例:假设旧价值全为零,一局奖励是 [0,0,0,1],则 GAE 为 [0.95³,0.95²,0.95,1]。当前 Actor 只使用最后一步的优势;Critic 的目标 old_values+advantages 则覆盖四个真实时刻。这些目标在优化前算一次并保持固定,本例没有优势标准化。
7. PPO 更新:当前网络重新走完整历史
采样时得到的 old_log_probs 必须固定。优化时重新用当前网络处理完整观测序列。下面先摘取一名 Actor 的损失计算,i 表示该智能体的编号:
logits, _ = actor(
    batch["obs"][:, :, i],
    batch["legal"],
    actor.initial_hidden(len(batch["obs"])),
)

# 这里只取真正有选择自由的最后一步。
dist = Categorical(logits=logits[:, -1])
new_log_prob = dist.log_prob(
    batch["actions"][:, -1, i],
)

log_ratio = (
    new_log_prob
    - batch["old_log_probs"][:, -1, i]
)
ratio = log_ratio.exp()
advantage = batch["advantages"][:, -1]

raw = ratio * advantage
clipped = (
    ratio.clamp(1 - clip_eps, 1 + clip_eps)
    * advantage
)
actor_loss = -torch.minimum(raw, clipped).mean()
这里重新走了 t=0,1,2,3,所以最后的动作概率仍然由开头提示经过 GRU 记忆得到。只取最后一步计算 Actor loss,是因为前三步只有一个合法动作 WAIT,它们没有真正的选择自由。
概率比和裁剪损失分别是:
\[\rho_i=\exp(\log\pi_i^{\text{new}}-\log\pi_i^{\text{old}}), \qquad L_i=-\mathbb E\left[\min\left(\rho_i A,\operatorname{clip}(\rho_i,0.8,1.2)A\right)\right].\]每名 Actor 分别计算自己的比值和裁剪损失,再对两个 Actor 的损失取平均。两人使用同一个团队优势,并没有计算 COMA 的反事实优势。
Critic 则使用完整时间轴上的目标。下面是汇总部分,actor_losses 和 entropies 是循环中分别保存的两名 Actor 的损失与动作熵:
values = model.values(batch["states"])
critic_loss = (
    values - batch["targets"]
).square().mean()

# 两个独立 Actor 的损失和熵按角色取平均。
actor_loss = torch.stack(actor_losses).mean()
entropy = torch.stack(entropies).mean()
total_loss = (
    actor_loss
    + critic_coef * critic_loss
    - entropy_coef * entropy
)
PPO 的“旧概率”和 Critic 的“旧目标”都是这批经历对应的固定参照。当前网络可以变化,但不能反过来覆盖采样时的旧数据。
每批数据最多优化四轮,然后重新采样。以下是优化主体,compute_losses 返回总损失和指标;其 approx_kl 是两名 Actor 各自的 mean((ratio-1)-log_ratio) 中的较大值,作为当前批次变化幅度的近似监测:
def update_batch(model, optimizer, batch):
    fixed = {name: value.clone() for name, value in batch.items()}
    optimizer_steps = 0
    for epoch in range(update_epochs):
        loss, metrics = compute_losses(model, batch)
        if metrics["approx_kl"] > target_kl:
            break
        optimizer.zero_grad(set_to_none=True)
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), max_grad_norm)
        optimizer.step()
        optimizer_steps += 1
    for name, value in batch.items():
        assert torch.equal(fixed[name], value), name
    with torch.no_grad():
        _, final_metrics = compute_losses(model, batch)
    return optimizer_steps, final_metrics
target_kl=0.03,max_grad_norm=0.5,学习率为 0.005,价值损失系数为 0.5,熵系数为 0.005。外层重复“采样 64 局 → 固定 GAE 和目标 → 有限多轮更新”共 160 次。理论最多更新 160×4=640 次;近似 KL 达到阈值的批次会提前停止,所以这次实际是 636 次。
8. detach 和清空 hidden:数值与梯度的区别
这两个操作经常被混在一起,其实作用不同:
| 操作 | hidden 数值 | 后面的损失能否回到更早时间步 |
|---|---|---|
| 继续传递 | 保留 | 可以 |
hidden.detach() |
保留 | 不能穿过 detach 点 |
| 重新创建零 hidden | 清空 | 不能使用之前的历史 |
下面是三种操作的调用示意;obs、legal 表示已按 [B,1,3] 整理好的当前一步输入:
# 正常递推:值和计算图都继续传递。
logits, hidden = actor(obs, legal, hidden)

# 截断梯度:当前 hidden 的数值还在,
# 但它与之前的计算图断开。
logits, hidden = actor(
    obs,
    legal,
    hidden.detach(),
)

# 清空记忆:连之前的历史数值也不再保留。
hidden = actor.initial_hidden(batch_size)
因此,detach 后仍可能根据已有记忆选对门,但最后的损失不能再沿这条链训练开头怎样编码提示。清空 hidden 则连行动依据也一起删除。detach 也不等于冻结所有 GRU 参数:后续时间步的运算仍可更新参数,只是跨过截断点的梯度路径消失了。[3]
练习对末步实际动作的 log probability 关于开头提示输入的梯度做了对照。下面摘取正常递推的检查,model 是训练后的网络,demo_batch 是用于探测的固定采样数据:
probe = demo_batch["obs"][:, :, 0].detach().clone().requires_grad_(True)
actor = model.actors[0]
live_logits, _ = actor(
    probe, demo_batch["legal"],
    actor.initial_hidden(len(probe)),
)
live_logp = Categorical(logits=live_logits[:, -1]).log_prob(
    demo_batch["actions"][:, -1, 0],
)
live_gradient = torch.autograd.grad(live_logp.sum(), probe)[0]
opening_gradient = live_gradient[:, 0, 1].abs().sum().item()
正常完整递推:梯度绝对值之和约 3.291114
每步 detach:梯度绝对值之和为 0
两种前向的动作概率可以相同,训练信号却不一样。
这个数值来自 live_logp.sum() 的输入梯度,不是 PPO 总损失的梯度,也不能直接解释成“记忆强度”。它用于确认末步动作概率与开局提示之间是否存在可微路径。
9. 回合顺序、补齐和真实终止
不同回合可以换顺序,因为每局从自己的初始 hidden 开始:
order = torch.randperm(batch["obs"].shape[0])
shuffled_batch = {
    name: value[order]
    for name, value in batch.items()
}
但同一回合内部的时间顺序不能打乱。obs、actions、旧概率、优势和目标必须使用同一个回合索引一起移动,两名智能体的共同奖励也必须继续配对。
如果回合长度不同,需要补齐到同样长度。例如一局第二步已经结束:
valid = [1, 1, 0, 0]
valid=1表示真实环境步,参与损失;valid=0表示为了对齐长度补出来的位置,不参与损失;- 真正终止步本身仍然是有效样本;
- 终止步的 TD target 保留当前奖励,去掉未来价值;
- 新回合开始前重置上一回合的 hidden。
下面是独立的掩码损失教学算例,假设两个张量形状都是 [1,4],先取有效位置再计算平方误差。目标和预测仍必须按同一回合、同一时刻对齐:
values = torch.tensor([[0.2, 0.8, 0.0, 0.0]])
targets = torch.tensor([[0.5, 1.0, 0.0, 0.0]])
valid = torch.tensor([[True, True, False, False]])
masked_loss = (values[valid] - targets[valid]).square().mean()
# (0.3² + 0.2²) / 2 = 0.065
valid 只管哪些位置参与损失,不会自动停止 GRU 对补齐位置的前向计算。变长序列的最后真实输出要按实际长度取,不能直接拿补齐后的 logits[:, -1] 当作决策输出。如果只是尾部补齐、不再使用补齐后的 hidden,且仅在真实位置计算损失,尾部前向不会倒过来改变更早的输出;若继续进入新局,则必须按回合边界重置。
外部时间限制截断还要与真实终止区别处理:可从最后真实观测 bootstrap,但 GAE 递推不能跨过环境重置接入下一局。当前练习固定为四步,没有补齐位置或外部截断;上述掩码和变长规则是课堂扩展,不是已实现的训练功能。长片段训练还要处理正确初态和计算图长度,不能把本例末步索引直接搬过去。
10. 实跑结果:成功依赖记忆
本节数值来自当前保存输出:CPU、PyTorch 2.10.0+cu128、随机种子 7。图中的训练历史由同源代码在新内核中重跑取得,关键结果与保存输出一致。训练产生:
10240个共同回合;40960条共同环境转移;81920个体动作;636次联合优化器更新。
四种等概率提示组合上的精确双人成功概率如下:
| 条件 | 精确成功概率 |
|---|---|
| 初始循环策略 | 0.250000 |
| 训练后,正常传递 hidden | 0.999879 |
| 同一策略,最后选门前清空 hidden | 0.250000 |
| 只看当前观测的 MLP 信息对照 | 0.250000 |
MLP 没有做完整训练,它用于核对相同末步输入下的理论信息边界。增加 MLP 的宽度不会使已经消失的独立随机提示重新出现在输入里。
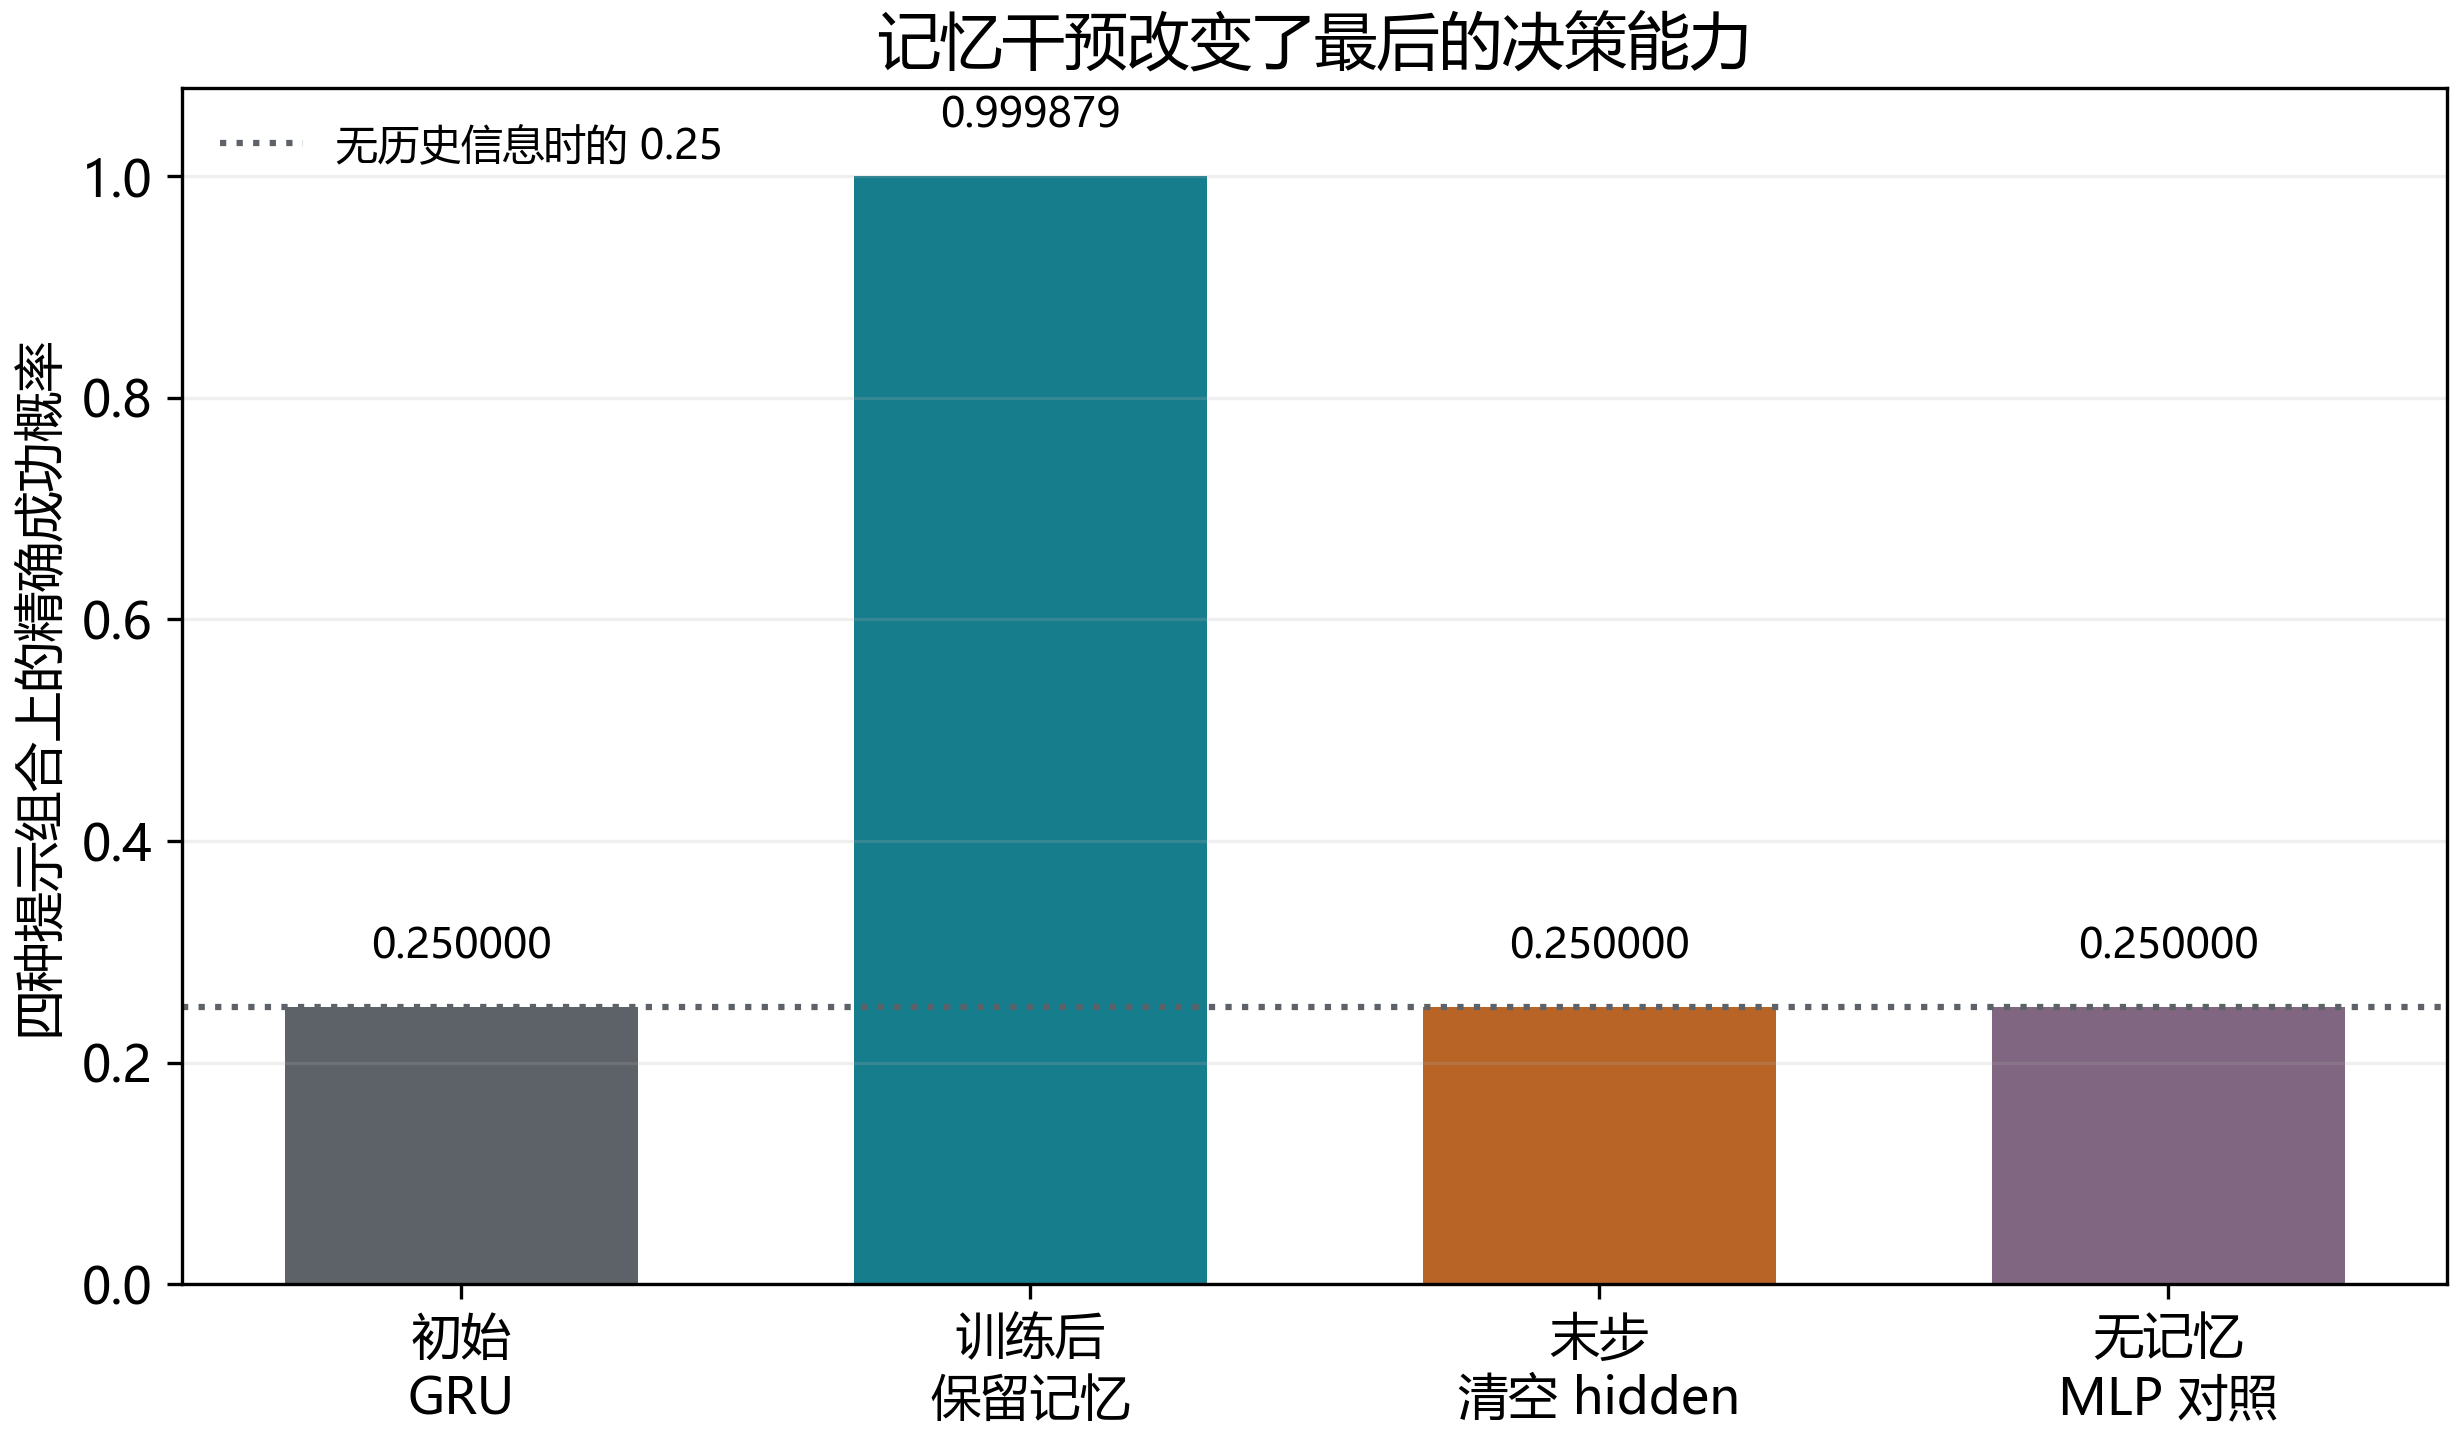
正常贪心执行在四种提示组合上 4/4 成功;另抽取 500 组提示并按策略概率采样,500/500 局成功。有限样本成功次数和精确策略概率是两种不同的统计口径。
精确成功概率不要求贪心动作一定执行成功才进行计算。对四种等概率提示,每一行先取两名 Actor 分别选中正确门的概率,再相乘并求平均:
\[P_{\text{success}} =\frac14\sum_{c_0,c_1\in\{0,1\}} \pi_0(c_0\mid \text{本人历史})\, \pi_1(c_1\mid \text{本人历史}).\]下面摘取冻结评估主体,省略轨迹保存和随机采样分支。cues 应传入 [[0,0],[0,1],[1,0],[1,1]],才能对应上面的四种等概率精确口径:
@torch.no_grad()
def evaluate_exact(actors, cues, reset_before_choice=False):
    env = ParallelCueEnv(cues)
    hidden = [actor.initial_hidden(len(cues)) for actor in actors]
    for t in range(horizon):
        obs, _, legal = env.observe()
        if reset_before_choice and t == horizon - 1:
            hidden = [actor.initial_hidden(len(cues)) for actor in actors]
        parts, probabilities = [], []
        for i, actor in enumerate(actors):
            logits, hidden[i] = actor(
                obs[:, i:i + 1], legal[:, None], hidden[i],
            )
            probs = logits[:, 0].softmax(dim=-1)
            parts.append(probs.argmax(dim=-1))
            probabilities.append(probs[:, :2])
        actions = torch.stack(parts, dim=-1)
        reward, terminated = env.step(actions)
    assert terminated.all()
    choice_probs = torch.stack(probabilities, dim=1)
    own_correct = choice_probs.gather(
        -1, cues.unsqueeze(-1),
    ).squeeze(-1)
    return own_correct.prod(dim=-1).mean().item()
这里传入的只有局部 Actor,没有 Critic 或优化器。实际冻结评估的 Critic 调用次数为 0,参数保持不变,500 局全部完成四步,共产生 2000 条共同环境转移。
下面是一局提示为 (0,1) 的完整轨迹:
| 时间 | 两人的实际动作 | 团队奖励 | 真正终止 |
|---|---|---|---|
t=0 |
(WAIT, WAIT) |
0 |
否 |
t=1 |
(WAIT, WAIT) |
0 |
否 |
t=2 |
(WAIT, WAIT) |
0 |
否 |
t=3 |
(LEFT, RIGHT) |
1 |
是 |
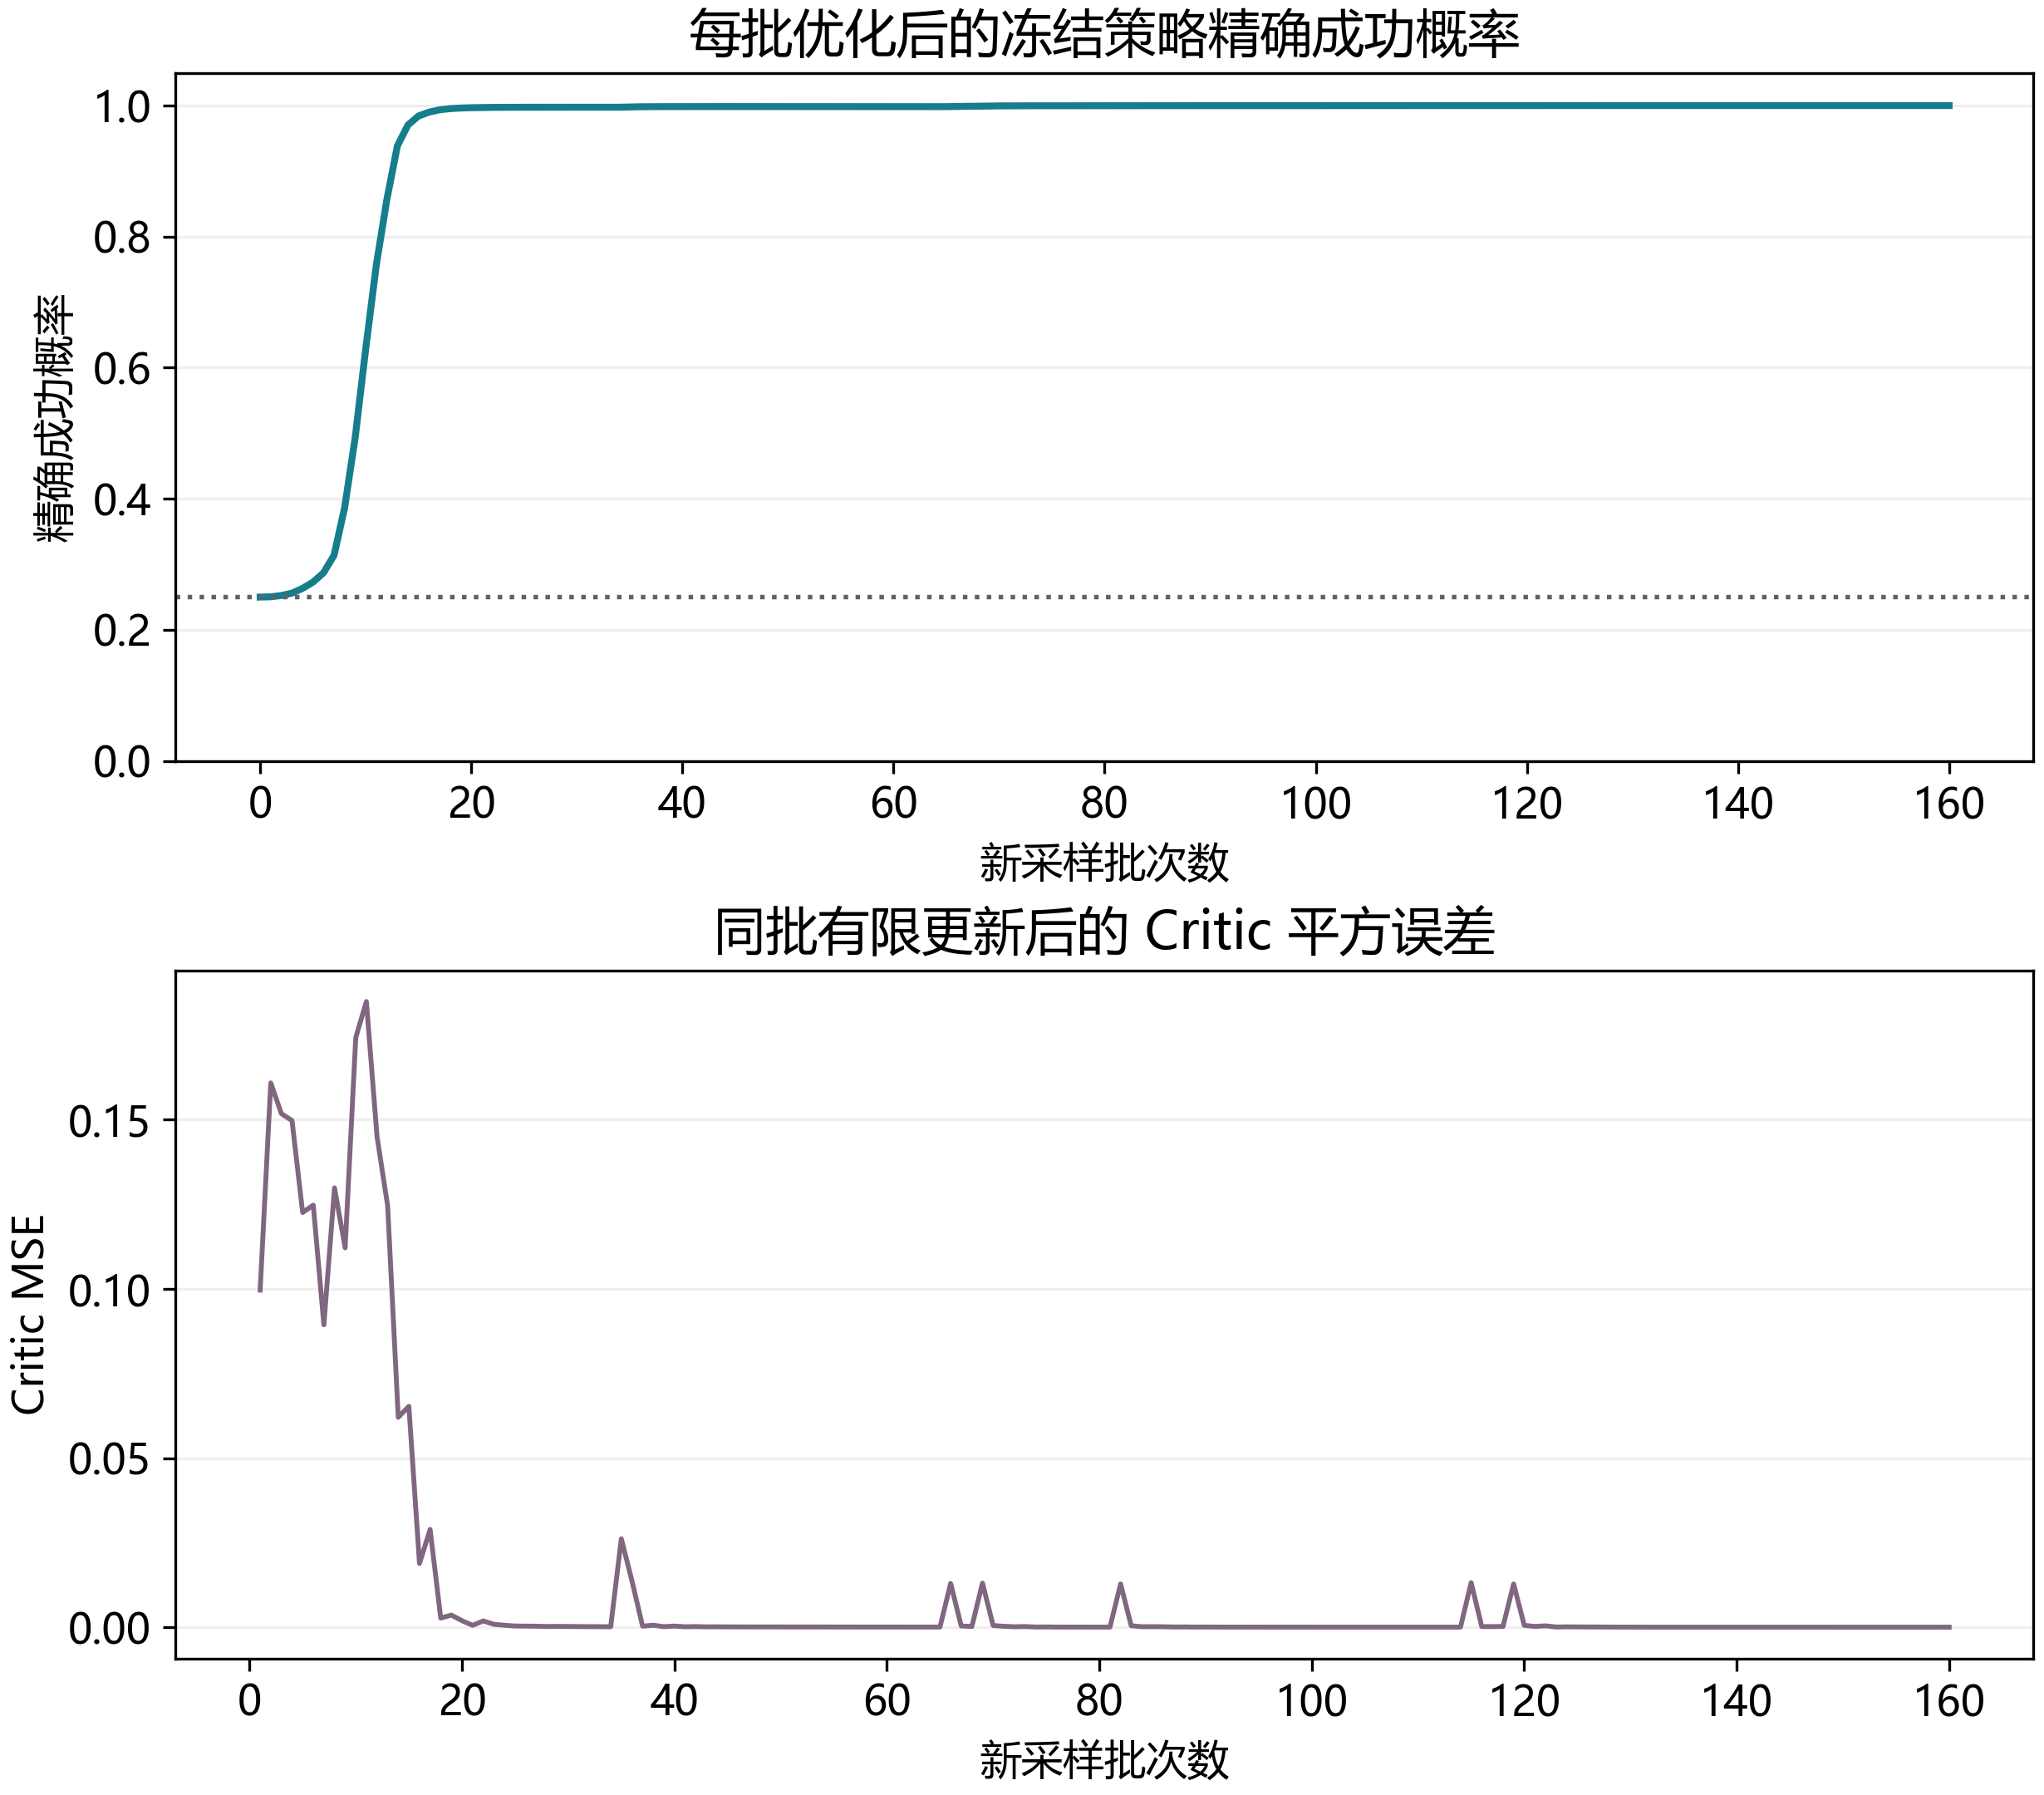
训练曲线上图是每批更新后的精确成功概率,下图是同批固定目标上的 Critic MSE。精确成功概率最终接近 1,价值误差总体下降;MSE 衡量目标拟合,记忆是否起作用则由清零干预检验,也不要求每一批单调下降。
最后三步的局部观测里已经没有提示,但正常循环策略仍然分别选出了左门和右门。选门前清空 hidden 后,成功概率回到 0.25,说明策略确实使用了本局前面形成的记忆。
最后一个机制对照是梯度:
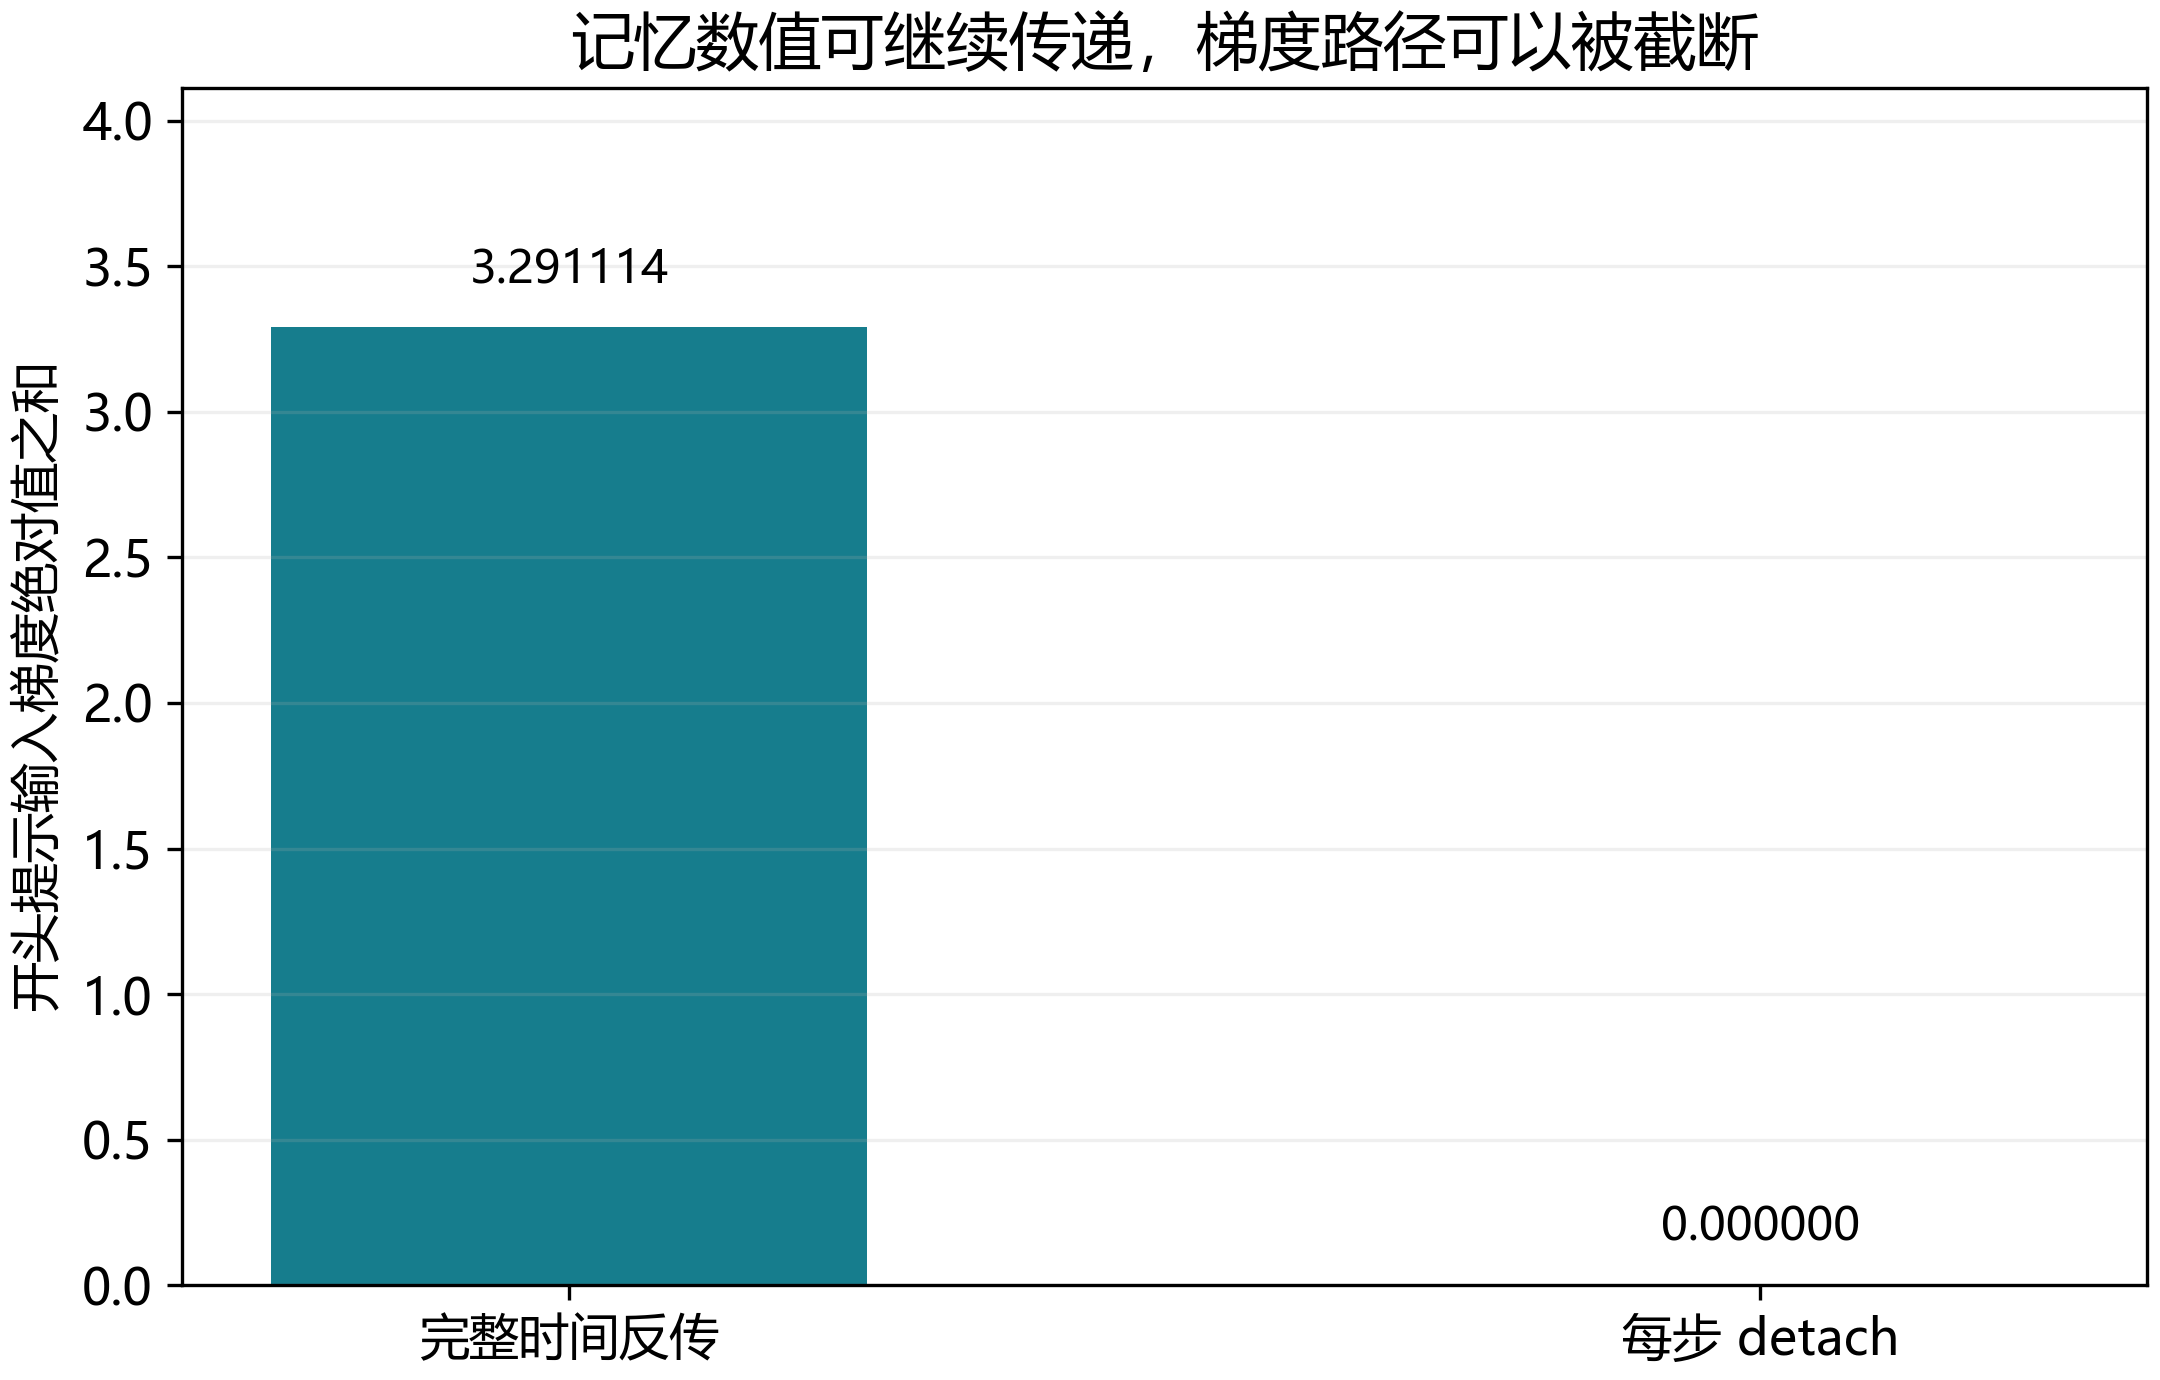
正常递推时,末步动作 log probability 对开头提示输入的梯度绝对值之和约为 3.291114;每步 detach 后,前向动作概率仍可保持一致,但开头梯度变成 0。
这一天把“局部 Actor 只看当前观测”扩展成了“局部 Actor 可以利用本局历史”:
- 记忆任务要让关键信息在决策前消失,否则 MLP 也能直接解决。
- 参数保存跨回合的处理规律,hidden 保存当前回合的历史。
- 采样时按时间顺序传递 hidden;训练时从回合起点重新走完整序列。
detach截断时间梯度,清空 hidden 则直接删除行动所需的历史。- 不同回合可以换序,同一回合内部必须保持时间顺序。
- 真实终止步仍参与训练,补齐位置才需要被 mask 掉。
这个任务检验的是共同奖励下的局部记忆。双方没有必须互相传递的私有信息,因此训练成功说明循环 Actor 学会了记忆,不等于已经完成通信。
参考资料
- Yu et al. The Surprising Effectiveness of PPO in Cooperative Multi-Agent Games. MAPPO 的集中训练与循环策略:论文,作者 RNN 实现。
- PyTorch GRU 文档:对应输入、输出和 hidden 的形状。
- PyTorch Tensor.detach 文档:对应切断计算图而保留数值的行为。