<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="zh-CN"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://redmoon-2333.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://redmoon-2333.github.io/" rel="alternate" type="text/html" hreflang="zh-CN" /><updated>2026-11-18T02:26:49+08:00</updated><id>https://redmoon-2333.github.io/feed.xml</id><title type="html">RedMoon · 训练日志</title><subtitle>我走过的漫漫长路。 记录 LLM 原理、后训练、推理优化与 Agent 开发的学习与实践。</subtitle><author><name>RedMoon</name><uri>https://redmoon-2333.github.io</uri></author><entry><title type="html">智能计算系统 Day9：大模型工具链、AI 芯片与量化加速</title><link href="https://redmoon-2333.github.io/2026/11/18/ics-day9/" rel="alternate" type="text/html" title="智能计算系统 Day9：大模型工具链、AI 芯片与量化加速" /><published>2026-11-18T00:00:00+08:00</published><updated>2026-11-18T00:00:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/18/ics-day9</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/18/ics-day9/"><![CDATA[<blockquote>
  <p>RedMoon · 2026-11-18 整理 · 课堂笔记</p>
</blockquote>

<p>上节课从 Transformer 延伸到多模态和智能体，本课把这些模型放回完整的计算系统。前半段梳理 Token、上下文、工具、MCP 与 Agent Skill，说明模型怎样获得信息并执行任务；后半段进入硬件与量化，讨论参数和激活怎样存储、搬运、参与运算。两部分连接着同一个问题：完成一次任务，除了模型生成内容，还需要哪些软件和硬件配合？</p>

<h2 id="一计算生态硬件能力怎样变成可用性能">一、计算生态：硬件能力怎样变成可用性能</h2>

<h3 id="1-芯片编译器与算子库共同工作">1. 芯片、编译器与算子库共同工作</h3>

<p>课堂从 CUDA 生态谈起，强调硬件之外的软件积累。一个矩阵乘法从模型代码走到芯片执行，通常还要经过框架、编译器、运行时、算子实现和驱动。模型支持哪些数据类型、算子能否融合、形状是否适合并行，都会影响性能。<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html">1</a>、<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html">2</a></p>

<p>因此，芯片峰值算力与某个模型的实际速度是不同的指标。换一种硬件后，能否直接运行、是否需要改算子、数值是否一致、性能是否稳定，都涉及软件与硬件的配合。课堂将这部分概括为中间件和开发生态。</p>

<p>GPU 也有通用计算、向量、标量和控制能力，矩阵计算只是深度学习中很重要的一类工作。理解 AI 加速时，应把完整工作负载拆开，再看各类运算映射到哪里。</p>

<h3 id="2-用模型生成算子还需要验证循环">2. 用模型生成算子，还需要验证循环</h3>

<p>课堂介绍了借助大模型生成、编译和优化计算代码的思路：给定算子定义与目标硬件，生成实现，编译运行，根据错误信息和性能反馈继续修改。这个流程可以减少部分人工试错，但“成功生成代码”只是其中一步。</p>

<p>一个可核验的算子优化循环包括：</p>

<ol>
  <li>明确输入输出、数据类型、形状和参考实现。</li>
  <li>编译并检查不同输入下的数值，覆盖边界和特殊值。</li>
  <li>在统一条件下预热、同步和计时，避免把异步提交时间当成执行时间。</li>
  <li>将优化后的算子放回模型，检查端到端收益。</li>
</ol>

<p>如果一个算子只占原总耗时的 $p$，其速度提升到原来的 $s$ 倍，在其余部分不变的理想条件下，总加速比为：</p>

\[S_{\mathrm{total}}=\frac{1}{(1-p)+p/s}.\]

<p>例如，算子占原耗时 20%，即使加速 10 倍，总加速也只有 $1/(0.8+0.2/10)\approx1.22$ 倍。这是按给定时间占比推算的教学例子，说明局部算子收益需要经过系统占比才能转化为整体收益。</p>

<h2 id="二token-与生成从文本进入数值计算">二、Token 与生成：从文本进入数值计算</h2>

<h3 id="1-tokenizer-负责切分与编号">1. Tokenizer 负责切分与编号</h3>

<p>Tokenizer 将文本转换为 Token ID 序列。Token 可以对应常见词、词的一部分、字符、字节片段或特殊标记；切分取决于具体词表和算法。BPE、WordPiece、Unigram 是常见的子词方案。<a href="https://huggingface.co/docs/transformers/main/en/tokenizer_summary">3</a></p>

<p>同一个词在不同 Tokenizer 下可能有不同的切分，部分 Unicode 字符也可能跨多个 Token。因而不能将“一 Token 等于几个汉字”作为通用换算规则。需要估计长度或费用时，应使用目标模型对应的 Tokenizer。</p>

<p>Token ID 只是词表索引。模型先把 ID 映射为向量，再进行注意力和前馈等计算；输出通常是词表上的分数，经归一化形成下一 Token 的条件概率：</p>

\[p_\theta(x_t\mid x_{\lt t},c)
=\operatorname{softmax}(\ell_t).\]

<p>$c$ 表示指令、已有输入及其他上下文，$\ell_t$ 是当前词表分数。选择下一个 Token 可以使用贪心或采样等解码策略，并非每次都必须取最大概率项。</p>

<h3 id="2-自回归依赖-token界面不必逐字刷新">2. 自回归依赖 Token，界面不必逐字刷新</h3>

<p>典型自回归生成会把新 Token 接到已有前缀后，再预测后续内容，直到结束标记、输出限制或其他停止条件。Token 边界与汉字、单词边界不相同，界面也可以缓存多个 Token 后再显示。因此，“逐 Token 生成”与“屏幕逐字刷新”需要分开理解。</p>

<p>推理过程常分成两个阶段：</p>

<table>
  <thead>
    <tr>
      <th>阶段</th>
      <th>主要处理什么</th>
      <th>计算特点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Prefill</td>
      <td>已知的输入 Token 序列</td>
      <td>同一次前向中可并行处理多个位置</td>
    </tr>
    <tr>
      <td>Decode</td>
      <td>继续生成后续 Token</td>
      <td>同一序列的下一步依赖已经确定的前缀</td>
    </tr>
  </tbody>
</table>

<p>KV Cache 保存前缀的键和值，减少生成过程中的重复计算；它增加了需要管理的运行时存储。不同请求可以组成批次，但单个序列中的生成依赖仍然存在。</p>

<h2 id="三上下文prompt-与-rag">三、上下文、Prompt 与 RAG</h2>

<h3 id="1-当前能读取什么取决于实际送入的信息">1. 当前能读取什么，取决于实际送入的信息</h3>

<p>上下文可以包括用户问题、系统或应用规则、历史对话、工具描述、检索材料与工具结果。模型表现得像记住了上一轮，通常是因为应用再次提供了相关历史，或检索了外部记录。</p>

<p>上下文窗口规定一次处理所支持的长度范围。它与当前实际占用长度、单次输出限制是不同的量。应用还可能截断、压缩或筛选历史，因此对话界面中的全部记录不一定都出现在当前输入里。</p>

<p>设上下文预算为 $C$，系统规则、历史、工具说明、检索片段和问题的 Token 数分别为 $S,H,T,R,Q$，计划保留的输出空间为 $O$，可以先检查：</p>

\[S+H+T+R+Q+O\leq C.\]

<p>这是规划输入和输出空间的教学记法；具体服务可能还有独立的输入、输出或其他预算规则。即使材料放得下，也仍要检查模型是否提取了正确证据。</p>

<h3 id="2-prompt-说明任务与行为规则">2. Prompt 说明任务与行为规则</h3>

<p>课堂用数学辅导机器人说明两类信息：应用规定“引导学生思考”，用户提出“求解某道题”。前者约束行为，后者给出当前任务。明确目标、可用材料和输出要求，能减少模型对任务的歧义。</p>

<p>这些规则通过消息或上下文影响推理，不等于更新模型参数。它们也不能代替程序中的访问控制。例如，文本里写“只读文件”，还需要执行器实际限制写入能力。</p>

<h3 id="3-rag-把有关证据带入当前请求">3. RAG 把有关证据带入当前请求</h3>

<p>面对很长的产品手册，可以先检索相关段落，再把问题和这些段落一起交给模型。典型流程是文档解析、切分、建立索引、检索，必要时重排，再生成带依据的回答。<a href="https://arxiv.org/abs/2005.11401">4</a></p>

<p>RAG 将外部可更新的文档与模型参数中的知识结合起来。检索阶段需要找到有关材料，生成阶段需要正确使用这些材料。漏检关键条件、切断表格上下文或混入过期版本，都会影响回答。</p>

<p>检索后的片段仍占上下文，模型输入仍受长度预算约束。RAG 的作用是选择信息，提高相关材料的使用效率，而不是让窗口变成无限大。</p>

<h2 id="四工具mcpagent-与-skill-怎样配合">四、工具、MCP、Agent 与 Skill 怎样配合</h2>

<h3 id="1-工具调用需要执行器真正运行">1. 工具调用需要执行器真正运行</h3>

<p>工具可封装成有明确输入输出的函数，如文件读取、数据库查询、测试运行或天气服务。模型根据工具描述生成调用请求，宿主程序校验请求并执行，再将返回值交给模型继续处理。</p>

<p>一次工具交互可以拆为：</p>

<ol>
  <li>应用向模型提供问题和当前可用的工具描述。</li>
  <li>模型返回工具名与结构化参数。</li>
  <li>执行器校验参数、权限及调用条件，运行对应操作。</li>
  <li>应用将工具结果加入后续上下文，模型据此继续或结束。</li>
</ol>

<p>生成“已经查到”的文字不能作为执行证据。工具名称正确，也不保证参数、执行结果或最终回答正确。对于文件、测试等任务，可以直接检查目标文件和测试结果。</p>

<h3 id="2-mcp-规范连接方式">2. MCP 规范连接方式</h3>

<p>MCP，即 Model Context Protocol，采用客户端—服务器架构，规范 AI 应用与外部能力之间的消息交换。官方架构区分三个角色：<a href="https://modelcontextprotocol.io/docs/learn/architecture">5</a></p>

<table>
  <thead>
    <tr>
      <th>角色</th>
      <th>责任</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Host</td>
      <td>宿主应用，协调客户端、模型交互和应用侧策略</td>
    </tr>
    <tr>
      <td>Client</td>
      <td>宿主内部的协议组件，维护与对应服务器的连接</td>
    </tr>
    <tr>
      <td>Server</td>
      <td>暴露工具、资源或提示模板等能力</td>
    </tr>
  </tbody>
</table>

<p>工具发现与调用可以对应 <code class="language-plaintext highlighter-rouge">tools/list</code> 和 <code class="language-plaintext highlighter-rouge">tools/call</code>。Server 还可以暴露 Resources 与 Prompts，所以 MCP 的范围比单一函数列表更广。模型通常通过宿主使用这些能力，协议本身不规定模型如何规划任务。<a href="https://modelcontextprotocol.io/docs/learn/architecture">5</a></p>

<p>课堂用“把 $M\times N$ 个定制对接变成近似 $M+N$ 个适配”说明标准接口的收益。这个类比描述重复集成工作的减少；具体系统仍要处理协议版本、能力支持、认证、输入输出语义和访问权限。</p>

<h3 id="3-agent-在反馈中决定下一步">3. Agent 在反馈中决定下一步</h3>

<p>课堂的例子是：先定位，再查天气；如果下雨，再找附近可以买伞的店。前一步的结果影响后一步是否执行，这就形成了带状态的任务循环。</p>

<p>Agent 可以根据当前目标、已有结果和可用工具安排下一步，也可以在明确的工作流里执行。系统需要知道何时成功、何时失败、何时应补充信息或停止。多调用几次工具，不能直接证明任务完成得更好。</p>

<p>课堂视频中的天气、位置和店铺数据是演示用的假设返回值，适合说明控制流程。实际服务还需检查数据是否来自真实调用，以及位置、日期和查询对象是否对应。</p>

<h3 id="4-skill-保存可复用的操作说明">4. Skill 保存可复用的操作说明</h3>

<p>Agent Skill 将某类任务的说明、脚本或参考材料打包，以便按需使用。公开格式以技能目录中的 <code class="language-plaintext highlighter-rouge">SKILL.md</code> 为入口，文件含 YAML 元数据和 Markdown 正文；<code class="language-plaintext highlighter-rouge">name</code> 与 <code class="language-plaintext highlighter-rouge">description</code> 用于说明名称和适用条件。<a href="https://agentskills.io/specification">6</a></p>

<p>下面是根据课堂“出门清单”例子整理的文档片段，用于说明格式：</p>

<div class="language-markdown highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nn">---</span>
<span class="na">name</span><span class="pi">:</span> <span class="s">departure-checklist</span>
<span class="na">description</span><span class="pi">:</span> <span class="s">根据已取得的天气信息整理出门物品清单。</span>
<span class="nn">---</span>

先确认地点和日期，再读取天气结果。
下雨时列出雨伞，并写明判断依据。
先给一句概括，再列物品及原因。
天气查询失败时，保留失败信息，不编造结果。
</code></pre></div></div>

<p>渐进式披露先加载简短元数据，在任务匹配时读取正文，需要时再读取脚本和参考文件。这种组织减少了把全部说明长期塞进上下文的开销。<a href="https://agentskills.io/specification">6</a></p>

<p>Skill 提供做事规则，工具提供执行能力，MCP 规范部分能力的连接方式。写了一份 Skill，不会自动安装天气服务或赋予文件权限；技能安装位置、触发机制与执行限制仍由宿主决定。</p>

<h2 id="五从模型算子走向-cpugpu-与专用加速器">五、从模型算子走向 CPU、GPU 与专用加速器</h2>

<h3 id="1-资源要在计算存储控制与通信之间分配">1. 资源要在计算、存储、控制与通信之间分配</h3>

<p>CPU 通常强调复杂控制和单任务响应，GPU 通过大量并行工作及高吞吐执行单元处理适合并行的任务，专用加速器还可以针对特定运算和数据流安排硬件。<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html">1</a></p>

<p>课堂用“城市分区与道路”类比芯片：计算单元像工作区域，缓存和存储保存数据，互连负责搬运。增加计算单元之后，如果供数不足，执行单元仍会等待。面积、带宽、功耗、时序与软件利用率需要共同考虑。</p>

<p>不同芯片的面积构成取决于架构和实现，不能把“CPU 只有 1% 用于计算、GPU 为 30%—60%”当作普适比例。理解这段讲授时，应抓住吞吐与控制等资源取舍，不据类比推导固定的性能倍数。</p>

<h3 id="2-张量有多少数据需要按形状和类型计算">2. 张量有多少数据，需要按形状和类型计算</h3>

<p>一张 $2048\times2048$ RGB 图像包含：</p>

\[2048\times2048\times3=12{,}582{,}912\]

<p>个通道数值。按未压缩且无额外布局开销计算：</p>

<table>
  <thead>
    <tr>
      <th>每个通道数值的类型</th>
      <th style="text-align: right">字节数</th>
      <th style="text-align: right">整张图像占用</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>uint8</td>
      <td style="text-align: right">1</td>
      <td style="text-align: right">12 MiB</td>
    </tr>
    <tr>
      <td>FP32</td>
      <td style="text-align: right">4</td>
      <td style="text-align: right">48 MiB</td>
    </tr>
    <tr>
      <td>FP64</td>
      <td style="text-align: right">8</td>
      <td style="text-align: right">96 MiB</td>
    </tr>
  </tbody>
</table>

<p>这里 $1\ \mathrm{MiB}=2^{20}$ 字节。图像文件压缩后的大小、原始像素值个数、模型内部激活数量与处理它们的运算次数，属于不同统计口径。</p>

<p>FP64 指每个值的总表示宽度为 64 位。IEEE 双精度格式由 1 位符号、11 位指数和 52 位显式小数部分组成，并不是“小数点后有 64 位”，也不需要再额外加上数百位的整数部分。<a href="https://docs.oracle.com/cd/E19957-01/806-3568/ncg_math.html">7</a></p>

<h3 id="3-一个模型包含多种算子">3. 一个模型包含多种算子</h3>

<table>
  <thead>
    <tr>
      <th>运算</th>
      <th>典型工作</th>
      <th>性能关注点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>矩阵乘法</td>
      <td>QKV 投影、注意力乘法、前馈层</td>
      <td>形状、并行度、数据复用、支持的数据类型</td>
    </tr>
    <tr>
      <td>Softmax</td>
      <td>最大值、指数、求和与归一化</td>
      <td>归约、数值稳定性、访存</td>
    </tr>
    <tr>
      <td>归一化</td>
      <td>计算统计量并变换输入</td>
      <td>归约与读写开销</td>
    </tr>
    <tr>
      <td>激活函数</td>
      <td>对元素做非线性变换</td>
      <td>吞吐、融合与中间结果</td>
    </tr>
    <tr>
      <td>池化</td>
      <td>局部最大值或平均值等</td>
      <td>局部读取与归约，取决于具体视觉网络</td>
    </tr>
  </tbody>
</table>

<p>Softmax 的输出依赖一组输入的归一化，不能只看成互不相关的逐点激活。矩阵乘法、逐元素操作和归约的性能特点也不同，单一峰值乘加指标无法覆盖它们。<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html">1</a>、<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html">2</a></p>

<h2 id="六计算量访存量与加速瓶颈">六、计算量、访存量与加速瓶颈</h2>

<h3 id="1-矩阵乘法的运算次数取决于形状">1. 矩阵乘法的运算次数取决于形状</h3>

<p>设 $A$ 的形状为 $M\times K$，$B$ 为 $K\times N$。每个输出需要长度为 $K$ 的内积，约有 $MNK$ 次乘加；按一次乘法和一次加法各记一次操作，约为：<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html">2</a></p>

\[F\approx2MNK.\]

<p>例如，$M=N=K=1024$ 时，约为 $2.147\times10^9$ 次算术操作。把 FP32 换成 INT8，矩阵形状不变，标量乘加数量也不变；变化的是每次运算使用的数据表示、相应的硬件执行方式和数据传输量。</p>

<p>低位宽运算可以使用吞吐更高的硬件路径，减少部分存储与搬运。但速度还取决于算子是否支持、是否需要反量化、输入形状和整个程序的瓶颈。</p>

<h3 id="2-算术强度连接计算与访存">2. 算术强度连接计算与访存</h3>

<p>算术强度是运算次数与数据搬运字节数的比值：</p>

\[I=\frac{F}{B}\quad\text{次操作/字节}.\]

<p>若计算峰值为 $P_{\mathrm{peak}}$，内存带宽为 $W_{\mathrm{mem}}$，一个简化的性能上界模型是：</p>

\[P_{\mathrm{effective}}
\leq\min\left(P_{\mathrm{peak}},I W_{\mathrm{mem}}\right).\]

<p>对于很低的算术强度，供数速度可能先成为限制；算术强度较高且并行度足够时，计算吞吐可能更重要。该模型还需结合工作规模、指令、同步和调度开销使用。<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html">1</a></p>

<p>分块矩阵乘法把部分数据放入更近的存储后重复利用，算子融合减少中间结果反复写回和读取，都在改变数据复用与搬运。近存计算、存内计算则进一步探索数据存储与计算的位置安排，具体收益取决于器件、精度和系统接口。</p>

<h3 id="3-量化与缓存影响不同的开销">3. 量化与缓存影响不同的开销</h3>

<p>量化减少特定张量的表示位宽；KV Cache 避免重复计算已有前缀；分块和融合减少搬运与中间结果。这些方法可以组合，但要分别统计节省了什么。</p>

<p>同样，模型参数、KV Cache、激活和临时工作区都占存储。只把权重量化到 4 位，并不意味着全部运行时内存也变成 4 位。</p>

<h2 id="七量化用较少的离散值近似原数据">七、量化：用较少的离散值近似原数据</h2>

<h3 id="1-均匀仿射量化的三个动作">1. 均匀仿射量化的三个动作</h3>

<p>设原值为 $x$，正比例系数为 $s$，整数零点为 $z$，整数表示范围为 $\lbrack q_{\min},q_{\max}\rbrack$。一种常见写法是：</p>

\[q=\operatorname{clip}
\left(\operatorname{round}(x/s)+z,\ q_{\min},q_{\max}\right),\]

\[\hat x=s(q-z).\]

<p>先缩放，再舍入，最后裁剪到可表示范围；反量化后得到近似值 $\hat x$。比例系数和零点决定整数码与实数之间的对应关系。具体实现还要约定舍入规则和饱和范围。<a href="https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html">8</a>、<a href="https://onnx.ai/onnx/operators/onnx__QuantizeLinear.html">9</a></p>

<p>均匀量化表示相邻可表示实数的间隔一致。若输入在覆盖范围内、采用最近舍入且没有裁剪，绝对误差可控制在约 $s/2$；发生裁剪时，这个误差界不再适用。</p>

<h3 id="2-对称与非对称量化">2. 对称与非对称量化</h3>

<p>对称量化通常围绕零点安排实数范围，使用零点为 0 的有符号码。一种常见选择是使用 $b$ 位有符号整数的对称子范围：</p>

\[q_{\max}=2^{b-1}-1,\qquad q_{\min}=-q_{\max},\qquad
s=\frac{\max |x|}{q_{\max}}.\]

<p>例如 8 位时使用 $\lbrack-127,127\rbrack$，刻意保留了对称范围，未用到可存储的 $-128$。不同实现可能采用不同范围约定。<a href="https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html">8</a>、<a href="https://onnx.ai/onnx/operators/onnx__QuantizeLinear.html">9</a></p>

<p>非对称量化使用可调整的零点，将偏向一侧的数据范围映射到整数区间。例如对非负且覆盖 $\lbrack0,6\rbrack$ 的数据使用 uint8，取 $s=6/255$、$z=0$；若数据范围跨越零点且不对称，可以使用非零的整数零点。对称性与“某边更重要”是不同概念，关键在于映射范围和零点。</p>

<h3 id="3-手算一次低位宽量化">3. 手算一次低位宽量化</h3>

<p>采用教学用的 3 位对称子范围 $\lbrack-3,3\rbrack$，数据范围 $\lbrack-1,1\rbrack$，所以 $s=1/3$、$z=0$：</p>

<table>
  <thead>
    <tr>
      <th>原值 $x$</th>
      <th style="text-align: right">整数码 $q$</th>
      <th style="text-align: right">反量化值 $\hat x$</th>
      <th style="text-align: right">误差 $\hat x-x$</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>$-1.0$</td>
      <td style="text-align: right">-3</td>
      <td style="text-align: right">-1.0000</td>
      <td style="text-align: right">0</td>
    </tr>
    <tr>
      <td>$-0.6$</td>
      <td style="text-align: right">-2</td>
      <td style="text-align: right">-0.6667</td>
      <td style="text-align: right">-0.0667</td>
    </tr>
    <tr>
      <td>$-0.1$</td>
      <td style="text-align: right">0</td>
      <td style="text-align: right">0</td>
      <td style="text-align: right">+0.1000</td>
    </tr>
    <tr>
      <td>$0$</td>
      <td style="text-align: right">0</td>
      <td style="text-align: right">0</td>
      <td style="text-align: right">0</td>
    </tr>
    <tr>
      <td>$0.2$</td>
      <td style="text-align: right">1</td>
      <td style="text-align: right">0.3333</td>
      <td style="text-align: right">+0.1333</td>
    </tr>
    <tr>
      <td>$0.7$</td>
      <td style="text-align: right">2</td>
      <td style="text-align: right">0.6667</td>
      <td style="text-align: right">-0.0333</td>
    </tr>
    <tr>
      <td>$1.0$</td>
      <td style="text-align: right">3</td>
      <td style="text-align: right">1.0000</td>
      <td style="text-align: right">0</td>
    </tr>
  </tbody>
</table>

<p>如果随后输入 $1.4$ 而仍使用这套量化参数，整数码会被裁剪到 3，重建为 1，绝对误差为 0.4。这说明校准范围和运行时数据分布的匹配很重要。</p>

<p>下面用 NumPy 复算。整数码保存在 int32 数组中便于观察，代码用于解释量化过程，没有实现 3 位打包或硬件加速：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="k">def</span> <span class="nf">symmetric_quantize</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">bits</span><span class="o">=</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">asarray</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">float64</span><span class="p">)</span>
    <span class="n">qmax</span> <span class="o">=</span> <span class="mi">2</span> <span class="o">**</span> <span class="p">(</span><span class="n">bits</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span>
    <span class="n">amplitude</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">max</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nb">abs</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
    <span class="n">scale</span> <span class="o">=</span> <span class="n">amplitude</span> <span class="o">/</span> <span class="n">qmax</span> <span class="k">if</span> <span class="n">amplitude</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="k">else</span> <span class="mf">1.0</span>
    <span class="n">codes</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">clip</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">rint</span><span class="p">(</span><span class="n">x</span> <span class="o">/</span> <span class="n">scale</span><span class="p">),</span> <span class="o">-</span><span class="n">qmax</span><span class="p">,</span> <span class="n">qmax</span><span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">int32</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">codes</span><span class="p">,</span> <span class="n">scale</span> <span class="o">*</span> <span class="n">codes</span><span class="p">,</span> <span class="n">scale</span>

<span class="n">x</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([</span><span class="o">-</span><span class="mf">1.0</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.6</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.1</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">,</span> <span class="mf">0.2</span><span class="p">,</span> <span class="mf">0.7</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">])</span>
<span class="n">codes</span><span class="p">,</span> <span class="n">restored</span><span class="p">,</span> <span class="n">scale</span> <span class="o">=</span> <span class="n">symmetric_quantize</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">codes</span><span class="p">.</span><span class="n">tolist</span><span class="p">())</span>                 <span class="c1"># [-3, -2, 0, 0, 1, 2, 3]
</span><span class="k">print</span><span class="p">(</span><span class="nb">round</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nb">max</span><span class="p">(</span><span class="nb">abs</span><span class="p">(</span><span class="n">restored</span> <span class="o">-</span> <span class="n">x</span><span class="p">)),</span> <span class="mi">6</span><span class="p">))</span>  <span class="c1"># 0.133333
</span></code></pre></div></div>

<h3 id="4-量化后的乘法怎样对应原计算">4. 量化后的乘法怎样对应原计算</h3>

<p>对权重与输入分别量化后，一个内积可近似写成：</p>

\[\sum_i w_i x_i
\approx s_w s_x
\sum_i(q_{w,i}-z_w)(q_{x,i}-z_x).\]

<p>这给出了整数乘加与原实数内积之间的联系。累加器通常采用比输入更宽的类型，避免低位宽乘积不断求和时快速溢出；最后还需按输出表示进行缩放或重新量化。<a href="https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html">8</a></p>

<p>“权重 4 位”也可能对应权重压缩存储、运行时与较高精度激活配合计算，不能据名称推断整层全部采用 4 位整数运算。</p>

<h2 id="八量化策略范围粒度与训练阶段">八、量化策略：范围、粒度与训练阶段</h2>

<h3 id="1-量化粒度决定哪些值共用参数">1. 量化粒度决定哪些值共用参数</h3>

<table>
  <thead>
    <tr>
      <th>粒度</th>
      <th>共用量化参数的范围</th>
      <th>主要取舍</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Per-tensor</td>
      <td>一个张量共用一组</td>
      <td>元数据少，但可能受大幅值影响</td>
    </tr>
    <tr>
      <td>Per-channel</td>
      <td>按选定通道或轴分别设置</td>
      <td>适应通道间范围差异，需额外参数</td>
    </tr>
    <tr>
      <td>Per-group / Per-block</td>
      <td>一组或一块元素共用</td>
      <td>在范围适配、元数据和实现之间取舍</td>
    </tr>
  </tbody>
</table>

<p>分通道量化通常指每个通道有自己的比例系数等参数，不必同时给不同通道分配不同位数；各层使用不同位宽，则属于混合精度设计。这些选择可以组合。<a href="https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html">8</a>、<a href="https://onnx.ai/onnx/operators/onnx__QuantizeLinear.html">9</a></p>

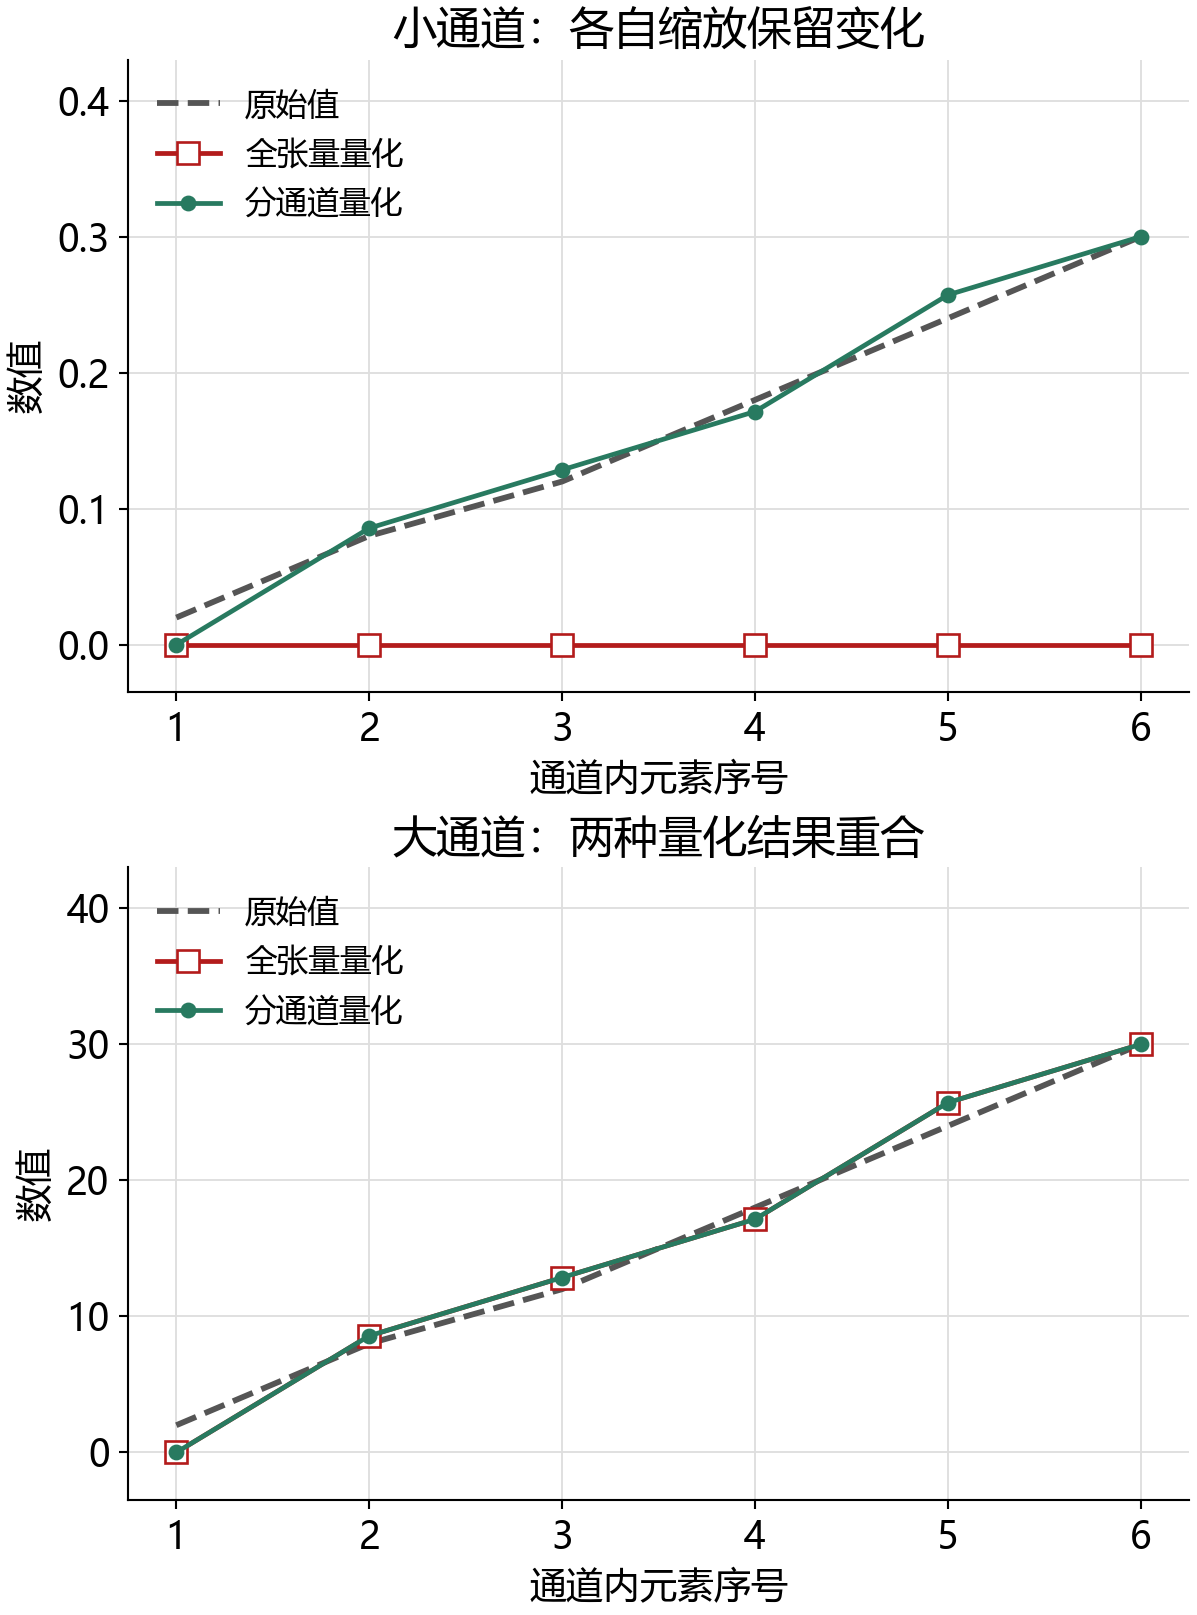
<p>例如，一个权重张量有两个输出通道，范围分别约为 $\lbrack0,0.3\rbrack$ 和 $\lbrack0,30\rbrack$。若采用 4 位对称子范围 $\lbrack-7,7\rbrack$，全张量比例系数为 $30/7$，小通道中的数可能全部舍入为零。分别量化两个通道时，小通道可以使用 $0.3/7$ 的步长，保留更多相对变化。</p>

<p><img src="/assets/img/ics-day9/quantization-granularity.png" alt="同一组权重在全张量与分通道量化下的重建值" /></p>

<blockquote>
  <p>图 1：给定小通道 $\lbrack0.02,0.08,0.12,0.18,0.24,0.30\rbrack$，大通道为其 100 倍，直接计算 4 位对称量化的结果。上图的小通道在全张量量化后全部为零；下图的大通道在两种策略下使用相同的比例系数，因此重建曲线重合。图中是固定数组的数值计算，不是模型任务精度实验。</p>
</blockquote>

<p>粒度更细可以改善某些权重的重建，却会增加比例系数、零点等元数据，并影响内核设计。最终仍需检查任务精度和目标平台上的性能。</p>

<h3 id="2-均匀性与异常值">2. 均匀性与异常值</h3>

<p>均匀量化的步长固定，便于缩放和整数计算。非均匀量化可以用不等间隔的码本或其他表示适应数据分布，但查表、编码和计算支持也随之变化。</p>

<p>对于异常值，可以考虑更细粒度、裁剪范围、特殊表示或保留部分较高精度值。裁剪减少主体分布的量化步长，同时增大被裁剪值的误差；是否有利要结合模型和数据评价，不能统一认定某种方法总能提高精度。</p>

<h3 id="3-ptq-与-qat">3. PTQ 与 QAT</h3>

<p>训练后量化（PTQ）在已有模型上确定量化参数并转换表示。静态激活量化通常用代表性数据校准范围；动态量化在运行时计算部分量化参数，会引入相应计算开销。<a href="https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html">8</a></p>

<p>量化感知训练（QAT）在训练或微调时模拟量化、反量化等影响，使参数有机会适应量化误差，部署时再转换为目标表示。模拟量化不等于整个训练过程已经完全在低位宽硬件上执行。</p>

<p>“训练前、中、后”是安排量化相关步骤的时间线；具体方案还要说清楚量化对象、参数如何确定、哪些值参与低精度计算。动态量化通常指运行时求参数，也不应和“自动选择每层位宽”混为一谈。</p>

<h2 id="九压缩与部署从位宽算到完整开销">九、压缩与部署：从位宽算到完整开销</h2>

<h3 id="1-权重存储按位宽线性变化">1. 权重存储按位宽线性变化</h3>

<p>若有 $N$ 个参数，每个使用 $b$ 位，紧密存储且暂不计额外信息，权重占用为：</p>

\[B_{\mathrm{weights}}=\frac{Nb}{8}\quad\text{字节}.\]

<p>以十进制 70 亿参数为教学规模：</p>

<table>
  <thead>
    <tr>
      <th>表示</th>
      <th style="text-align: right">每参数字节数</th>
      <th style="text-align: right">原始权重大小</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>FP32</td>
      <td style="text-align: right">4</td>
      <td style="text-align: right">28 GB</td>
    </tr>
    <tr>
      <td>FP16 / BF16</td>
      <td style="text-align: right">2</td>
      <td style="text-align: right">14 GB</td>
    </tr>
    <tr>
      <td>INT8</td>
      <td style="text-align: right">1</td>
      <td style="text-align: right">7 GB</td>
    </tr>
    <tr>
      <td>4 位紧密存储</td>
      <td style="text-align: right">0.5</td>
      <td style="text-align: right">3.5 GB</td>
    </tr>
  </tbody>
</table>

<p>这里 $1\ \mathrm{GB}=10^9$ 字节。从 32 位到 8 位，原始存储降为四分之一，表示开销按位宽线性变化；可表示码的数量则与 $2^b$ 有关。这两个关系不能混用。</p>

<p>分组量化还要保存元数据。例如每 128 个权重保存一个 2 字节比例系数，且不考虑零点、对齐和其他内容，4 位权重的平均存储变为：</p>

\[0.5+\frac{2}{128}=0.515625
\quad\text{字节/参数}.\]

<p>70 亿参数约占 3.609375 GB。这个例子说明为什么量化文件大小通常不会恰好等于“参数量乘位宽”。</p>

<h3 id="2-权重之外还有上下文缓存">2. 权重之外还有上下文缓存</h3>

<p>作为上下文与硬件开销的补充，常规注意力的 KV Cache 可以按形状估算。设层数为 $L$、批次为 $B$、缓存长度为 $T$、KV 头数为 $h_{\mathrm{kv}}$、每头维度为 $d_h$，每值占 $a$ 字节，则键和值共约占：</p>

\[B_{\mathrm{KV}}=2LBT h_{\mathrm{kv}}d_h a.\]

<p>例如 $L=32$、$B=1$、$T=2048$、$h_{\mathrm{kv}}=8$、$d_h=128$、$a=2$，得到 $268{,}435{,}456$ 字节，即 256 MiB。这是指定缓存形状的裸数据量，未计分配器、块管理和其他运行时开销，也不直接适用于所有压缩注意力结构。</p>

<p>所以，缩小权重、缩短输入、共享 KV 头或改变缓存格式，分别影响不同部分的内存。</p>

<h3 id="3-用任务与系统指标判断收益">3. 用任务与系统指标判断收益</h3>

<p>量化部署需要同时看结果质量、模型体积、峰值内存、时延和吞吐。首 Token 时间、后续 Token 时间、并发和输入长度还会影响测量结果；比较前应固定任务和运行条件。</p>

<p>如果权重量化后速度没有提高，应进一步检查低位宽内核是否实际启用、反量化或格式转换是否成为开销，以及瓶颈是否落在激活、缓存、其他算子或通信上。省下多少字节可以直接核算，快了多少则需要在目标系统上测量。</p>

<h2 id="十复习问答">十、复习问答</h2>

<ol>
  <li>
    <p><strong>Token 为什么不能直接等同于单词或汉字？</strong></p>

    <p>Tokenizer 按具体词表和算法切分文本，一个词可拆成多个 Token，一个字符也可能跨多个字节片段。长度应使用对应 Tokenizer 计算。</p>
  </li>
  <li>
    <p><strong>RAG、MCP 和 Skill 分别解决什么问题？</strong></p>

    <p>RAG 选择并提供相关材料，MCP 规范外部能力与宿主的连接，Skill 提供可复用的任务说明。三者可以配合，但功能不同。</p>
  </li>
  <li>
    <p><strong>模型生成了工具调用请求，是否代表操作已经完成？</strong></p>

    <p>还需要执行器运行并返回结果，再检查目标状态。请求文本与执行证据属于不同阶段。</p>
  </li>
  <li>
    <p><strong>增加 GPU 计算单元为什么可能无法同比加速？</strong></p>

    <p>存储供数、互连、并行规模及其他算子都可能限制吞吐。计算资源需要与数据供给匹配。</p>
  </li>
  <li>
    <p><strong>FP64 是不是小数点后有 64 位？</strong></p>

    <p>FP64 是每值总共 64 位的浮点表示，包含符号、指数和小数部分。</p>
  </li>
  <li>
    <p><strong>FP32 换成 INT8，矩阵乘加次数会降为十六分之一吗？</strong></p>

    <p>相同矩阵形状下不会。原始字节数降为四分之一，运算次数不变；硬件速度和能耗需按低位宽执行路径判断。</p>
  </li>
  <li>
    <p><strong>分通道量化一定是给每个通道不同位宽吗？</strong></p>

    <p>通常是每个通道分别确定量化参数；位宽可以相同。混合位宽是另一项设计选择。</p>
  </li>
  <li>
    <p><strong>为什么 4 位权重的实际内存比参数量乘半字节更大？</strong></p>

    <p>还包含量化参数、对齐、未量化部分及运行时数据；激活和 KV Cache 也需要存储。</p>
  </li>
</ol>

<h2 id="参考资料">参考资料</h2>

<p>课堂范围依据《大模型底层原理与AI芯片加速技术》转写和配套摘要，包含课堂播放的概念讲解。下列官方文档和原论文用于核对术语、公式与实现含义；数值、代码和图为给定条件下的教学计算。</p>

<ol>
  <li>NVIDIA，<em>GPU Performance Background</em>。<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html">官方说明</a>。用于核对硬件执行、算术强度与不同算子类别。</li>
  <li>NVIDIA，<em>Matrix Multiplication Background</em>。<a href="https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html">官方说明</a>。用于核对矩阵乘加数量、分块与访存限制。</li>
  <li>Hugging Face，<em>Tokenization Algorithms</em>。<a href="https://huggingface.co/docs/transformers/main/en/tokenizer_summary">官方说明</a>。</li>
  <li>Lewis 等，<em>Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks</em>，NeurIPS 2020。<a href="https://arxiv.org/abs/2005.11401">原论文</a>。</li>
  <li>Model Context Protocol，<em>Architecture Overview</em>。<a href="https://modelcontextprotocol.io/docs/learn/architecture">官方说明</a>。用于核对 Host、Client、Server 与工具、资源和提示。</li>
  <li>Agent Skills，<em>Specification</em>。<a href="https://agentskills.io/specification">公开格式</a>。用于核对 <code class="language-plaintext highlighter-rouge">SKILL.md</code>、元数据及渐进式披露。</li>
  <li>Oracle，<em>Numerical Computation Guide: IEEE Arithmetic</em>。<a href="https://docs.oracle.com/cd/E19957-01/806-3568/ncg_math.html">浮点格式说明</a>。</li>
  <li>ONNX Runtime，<em>Quantize ONNX Models</em>。<a href="https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html">官方说明</a>。用于核对 scale、zero point、静态/动态量化及 QAT。</li>
  <li>ONNX，<em>QuantizeLinear</em>。<a href="https://onnx.ai/onnx/operators/onnx__QuantizeLinear.html">算子定义</a>。用于核对舍入、饱和与量化粒度。</li>
</ol>]]></content><author><name>RedMoon</name></author><category term="课堂笔记" /><category term="智能计算系统" /><category term="大模型系统" /><category term="MCP" /><category term="Agent Skill" /><category term="GPU" /><category term="量化" /><summary type="html"><![CDATA[从 Token、RAG、MCP 与 Skill 的系统分工，走向 AI 芯片的计算和访存瓶颈，用代码与算例解释量化、存储和实际加速。]]></summary></entry><entry><title type="html">人工智能导论 Day9：对比学习、视觉基础模型与掩码预训练</title><link href="https://redmoon-2333.github.io/2026/11/17/ai-intro-day9/" rel="alternate" type="text/html" title="人工智能导论 Day9：对比学习、视觉基础模型与掩码预训练" /><published>2026-11-17T00:00:00+08:00</published><updated>2026-11-17T00:00:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/17/ai-intro-day9</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/17/ai-intro-day9/"><![CDATA[<blockquote>
  <p>RedMoon · 2026-11-17 整理 · 课堂笔记</p>
</blockquote>

<p>同一张照片经过裁剪、调色之后，模型应当保留什么信息？一张图片怎样与一句描述对应？遮住大部分图像后，剩下的内容能提供多少预测线索？本课围绕这些问题继续讨论自监督学习：用增强视图构造对应关系，用教师网络产生目标分布，或直接预测被遮挡的内容，再把学到的表示迁移到具体任务。开场的增量路径规划分享，则说明了另一个计算思路：环境改变后，怎样复用已有结果。</p>

<h2 id="一开场分享d-lite-怎样复用搜索结果">一、开场分享：D* Lite 怎样复用搜索结果</h2>

<h3 id="1-在未知地图里最短路依赖当前已知信息">1. 在未知地图里，最短路依赖当前已知信息</h3>

<p>机器人出发时可能只知道部分地图。尚未观察的格子暂按可通行处理，靠近后发现障碍，再更新边的代价。此时求得的是当前地图上的最短路径；机器人已经走过的路无法撤销，因此整段实际行程未必等于预先知道完整地图时的最短路。[1]</p>

<p>每次发现障碍都从头运行 A<em>，会重复处理很多没有变化的信息。增量搜索保留上一轮的距离估计，优先修复受边代价变化影响的部分。D</em> Lite 将 LPA* 的增量机制用于移动机器人的重规划，并通过启发式把计算集中到当前决策需要的区域。[1]</p>

<h3 id="2-一致性检查比较的是-g-与-rhs">2. 一致性检查比较的是 g 与 rhs</h3>

<p>以 D* Lite 从目标向当前位置搜索的写法为例，$g(s)$ 估计从节点 $s$ 到目标的代价，$\operatorname{rhs}(s)$ 是根据后继节点计算的一步前瞻值：</p>

\[\operatorname{rhs}(s)=
\begin{cases}
0, &amp; s=s_{\mathrm{goal}},\\
\displaystyle\min_{s'\in\operatorname{Succ}(s)}
\left[c(s,s')+g(s')\right], &amp; s\ne s_{\mathrm{goal}}.
\end{cases}\]

<p>当 $g(s)=\operatorname{rhs}(s)$ 时，节点局部一致。边代价变化后，两者可能不相等，相关节点进入优先队列等待处理。$g(s)&gt;\operatorname{rhs}(s)$ 表示当前距离估计可以降低；$g(s)&lt;\operatorname{rhs}(s)$ 表示原估计可能依赖已经失效的路径，需要撤销并继续传播变化。[1]</p>

<p>启发式 $h$ 用于安排处理顺序，与 $\operatorname{rhs}$ 的作用不同。算法的停止条件还检查队首优先级，因此单个节点局部一致，不能单独说明当前所需的最短路径已经修复完成。</p>

<h3 id="3-反向搜索便于处理移动的起点">3. 反向搜索便于处理移动的起点</h3>

<p>机器人不断移动，目标相对固定。D* Lite 从目标向机器人当前位置传播代价信息，再按边代价加后继估值选择实际前进方向。搜索方向反转，机器人仍然朝目标运动。算法还用键值修正处理起点移动，避免每移动一步就重排整个队列。[1]</p>

<p>分享中比较了节点扩展、节点访问和堆操作等计算量，也讨论了地图分辨率与传感器范围。评价这些指标时，需要结合任务和实现：更少的某一种操作不自动等于更短的总运行时间。</p>

<h2 id="二对比学习训练信号来自样本之间的关系">二、对比学习：训练信号来自样本之间的关系</h2>

<h3 id="1-从图像空间进入表示空间">1. 从图像空间进入表示空间</h3>

<p>图像的像素距离不一定符合语义。狗的头部与腿部外观不同，猫头与狗头却可能在局部纹理上相似。表示学习希望得到适合任务的特征，使同一对象的不同有效视图仍能对应起来。</p>

<p>设图像为 $x$，编码器为 $f_\theta$，表示为：</p>

\[h=f_\theta(x).\]

<p>编码器可以使用 CNN 或 ViT；对比学习描述的是训练目标，可以配合不同网络结构。损失约束表示之间的相对关系，通过反向传播更新编码器参数。[2][3]</p>

<p>常见相似度是余弦相似度：</p>

\[\operatorname{sim}(u,v)=\frac{u^\mathsf T v}{\|u\|_2\|v\|_2}.\]

<p>相似度越大通常表示越接近；欧氏距离则是越小越接近。对单位向量有：</p>

\[\|u-v\|_2^2=2-2u^\mathsf T v.\]

<p>所以在单位球面上，提高点积与减小平方距离方向一致。阅读损失函数时，先确认使用的是距离还是相似度，才能判断优化方向。</p>

<h3 id="2-正样本关系由构造规则决定">2. 正样本关系由构造规则决定</h3>

<p>实例级视觉对比通常独立采样两种增强：</p>

\[v_1=t_1(x),\qquad v_2=t_2(x).\]

<p>同一张原图的两个视图构成正样本，其他原图的视图提供负样本。模型不需要人工给每张图标“猫”或“狗”，但需要知道两个视图来自同一个原始样本。[2]</p>

<p>这也解释了两个容易混淆的情况：</p>

<ul>
  <li>两张不同的猫图，在实例级对比里仍可能互为负样本。这样的“假负样本”来自实例关系与类别语义之间的差别。</li>
  <li>裁剪可能只留下背景，旋转也可能改变某些数字或符号的类别。增强是否合理，要看它是否保留目标任务所需的信息。</li>
</ul>

<p>课堂用人脸识别说明特征提取与相似度检索：先为登记图像提取特征，再把查询图像的特征与库中记录比较。增强训练可以改善部分光照、姿态和遮挡条件下的稳定性，实际识别性能仍要在对应条件下测量。</p>

<h3 id="3-infonce-把对应关系变成分类问题">3. InfoNCE 把对应关系变成分类问题</h3>

<p>设查询为 $q$，正样本为 $k^+$，另有 $K$ 个负样本 $k_j^-$，温度系数为 $\tau&gt;0$：</p>

\[\mathcal L_q=-\log
\frac{\exp\left(\operatorname{sim}(q,k^+)/\tau\right)}
{\exp\left(\operatorname{sim}(q,k^+)/\tau\right)
+\sum_{j=1}^{K}\exp\left(\operatorname{sim}(q,k_j^-)/\tau\right)}.\]

<p>分母包含正样本和全部负样本。训练要求在这些候选中找出正样本，因此损失取决于正样本的相对分数。给全部分数加同一个常数，Softmax 概率保持不变。[2][3]</p>

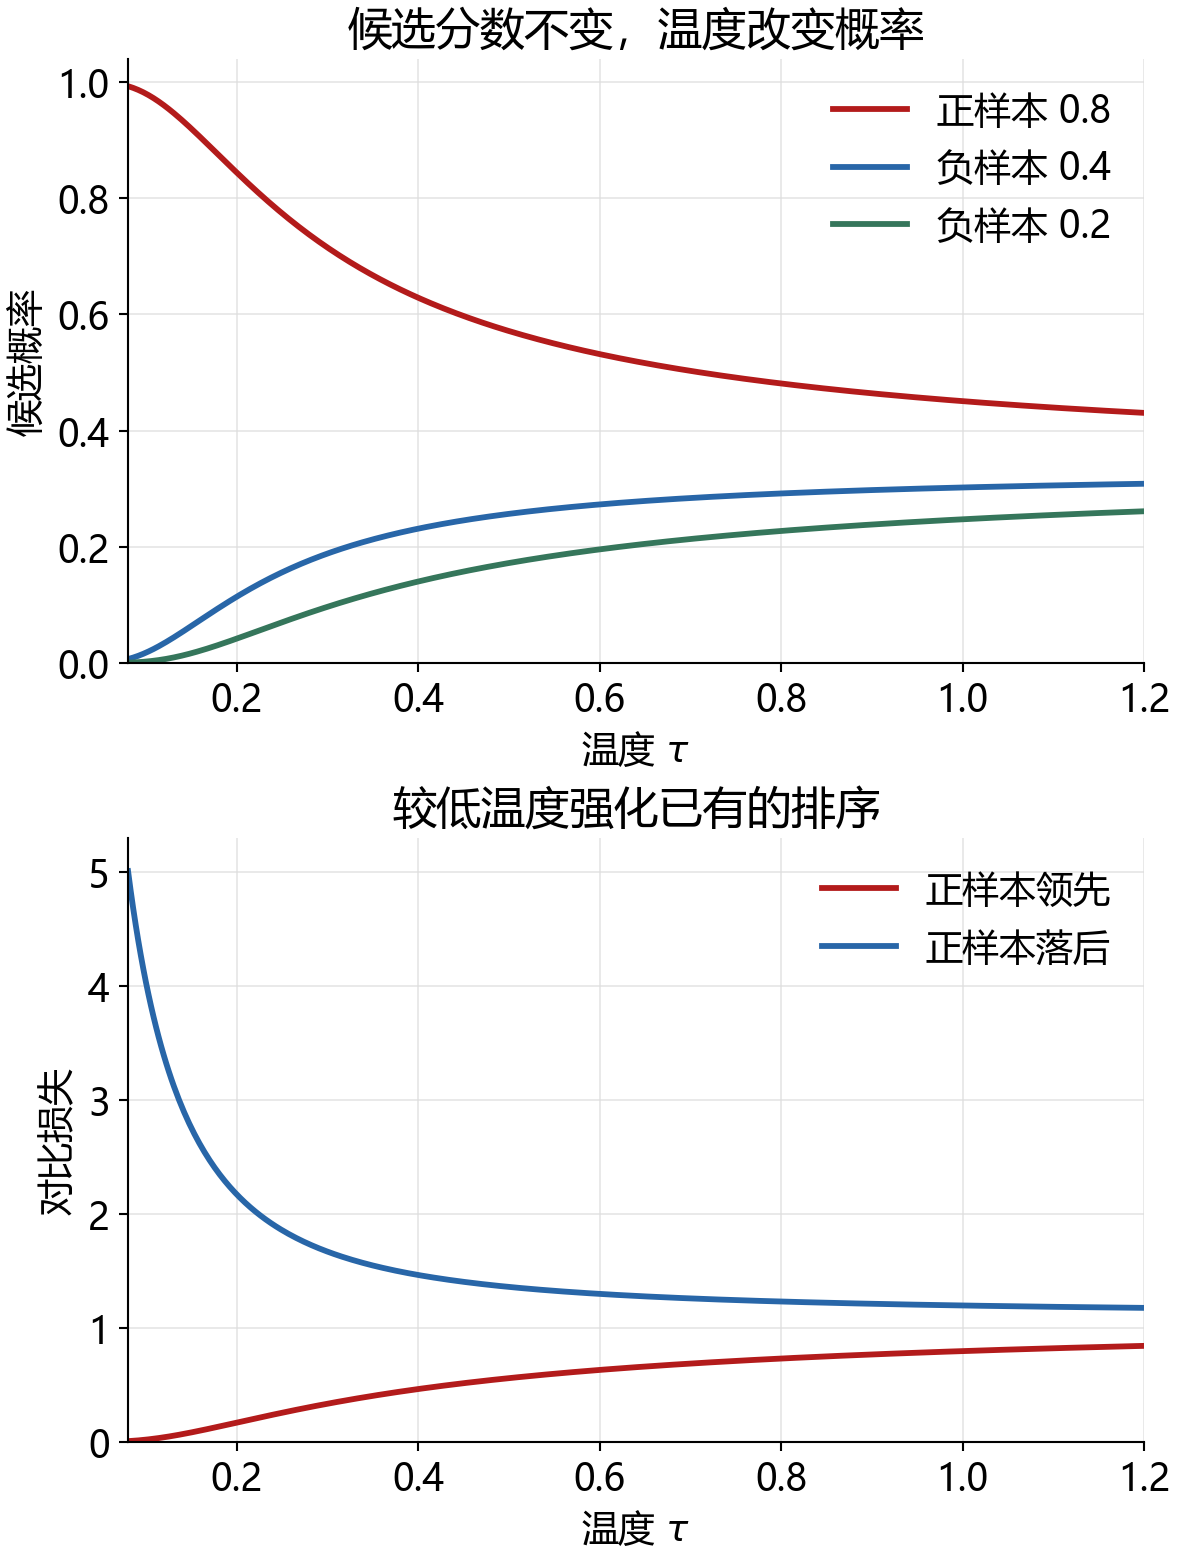
<p>下面固定正样本相似度为 $0.8$，两个负样本为 $0.4$、$0.2$，直接代入公式：</p>

<table>
  <thead>
    <tr>
      <th>温度 $\tau$</th>
      <th style="text-align: right">正样本概率</th>
      <th style="text-align: right">第一个负样本概率</th>
      <th style="text-align: right">第二个负样本概率</th>
      <th style="text-align: right">损失</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>1.0</td>
      <td style="text-align: right">0.4506</td>
      <td style="text-align: right">0.3021</td>
      <td style="text-align: right">0.2473</td>
      <td style="text-align: right">0.7971</td>
    </tr>
    <tr>
      <td>0.5</td>
      <td style="text-align: right">0.5713</td>
      <td style="text-align: right">0.2567</td>
      <td style="text-align: right">0.1721</td>
      <td style="text-align: right">0.5599</td>
    </tr>
    <tr>
      <td>0.1</td>
      <td style="text-align: right">0.9796</td>
      <td style="text-align: right">0.0179</td>
      <td style="text-align: right">0.0024</td>
      <td style="text-align: right">0.0206</td>
    </tr>
  </tbody>
</table>

<p><img src="/assets/img/ai-intro-day9/contrastive-temperature.png" alt="固定相似度下，温度对候选概率和对比损失的影响" /></p>

<blockquote>
  <p>图 1：根据 Softmax 和负对数概率直接计算的教学曲线。上图使用相似度 $[0.8,0.4,0.2]$；下图另加入正样本为 $0.4$、负样本为 $0.8$ 和 $0.2$ 的情况。较低温度会强化已有排序：正样本领先时损失变小，落后时损失反而增大。这些曲线没有进行模型训练。</p>
</blockquote>

<p>将相似度记为 $s_j$，其 Softmax 概率记为 $p_j$，则：</p>

\[\frac{\partial\mathcal L}{\partial s_j}
=\frac{p_j-\mathbb 1[j=+]}{\tau}.\]

<p>这个式子说明温度还会改变分数梯度的尺度及其分配。因此，不能仅凭固定分数下的低损失选择训练温度，也不能把降低温度当作已经学出了更好的表示。</p>

<h2 id="三simclr用批内视图完成对比">三、SimCLR：用批内视图完成对比</h2>

<h3 id="1-一个批次怎样组织">1. 一个批次怎样组织</h3>

<p>取 $N$ 张原图，每张生成两个增强视图，共得到 $2N$ 个输入。两个分支共用编码器，再经过非线性投影头：</p>

\[h_i=f_\theta(v_i),\qquad z_i=g_\theta(h_i).\]

<p>对某个锚点而言，另一个同源视图是正样本，其他 $2N-2$ 个视图是负样本。排除锚点自身后，分母共有 $2N-1$ 个候选。每个视图都轮流作为锚点，最后对这些损失求平均。[2]</p>

<p>SimCLR 强调增强组合、非线性投影头以及较大批次的作用。$h$ 是编码器表示，$z$ 是为对比目标进一步变换后的向量；原论文的下游评估使用编码器表示，不能默认把投影头输出直接当作所有下游任务的最佳特征。[2]</p>

<h3 id="2-最小损失计算">2. 最小损失计算</h3>

<p>下面只实现损失。约定 <code class="language-plaintext highlighter-rouge">z1[i]</code> 与 <code class="language-plaintext highlighter-rouge">z2[i]</code> 来自同一张图，两个张量的行顺序必须对应：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">torch</span>
<span class="kn">import</span> <span class="nn">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>

<span class="k">def</span> <span class="nf">simclr_loss</span><span class="p">(</span><span class="n">z1</span><span class="p">,</span> <span class="n">z2</span><span class="p">,</span> <span class="n">tau</span><span class="o">=</span><span class="mf">0.5</span><span class="p">):</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">z1</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">z</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="n">normalize</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">([</span><span class="n">z1</span><span class="p">,</span> <span class="n">z2</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="n">z</span> <span class="o">@</span> <span class="n">z</span><span class="p">.</span><span class="n">T</span> <span class="o">/</span> <span class="n">tau</span>
    <span class="n">diagonal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">n</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">z</span><span class="p">.</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">)</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="n">masked_fill</span><span class="p">(</span><span class="n">diagonal</span><span class="p">,</span> <span class="nb">float</span><span class="p">(</span><span class="s">"-inf"</span><span class="p">))</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">arange</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">n</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">z</span><span class="p">.</span><span class="n">device</span><span class="p">)</span> <span class="o">+</span> <span class="n">n</span><span class="p">)</span> <span class="o">%</span> <span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">n</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="n">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">labels</span><span class="p">)</span>

<span class="n">z1</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">requires_grad</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">z2</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">eye</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">requires_grad</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">loss</span> <span class="o">=</span> <span class="n">simclr_loss</span><span class="p">(</span><span class="n">z1</span><span class="p">,</span> <span class="n">z2</span><span class="p">)</span>
<span class="n">loss</span><span class="p">.</span><span class="n">backward</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="nb">round</span><span class="p">(</span><span class="n">loss</span><span class="p">.</span><span class="n">item</span><span class="p">(),</span> <span class="mi">6</span><span class="p">))</span>  <span class="c1"># 0.239545
</span></code></pre></div></div>

<p>拼接后的正样本索引依次为 $[2,3,0,1]$。示例中正样本相似度为 1，其余两个候选为 0，温度为 $0.5$，每个锚点的损失都等于：</p>

\[-\log\frac{e^2}{e^2+2}\approx0.239545.\]

<p>实际训练还要在前面加入图像增强、编码器和投影头，在后面加入优化器更新。这里的单位向量是为核对索引和公式构造的输入。</p>

<h2 id="四moco队列扩大字典动量更新维持一致性">四、MoCo：队列扩大字典，动量更新维持一致性</h2>

<h3 id="1-历史特征为什么会过时">1. 历史特征为什么会过时</h3>

<p>如果把先前批次的特征保存下来，就能在较小当前批次之外使用更多候选。但编码器每轮都在更新：旧特征来自旧参数，新查询来自新参数，二者可能不在足够一致的表示空间中。</p>

<p>MoCo 将对比学习看成字典查询。当前查询编码器产生 $q$，键编码器产生 $k$；队列保存近期批次的键，新键入队、较早的键出队。字典大小因此与当前小批次大小解耦。[3]</p>

<p>这个训练队列与实际人脸检索中的身份特征库用途不同。前者为优化目标提供候选键，后者保存部署系统的登记记录；它们都存向量，但更新规则和评价目标不同。</p>

<h3 id="2-两个编码器怎样更新">2. 两个编码器怎样更新</h3>

<p>查询编码器参数 $\theta_q$ 通过损失反向传播更新；键编码器采用指数移动平均：</p>

\[\theta_k\leftarrow m\theta_k+(1-m)\theta_q,\qquad 0\leq m&lt;1.\]

<p>较大的 $m$ 让键编码器变化更平缓，从而减轻跨批次特征不一致。原始 MoCo 中，键分支不按普通损失梯度直接更新参数。[3]</p>

<p>一个标量示例：旧键参数为 1，更新后的查询参数为 2，若 $m=0.9$，新键参数为 $1.1$。这是对参数做移动平均，与把队列中的所有旧向量重新编码不同。</p>

<h3 id="3-与-simclr-对照">3. 与 SimCLR 对照</h3>

<table>
  <thead>
    <tr>
      <th>问题</th>
      <th>SimCLR</th>
      <th>原始 MoCo</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>候选特征主要来自哪里</td>
      <td>当前批次的增强视图</td>
      <td>当前正样本与近期键队列</td>
    </tr>
    <tr>
      <td>怎样获得较多负样本</td>
      <td>增大批次会增加批内候选</td>
      <td>通过队列维护较大字典</td>
    </tr>
    <tr>
      <td>分支参数怎样变化</td>
      <td>共用可训练编码器</td>
      <td>查询梯度更新、键动量更新</td>
    </tr>
    <tr>
      <td>主要实现关注点</td>
      <td>增强、批次与正样本索引</td>
      <td>队列进出、键的梯度隔离与一致性</td>
    </tr>
  </tbody>
</table>

<p>两者都依赖正样本构造。队列解决候选组织问题，无法修复把语义不同的视图错误配为正样本的问题。</p>

<h2 id="五vit把图像转换为带位置的-patch-序列">五、ViT：把图像转换为带位置的 Patch 序列</h2>

<h3 id="1-切块改变输入组织方式">1. 切块改变输入组织方式</h3>

<p>ViT 把图像切成固定大小的块，将每块展平并映射为 Token，再加入位置嵌入，交给 Transformer。若图像大小为 $H\times W$、Patch 边长为 $P$，且能够整除，则 Patch 数量为：</p>

\[N=\frac{HW}{P^2}.\]

<p>对于 $224\times224$ 的 RGB 图像与 $16\times16$ 的 Patch：</p>

\[N=14\times14=196,\qquad P^2C=16\times16\times3=768.\]

<p>768 是每块展开后的原始维度；映射后的 Token 维度由模型设计决定，并非总是 768。采用分类 Token 的配置还会额外加入一个 Token。[4]</p>

<h3 id="2-序列不等于时间">2. 序列不等于时间</h3>

<p>图像块排成序列，是为了使用 Transformer 的输入形式。原始图像仍是二维空间数据，位置嵌入负责保留各块的空间身份。</p>

<p>CNN 的卷积层通常通过局部邻域与参数共享处理图像，多层叠加后也能形成大范围感受野。全局自注意力则允许一个 Patch 直接与其他可见 Patch 交换信息。两类结构的归纳偏置和计算方式不同，效果还取决于训练数据、规模及任务。[4]</p>

<p>ViT 原论文于 2020 年公开，并发表于 ICLR 2021；不能把它引入视觉的时间统一写成 2022 年。[4] 自监督训练可以用于 ViT，有监督分类也可以用于 ViT，网络结构与监督方式需要分开辨认。</p>

<h2 id="六dino用自蒸馏学习视觉表示">六、DINO：用自蒸馏学习视觉表示</h2>

<h3 id="1-教师目标由训练过程形成">1. 教师目标由训练过程形成</h3>

<p>DINO 对同一图像生成不同视图，分别输入学生和教师网络。学生通过梯度更新，教师参数由学生参数的指数移动平均得到。教师输出提供目标分布，学生学习在另一视图上给出相符的分布。[5]</p>

<p>这类自蒸馏中的教师可以与学生采用相同架构；教师身份来自更新方式，并不要求预先训练好一个更大、更强的模型。这与先训练大模型、再把能力蒸馏到小模型的常见压缩流程有所不同。</p>

<p>若教师与学生分布分别为 $p_t$、$p_s$，一个跨视图匹配项可写成：</p>

\[\mathcal L_{\mathrm{DINO}}
=-\sum_k\operatorname{sg}\!\left[p_t^{(k)}(v_1)\right]
\log p_s^{(k)}(v_2).\]

<p>$\operatorname{sg}$ 表示停止梯度。索引 $k$ 对应输出分布的维度，不必解释成人工标注的类别。实际目标会组合多个有效视图对。[5]</p>

<h3 id="2-一致性训练需要防止表示坍塌">2. 一致性训练需要防止表示坍塌</h3>

<p>如果所有图像都输出同一个分布，视图之间也能看起来很一致，却没有留下区分图像的信息。DINO 结合教师输出居中、温度锐化、教师动量更新和多裁剪训练来组织学习，不能只保留“两个输出做交叉熵”就认为复现了完整方法。[5]</p>

<p>课堂展示的自监督 ViT 注意力和特征，说明在不使用对应人工像素标签的训练中，也能出现与对象区域相关的结构。这类可视化展示特征中的信息；要完成语义分割等任务，还需相应的预测与评估流程。</p>

<p>DINOv2 进一步强调大规模、多样且经过筛选的数据，以及训练稳定性和模型蒸馏。它将学习通用视觉特征作为目标，研究图像级和像素级表示的可迁移性。[6]</p>

<h2 id="七clip让图像和文本在同一空间中匹配">七、CLIP：让图像和文本在同一空间中匹配</h2>

<h3 id="1-从同模态视图到跨模态对应">1. 从同模态视图到跨模态对应</h3>

<p>SimCLR 比较同一图像的不同视图。CLIP 使用图像—文本对，让图像编码器与文本编码器分别产生向量，再在共同空间中比较相似度。原论文使用约 4 亿个互联网图文对进行训练，文本提供了自然语言监督。[7]</p>

<p>一个包含 $N$ 个匹配图文对的批次，可以得到 $N\times N$ 的相似度矩阵：</p>

\[S_{ij}=\frac{\hat u_i^\mathsf T\hat v_j}{\tau}.\]

<p>$\hat u_i$、$\hat v_j$ 分别是归一化后的图像和文本表示。在标准配对约定下，对角线 $(i,i)$ 是正确匹配。图到文方向按行找对应文本，文到图方向按列找对应图像，再对两个方向的交叉熵取平均：[7]</p>

\[\mathcal L_{\mathrm{CLIP}}
=-\frac{1}{2N}\sum_{i=1}^{N}
\left[
\log\frac{e^{S_{ii}}}{\sum_j e^{S_{ij}}}
+
\log\frac{e^{S_{ii}}}{\sum_j e^{S_{ji}}}
\right].\]

<p>图文配对也会有噪声：一段描述可能只覆盖图片的一部分，同批次中也可能有语义相近的其他图片或文本。数据规模与清洗会影响这种对应信号的质量。</p>

<h3 id="2-零样本分类怎样实现">2. 零样本分类怎样实现</h3>

<p>给定候选类别，为每一类写一条文本提示，例如“一张猫的照片”“一张狗的照片”。先编码这些文本，再把待分类图像与它们比较：</p>

\[\hat c=\arg\max_c\operatorname{sim}
\left(f_{\mathrm{image}}(x),f_{\mathrm{text}}(t_c)\right).\]

<p>这样就把分类改写为图文匹配。这里的零样本指对目标数据集不再使用其训练样本进行任务专门训练，并不表示模型此前没有见过相关视觉概念或语言描述。候选类别、提示写法和数据分布都会影响结果。[7]</p>

<p>原始 CLIP 双塔输出匹配表示与分数。自动生成图像描述或给每个像素分配类别，需要进一步的模型结构和任务处理；课堂提到的视觉语言模型应用不能全部等同于原始 CLIP 的直接输出。</p>

<h2 id="八掩码建模从已有数据中产生预测目标">八、掩码建模：从已有数据中产生预测目标</h2>

<h3 id="1-自回归预测与掩码预测的可见信息不同">1. 自回归预测与掩码预测的可见信息不同</h3>

<p>自回归语言建模利用已有前缀预测下一个 Token：</p>

\[\mathcal L_{\mathrm{AR}}
=-\sum_t\log p_\theta(x_t\mid x_{\lt t}).\]

<p>目标 Token 已经包含在原始文本中，因此可以自动构造训练对。训练时要通过因果掩码限制可见范围，避免当前位置读取未来答案。预测结果再与真实 Token 比较，梯度由预测概率回到网络参数。</p>

<p>BERT 的掩码语言建模则允许利用被选中位置两侧的上下文。原始方案选取约 15% 的 Token 参与预测，其中约 80% 替换为 <code class="language-plaintext highlighter-rouge">[MASK]</code>，10% 替换为随机 Token，10% 保持原样；预测目标始终是原 Token。15% 表示被选中的预测位置比例，不等于全部直接换成 <code class="language-plaintext highlighter-rouge">[MASK]</code>。[8]</p>

<p>输入内容遮挡、注意力的可见性限制，以及权重或激活的随机丢弃，作用位置不同。它们都可能被口头称作“掩码”，阅读实现时需要看掩码具体施加在哪里。</p>

<h3 id="2-beit预测离散视觉-token">2. BEiT：预测离散视觉 Token</h3>

<p>语言有离散词表，图像块原本是连续像素。BEiT 借助视觉 Tokenizer 把原图转换为离散视觉 Token，再根据受遮挡的图像块预测对应位置的 Token 编号。目标因此是离散预测，而不是直接把全部像素值作为回归目标。[9]</p>

<p>课堂提到的“图像块输入模型，同时用离散编码器提供目标”，可以沿这一思路理解。图像输入与预测目标的表示可以不同，关键是保留位置对应关系。</p>

<h3 id="3-mae重编码器只看可见块">3. MAE：重编码器只看可见块</h3>

<p>MAE 采用非对称编码器—解码器：[10]</p>

<ol>
  <li>把图像切成 Patch，随机遮挡其中较大一部分。</li>
  <li>编码器只接收可见 Patch 及其位置，不把全部 Mask Token 送入重编码器。</li>
  <li>将可见块的编码结果映射到解码器维度，再补入可学习的 Mask Token。</li>
  <li>恢复完整序列的位置顺序，加入解码器位置嵌入，预测像素。</li>
  <li>主要在被遮挡位置计算重建误差；预训练后使用编码器适配下游任务。</li>
</ol>

<p>原始 MAE 的典型图像配置使用 75% 掩码率。以 196 个 Patch 为例：</p>

\[N_{\mathrm{visible}}=196\times0.25=49,\qquad
N_{\mathrm{masked}}=147.\]

<p>不计分类 Token、且保持其他条件不变时，编码器注意力分数矩阵的元素数量由 $196^2$ 降至 $49^2$，比例为：</p>

\[\left(\frac{49}{196}\right)^2=\frac{1}{16}.\]

<p>这是注意力矩阵规模的比较。完整训练仍包含线性投影、前馈层和处理完整序列的轻量解码器，不能据此把整套训练速度写成提高 16 倍。MAE 的计算节省来自可见 Token 编码和非对称设计，也不应直接改称一般意义上的“稀疏注意力”。[10]</p>

<h3 id="4-重建损失计算在哪些位置">4. 重建损失计算在哪些位置</h3>

<p>设被遮挡位置集合为 $\mathcal M$，每块含 $d$ 个像素通道数值，则可写为：</p>

\[\mathcal L_{\mathrm{MAE}}
=\frac{1}{|\mathcal M|}
\sum_{i\in\mathcal M}
\frac{1}{d}\|\hat x_i-x_i\|_2^2.\]

<p>原始实现也提供按 Patch 归一化像素目标的配置。下面对应未归一化的像素均方误差，假设至少遮挡一个 Patch：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">masked_patch_mse</span><span class="p">(</span><span class="n">pred</span><span class="p">,</span> <span class="n">target</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
    <span class="c1"># pred、target: [batch, patches, pixel_values]
</span>    <span class="c1"># mask: [batch, patches]，1 表示被遮挡
</span>    <span class="n">per_patch</span> <span class="o">=</span> <span class="p">(</span><span class="n">pred</span> <span class="o">-</span> <span class="n">target</span><span class="p">).</span><span class="n">square</span><span class="p">().</span><span class="n">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="p">(</span><span class="n">per_patch</span> <span class="o">*</span> <span class="n">mask</span><span class="p">).</span><span class="nb">sum</span><span class="p">()</span> <span class="o">/</span> <span class="n">mask</span><span class="p">.</span><span class="nb">sum</span><span class="p">()</span>

<span class="n">pred</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">tensor</span><span class="p">([[[</span><span class="mf">1.0</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">],</span> <span class="p">[</span><span class="mf">100.0</span><span class="p">,</span> <span class="mf">100.0</span><span class="p">]]])</span>
<span class="n">target</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">tensor</span><span class="p">([[[</span><span class="mf">0.0</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">],</span> <span class="p">[</span><span class="mf">0.0</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">]]])</span>
<span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">tensor</span><span class="p">([[</span><span class="mf">1.0</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">]])</span>
<span class="k">print</span><span class="p">(</span><span class="n">masked_patch_mse</span><span class="p">(</span><span class="n">pred</span><span class="p">,</span> <span class="n">target</span><span class="p">,</span> <span class="n">mask</span><span class="p">).</span><span class="n">item</span><span class="p">())</span>  <span class="c1"># 2.5
</span></code></pre></div></div>

<p>第二个 Patch 虽然误差很大，但它没有被选入掩码损失；第一个 Patch 的平均平方误差为 $(1+4)/2=2.5$。如果把可见位置也一起平均，优化的目标就改变了。</p>

<p>图像局部有较强冗余，这为高比例遮挡后的预测提供了线索。重建图像合理，并不意味着模型恢复了所有真实细节；迁移价值仍需通过下游分类、检测或其他具体任务评价。</p>

<h2 id="九预训练之后怎样使用已有表示">九、预训练之后：怎样使用已有表示</h2>

<h3 id="1-冻结全量更新与参数高效适配">1. 冻结、全量更新与参数高效适配</h3>

<p>预训练得到可复用的参数，下游任务再决定如何利用它们：</p>

<table>
  <thead>
    <tr>
      <th>方式</th>
      <th>哪些参数参与学习</th>
      <th>适合观察什么</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>特征提取与检索</td>
      <td>编码器冻结，建立或更新特征索引</td>
      <td>现有表示是否支持匹配与检索</td>
    </tr>
    <tr>
      <td>线性探测</td>
      <td>编码器冻结，只训练线性任务头</td>
      <td>固定表示对目标类别的线性可分性</td>
    </tr>
    <tr>
      <td>全量微调</td>
      <td>编码器及任务相关参数共同更新</td>
      <td>在指定数据和预算下适配目标任务</td>
    </tr>
    <tr>
      <td>LoRA 等参数高效方法</td>
      <td>主干通常冻结，训练新增的适配参数</td>
      <td>用较少可训练参数调整模型行为</td>
    </tr>
  </tbody>
</table>

<p>线性探测成绩、全量微调成绩和零样本迁移成绩对应不同条件。比较结果时应同时说明训练数据、更新范围及评价任务，才能判断表示或适配方法的贡献。</p>

<h3 id="2-lora-学习低秩更新">2. LoRA 学习低秩更新</h3>

<p>对于原权重 $W_0\in\mathbb R^{d_{\mathrm{out}}\times d_{\mathrm{in}}}$，LoRA 使用：</p>

\[W=W_0+\frac{\alpha}{r}BA,\]

\[B\in\mathbb R^{d_{\mathrm{out}}\times r},\qquad
A\in\mathbb R^{r\times d_{\mathrm{in}}}.\]

<p>训练时冻结 $W_0$，更新 $A$ 和 $B$。新增可训练参数数目为 $r(d_{\mathrm{in}}+d_{\mathrm{out}})$，低于直接训练完整矩阵的 $d_{\mathrm{in}}d_{\mathrm{out}}$。[11]</p>

<p>例如，单个 $4096\times4096$ 矩阵有 $16{,}777{,}216$ 个参数；取 $r=8$ 时，两个低秩矩阵共含 $65{,}536$ 个参数，是前者的约 $0.3906\%$。这个比例针对该权重矩阵，不等于整个模型的总可训练参数比例。</p>

<p>低秩约束针对的是更新矩阵的结构。$BA$ 可以是稠密矩阵，LoRA 并不是按“高频知识”挑出原权重中的少量元素来训练。它减少可训练参数、梯度和相关优化器状态，主干权重及前向计算仍需相应资源；能否在某块显卡上训练，还取决于模型大小、精度、序列长度和实现。[11]</p>

<h3 id="3-把架构目标和适配方式分开">3. 把架构、目标和适配方式分开</h3>

<p>ViT 描述网络如何处理图像；SimCLR、MoCo、DINO、CLIP、BEiT 和 MAE 描述不同的训练组织与目标；线性探测、全量微调和 LoRA 则决定下游如何使用参数。这些维度可以组合。</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>输入关系</th>
      <th>主要预测目标</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>SimCLR</td>
      <td>同一图像的两个增强视图</td>
      <td>在批内候选中找到同源视图</td>
    </tr>
    <tr>
      <td>MoCo</td>
      <td>查询、当前正样本与近期键队列</td>
      <td>在较大动态字典中完成对比</td>
    </tr>
    <tr>
      <td>DINO</td>
      <td>同一图像的不同裁剪</td>
      <td>匹配动量教师的目标分布</td>
    </tr>
    <tr>
      <td>CLIP</td>
      <td>配对图像与文本</td>
      <td>双向找到匹配的另一模态</td>
    </tr>
    <tr>
      <td>BEiT</td>
      <td>受遮挡图像与离散视觉目标</td>
      <td>预测被遮挡位置的视觉 Token</td>
    </tr>
    <tr>
      <td>MAE</td>
      <td>少量可见图像块</td>
      <td>重建被遮挡位置的像素</td>
    </tr>
  </tbody>
</table>

<p>自动构造目标扩大了可用于训练的数据范围。增强保留什么、图文是否对应、遮挡哪些位置，都会改变模型受到的学习信号。</p>

<h2 id="十复习问答">十、复习问答</h2>

<ol>
  <li>
    <p><strong>对比学习需要人工类别标签吗？</strong></p>

    <p>实例级自监督对比可以根据同一原图的增强关系构造正样本，无需逐张提供类别。但训练仍依赖明确的正负样本构造规则。</p>
  </li>
  <li>
    <p><strong>为什么不能只说“拉近正样本，推远负样本”？</strong></p>

    <p>还要说明表示是否归一化、使用何种相似度、比较哪些候选，以及损失如何归一化。InfoNCE 约束的是正样本在候选集合中的相对分数。</p>
  </li>
  <li>
    <p><strong>SimCLR 每个锚点为什么只有 $2N-2$ 个负样本？</strong></p>

    <p>$2N$ 个视图中，要排除锚点自身和一个同源正样本；分母仍包含正样本，因此有 $2N-1$ 个候选。</p>
  </li>
  <li>
    <p><strong>MoCo 为什么同时需要队列和动量编码器？</strong></p>

    <p>队列扩大字典，动量编码器减缓跨批次表示变化。单独保存旧特征，可能遇到旧键与新查询不一致的问题。</p>
  </li>
  <li>
    <p><strong>DINO 的教师一定比学生大吗？</strong></p>

    <p>不一定。其教师可以采用同样架构，通过学生参数的移动平均形成。教师分布停止梯度，学生按损失更新。</p>
  </li>
  <li>
    <p><strong>CLIP 的零样本分类为什么还需要类别文本？</strong></p>

    <p>文本为候选类别提供表示，图像通过与这些文本匹配完成选择。更换类别集合或提示，会改变分类问题。</p>
  </li>
  <li>
    <p><strong>MAE 遮挡 75%，为什么编码器只接收 25% 的 Patch？</strong></p>

    <p>它将 Mask Token 放在较轻的解码阶段补入。重编码器省去被遮挡位置的处理，是非对称设计的重要部分。</p>
  </li>
  <li>
    <p><strong>LoRA 参数很少，为什么仍可能放不进显存？</strong></p>

    <p>主干权重、激活与运行开销仍然存在。可训练参数少，不能替代对整套模型资源需求的估计。</p>
  </li>
</ol>

<h2 id="参考资料">参考资料</h2>

<p>课堂范围依据本次计算机视觉自监督学习转写及配套摘要。下列原始资料用于核对算法定义和实现；文中的概率表、单位向量、掩码误差和参数数量是解释机制的教学算例。</p>

<ol>
  <li>Koenig、Likhachev，D* Lite，AAAI 2002。<a href="https://idm-lab.org/bib/abstracts/papers/aaai02b.pdf">作者提供的论文</a>。重点核对 LPA*、局部一致性与反向增量搜索。</li>
  <li>Chen 等，<em>A Simple Framework for Contrastive Learning of Visual Representations</em>，ICML 2020。<a href="https://proceedings.mlr.press/v119/chen20j.html">论文页面</a>。</li>
  <li>He 等，<em>Momentum Contrast for Unsupervised Visual Representation Learning</em>，CVPR 2020。<a href="https://arxiv.org/abs/1911.05722">论文页面</a>。</li>
  <li>Dosovitskiy 等，<em>An Image Is Worth 16×16 Words: Transformers for Image Recognition at Scale</em>，ICLR 2021。<a href="https://arxiv.org/abs/2010.11929">论文页面</a>。</li>
  <li>Caron 等，<em>Emerging Properties in Self-Supervised Vision Transformers</em>，ICCV 2021。<a href="https://arxiv.org/abs/2104.14294">论文</a>、<a href="https://github.com/facebookresearch/dino/blob/main/main_dino.py">作者实现</a>。</li>
  <li>Oquab 等，<em>DINOv2: Learning Robust Visual Features without Supervision</em>，2023。<a href="https://arxiv.org/abs/2304.07193">论文页面</a>。</li>
  <li>Radford 等，<em>Learning Transferable Visual Models From Natural Language Supervision</em>，ICML 2021。<a href="https://proceedings.mlr.press/v139/radford21a.html">论文页面</a>。</li>
  <li>Devlin 等，<em>BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding</em>，NAACL 2019。<a href="https://arxiv.org/abs/1810.04805">论文</a>、<a href="https://github.com/google-research/bert/blob/master/create_pretraining_data.py">作者的数据构造实现</a>。</li>
  <li>Bao 等，<em>BEiT: BERT Pre-Training of Image Transformers</em>，ICLR 2022。<a href="https://arxiv.org/abs/2106.08254">论文页面</a>。</li>
  <li>He 等，<em>Masked Autoencoders Are Scalable Vision Learners</em>，CVPR 2022。<a href="https://arxiv.org/abs/2111.06377">论文</a>、<a href="https://github.com/facebookresearch/mae/blob/main/models_mae.py">作者实现</a>。</li>
  <li>Hu 等，<em>LoRA: Low-Rank Adaptation of Large Language Models</em>，ICLR 2022。<a href="https://arxiv.org/abs/2106.09685">论文页面</a>；本地原文用于核对低秩分解与冻结权重。</li>
</ol>]]></content><author><name>RedMoon</name></author><category term="课堂笔记" /><category term="人工智能导论" /><category term="自监督学习" /><category term="对比学习" /><category term="DINO" /><category term="CLIP" /><category term="MAE" /><category term="LoRA" /><summary type="html"><![CDATA[从增量重规划转向自监督视觉表示，梳理 SimCLR、MoCo、DINO、CLIP 与掩码预训练，并用公式、代码和算例解释模型如何学习与迁移。]]></summary></entry><entry><title type="html">LLM 与多智能体强化学习：从策略更新到协作信号</title><link href="https://redmoon-2333.github.io/2026/11/16/llm-rl-research-map/" rel="alternate" type="text/html" title="LLM 与多智能体强化学习：从策略更新到协作信号" /><published>2026-11-16T00:00:00+08:00</published><updated>2026-11-16T00:00:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/16/llm-rl-research-map</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/16/llm-rl-research-map/"><![CDATA[<p>大语言模型与多智能体强化学习不是一种单独的算法。研究工作真正分歧的地方，是多智能体系统中的<strong>谁在行动、谁提供训练信号、最终哪组参数被更新</strong>。</p>

<p>本文按截至 2026 年 11 月 14 日可获取全文的 42 篇代表研究整理，覆盖经典合作 MARL、LLM 策略微调、LLM 辅助训练、多模态具身协作及相邻对照方法。这是一份有边界的研究地图，不是穷尽式系统综述。</p>

<p><img src="/assets/img/llm-rl/research_taxonomy.svg" alt="大语言模型与多智能体强化学习的研究分类：依据被优化对象区分经典MARL、直接优化LLM策略、LLM辅助传统MARL、相邻协作研究，并标出多模态具身交叉层" /></p>

<p>图 1：多模态是与算法路线交叉的任务维度；判断一篇工作属于哪条路线，先检查策略是否由奖励信号更新。</p>

<h2 id="1-先问谁在学习">1. 先问“谁在学习”</h2>

<p>强化学习中的策略可以是小型数值网络，也可以是 LLM 的生成分布。系统里出现了 LLM，并不自动说明它的权重正在接受强化学习更新。</p>

<table>
  <thead>
    <tr>
      <th>系统设计</th>
      <th>策略 / 执行关系</th>
      <th>典型判断</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>LLM 直接作为策略</td>
      <td>LLM 生成动作、消息或文本决策；奖励经策略梯度进入模型参数或适配器</td>
      <td>这是直接优化 LLM 策略</td>
    </tr>
    <tr>
      <td>LLM 提供训练信号</td>
      <td>LLM 读取轨迹、评价贡献、生成奖励或先验；下层策略另行学习</td>
      <td>LLM 可能被冻结，更新对象是下层策略</td>
    </tr>
    <tr>
      <td>LLM 执行、控制器学习</td>
      <td>小型 Actor 选择检索、分享、写作等动作；LLM 执行文本任务</td>
      <td>优化器更新控制器，不一定更新 LLM</td>
    </tr>
    <tr>
      <td>LLM 生成教师轨迹</td>
      <td>大模型提供任务分配或协作示范，轻量策略以监督学习模仿</td>
      <td>属于蒸馏，不等于奖励驱动的 MARL</td>
    </tr>
  </tbody>
</table>

<p><img src="/assets/img/llm-rl/credit_signal_loop.svg" alt="从联合策略和交互轨迹到团队结果、信用分配与策略更新的闭环" /></p>

<p>图 2：团队分数需要经过某种信用或奖励机制，才能成为具体策略的更新信号；信号设计不同，回答的问题也不同。</p>

<h2 id="2-经典-marl-是方法底座">2. 经典 MARL 是方法底座</h2>

<p>经典方法解决的是多智能体训练中的不同环节，不能把它们统称为“奖励分配算法”。</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>主要解决的问题</th>
      <th>与 LLM 协作研究的联系</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>MADDPG</td>
      <td>训练期使用集中式 Critic，执行期由局部 Actor 决策</td>
      <td>展示 CTDE 如何在训练中利用联合信息</td>
    </tr>
    <tr>
      <td>VDN</td>
      <td>将联合价值表示为各智能体局部价值之和</td>
      <td>提供简单的团队价值分解基线</td>
    </tr>
    <tr>
      <td>QMIX</td>
      <td>用状态条件的单调混合网络表示联合价值</td>
      <td>在表达力和局部贪心执行之间折中</td>
    </tr>
    <tr>
      <td>COMA</td>
      <td>固定队友实际动作，只反事实替换本人动作来构造优势</td>
      <td>直接比较个体动作对团队价值的相对作用</td>
    </tr>
    <tr>
      <td>MAPPO</td>
      <td>用 PPO 优化合作策略，并系统评估实现选择</td>
      <td>提供强策略优化基线；本身不等于显式反事实归因</td>
    </tr>
  </tbody>
</table>

<p><a href="https://arxiv.org/abs/1706.02275">MADDPG</a>、<a href="https://arxiv.org/abs/1706.05296">VDN</a>、<a href="https://proceedings.mlr.press/v80/rashid18a.html">QMIX</a>、<a href="https://arxiv.org/abs/1705.08926">COMA</a> 与 <a href="https://proceedings.neurips.cc/paper_files/paper/2022/hash/9c1535a02f0ce079433344e14d910597-Abstract-Datasets_and_Benchmarks.html">MAPPO</a> 关注的模块不同。比较论文时，需要说明差异发生在策略优化、价值表示、信用估计还是训练信息边界。</p>

<h2 id="3-直接优化-llm-策略">3. 直接优化 LLM 策略</h2>

<p>这类方法把 LLM 的输出行为当成策略的一部分。模型产生答案、消息、工具调用或角色动作；训练信号经策略优化目标改变这些输出的概率。</p>

<ul>
  <li><a href="https://aclanthology.org/2025.acl-long.1459/">MAPoRL2</a> 让多个 LLM 先独立回答，再进行多轮讨论。Verifier 评价最终答案，并对讨论中的纠正与说服行为提供激励，多个模型共同接受强化学习后训练。</li>
  <li><a href="https://arxiv.org/abs/2504.16129">MARFT</a> 关注传统 MARL 假设与 LLM 智能体系统之间的错配，重点讨论异步交互、不同角色和异构模型下的强化微调框架。它更适合理解为框架与问题建模，而不是一个可替代所有算法的单一更新公式。</li>
  <li><a href="https://proceedings.mlr.press/v306/xie26o.html">TeamTR</a> 关注顺序更新多个共享上下文角色时的分布漂移：一个角色更新后，其他角色面对的上下文分布也随之改变。方法在角色更新后重采样，并限制策略变化幅度。</li>
  <li><a href="https://aclanthology.org/2026.acl-long.1828/">MARCH</a> 让多角色共同参与求解、提出核查意见和证据检查，并对角色条件下的 LLM 行为进行策略训练。</li>
</ul>

<p>这些论文都涉及 LLM 策略学习，但训练目标、角色交互顺序、奖励来源和模型共享方式并不相同。只看到“多个 LLM + PPO/GRPO”不足以判定方法等价。</p>

<h2 id="4-llm-辅助传统-marl">4. LLM 辅助传统 MARL</h2>

<p>另一条路线让 LLM 设计或改善训练信号，再由传统强化学习策略学习动作。此时 LLM 的作用可能是评估器、奖励设计者、先验提供者或文本执行器。</p>

<h3 id="41-用-llm-产生角色信用">4.1 用 LLM 产生角色信用</h3>

<p><a href="https://arxiv.org/abs/2502.16863">LLM-MCA</a> 将多智能体轨迹交给集中式 LLM Critic，要求它分析角色行为并生成个体信用或任务改进信号，再把这些信号接入下层 MARL。它提供的是可读的轨迹判断；语言解释本身不等于已经验证的因果贡献。</p>

<h3 id="42-用-llm-设计奖励">4.2 用 LLM 设计奖励</h3>

<p><a href="https://openreview.net/forum?id=CWYWhLho0a">ReMAC</a> 在上层迭代生成团队级和智能体级奖励函数候选，下层多智能体策略根据候选奖励训练，训练表现再反馈给 LLM 改进奖励设计。LLM 不是每一步都替机器人选动作，关键学习对象仍是下层策略。</p>

<p>这两种方法都试图缓解团队回报难以指导个体学习的问题，但改变的位置不同：LLM-MCA 从轨迹中生成信用判断；ReMAC 改变训练策略所使用的奖励函数。</p>

<h3 id="43-用信息价值训练协作">4.3 用信息价值训练协作</h3>

<p><a href="https://arxiv.org/abs/2610.17893">CoSIR</a> 研究分享、请求和使用队友证据的行为。其核心思路是用团队对正确答案的惊讶程度表示不确定性：</p>

\[\Phi(\mathcal{K})=-\sum_i \log_2 P_i(y^\*\mid \mathcal{K}_i)\]

<p>其中 $\mathcal{K}_i$ 表示智能体 $i$ 当前掌握的证据，$P_i(y^*\mid\mathcal{K}_i)$ 是其证据下正确答案的概率。一次交流的信息奖励可理解为交流前后的 surprisal 差：</p>

\[R_{\text{info}}=\Phi(\mathcal{K}_{\text{before}})-\Phi(\mathcal{K}_{\text{after}})\]

<p>若消息使团队更有把握地选出正确答案，信息奖励为正；没有带来有用变化的消息不应仅因“发过消息”就获得同等奖励。该工作把信息价值转成 LLM 协作策略的后训练信号，与“LLM 冻结、下层 MLP 学动作”的路线不同。</p>

<h2 id="5-llm-执行控制器学习">5. LLM 执行、控制器学习</h2>

<p>判断训练对象时，一个清楚的对照是 <a href="https://aclanthology.org/2026.emnlp-main.2052/">CREW</a>：小型数值 Actor-Critic 根据局部状态选择检索、传播知识、撰写或批评；Qwen 执行具体文本任务。IPPO 更新的是动作控制器，而不是因为系统使用了 Qwen，就自动更新 Qwen 的模型权重。</p>

<p>因此，“强化学习参与了一个含 LLM 的多智能体系统”和“强化学习直接微调了 LLM”是两条不同的结论。需要查看优化器参数、策略损失所用的 log-prob，以及训练前后哪组权重确实发生变化。</p>

<h2 id="6-相邻方法协作不必然是-marl">6. 相邻方法：协作不必然是 MARL</h2>

<p><a href="https://proceedings.mlr.press/v306/zhai26c.html">SynCoord</a> 让高能力教师生成任务级协作轨迹，再用监督学习训练轻量执行策略。它可以降低部署时的推理成本，也可以作为协作策略对照；但学生策略主要通过模仿教师标签训练，不是由环境奖励直接更新。</p>

<p>提示规则搜索、离线协作记忆和固定工作流也可能改善多智能体表现。它们可与 MARL 比较，但要依据参数更新和反馈来源分类，不能只凭多智能体对话或论文标题中的 “reinforcement” 下结论。</p>

<h2 id="7-多模态与具身协作">7. 多模态与具身协作</h2>

<p>多模态方向至少涉及三种不同问题：</p>

<ol>
  <li><strong>多模态输入基准</strong>：智能体接收图像、语言或不同视角，研究环境本身支持什么样的合作评估。</li>
  <li><strong>多模态推理与角色协作</strong>：例如 <a href="https://arxiv.org/abs/2506.00555">MMedAgent-RL</a>，结合医疗影像与不同专科角色进行推理。</li>
  <li><strong>具身或视觉语言动作策略训练</strong>：例如 <a href="https://proceedings.neurips.cc/paper_files/paper/2025/hash/ab16cc8f472cf94b282dbff7b99f5f8e-Abstract-Datasets_and_Benchmarks_Track.html">VIKI-R</a>、<a href="https://arxiv.org/abs/2610.39324">MRC-MMAgent</a> 和 <a href="https://arxiv.org/abs/2609.36588">多智能体 VLA 强化微调</a>，研究视觉信息、动作决策、角色分工和协同控制如何共同进入训练。</li>
</ol>

<p>多模态不仅增加输入种类，也会改变状态编码、动作空间、数据采集、模型延迟和不同角色的信息边界。因而实验除了报告成功率，还应交代训练预算、工具或视觉调用、时延、团队规模与测试分布。</p>

<h2 id="8-跨论文共同难题">8. 跨论文共同难题</h2>

<table>
  <thead>
    <tr>
      <th>难题</th>
      <th>核心问题</th>
      <th>可检验的证据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>团队信用</td>
      <td>团队成功后，某个角色或动作真的起了作用吗？</td>
      <td>反事实替换、成员移除、角色替换及归因误差</td>
    </tr>
    <tr>
      <td>策略非平稳</td>
      <td>一个角色更新后，队友面对的上下文是否变了？</td>
      <td>更新前后重采样、上下文分布和 KL 变化</td>
    </tr>
    <tr>
      <td>奖励与评估器偏差</td>
      <td>策略是在完成任务，还是只学会让评估器给高分？</td>
      <td>独立评估、奖励置换、异常轨迹与人工抽查</td>
    </tr>
    <tr>
      <td>通信成本与兼容性</td>
      <td>消息带来的收益是否超过 token、延迟和协调开销？</td>
      <td>等预算比较、消息消融、不同队友交叉配对</td>
    </tr>
    <tr>
      <td>多模态泛化</td>
      <td>视觉证据、角色能力或环境分布改变后，合作是否仍成立？</td>
      <td>未见场景、角色互换、多随机种子与成本报告</td>
    </tr>
  </tbody>
</table>

<p>对于复杂系统，一个最终准确率无法单独证明信用估计正确、通信不可替代、训练稳定或能够迁移。每种结论都要对应相应的干预和评估条件。</p>

<h2 id="9-可以继续追问的研究问题">9. 可以继续追问的研究问题</h2>

<p>一个可检验的起点是：在部分可观测的多模态协作任务中，能否用可验证的信息价值或反事实信号，让智能体只在确有增益时分享证据，并降低无效通信成本？</p>

<p>可以先设计小型视觉证据协作任务，再逐步比较单体模型、固定提示多智能体、共享团队奖励、COMA 式反事实信用和信息价值奖励。关键是固定模型、训练数据和总预算，并同时报告答题质量、信息来源准确率、消息 token、工具调用、多种子波动及不同队友之间的协议兼容性。</p>

<p>这个问题是研究切入点，不是已验证的创新性结论。评价方法时要先问：<strong>更新了谁、用了什么学习信号、哪项实验支持哪条结论？</strong></p>

<h2 id="代表论文">代表论文</h2>

<ul>
  <li><a href="https://proceedings.neurips.cc/paper_files/paper/2022/hash/9c1535a02f0ce079433344e14d910597-Abstract-Datasets_and_Benchmarks.html">The Surprising Effectiveness of PPO in Cooperative Multi-Agent Games（MAPPO）</a></li>
  <li><a href="https://arxiv.org/abs/1705.08926">Counterfactual Multi-Agent Policy Gradients（COMA）</a></li>
  <li><a href="https://aclanthology.org/2025.acl-long.1459/">MAPoRL2</a> · <a href="https://arxiv.org/abs/2504.16129">MARFT</a> · <a href="https://proceedings.mlr.press/v306/xie26o.html">TeamTR</a></li>
  <li><a href="https://arxiv.org/abs/2502.16863">LLM-MCA</a> · <a href="https://openreview.net/forum?id=CWYWhLho0a">ReMAC</a> · <a href="https://arxiv.org/abs/2610.17893">CoSIR</a></li>
  <li><a href="https://aclanthology.org/2026.emnlp-main.2052/">CREW</a> · <a href="https://proceedings.mlr.press/v306/zhai26c.html">SynCoord</a></li>
  <li><a href="https://arxiv.org/abs/2506.00555">MMedAgent-RL</a> · <a href="https://proceedings.neurips.cc/paper_files/paper/2025/hash/ab16cc8f472cf94b282dbff7b99f5f8e-Abstract-Datasets_and_Benchmarks_Track.html">VIKI-R</a> · <a href="https://arxiv.org/abs/2610.39324">MRC-MMAgent</a></li>
</ul>]]></content><author><name>RedMoon</name><uri>https://redmoon-2333.github.io</uri></author><category term="论文精读" /><category term="大语言模型" /><category term="多智能体" /><category term="强化学习" /><category term="信用分配" /><category term="多模态" /><summary type="html"><![CDATA[以被更新的策略和训练信号为线索，区分直接训练 LLM、LLM 辅助传统 MARL、控制器学习与协作蒸馏。]]></summary></entry><entry><title type="html">华师砺剑 08 · 把攻防经验带回系统设计</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-08-engineering-lessons/" rel="alternate" type="text/html" title="华师砺剑 08 · 把攻防经验带回系统设计" /><published>2026-11-12T18:08:00+08:00</published><updated>2026-11-12T18:08:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-08-engineering-lessons</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-08-engineering-lessons/"><![CDATA[<h2 id="一从暴露面反推系统如何部署">一、从暴露面反推系统如何部署</h2>

<p>训练中反复遇到的对象，包括管理面板、开发资源、接口文档、文件共享、监控页面和科研应用。它们使安全问题变得具体：一个功能可以在开发时很方便，却在部署时向不合适的访问者开放。</p>

<p>从防守视角，首先要明确每个入口的读者。普通业务用户、维护人员、自动化服务和公开访客，需要不同的网络与身份边界。把所有服务放到同一个可达范围，再依赖用户“不知道路径”，很难表达完整的访问规则。</p>

<p>网络分区可以减少不必要的可达面，应用授权则控制进入系统后能操作什么。两者分别回答不同问题，应在部署与测试中同时出现。</p>

<h2 id="二将发现类型对应到修复与复测">二、将发现类型对应到修复与复测</h2>

<p>下面是从训练案例提炼的工程建议，不代表相关目标已经完成整改。</p>

<table>
  <thead>
    <tr>
      <th>观察到的问题类型</th>
      <th>修复关注点</th>
      <th>复测关注点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>管理入口向过宽来源开放</td>
      <td>管理网络、访问来源和管理员身份</td>
      <td>非管理来源受限，正常维护仍可进行</td>
    </tr>
    <tr>
      <td>服务端秘密出现在前端资源</td>
      <td>移至服务端、撤销或轮换旧值、收紧权限</td>
      <td>旧值失效，客户端不再获得等效秘密</td>
    </tr>
    <tr>
      <td>对象归属校验缺失</td>
      <td>每次操作检查身份、对象和权限</td>
      <td>合法共享可用，跨用户访问被拒</td>
    </tr>
    <tr>
      <td>配置或调试信息暴露</td>
      <td>关闭不必要调试入口、收敛返回字段</td>
      <td>外部响应最小化，内部排错仍有日志</td>
    </tr>
    <tr>
      <td>文件共享范围过宽</td>
      <td>访问主体、导出规则与文件权限</td>
      <td>被允许的客户端可用，其他主体受限</td>
    </tr>
    <tr>
      <td>默认身份或弱认证</td>
      <td>初始化策略、身份管理与审计</td>
      <td>旧认证条件不再有效，合法登录正常</td>
    </tr>
    <tr>
      <td>报告与证据难以关联</td>
      <td>统一编号、版本、来源与状态</td>
      <td>每个主张可以定位到对应记录</td>
    </tr>
  </tbody>
</table>

<p>修复不是让一个请求碰巧失败。还要确认合法流程没有被破坏，并在相同条件下重新比较允许与拒绝的行为。OWASP 的授权测试方法强调具体身份和对象，这对修复后的回归同样适用。〔1〕</p>

<h2 id="三科研与-ai-应用为什么值得单独关注">三、科研与 AI 应用为什么值得单独关注</h2>

<p>后期材料中出现了推理界面、三维处理、任务队列、监控与数据服务等应用形态。它们容易让人把注意力放在模型或算法上，而实际暴露面常来自外围工程。</p>

<p>例如，任务接口是否允许任意身份创建计算任务，文件服务是否把工作目录直接公开，前端配置是否包含服务端秘密，结果对象是否按用户隔离。这些问题并不因为应用使用大模型而改变其基本性质。</p>

<p>评价这类系统时，可以把资源分成几种：输入文件、任务状态、计算资源、生成结果、运行日志和管理配置。每一种资源都需要明确的身份与归属关系。尤其是异步任务，提交、执行、失败和结果读取是不同阶段，各阶段可能具有不同的权限与副作用。</p>

<p>这也连接到此前的工程命题：请求超时不说明任务没有创建，重试需要考虑重复执行；返回 <code class="language-plaintext highlighter-rouge">ok</code> 不说明状态已持久化；任务失败也可能已经消耗资源。安全与可靠性在这里共享同一套状态理解。</p>

<h2 id="四怎样描述这段实践能力">四、怎样描述这段实践能力</h2>

<p>用一串工具名概括经历，会丢掉最有价值的部分。更具体的能力可以由留存工作支撑：</p>

<ul>
  <li>能把活动目标拆成招募、评价、材料和交付要求；</li>
  <li>能恢复训练环境，并用实际功能核对恢复结果；</li>
  <li>能记录网络来源和身份条件，解释不同位置的可达性；</li>
  <li>能读取请求响应与协议状态，识别结论所处的能力层级；</li>
  <li>能通过对照、规范和原始记录复核候选；</li>
  <li>能组织截图、脚本、报告与版本，使其他人接得住工作；</li>
  <li>能将 AI 用于整理与辅助分析，并保留人工判断和事实来源。</li>
</ul>

<p>这些描述分别有命题材料、环境记录、验证日志和归档文件作为支撑。若用于简历或面试，可以选择其中两三个最完整的案例，说明当时的问题、本人承担的步骤、采用的证据和最终交付。具体评审成绩或奖项则按正式结果另行填写。</p>

<h2 id="五一次新问题的处理顺序">五、一次新问题的处理顺序</h2>

<p>这次训练沉淀出的工作方法，可以用于后续授权练习，也可以用于日常开发排错。</p>

<p>先确定对象与边界：问题发生在哪个服务，什么来源和身份下，允许验证到哪一步。然后提出具体命题，把“似乎不安全”改写成可观察的行为。</p>

<p>接着检查已有证据，优先使用能够区分不同解释的对照。若怀疑接口泄露，就确认返回内容；若怀疑服务身份，就核对协议与专有特征；若怀疑权限，就构造合法与不合法访问的预期矩阵。</p>

<p>得到结果后，按实际观察命名。必要时保留“未确定”的状态，并明确缺的是什么。最后查重、关联原始材料，给出能够验证修复效果的建议。</p>

<p>这套顺序强调的是每一步应解决的问题。工具可以变化，接口可以变化，证据之间的逻辑关系仍然可以复用。</p>

<h2 id="六练习时用什么判断自己进步了">六、练习时用什么判断自己进步了</h2>

<p>练习不一定需要追求更大的目标范围。一个可控靶场，就足以检验以下能力：</p>

<table>
  <thead>
    <tr>
      <th>练习</th>
      <th>可以观察的学习结果</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>抓取一次普通请求</td>
      <td>能说明请求经过了哪个代理、返回了什么内容</td>
    </tr>
    <tr>
      <td>比较真实路径与不存在路径</td>
      <td>能识别登录外壳、错误页和真实资源</td>
    </tr>
    <tr>
      <td>设计两个测试身份的权限矩阵</td>
      <td>能区分合法共享、读取越权与未证实写入</td>
    </tr>
    <tr>
      <td>阅读一个模板的匹配条件</td>
      <td>能说明它为什么命中，以及会在哪些正常响应上误报</td>
    </tr>
    <tr>
      <td>分析一份协议响应</td>
      <td>能指出当前状态、字段含义和不能推导的下一步能力</td>
    </tr>
    <tr>
      <td>整理一次完整记录</td>
      <td>他人能够根据材料复查结论，而不依赖口头补充</td>
    </tr>
  </tbody>
</table>

<p>从这次筹备、参训和交付过程留下来的经验看，判断能力主要体现在细节里：能够解释一个结果为什么出现，找到会推翻当前判断的对照，并把结论写到证据真正支持的位置。</p>

<h2 id="参考">参考</h2>

<p>〔1〕 OWASP WSTG v4.2，Authorization Testing（官方原文）：<a href="https://raw.githubusercontent.com/OWASP/wstg/v4.2/document/4-Web_Application_Security_Testing/05-Authorization_Testing/README.md">https://raw.githubusercontent.com/OWASP/wstg/v4.2/document/4-Web_Application_Security_Testing/05-Authorization_Testing/README.md</a>。</p>

<p>本章将前七章的实践整理为工程建议与练习设计；建议项不代表历史目标的整改完成状态。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="安全设计" /><category term="经验总结" /><category term="AI 应用安全" /><category term="工程实践" /><summary type="html"><![CDATA[将训练中的资产、权限、协议与交付经验转为开发和运维中的具体检查，形成可复用的方法。]]></summary></entry><entry><title type="html">华师砺剑 07 · 证据、报告与 AI 协作</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-07-reporting-and-ai/" rel="alternate" type="text/html" title="华师砺剑 07 · 证据、报告与 AI 协作" /><published>2026-11-12T18:07:00+08:00</published><updated>2026-11-12T18:07:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-07-reporting-and-ai</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-07-reporting-and-ai/"><![CDATA[<h2 id="一报告是验证过程的交付界面">一、报告是验证过程的交付界面</h2>

<p>一次发现经过多人处理后，最容易发生的错误是上下文丢失：截图属于哪个目标，脚本是否后来改过，表格里的统计来自哪批记录，正文里的“成功”具体指哪一步。</p>

<p>后期工作为这些问题建立了明确的交付结构。报告正文、纯文本、原始截图、脚本、证据数据和说明文件放在同一个包内，并用编号和索引关联。这个结构让复核者可以沿着主张回到原始材料。</p>

<p>一段可复核的正文应写清目标对象、验证条件、关键观察和实际影响。工具名称可以作为复现条件，标题则围绕系统和问题本身命名，避免用“某工具扫到高危”代替技术结论。</p>

<h2 id="二截图和原始记录各有作用">二、截图和原始记录各有作用</h2>

<p>截图便于快速阅读，也能显示当时的操作界面和上下文；原始请求响应便于检索、解析和精确比较。只保留其中一种，都会损失信息。</p>

<p>后期协作约定要求人工运行取证并截图，保留原图与时间线索，随后按实际内容核对编号、添加说明并计算 SHA-256。图像不应被重绘成“更清楚的终端输出”，也不能把后来修改的脚本当成截图中已经运行过的版本。</p>

<p>哈希适合回答“现在的文件是否与当时归档的字节一致”。它不证明截图内容真实，也不证明服务响应来自所声称的目标。真实性仍依赖采集上下文、原始事务和相互一致的记录。</p>

<p>时间也需要注明来源。系统任务栏、服务端响应、工具自身时间、文件修改时间分别代表不同事件；整理副本的修改时间尤其不能充当原始测试时间。</p>

<h2 id="三报告正文要能逐句找到依据">三、报告正文要能逐句找到依据</h2>

<p>把一句话拆开，往往能发现夸大的部分。</p>

<p>例如，“匿名访问配置页，可任意修改并接管设备”包含至少三个主张：配置可读、配置可改、设备可控。若证据只有页面内容，后两项并没有被这张图建立。</p>

<p>更清楚的写法是先描述实际返回的配置类型，再解释其可见范围与管理用途。修复建议可以要求检查相关写操作的权限，但不能把建议检查的能力写成已经获得的能力。</p>

<p>多目标问题也要分清总体清单与截图样本。一张样本图不承担整批设备的逐台验证；如果规模来自结构化清单，正文应说明统计来源与样本范围。</p>

<h2 id="四重复发现与版本修订">四、重复发现与版本修订</h2>

<p>这次材料中，同一问题可能在初始扫描、协议复核、人工补图和最终报告中反复出现。后期归档要求从三个方向检查：已有提交、前几天的成果、其他角色的产物。</p>

<p>重复判断需要关注同一目标、服务、资源和成因。更清楚的一张截图通常应补入原问题；新端口也可能只是同一根因的另一个表现。相反，同一主机上的不同权限缺陷，应分别说明成立依据和相互关系。</p>

<p>文件数量不能替代版本管理。一个编号可能只有表单，尚未生成完整压缩包；一个包名写着“已送审”，也不意味着评审通过。把以下状态分开后，交付会清楚很多：</p>

<table>
  <thead>
    <tr>
      <th>状态</th>
      <th>应有的依据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>候选</td>
      <td>线索及待验证命题</td>
    </tr>
    <tr>
      <td>已有验证记录</td>
      <td>与主张对应的请求响应或协议事务</td>
    </tr>
    <tr>
      <td>材料齐备</td>
      <td>报告、原始证据与截图等满足提交要求</td>
    </tr>
    <tr>
      <td>已提交</td>
      <td>平台或人工提交记录</td>
    </tr>
    <tr>
      <td>通过或驳回</td>
      <td>明确的评审反馈</td>
    </tr>
    <tr>
      <td>已整改并复测</td>
      <td>修复后的独立复测与必要的正常功能检查</td>
    </tr>
  </tbody>
</table>

<p>历史状态不应被新版文件名静默覆盖。保留修订原因、替代关系和必要的交叉引用，能避免后续重复申报。</p>

<h2 id="五ai-在这套工作里适合承担什么">五、AI 在这套工作里适合承担什么</h2>

<p>目录中保存了多个角色的分析、脚本和报告产物。AI 对批量整理很有帮助：将输出转为结构化表格、查找重复记录、比较模板和响应、检查文档字段、解释协议规范。</p>

<p>但 AI 的文字不能给事实“升级”。模型可以写出一段逻辑连贯的复现过程，即使某一步从未发生；也可能根据接口名猜测用途，把 <code class="language-plaintext highlighter-rouge">success</code> 标签解释成更大的权限，把多个批次拼成一次连续操作。</p>

<p>因此，任务交付应要求具体证据，而不只要求“确认完成”。一个适合离线材料复核的任务，可以写成：</p>

<blockquote>
  <p>读取指定历史记录，列出每个主张对应的来源、观察条件与原文位置。将计划、脚本、已保存的响应和人工截图分别标注。遇到矛盾时保留两份来源，给出需要核对的具体字段，不补造缺失结果。</p>
</blockquote>

<p>这类任务让模型的产物可检查，也便于人工判断何处还需要原始材料。</p>

<h2 id="六多人协作的共享资源">六、多人协作的共享资源</h2>

<p>不同分析方向可以并行，但网络出口、VPN、浏览器会话、截图目录和提交编号可能是共享资源。一处环境变化，会影响其他任务对来源与身份的解释。</p>

<p>较清楚的分工方式是：每个角色说明自己使用的材料与时间范围，交接时提交原始文件和观察结论，归档阶段再统一查重、编号和定稿。若有人只做了离线审查，就写离线审查；若人工负责运行与截图，就保留该事实。</p>

<p>同一结论被多个模型复述也不构成独立证据。判断可信度要看它们是否回到了独立的观测，还是都引用同一份摘要。</p>

<h2 id="七公开总结保留方法原始证据受控保存">七、公开总结保留方法，原始证据受控保存</h2>

<p>内部报告需要准确定位目标，公开文章则需要保护涉及的系统与人员。两种文档服务不同读者。</p>

<p>公开复盘适合保留：问题类型、验证条件、对照逻辑、工具分工、排错过程和整改原则。实际目标、凭据、内部对象标识、个人信息以及可直接复现的敏感链条，继续保存在受控材料中。</p>

<p>这一处理不会妨碍技术表达。用“匿名身份能否取得受保护字段”“导出声明与挂载结果是否一致”就能讲清关键判断。真正值得迁移到下一次项目的，是如何得到结论和如何交付结论。</p>

<p>本章依据历史取证协作约定、项目归档规范、报告模板、查重记录与截图核对材料整理。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="证据管理" /><category term="技术写作" /><category term="AI 协作" /><category term="报告" /><summary type="html"><![CDATA[把原始响应、人工截图、脚本、报告和提交状态关联起来，让安全发现能够被复查、交接和处理。]]></summary></entry><entry><title type="html">华师砺剑 06 · 怎样淘汰误报，留下可靠结论</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-06-evidence-validation/" rel="alternate" type="text/html" title="华师砺剑 06 · 怎样淘汰误报，留下可靠结论" /><published>2026-11-12T18:06:00+08:00</published><updated>2026-11-12T18:06:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-06-evidence-validation</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-06-evidence-validation/"><![CDATA[<h2 id="一先写出准备证明的命题">一、先写出准备证明的命题</h2>

<p>“扫描器报高危”是线索；“未登录身份可以读取本应受保护的业务记录”才是可以检验的命题。两者之间还缺身份、资源、内容和权限规则。</p>

<p>这次材料中，许多有价值的工作都发生在复核阶段。候选有的被保留，有的转为观察，有的与旧包合并。它们共同提高了报告的可用性：复核者能够看到结论为什么成立，也能知道哪些相似现象已经被排除。</p>

<p>验证前可以先补齐一句话：</p>

<blockquote>
  <p>在什么来源、什么身份和什么条件下，对哪个对象做了什么操作，观察到什么结果，因此支持什么结论。</p>
</blockquote>

<p>如果这句话里只有工具名称和风险等级，说明还没有走到结论层。</p>

<h2 id="二路由兜底多个路径共享同一张页面">二、路由兜底：多个路径共享同一张页面</h2>

<p>历史复核出现过两类典型情况。第一类是组件目录返回服务器默认页；第二类是文档路径与随机路径返回同样的 HTML 外壳。候选路径的名字很像敏感接口，正文却没有对应内容。</p>

<p>这时，随机路径和普通入口构成了有效对照。需要比较的不只是 200，还包括内容类型、页面结构和关键字段。若文档路径返回的只是登录页，就应把“接口文档泄露”撤回为“该请求返回登录界面”。</p>

<p>早期记录中也有相反例子：候选文件返回具有构建语义的 XML，而同类型的不存在路径返回错误页。这样的对照增加了“真实文件可读”这一判断的可信度；文件本身有多敏感，仍要单独分析。</p>

<p>对照的价值，是让同一个响应有了可以比较的背景。</p>

<h2 id="三读模板而不只读命中名称">三、读模板，而不只读命中名称</h2>

<p>Nuclei 根据模板中配置的 matcher 判定是否匹配。〔1〕 同样一个标题为“敏感信息”的规则，实际可能检查状态码、字符串、正则，也可能组合多项条件。</p>

<p>历史审查中有些探测规则只根据通用响应特征命中，随后被错误地解释成了攻击成功。请求走私等问题尤其需要严格区分“出现响应差异”和“已经证明跨请求边界异常”。常见状态码或通用协议文字，本身不承担后一个结论。</p>

<p>复核模板时，应理解：</p>

<ol>
  <li>它实际发送什么请求，是否符合本次范围；</li>
  <li>它检查哪个响应部位；</li>
  <li>条件是同时满足，还是任意一个满足；</li>
  <li>这些条件能否排除正常页面与错误页；</li>
  <li>输出的严重性标签是否对应当前证据和实际影响。</li>
</ol>

<p>历史命中应配历史模板或内嵌模板版本。后来的规则即使修正了误报，也不能倒过来替旧日志补证据。</p>

<h2 id="四否定结果也要限制在观测范围内">四、否定结果也要限制在观测范围内</h2>

<p>错误响应可以排除一个具体主张，却很少能证明整个系统安全。</p>

<p>例如，NAS 的某组敏感接口没有返回受保护内容，可以支持“这组请求未建立匿名访问能力”。它不能覆盖所有接口，更不能保证其他身份或版本下没有问题。反过来，公开 API 元数据也不能自动支持私有数据泄露。</p>

<p>超时尤其需要谨慎。它可能来自过滤、等待时间、网络质量、服务负载或请求格式。Nmap 对端口状态的定义本身就包含无法确定的情况。〔2〕 若没有进一步证据，应保留“本条件下未得到响应”，而不是给出唯一故障原因。</p>

<p>同样，一次修正后的请求获得响应，可以证明旧判断受请求格式影响；它不自动说明服务器没有其他防护。</p>

<h2 id="五技术一致性与业务真实性">五、技术一致性与业务真实性</h2>

<p>后期业务接口材料中，有些数据包含专业字段、连续时间和满足数学关系的数值。这些特征可以帮助理解数据结构，却不能单独证明它们是生产数据。</p>

<p>模拟数据同样可以满足公式，也可以使用真实风格的字段与时间戳。因此，“数值关系正确”支持的是内部一致性；“来自真实业务”还需要数据责任方、业务用途或其他独立来源确认。</p>

<p>这一区分影响风险描述。可以准确说明某接口返回了哪些类型的信息，以及为何需要确认其公开属性；不能仅凭记录条数或专业术语就推定真实个人数据规模。</p>

<p>同理，堆栈里出现文件路径，证明的是错误信息暴露了内部实现线索；页面显示一个管理菜单，证明的是界面内容存在。对“账户接管”“任意文件读取”“命令执行”等更强主张，应有对应能力证据。</p>

<h2 id="六计数之前先确定数的是什么">六、计数之前先确定数的是什么</h2>

<p>这次目录里同时存在扫描结果、汇总表、截图、报告、压缩包、修订版和非提交归档。它们计量的是不同对象。</p>

<table>
  <thead>
    <tr>
      <th>数量</th>
      <th>实际含义</th>
      <th>容易造成的错误</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>扫描命中数</td>
      <td>规则产生的事件</td>
      <td>当成有效漏洞数</td>
    </tr>
    <tr>
      <td>端点数</td>
      <td>主机与端口等组合</td>
      <td>当成独立系统数</td>
    </tr>
    <tr>
      <td>截图数</td>
      <td>图像文件数量</td>
      <td>当成独立验证次数</td>
    </tr>
    <tr>
      <td>报告包数</td>
      <td>交付文件数量</td>
      <td>当成评审通过数</td>
    </tr>
    <tr>
      <td>返回记录数</td>
      <td>本次响应或统计口径中的条目</td>
      <td>当成去重后的真实人员数</td>
    </tr>
  </tbody>
</table>

<p>历史认证审查特别处理了主日志与 HITS 投影的重复：同一协议、端点和时刻的相同事件，只计一次。没有运行完成摘要、实际端点少于计划端点的任务，也不能标成全部覆盖。</p>

<p>文件哈希能帮助识别字节相同的副本；哈希不同却仍可能是同一事件的格式转换或脱敏版本。漏洞层面的查重还要比较资源、根因和影响。</p>

<h2 id="七一条候选如何收敛">七、一条候选如何收敛</h2>

<p>以“某接口匿名泄露管理数据”为例，先核对对象是否在明确范围内，再确认身份条件，读取已有请求响应，比较正常入口或错误路径，判断返回的是公开信息还是受保护内容，最后查明是否已有同根因报告。</p>

<p>每一步都可能改变后续处理：组件认错就回到资产识别，身份不清就补上下文，只有公开信息就保留观察，已有同一问题就补充旧证据。这样减少的是无效分支，留下的结论更容易复现和修复。</p>

<h2 id="参考">参考</h2>

<p>〔1〕 ProjectDiscovery，Matchers：<a href="https://docs.projectdiscovery.io/templates/reference/matchers">https://docs.projectdiscovery.io/templates/reference/matchers</a>。</p>

<p>〔2〕 Nmap，Port Scanning Basics：<a href="https://nmap.org/book/man-port-scanning-basics.html">https://nmap.org/book/man-port-scanning-basics.html</a>。</p>

<p>经历依据：首日只读验证报告、设备误报淘汰、历史 N-day 命中审查、认证事件去重与后期否证材料。文中采用其可由记录支持的方法，不沿用旧稿中超出证据的严重性结论。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="误报分析" /><category term="证据判断" /><category term="Nuclei" /><category term="验证方法" /><summary type="html"><![CDATA[以路由兜底、组件误识别、协议权限和历史记录去重为例，说明怎样把扫描线索转成有依据的判断。]]></summary></entry><entry><title type="html">华师砺剑 05 · 协议与设备：读懂每一步响应</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-05-protocols/" rel="alternate" type="text/html" title="华师砺剑 05 · 协议与设备：读懂每一步响应" /><published>2026-11-12T18:05:00+08:00</published><updated>2026-11-12T18:05:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-05-protocols</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-05-protocols/"><![CDATA[<h2 id="一离开浏览器以后成功没有统一的含义">一、离开浏览器以后，成功没有统一的含义</h2>

<p>Web 验证还能从页面内容获得直观反馈，非 HTTP 服务则需要理解协议状态。数据库返回欢迎包、文件共享返回导出名称、视频服务返回媒体描述，分别说明不同的事情。</p>

<p>训练后期的协议记录覆盖了数据库、SMB、FTP、LDAP、SNMP、NFS、RTSP、远程桌面和设备管理面。最有用的整理方式，是为每种协议建立能力层级：连接、协议识别、认证、资源读取、状态改变。工具写出的 <code class="language-plaintext highlighter-rouge">SUCCESS</code> 要映射到其中某一步。</p>

<table>
  <thead>
    <tr>
      <th>协议或服务</th>
      <th>常见观察</th>
      <th>需要保留的边界</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>数据库</td>
      <td>握手、版本、认证结果</td>
      <td>握手成功不等于登录，更不等于读取了库表</td>
    </tr>
    <tr>
      <td>FTP、SMB</td>
      <td>匿名身份、共享或目录元数据</td>
      <td>登录、列目录、读文件与写文件是不同能力</td>
    </tr>
    <tr>
      <td>LDAP</td>
      <td>匿名绑定、服务根元数据</td>
      <td>根元数据可见不等于可枚举全部目录对象</td>
    </tr>
    <tr>
      <td>SNMP</td>
      <td>设备状态、管理信息</td>
      <td>可读信息与写配置分别判断</td>
    </tr>
    <tr>
      <td>BMC、Redfish、虚拟化平台</td>
      <td>服务根、管理页面、会话</td>
      <td>页面与元数据可见不等于控制宿主机</td>
    </tr>
    <tr>
      <td>RTSP</td>
      <td>会话描述、媒体控制状态</td>
      <td>描述返回不等于媒体已经播放</td>
    </tr>
  </tbody>
</table>

<p>这里列的是判读框架。具体设备是否存在安全问题，还取决于哪些信息本来允许公开，以及历史事务实际证明到了哪一层。</p>

<h2 id="二nfs导出清单和文件内容之间还有几道检查">二、NFS：导出清单和文件内容之间还有几道检查</h2>

<p>NFS 复核是这次训练中很有代表性的协议案例。早期观察看到导出清单与通配标记，容易联想到“任意主机可以访问”。后续记录却显示，部分导出在实际挂载阶段返回了拒绝。</p>

<p>在 NFSv3 配套的 MOUNT 协议中，EXPORT 返回导出目录与相关客户端组信息；MNT 是请求挂载句柄的另一项操作。〔1〕 因而，读取导出声明和取得访问句柄不能混为一谈。</p>

<table>
  <thead>
    <tr>
      <th>阶段</th>
      <th>本阶段的意义</th>
      <th>合适的表述</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>服务查询</td>
      <td>发现相关 RPC 服务</td>
      <td>服务可识别</td>
    </tr>
    <tr>
      <td>EXPORT</td>
      <td>得到导出清单</td>
      <td>导出元数据可查询</td>
    </tr>
    <tr>
      <td>MNT</td>
      <td>请求文件句柄</td>
      <td>按返回结果说明获得句柄或被拒绝</td>
    </tr>
    <tr>
      <td>目录操作</td>
      <td>请求目录条目</td>
      <td>仅对实际返回的范围说明可列举</td>
    </tr>
    <tr>
      <td>文件读取</td>
      <td>请求文件内容</td>
      <td>需要相应内容证据及允许的验证范围</td>
    </tr>
  </tbody>
</table>

<p>历史复核记录中的一个典型结果是：导出声明看似宽泛，但 MOUNT 返回状态 13。按 RFC 1813 的 MOUNT v3 定义，这是 <code class="language-plaintext highlighter-rouge">MNT3ERR_ACCES</code>，即访问被拒绝。它支持“此次挂载请求被拒”，不能从中直接推出后台采用了哪一种安全配置。</p>

<p>这也纠正了一个容易忽略的术语细节：MOUNT 状态和 NFS 操作状态属于相关但不同的枚举。即使数字含义相似，报告仍应写明它来自哪一层响应。</p>

<h2 id="三协议解析器本身也可能出错">三、协议解析器本身也可能出错</h2>

<p>同一份 NFS 复核材料记录了帧长度和 XDR 结构理解方面的问题。若请求帧构造错误，服务器可能不按预期应答，外部看起来像超时；若解析时把链表当作计数数组，结果可能静默丢失后续字段。</p>

<p>这种故障比明显抛出异常更难发现，因为输出仍像一张合法表格。验证自写解析器时，应把原始字节、协议规范和解析后的结构放在一起，检查长度、对齐、边界与剩余数据。</p>

<p>RFC 1813 中的 EXPORT 结构包括目录、客户端组链表和下一节点，没有提供完整的服务器导出选项清单。〔1〕 因此，缺少某个配置字段时，应先检查协议是否会传输该字段，不能自动归因于解析失败，也不能凭空补出配置。</p>

<p>这个经验可以迁移到其他二进制协议：解析结果越“像真的”，越需要用已知样例和规范确认字段位置。</p>

<h2 id="四rtsp会话描述能说明什么">四、RTSP：会话描述能说明什么</h2>

<p>历史材料中有 RTSP <code class="language-plaintext highlighter-rouge">DESCRIBE</code> 返回 SDP 的记录。SDP 描述媒体类型、编码和相关参数，它说明服务器提供了会话描述。</p>

<p>RTSP 的 DESCRIBE、SETUP 和 PLAY 承担不同任务：获取描述、配置传输、控制播放。〔2〕 后面的操作可能有各自的认证要求。因此，返回 SDP 可以用于分析描述信息是否暴露，不能直接证明匿名观看画面已经成立。</p>

<p>DESCRIBE 也不应简单写成“等价于 HTTP HEAD”。HEAD 在 HTTP 中不返回响应内容，而 DESCRIBE 的用途恰恰包括返回媒体描述正文。〔2〕〔3〕</p>

<p>这种差异会改变报告结论。若历史验证停在描述阶段，恰当的总结就是“得到媒体描述，播放权限未由这次记录建立”。说明本次能力层级，就已经足够支持相应分析，无需用更强的措辞填补缺失步骤。</p>

<h2 id="五设备管理面与业务面要分开">五、设备管理面与业务面要分开</h2>

<p>打印机、NAS、虚拟化平台和带外管理控制器，在同一网络里可能同时提供 Web 页面、文件共享和管理协议。一个设备的多个端口可以对应不同功能，也可能共同暴露同一份配置。</p>

<p>因此，查重时既不能只看主机，也不能只看端口。需要问：是否同一资源？是否同一种访问控制缺失？修复是否会同时解决两个现象？</p>

<p>例如，设备状态页公开了型号和耗材信息，与后台能够修改网络参数，是不同的能力层级；同一信息被两个接口返回，也未必构成两个独立问题。报告应围绕实际影响和根因组织，而不是围绕扫描器发现了几条路径组织。</p>

<p>文件共享也类似。匿名 FTP 可能用于公开分发，是否构成风险取决于返回内容、预期用途与权限配置。看到匿名登录成功，应先确认这一步的含义，不能默认存在敏感数据泄露。</p>

<h2 id="六把每一次成功展开">六、把每一次“成功”展开</h2>

<p>后期历史认证审查中，同一事件既写入主日志，也被投影到 HITS 文件。两份文件并不代表发生了两次独立认证；客户端标签也不能自动证明目标身份与权限等级。</p>

<p>更可用的记录方式是保留协议状态和所处阶段，例如“收到认证拒绝”“返回服务元数据”“目录请求获得条目”。这样下一位读者即使不用同一工具，也能理解结论。</p>

<p>这次协议训练的主要收获，是把含混的“打通了”拆成具体状态。每个状态都对应一类证据，也对应不同的整改建议。</p>

<h2 id="参考">参考</h2>

<p>〔1〕 RFC 1813，NFS Version 3 Protocol Specification，§5：<a href="https://www.rfc-editor.org/rfc/rfc1813.html">https://www.rfc-editor.org/rfc/rfc1813.html</a>。</p>

<p>〔2〕 RFC 7826，RTSP 2.0，§13：<a href="https://www.rfc-editor.org/rfc/rfc7826.html">https://www.rfc-editor.org/rfc/rfc7826.html</a>。本文用其方法定义说明概念；历史响应中的 RTSP 1.0 状态不因此视作 2.0 一致性验证。</p>

<p>〔3〕 RFC 9110，HTTP Semantics，HEAD：<a href="https://www.rfc-editor.org/rfc/rfc9110.html#section-9.3.2">https://www.rfc-editor.org/rfc/rfc9110.html#section-9.3.2</a>。</p>

<p>经历依据：NFS 复核说明与对应 JSON、非 HTTP 协议候选筛查、历史认证批次审查和媒体描述记录。所有案例保留在已有证据所处的能力层级。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="协议分析" /><category term="NFS" /><category term="RTSP" /><category term="设备安全" /><summary type="html"><![CDATA[用 NFS、RTSP、数据库和设备管理面的案例，区分连接、握手、认证、读取与控制。]]></summary></entry><entry><title type="html">华师砺剑 04 · Web 验证：身份、对象与操作</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-04-web-authorization/" rel="alternate" type="text/html" title="华师砺剑 04 · Web 验证：身份、对象与操作" /><published>2026-11-12T18:04:00+08:00</published><updated>2026-11-12T18:04:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-04-web-authorization</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-04-web-authorization/"><![CDATA[<h2 id="一http-200-后面是什么">一、HTTP 200 后面是什么</h2>

<p>在训练中，最常见的误判起点就是成功状态码。目录扫描得到一串 200，看起来发现了许多入口；实际打开，却可能全是同一张登录页。</p>

<p>早期复核记录里，某些组件路径返回默认服务器页面，另一些路径落到了应用的路由兜底。它们确实有响应，但响应并不包含所声称的组件内容。</p>

<p>因此，判断一条候选需要同时看状态码、内容类型、正文结构和对照响应。响应长度有助于快速筛选，但长度相等不保证内容完全相同；动态时间、随机值和会话标识也可能使同一页面长度变化。关键仍是内容含义。</p>

<p>一个有效的对照，是在同样的身份与网络条件下比较候选路径、普通入口和不存在的路径。如果三者返回同一登录外壳，候选路径并没有提供预期的访问证据。若返回具有明确语义的结构化数据，才继续判断其公开属性与权限要求。</p>

<h2 id="二认证未授权访问和越权">二、认证、未授权访问和越权</h2>

<p>认证回答“你是谁”；授权回答“这个身份能对这个对象做什么”。OWASP 的授权测试把绕过授权、权限提升和对象引用等问题分别处理，因为它们需要不同的对照设计。〔1〕</p>

<table>
  <thead>
    <tr>
      <th>问题类型</th>
      <th>判断重点</th>
      <th>常见混淆</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>弱口令</td>
      <td>某组凭据被接受，且能关联到目标身份</td>
      <td>把欢迎页、超时或客户端成功标签当成登录实证</td>
    </tr>
    <tr>
      <td>未授权访问</td>
      <td>无预期身份条件时，仍得到受保护资源或能力</td>
      <td>把公开首页、接口说明或健康状态当成私有数据</td>
    </tr>
    <tr>
      <td>对象级越权</td>
      <td>已认证用户访问了不属于自己且未共享的对象</td>
      <td>只改变编号，却没有确认对象归属</td>
    </tr>
    <tr>
      <td>功能级越权</td>
      <td>普通角色调用了不应开放给它的功能</td>
      <td>看到前端按钮或菜单便推断后端可执行</td>
    </tr>
    <tr>
      <td>信息暴露</td>
      <td>返回内容具有明确的保密或内部用途</td>
      <td>把所有版本、参数、字段名都称作密钥泄露</td>
    </tr>
  </tbody>
</table>

<p>一次完整的权限描述，应包含身份、对象和操作。例如“普通账号读取未共享的另一账号记录”，比“接口存在鉴权漏洞”更能帮助复核者理解问题。</p>

<h2 id="三用虚构对象说明有效对照">三、用虚构对象说明有效对照</h2>

<p>下面是教学示例，不是线上目标的操作记录。</p>

<p>设 A、B 为两个测试身份，文档 R1 属于 B，但已共享给 A 只读；文档 R2 属于 B，未共享给 A，并含专门设置的虚构标记。</p>

<table>
  <thead>
    <tr>
      <th>请求</th>
      <th>观察</th>
      <th>判断</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>A 读取 R1</td>
      <td>返回已共享内容</td>
      <td>符合规则</td>
    </tr>
    <tr>
      <td>A 修改 R1</td>
      <td>返回 <code class="language-plaintext highlighter-rouge">ok</code>，再次读取仍为原值</td>
      <td>写入成功尚未建立</td>
    </tr>
    <tr>
      <td>A 读取 R2</td>
      <td>返回 R2 内容与虚构标记</td>
      <td>在身份、对象归属已确认的前提下，证明越权读取</td>
    </tr>
  </tbody>
</table>

<p>这组对照在招募命题中也出现过，其意义在于控制对象归属和预期权限。只看“成功返回”会混淆正常分享、异常响应和真实越权。</p>

<p>OWASP 对不安全直接对象引用的测试同样强调使用不同权限身份和对象上下文。〔2〕 在真实系统中，测试对象与操作仍须服从具体授权；教学表格并不自动授予修改业务数据的权限。</p>

<h2 id="四前端资源能帮助理解系统但不能代替验证">四、前端资源能帮助理解系统，但不能代替验证</h2>

<p>后期材料涉及 OpenAPI 文档、前端配置、开发资源与业务接口。它们能帮助回答三个问题：系统有哪些对象、有哪些操作、客户端如何组织请求。</p>

<p>但接口文档没有写 <code class="language-plaintext highlighter-rouge">security</code>，不等于服务器没有鉴权；前端代码里出现一个路径，也不等于该路径当前有效。一次历史接口审查就保留了这样的反例：文档层面的安全声明不完整，实际业务响应却给出了认证拒绝。</p>

<p>前端配置中的字符串也需分类。公开标识、环境名称、算法公共参数和能够赋予权限的秘密值，是不同对象。判断敏感性要说明它的用途和权限效果；“看起来随机”或“字段名像密钥”都不够。</p>

<p>如果某个值本应只由服务端保存，却被客户端公开，并且历史事务能证明它改变了访问结果，修复应围绕服务端鉴权、权限范围与凭据轮换展开。把字符串从一个 JavaScript 文件移到另一个文件，并没有改变客户端仍能取得它的事实。</p>

<h2 id="五读取配置页与修改配置">五、读取配置页与修改配置</h2>

<p>打印设备和管理面板是训练中的常见对象。配置页直接可见，可以支持“某些配置字段向该来源开放”的判断；页面中有保存、上传或重启表单，则进一步说明存在相关界面。</p>

<p>界面存在仍不能证明操作成功。后端可能要求另一个权限条件，也可能拒绝请求。历史材料中有些条目明确停在配置读取，没有提交表单；复盘应保持这个边界。</p>

<p>这对风险表达很重要：把“可读内部配置”写清楚，可以形成有依据的整改问题；把它升级为“任意改配置、接管设备”，则需要不同级别的证据与授权。</p>

<h2 id="六动作的风险由语义决定">六、动作的风险由语义决定</h2>

<p>HTTP 标准将 GET、HEAD 等方法定义为具有安全语义的方法，即客户端请求的语义基本是只读的。〔3〕 但实际应用可能不按该语义实现。历史接口说明中就出现过状态查询附带下载、下载附带转码、清理接口改变文件状态等描述。</p>

<p>因此，评估一次验证是否适合当前范围，要看实际业务含义。路径叫 <code class="language-plaintext highlighter-rouge">status</code>，不保证它只是读一个值；使用 POST，也不自动意味着写数据。应结合接口契约、实现说明和已有响应判断。</p>

<p>类似地，后台任务失败并不说明之前没有消耗资源。任务进入队列、开始运行、访问外部资源，本身就可能产生副作用。技术复盘可以分析这些状态之间的关系，但不能用“最后失败了”反推操作没有影响。</p>

<h2 id="参考">参考</h2>

<p>〔1〕 OWASP WSTG v4.2，Authorization Testing（官方原文）：<a href="https://raw.githubusercontent.com/OWASP/wstg/v4.2/document/4-Web_Application_Security_Testing/05-Authorization_Testing/README.md">https://raw.githubusercontent.com/OWASP/wstg/v4.2/document/4-Web_Application_Security_Testing/05-Authorization_Testing/README.md</a>。</p>

<p>〔2〕 OWASP WSTG v4.2，Testing for Insecure Direct Object References（官方原文）：<a href="https://raw.githubusercontent.com/OWASP/wstg/v4.2/document/4-Web_Application_Security_Testing/05-Authorization_Testing/04-Testing_for_Insecure_Direct_Object_References.md">https://raw.githubusercontent.com/OWASP/wstg/v4.2/document/4-Web_Application_Security_Testing/05-Authorization_Testing/04-Testing_for_Insecure_Direct_Object_References.md</a>。</p>

<p>〔3〕 RFC 9110，HTTP Semantics，§9.2.1：<a href="https://www.rfc-editor.org/rfc/rfc9110.html#section-9.2.1">https://www.rfc-editor.org/rfc/rfc9110.html#section-9.2.1</a>。</p>

<p>经历依据：课堂验证与报告转写、早期只读复核、应用接口候选审查、配置页记录与权限命题材料。文中的 A/B/R1/R2 为虚构教学对象。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="Web 安全" /><category term="身份认证" /><category term="访问控制" /><category term="API" /><summary type="html"><![CDATA[用实际响应和身份对照分析未授权访问、弱口令、对象越权与前端信息暴露，拆开容易混淆的证据。]]></summary></entry><entry><title type="html">华师砺剑 03 · 资产识别与网络来源</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-03-network-boundaries/" rel="alternate" type="text/html" title="华师砺剑 03 · 资产识别与网络来源" /><published>2026-11-12T18:03:00+08:00</published><updated>2026-11-12T18:03:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-03-network-boundaries</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-03-network-boundaries/"><![CDATA[<h2 id="一一条发现首先要有明确的对象">一、一条发现首先要有明确的对象</h2>

<p>早期训练接到的是资产范围，工具输出却可能包含网段、主机、端口、域名、URL 和接口路径。它们不是同一层级。</p>

<p>主机是承载服务的对象；端口帮助定位监听服务；域名和协议影响应用入口；路径再定位具体功能。相同主机上可能有互不相同的业务，多个域名也可能指向同一套入口。只用 IP 去重，会把不同问题合并；只用 URL 计数，又可能把同一问题拆成许多条。</p>

<p>历史工作逐渐引入了端点、服务、路径和成因的联合比较。这个习惯也适合日常资产管理：先给对象稳定的身份，再为它追加不同时间和来源的观察。</p>

<h2 id="二网络位置属于实验条件">二、网络位置属于实验条件</h2>

<p>材料里出现过现场有线网络、无线网络、宿舍网络、校园 VPN，以及独立外部来源等不同条件。同一个服务在某个位置能连接，在另一个位置超时，并不矛盾。</p>

<p>一次网络观察至少包含：</p>

<ul>
  <li>发起请求的网络与实际路由；</li>
  <li>是否使用代理、VPN 或已认证会话；</li>
  <li>目标协议、端口及应用入口；</li>
  <li>观察时间、等待时间和实际响应。</li>
</ul>

<p>公网出口回显只说明访问那个回显服务时使用了某条路径。如果扫描器忽略系统代理，或者 VPN 对不同目标采用不同路由，该出口未必就是目标请求的出口。需要把具体工具的代理行为和目标路由一起核对。</p>

<p>历史边界评估中，来源地址曾被重新归类：原先被当作“校外”的一次观察，后来发现来源仍处于相关网络范围内，因此不能支撑普通互联网来源的结论。这个修订比继续沿用一个好看的“外网突破”标题更有分析价值。</p>

<h2 id="三正常登录与越过权限边界">三、正常登录与越过权限边界</h2>

<p>后期计划材料涉及用本人已有身份接入校园访问服务。使用合法账号获得其本来被授予的网络访问能力，应描述为正常认证与接入。</p>

<p>安全问题要在此基础上继续界定：这个身份原本允许访问什么，实际获得了什么，超出的部分是什么。一个普通账号能看到自己的资源，和它能访问另一个用户的私有对象，涉及完全不同的权限判断。</p>

<p>同样，设备在 VPN 内可达，不能直接写成“公网任意访问”；管理页面能打开，也不能直接写成“取得管理权限”。来源和权限写清楚后，影响范围才有可比较的基础。</p>

<h2 id="四从端口走到应用层">四、从端口走到应用层</h2>

<p>Nmap 将端口状态区分为 open、closed、filtered 等多种情况，其中 filtered 表示探测受到过滤，无法确定端口是开放还是关闭。〔1〕 这比“通了”和“不通”两类标签更接近实际观察。</p>

<p>在历史记录中，有些端点 TCP 建连成功，却没有返回预期协议内容。此时可以保留“连接成功，应用响应未确认”，不能仅凭常用端口号就命名产品，更不能把空响应直接定性为某种防御设备行为。</p>

<p>反过来，超时也不能推导出不存在服务。过短的等待时间、丢包、路由差异和工具采集问题都会影响结果。应保留本次观察条件，而不是把一次阴性结果提升为整段网络的安全证明。</p>

<table>
  <thead>
    <tr>
      <th>已看到的事实</th>
      <th>可以确定的层级</th>
      <th>还需区分的问题</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>TCP 建连成功</td>
      <td>该来源下的连接可达性</td>
      <td>对端实际协议与服务身份</td>
    </tr>
    <tr>
      <td>协议握手或 banner</td>
      <td>协议与版本线索</td>
      <td>版本信息是否可靠、认证是否开启</td>
    </tr>
    <tr>
      <td>登录页或管理页外壳</td>
      <td>应用入口可访问</td>
      <td>是否真正获得受保护内容</td>
    </tr>
    <tr>
      <td>认证事务成功</td>
      <td>某身份被服务接受</td>
      <td>身份关联、实际角色与权限范围</td>
    </tr>
    <tr>
      <td>受保护资源实际返回</td>
      <td>对该资源和操作的访问能力</td>
      <td>是否违背原有权限规则</td>
    </tr>
  </tbody>
</table>

<p>这些层级不能自动向下推演。每向前一步，都需要新的证据。</p>

<h2 id="五指纹误匹配怎样发生">五、指纹误匹配怎样发生</h2>

<p>一次设备普查把一些打印设备同时标成了 NAS、数据库管理界面或网络设备。复核发现，识别逻辑使用了宽泛词语，多个标签实际上来自同一份页面内容。</p>

<p>这不是“几种设备刚好部署在一起”的充分证据。更合理的检查是寻找组件专有结构：页面标识、专有接口、协议特征、资源关系，再和错误路径或普通页面对照。</p>

<p>历史原始记录中，一台 NAS 的接口清单可查询，但后续多个敏感接口返回错误。复盘时应分别保留“元数据可见”和“受保护操作被拒绝”的事实。实际 JSON 中还有不同的错误码，不能为了让表格整齐而统写成同一种认证错误。</p>

<p>组件标题和版本号也只是线索。公开页面可以被修改，代理可以重写响应，兼容实现可以复用 banner。组件归属越影响后续结论，越需要多种独立特征相互支持。</p>

<h2 id="六范围不能由技术推断扩大">六、范围不能由技术推断扩大</h2>

<p>历史记录中有范围待确认、暂缓验证的条目。处理这类条目时，保留授权清单原值与确认状态很重要：不能为了让网段语法“更标准”，就自行扩展它实际表示的范围。</p>

<p>同一自治系统、相近地址、网页出现学校名称、证书含机构缩写，都可以作为资产归属线索；它们本身不能取代明确的测试范围。特别是共享网络、第三方托管和外包系统，网络归属与业务责任方可能不同。</p>

<p>可复用的资产记录，应把“归属证据”和“允许开展的工作”分开。这样遇到新线索时，既能保留发现，也能避免把技术上的相邻关系误当成授权上的连续关系。</p>

<h2 id="参考">参考</h2>

<p>〔1〕 Nmap，Port Scanning Basics：<a href="https://nmap.org/book/man-port-scanning-basics.html">https://nmap.org/book/man-port-scanning-basics.html</a>。</p>

<p>经历依据：前几批总览、网络来源评估、设备普查与误报淘汰记录、后期网络基线。涉及来源与身份变化的描述按各次记录分别归属，不拼成一次连续突破。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="资产识别" /><category term="网络边界" /><category term="服务指纹" /><summary type="html"><![CDATA[相同地址在不同来源下表现不同。用范围、路由、服务指纹和应用响应解释可达性，避免把环境变化写成安全突破。]]></summary></entry><entry><title type="html">华师砺剑 02 · 工具链、靶场与环境排错</title><link href="https://redmoon-2333.github.io/2026/11/12/huali-security-02-toolchain/" rel="alternate" type="text/html" title="华师砺剑 02 · 工具链、靶场与环境排错" /><published>2026-11-12T18:02:00+08:00</published><updated>2026-11-12T18:02:00+08:00</updated><id>https://redmoon-2333.github.io/2026/11/12/huali-security-02-toolchain</id><content type="html" xml:base="https://redmoon-2333.github.io/2026/11/12/huali-security-02-toolchain/"><![CDATA[<h2 id="一工具要按问题分工">一、工具要按问题分工</h2>

<p>培训接触到的工具很多，真正决定效率的是它们如何接在一起。以下分类综合了课堂内容与本地运行记录；其中 httpx、ffuf、dnsx 出现在扩展工具目录，不能仅凭安装文件推定每一种都完成了独立实战验证。</p>

<table>
  <thead>
    <tr>
      <th>环节</th>
      <th>工具或组件</th>
      <th>在这次训练中的用途</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>可控实验环境</td>
      <td>Docker、WSL、Pikachu、Struts2 靶场</td>
      <td>学习请求响应与已知漏洞的表现，检查工具是否正常工作</td>
    </tr>
    <tr>
      <td>资产与服务发现</td>
      <td>fscan、Nmap、Goby</td>
      <td>收集可达端点、端口与服务线索</td>
    </tr>
    <tr>
      <td>Web 候选发现</td>
      <td>AWVS、Nuclei</td>
      <td>产生需要进一步验证的问题</td>
    </tr>
    <tr>
      <td>请求观察与比较</td>
      <td>Burp Suite、curl、浏览器</td>
      <td>检查身份、跳转、请求参数和实际响应</td>
    </tr>
    <tr>
      <td>目录与组件检查</td>
      <td>dirsearch、Wappalyzer</td>
      <td>发现路径和技术栈线索</td>
    </tr>
    <tr>
      <td>注入学习与验证</td>
      <td>sqlmap</td>
      <td>在本地靶场理解检测与响应证据</td>
    </tr>
    <tr>
      <td>协议与材料处理</td>
      <td>Python、PowerShell、JSON、CSV</td>
      <td>解析已有记录、生成限定用途脚本、建立证据索引</td>
    </tr>
  </tbody>
</table>

<p>工具交接时最容易丢的是上下文。扫描器发现一个 URL，下一步不能只复制地址，还应带上来源网络、发现时间、请求方法、认证状态和命中依据。否则换了工具，实验条件也悄悄换了。</p>

<h2 id="二环境迁移暴露出的依赖关系">二、环境迁移暴露出的依赖关系</h2>

<p>11 月 7 日的恢复记录中，Docker 数据、WSL 和 Anaconda 迁到另一块磁盘后出现过一串故障：镜像和容器在当前数据位置不可见，发行版名称变化，启动脚本仍指向旧解释器，部分工具入口文件缺失。</p>

<p>这些现象不能统称为“Docker 坏了”。排查需要区分四层：</p>

<ol>
  <li>磁盘上是否仍有原始数据或归档镜像；</li>
  <li>当前程序读取的是哪个数据目录；</li>
  <li>环境脚本解析到哪个解释器和可执行文件；</li>
  <li>服务启动后，应用是否真的返回预期内容。</li>
</ol>

<p>当数据盘切换后界面显示空容器列表，最先要核对的是当前数据位置，而不是直接删除旧盘。历史恢复过程使用保留的镜像归档重建靶场，并更新解释器路径；随后用页面、工具输出和应用数据逐项回归。</p>

<p>这里的验收应落在功能上。容器处于运行状态，说明容器进程启动了；页面返回成功，说明某个 HTTP 请求得到响应；靶场数据库初始化完成后，训练题目能得到预期结果，才进一步支持应用已经可用。</p>

<h2 id="三burp-没有记录先检查流量经过哪里">三、Burp 没有记录，先检查流量经过哪里</h2>

<p>历史记录中有一个很典型的问题：浏览器或命令行能访问本地靶场，Burp 的 HTTP history 却是空的。排查发现，请求工具受 <code class="language-plaintext highlighter-rouge">NO_PROXY</code> 影响，对本机地址绕过了代理。</p>

<p>这类故障说明“配置了代理”和“这次请求实际使用了代理”是两件事。需要检查请求工具自身的代理选项、环境变量、目标地址及代理监听位置，再用一条普通请求验证。</p>

<p>本地留存的 Burp 历史截图可以看到指向两个靶场入口的四条请求，以及方法、状态、响应长度和监听器信息。它支持“代理确实捕获到了流量”。这比启动窗口的标题或一段“配置成功”日志更直接。</p>

<p>Burp 在后续工作中的重要用途是保存和比较事务。Repeater 允许在可控条件下修改请求并检查响应；Comparer 则帮助定位差异。真正需要关注的是身份和资源有没有变化、返回的是业务内容还是登录页，而不是把所有响应差异都解释成漏洞。〔1〕</p>

<h2 id="四容器里的本机地址与宿主机不是一个对象">四、容器里的本机地址，与宿主机不是一个对象</h2>

<p>扫描工具运行在容器内时，回环地址指向的是该容器自身。若把宿主机浏览器能够访问的本机 URL 原样填入容器内工具，实际访问对象可能已经变了。</p>

<p>这会造成两种迷惑现象：目标“明明能打开”但扫描器连接失败，或者扫描器访问到了另一个服务。排查时要写清发起请求的进程在哪里，以及它看到的网络空间。</p>

<p>在本地训练中，最容易理解的拓扑包括宿主机、代理、扫描器容器和靶场容器。每次核对其中的一条连接，确认实际目标和预期目标一致，再扩大测试范围。已知靶场也因此兼任工具的对照组：若已知服务都识别不出来，应先解决环境问题。</p>

<h2 id="五路径和工作目录会改变程序行为">五、路径和工作目录会改变程序行为</h2>

<p>另一类故障来自中文、空格和相对路径。本地工具目录为部分原生程序设置了 ASCII 路径别名；Java 启动时，带空格的 JAR 路径曾因参数拆分而失败；Python 迁移后，旧路径仍出现在启动脚本中。</p>

<p>这些问题都可以拆成明确检查：</p>

<table>
  <thead>
    <tr>
      <th>现象</th>
      <th>需要核对的对象</th>
      <th>有说服力的验证</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>找不到脚本或 JAR</td>
      <td>可执行文件路径与实际参数</td>
      <td>程序读取到完整路径，正常启动目标文件</td>
    </tr>
    <tr>
      <td>包安装过却不能导入</td>
      <td>安装与运行所用解释器</td>
      <td>同一解释器能导入依赖并执行最小功能</td>
    </tr>
    <tr>
      <td>文件存在却打不开</td>
      <td>当前工作目录与相对路径基准</td>
      <td>从约定目录启动，实际读到预期文件内容</td>
    </tr>
    <tr>
      <td>GUI 点击错位</td>
      <td>窗口句柄、缩放与坐标体系</td>
      <td>操作确实作用于目标控件</td>
    </tr>
    <tr>
      <td>扫描进度完成却没有资产</td>
      <td>结果文件、日志与采集方式</td>
      <td>输出包含可解析的端点和响应证据</td>
    </tr>
  </tbody>
</table>

<p>单纯增加重试次数通常不能解决这类问题。应先找到输入在何处被解释错了，再做一个足够小的验证。</p>

<h2 id="六模板数量与工具能力的关系">六、模板数量与工具能力的关系</h2>

<p>训练环境中有大量模板。模板库规模表示可供选择的规则数量，不能直接代表目标覆盖率或发现质量。模板是否适配目标组件、匹配条件是否足够具体、操作是否符合本次验证范围，都需要单独判断。</p>

<p>Nuclei 的 matcher 可以根据状态码、文字、正则等条件匹配，并通过逻辑条件组合。〔2〕 如果规则只检查一个通用字符串，许多不同服务都可能命中。模板运行成功，只说明规则完成了检查；是否构成漏洞，还要回到实际响应。</p>

<p>工具版本和模板版本也应一起保存。同一个模板 ID 在不同版本中可能改变匹配逻辑，后来下载的新模板不能自动解释过去那次命中。</p>

<p>本地环境恢复记录最有价值的部分，是每种工具都配了一段可观察的功能结果。公开复盘保留这些排错经验，不将历史安装包、商业软件授权处理或实验凭据作为复现附件。读者搭建自己的环境时，使用官方发行渠道、开源版本或合法授权版本即可沿用相同的排查思路。</p>

<h2 id="参考">参考</h2>

<p>〔1〕 PortSwigger，Burp Repeater 官方文档：<a href="https://portswigger.net/burp/documentation/desktop/tools/repeater">https://portswigger.net/burp/documentation/desktop/tools/repeater</a>。</p>

<p>〔2〕 ProjectDiscovery，Matchers：<a href="https://docs.projectdiscovery.io/templates/reference/matchers">https://docs.projectdiscovery.io/templates/reference/matchers</a>。</p>

<p>经历依据：本地工具环境说明与迁移恢复记录、工具教程、首日培训转写、Burp 历史截图。工具目录中的存在性与实际运行证据分别使用。</p>]]></content><author><name>RedMoon</name></author><category term="技术实践" /><category term="工具链" /><category term="Docker" /><category term="Burp Suite" /><category term="环境排错" /><summary type="html"><![CDATA[从 Docker 数据迁移、Python 路径和代理绕行等实际问题，理解工具为什么能启动却不一定能工作。]]></summary></entry></feed>