· 强化学习 / 多智能体 / MADDPG / Actor-Critic / 连续动作
Day8 · MADDPG:连续动作与集中式评分
这一天解决的问题
Day7 用局部动作评分和单调 Mixer 训练合作策略。Day8 改用连续动作:每人直接输出一个数,训练时由 Critic 观察双方信息和动作,告诉各自的 Actor 怎样调整。
学习中最关键的疑问是:Critic 知道队友这次选了什么,Actor 却不知道。假如队友选择变了,同一个动作可能从好变坏,Actor 到底在学什么?
答案要同时看信息边界和更新方式。Actor 学习的是局部信息下、针对训练中队友行为的平均响应;双方共同训练,可以形成稳定的配合约定。执行时 Actor 的输入仍然是局部观测,不能因此恢复完全不可见的独立随机信息。
下文用“两轮连续数值对齐”实验把这条思路落实到代码:联合回放 → 目标动作与 TD → Critic 拟合 → 本人动作梯度 → 四个目标副本软同步 → 完整分散评估。正文给出关键代码和张量含义;教学算例与实际训练结果分别标明。
1. Critic 看见队友,Actor 为什么仍然不能猜到秘密
先用一个离散的单步例子说明。两人各选 0 或 1,相同得奖励 2,不同得 0。记队友选择 0 的概率为 $p$:
\[\mathbb E[r\mid a_0=0]=2p,\qquad \mathbb E[r\mid a_0=1]=2(1-p).\]队友经常选 0 时,自己选 0 的平均收益更高;队友经常选 1 时,方向相反。Critic 可以分别评价 (0,0)、(0,1) 等具体组合,Actor 的多次更新则综合这些不同经历。
def expected_rewards(teammate_p0):
    choose_0 = 2 * teammate_p0
    choose_1 = 2 * (1 - teammate_p0)
    return choose_0, choose_1

print(expected_rewards(0.8))  # (1.6, 0.4)
print(expected_rewards(0.5))  # (1.0, 1.0)
teammate_p0 表示队友的行为分布,不是自己执行时知道的“本轮队友动作”。若队友每次独立、均匀随机选择,自己得不到提示,选择 0 和选择 1 的期望完全相同。
即使自己以任意概率 $q$ 选择 0,匹配概率仍然是:
\[P(\text{匹配})=q\times0.5+(1-q)\times0.5=0.5.\]这时无法只靠训练突破 50% 的匹配上限。Critic 事后看到了联合动作,不会给 Actor 增加本轮尚未看见的信息。
局部 Critic 也可以拟合队友策略下的平均价值。集中式 Critic 多看联合动作,能够区分具体匹配与失配的条件结果;它改变的是训练时的评价依据。队友策略持续变化时,平均价值也会变化,联合信息有助于描述这种变化,但训练仍需要持续更新。
如果两人的策略都参与训练,情况就不同了:队友的选择分布也会变化。双方可能逐渐偏向同一个动作,形成约定。但这不应解释成“某个组合出现得多,它的真实 Q 就必然变大”。在刚才一步结束的对称游戏中,正确的两种匹配 Q(0,0) 和 Q(1,1) 都是 2;变化的是队友策略下的平均收益,以及网络对它们的近似。
“雪崩式越选越多”可以形容某些训练现象,却不能替代上述机制,也不能保证每次训练一定形成好约定。
2. 连续动作:从选哪个,变成怎样调整这个数
Day6 的离散 Actor 输出动作概率,再从分布中采样。今天的确定性 Actor 直接输出一个连续动作:
\[a_i=\mu_i(o_i).\]$o_i$ 是本人能获得的观测,$\mu_i$ 是自己的策略网络。同一组参数和相同输入在当前 MLP 中产生同一个动作;训练探索由网络输出之外的噪声提供。
用一个单步解析算例观察调整方向:
\[Q(a_0,a_1)=-(a_0-a_1)^2,\qquad \frac{\partial Q}{\partial a_0}=-2(a_0-a_1).\]固定队友为 0.8,自己输出 0.2,动作导数是 +1.2,提高自己的动作能提高评分;自己已经输出 0.9 时,导数变成 -0.2,应该稍微降低。
import torch

own_action = torch.tensor(0.2, requires_grad=True)
teammate_action = torch.tensor(0.8)
q = -(own_action - teammate_action).square()
q.backward()
print(own_action.grad.item())  # 约 +1.2
这里的 own_action 是用于手算验证的可微标量。实际训练更新的是 Actor 参数,梯度要经过“参数 → 动作 → Critic 评分”的链式法则:[1]
$\theta_i$ 表示 Actor 参数,$\mathcal D$ 是回放数据。第一部分描述参数怎样影响动作,第二部分描述动作怎样影响评分。两者接起来,才是网络参数的更新方向。
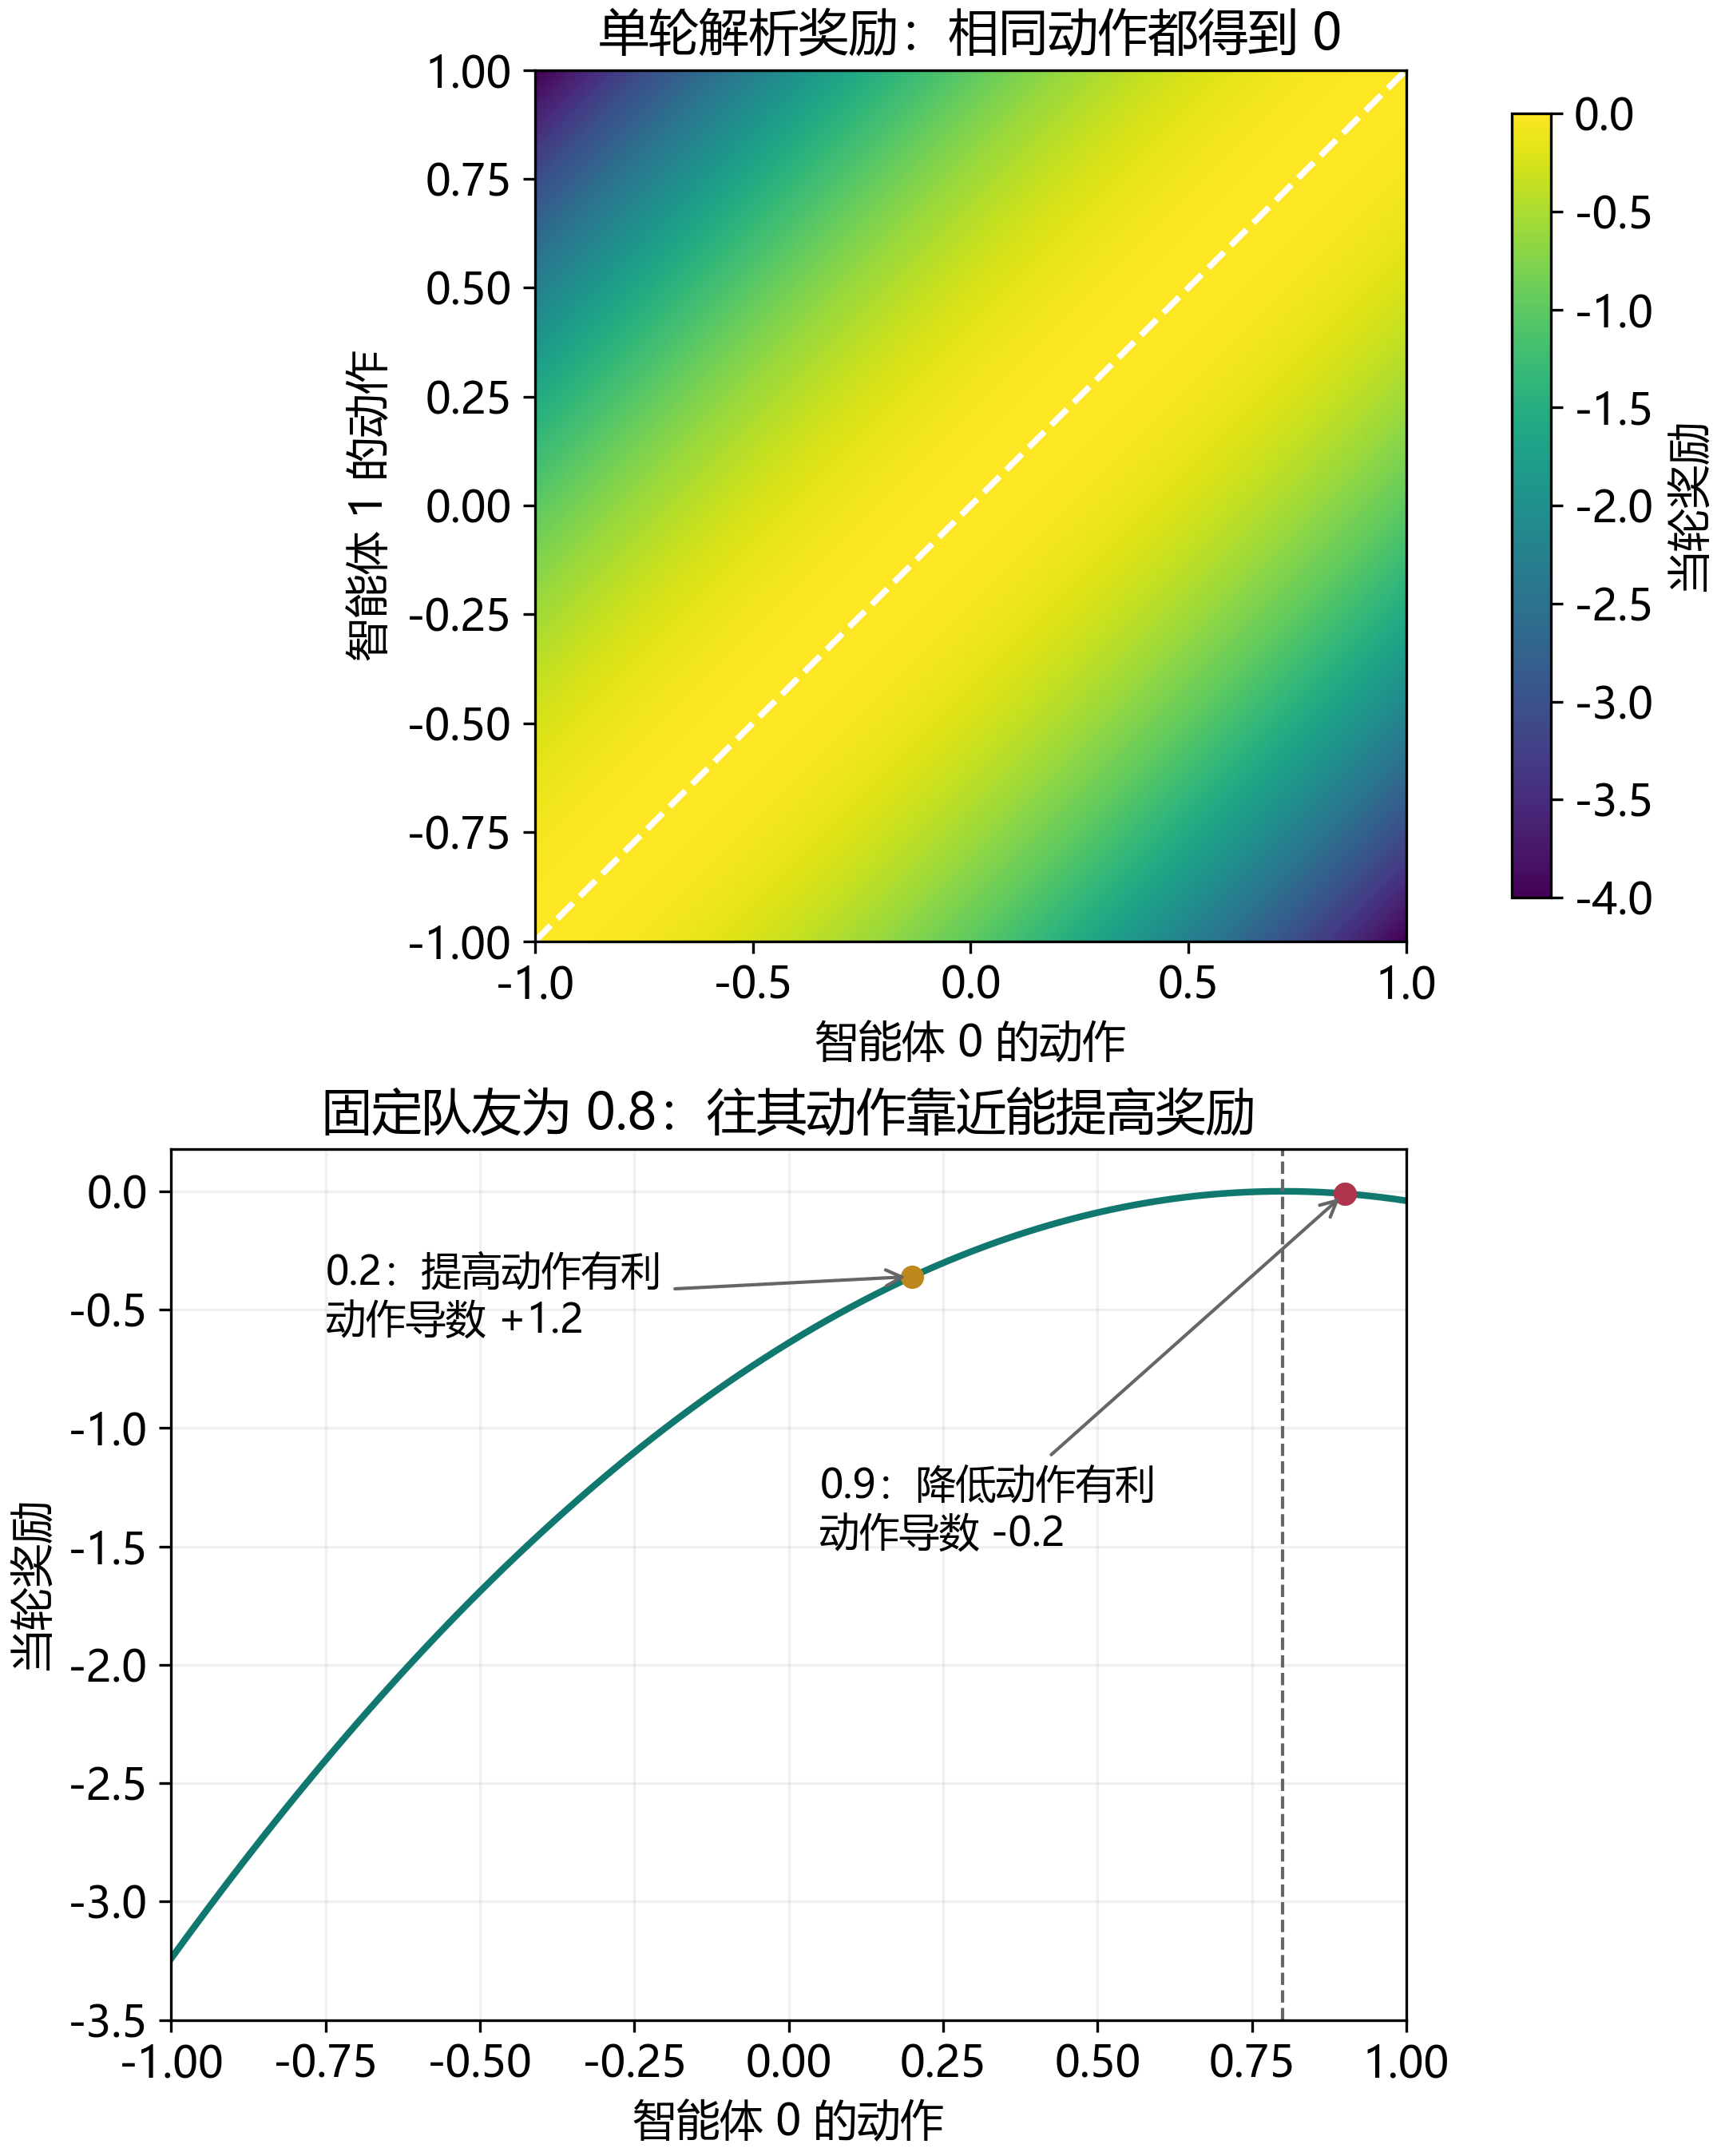
热力图的整条对角线都得到最高奖励 0,所以双方选 0、0.5 或 -0.7 都可以成功。下方曲线展示固定队友后的调整方向;它使用解析单步奖励,帮助理解梯度,并非两轮神经 Critic 的实测价值曲面。
3. 两轮实验:动作直接设置数值,共同奖励来自差距
环境有两名智能体,每人输出一个 [-1,1] 的连续数值。动作直接设置自己的新数值,双方同时行动。每轮共同奖励是:
差距越小,奖励越接近 0。两轮之后真正终止,整局总奖励为两轮奖励相加。每轮奖励在 [-4,0] 内,整局总奖励在 [-8,0] 内;0 是最高奖励。
全局状态为 [x0, x1, phase]。x0/x1 是上一次执行后各自的数值,phase 是已经完成的轮数:开始为 0,第一轮后为 1,第二轮后为 2。
import random

class TwoRoundAgreementEnv:
    def __init__(self, seed):
        self.rng = random.Random(seed)
        self.finished = True

    def reset(self, initial=None):
        self.positions = (
            tuple(float(x) for x in initial) if initial is not None else
            (self.rng.uniform(-1, 1), self.rng.uniform(-1, 1))
        )
        self.phase, self.finished = 0, False
        return (*self.positions, self.phase)

    def step(self, actions):
        if self.finished:
            raise RuntimeError("本局已经终止,请先 reset")
        assert len(actions) == 2 and all(-1 <= a <= 1 for a in actions)
        self.positions = tuple(float(a) for a in actions)
        reward = -(self.positions[0] - self.positions[1]) ** 2
        self.phase += 1
        self.finished = self.phase == 2
        return (*self.positions, self.phase), reward, self.finished
reset() 开始新局,step() 执行一次共同动作。这里摘取环境主体,省略原练习的统计计数器,不改变任务规则。
观测转换固定了信息边界:
device = torch.device("cpu")

def local_observations(state):
    x0, x1, phase = state
    return torch.tensor(
        [[x0, phase], [x1, phase]],
        dtype=torch.float32, device=device,
    )
返回形状是 [2,2]:第一行给智能体 0,第二行给智能体 1。每人只看自己的数值和公共阶段,不看队友数值。训练系统可以保留两行供 Critic 使用,但执行时不能把第二行悄悄送给第一个 Actor。
这个任务没有隐藏随机目标,也没有消息通道。双方学会输出相近的共同值即可完成;一个固定共同约定就足以解题,当前使用 MLP。它承接 Day7 的合作训练思想,通信的作用则要回到 Day6 那个“另一人必须知道随机提示”的任务中观察。
4. 网络分工:两个局部 Actor、两份集中式 Q、四个目标副本
Actor 输入 [自己的数值, 公共阶段],输出一个连续动作。末尾 Tanh 将输出限制在 (-1,1)。
from torch import nn

class LocalActor(nn.Module):
    def __init__(self, initial_bias):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(2, 32), nn.Tanh(),
            nn.Linear(32, 32), nn.Tanh(),
            nn.Linear(32, 1), nn.Tanh(),
        )
        with torch.no_grad():
            self.net[-2].bias.fill_(initial_bias)

    def forward(self, own_observation):
        return self.net(own_observation)
Linear(2,32) 把两个观测数变成 32 个隐藏特征;Linear(32,1) 产生一个输出。初始输出层偏置分别为 +0.6、-0.6,帮助观察开始时不协调的策略。偏置在最终 Tanh 之前,网络还有其他权重,因此实际动作并不直接等于这两个数字。
Critic 把双方观测和动作拼接起来,预测一条经历的未来折扣回报:
class CentralCritic(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(6, 32), nn.Tanh(),
            nn.Linear(32, 32), nn.Tanh(),
            nn.Linear(32, 1),
        )

    def forward(self, obs, actions):
        inputs = torch.cat(
            [obs.flatten(start_dim=1), actions.flatten(start_dim=1)],
            dim=1,
        )
        return self.net(inputs)
设批量大小为 B,观测是 [B,2,2],动作是 [B,2,1]。从第 1 维开始展平,分别得到 [B,4] 和 [B,2],再拼成 [B,6]:
[x0, phase, x1, phase, a0, a1] → 一个 Q 预测
公共阶段出现两次,来自直接拼接局部观测。对这个任务,两行观测的并集已经包含全局状态信息。Critic 输出 [B,1],每条转移一个数;输出层不加 Tanh,因为 Q 的尺度由回报决定。
import copy

actor_lr, critic_lr = 0.0005, 0.002
actors = [LocalActor(0.6).to(device), LocalActor(-0.6).to(device)]
critics = [CentralCritic().to(device) for _ in range(2)]
target_actors = copy.deepcopy(actors)
target_critics = copy.deepcopy(critics)
for target in target_actors + target_critics:
    target.requires_grad_(False)

actor_optimizers = [
    torch.optim.Adam(a.parameters(), lr=actor_lr) for a in actors
]
critic_optimizers = [
    torch.optim.Adam(c.parameters(), lr=critic_lr) for c in critics
]
每个 Actor 有对应的集中式 Q Critic。[1] 当前奖励是共同奖励,两份 Critic 都学习团队回报,参数分别训练;它们的数值差异不能解释成个人贡献或责任份额。
目标副本用于构造比较缓慢变化的 TD 目标:目标 Actor 提供下一步动作,目标 Critic 评价这些动作。deepcopy 得到独立参数;它们不会因在线优化器 step() 自动变化,而是由后面的软同步更新。
本文练习使用确定性 Tanh Actor 和外加高斯噪声,保留 MADDPG 的主要数据流;作者仓库中的动作分布、正则项等实现细节不在此练习中展开。[2]
5. 联合回放:同一局、同一步的双方数据必须配对
回放中一行记录一次共同交互。obs 与 actions 同时包含两人,next_obs 与 terminated 来自这次交互的真实结果。
from collections import deque
from typing import NamedTuple

class Transition(NamedTuple):
    obs: torch.Tensor
    actions: torch.Tensor
    rewards: torch.Tensor
    next_obs: torch.Tensor
    terminated: torch.Tensor

seed, replay_capacity, batch_size = 7, 5000, 128
replay = deque(maxlen=replay_capacity)
replay_rng = random.Random(seed + 1)
NamedTuple 给五项数据起名字,方便通过 batch.obs 等访问。deque(maxlen=5000) 最多保留 5000 条转移,超过容量时淘汰最旧条目。回放抽样使用独立随机数生成器。
def save_transition(state, actions, reward, next_state, terminated):
    replay.append(Transition(
        local_observations(state),
        torch.tensor(actions, dtype=torch.float32, device=device).view(2, 1),
        torch.full((2, 1), reward, dtype=torch.float32, device=device),
        local_observations(next_state),
        torch.tensor([float(terminated)], dtype=torch.float32, device=device),
    ))

def sample_batch():
    rows = replay_rng.sample(list(replay), batch_size)
    return Transition(*(torch.stack(field) for field in zip(*rows)))
保存的是加噪声、裁剪后真正执行的动作,因为真实奖励来自这些动作。保存干净动作却配上带噪声动作的奖励,会让 Critic 学到错误配对。
共同奖励在 rewards 中复制两份,便于分别训练两个 Critic;每个 Critic 取自己对应的一份,整局环境奖励仍然只计一次。复制数据不意味着把团队回报乘以 2。
sample_batch() 抽取完整行,zip(*rows) 按字段分组,torch.stack 增加批量维度:
| 字段 | 单条形状 | 批量形状 | 含义 |
|---|---|---|---|
obs |
[2,2] |
[B,2,2] |
双方本步局部观测 |
actions |
[2,1] |
[B,2,1] |
双方实际执行动作 |
rewards |
[2,1] |
[B,2,1] |
分给两份 Critic 的共同奖励 |
next_obs |
[2,2] |
[B,2,2] |
同一步产生的下一观测 |
terminated |
[1] |
[B,1] |
第二轮真正终止为 1,否则 0 |
不能给两名智能体各自随机抽样,再把不同局、不同时间的动作拼起来。联合 Critic 要评价的是同一次真实发生的配合。
历史状态、实际动作、奖励和终止事实保持不变;以后抽到这条经历时,网络预测和重算的 TD 目标可能改变。这与 Day7 的回放区分一致。
6. TD 目标:下一步先生成联合动作,再评价
连续动作不需要枚举所有数字做 argmax。当前实现直接让两个目标 Actor 在下一观测上生成动作,再交给目标 Critic:
- 表示目标网络,d 表示真正终止,gamma=0.9。第一轮后保留未来价值;第二轮真正结束时 d=1,目标只剩当前奖励。
gamma, tau = 0.9, 0.01

@torch.no_grad()
def td_targets(batch):
    next_actions = torch.stack(
        [target_actors[i](batch.next_obs[:, i]) for i in range(2)],
        dim=1,
    )
    targets = []
    for i in range(2):
        next_q = target_critics[i](batch.next_obs, next_actions)
        y = batch.rewards[:, i] + gamma * (1 - batch.terminated) * next_q
        targets.append(y)
    return targets
batch.next_obs[:,i] 取批次中智能体 i 的下一观测,形状 [B,2]。每个目标 Actor 输出 [B,1],stack(...,dim=1) 得到 [B,2,1] 的下一联合动作。
这里既不用本步旧动作,也不加训练探索噪声。它回答的是“在这条经历的下一状态,目标策略会怎样做,目标 Critic 怎样评价”。
rewards[:,i]、终止标记和 next_q 都是 [B,1],结果也必须是 [B,1]。若误把一个量压成 [B],它与 [B,1] 运算可能广播成 [B,B],把不同样本混在一起而不立即报错。
下面是两条转移的教学核算:
reward = torch.tensor([[-0.36], [-0.04]])
terminated = torch.tensor([[0.0], [1.0]])
next_q = torch.tensor([[-0.10], [-0.90]])
y = reward + 0.9 * (1 - terminated) * next_q
print(y)  # [[-0.45], [-0.04]]
第二条的下一 Q 虽然算出了 -0.90,终止标记仍把未来项清零。终止步的奖励不能删除;需要删除的是它之后的未来价值。
no_grad() 使 TD 目标不参与反向传播。真正终止与外部时间限制截断的区别沿用前几天;本环境的第二轮是任务本身结束,不是提前中止一条仍有后续价值的轨迹。
7. 一次联合更新:先训练 Critic,再替换本人的动作
Critic 阶段使用回放中真实发生过的联合动作,拟合两份 TD 目标:
from torch.nn import functional as F

batch = sample_batch()
targets = td_targets(batch)
for i in range(2):
    q = critics[i](batch.obs, batch.actions)
    loss = F.mse_loss(q, targets[i])
    critic_optimizers[i].zero_grad(set_to_none=True)
    loss.backward()
    critic_optimizers[i].step()
zero_grad() 清除上一轮梯度,backward() 计算本轮梯度,step() 改参数。目标不反传,在线 Critic 根据预测与目标的平方误差调整。
Actor 阶段重新生成本人的当前动作,队友动作仍使用回放值。这是当前练习采用的更新约定,也与作者源码中的“只替换正在更新的智能体动作”对应。[2]
for i in range(2):
    critic = critics[i]
    critic_optimizers[i].zero_grad(set_to_none=True)
    critic.requires_grad_(False)

    own_action = actors[i](batch.obs[:, i])
    action_parts = [batch.actions[:, j] for j in range(2)]
    action_parts[i] = own_action
    actions_for_actor = torch.stack(action_parts, dim=1)

    loss = -critic(batch.obs, actions_for_actor).mean()
    actor_optimizers[i].zero_grad(set_to_none=True)
    loss.backward()
    actor_optimizers[i].step()
    critic.requires_grad_(True)
假设一条回放是 (0.2,0.8),当前两个 Actor 输出为 0.9、0.7:
| 更新阶段 | 交给 Critic 的动作 | 目的 |
|---|---|---|
| Critic 拟合 | (0.2,0.8) |
学真实经历的评分 |
| Actor 0 更新 | (0.9,0.8) |
固定旧队友动作,调整本人 |
| Actor 1 更新 | (0.2,0.7) |
固定旧队友动作,调整本人 |
每次循环重新从 batch.actions 构造列表,所以 Actor 1 不会继承 Actor 0 刚替换的 0.9。表格是教学假设,不是训练中的实测输出。
loss=-Q.mean() 把提高平均评分转成最小化损失。它对批次中多个队友动作求平均,仍然遵守第一节的信息边界。
这里最关键的是保留本人动作的计算图。冻结 Critic 参数,只让它作为可微评分函数参与这次 Actor 更新;不能把整段放进 no_grad(),也不能对 own_action 做 detach()。[3]
actor = nn.Linear(1, 1, bias=False)
critic = nn.Linear(1, 1, bias=False)
with torch.no_grad():
    actor.weight.fill_(0.2)
    critic.weight.fill_(2.0)
critic.requires_grad_(False)

action = actor(torch.ones(1, 1))
loss = -critic(action).mean()
loss.backward()
print(actor.weight.grad)   # tensor([[-2.]])
print(critic.weight.grad)  # None
这个独立小例子里,Critic 权重不收梯度,Actor 仍能收到动作方向。若 action.detach() 再评分,本例的损失就不需要梯度,无法沿这条路径更新 Actor。
最后软同步:
@torch.no_grad()
def soft_update(online, target):
    for online_p, target_p in zip(online.parameters(), target.parameters()):
        target_p.mul_(1 - tau).add_(online_p, alpha=tau)

for online, target in zip(actors + critics, target_actors + target_critics):
    soft_update(online, target)
每个目标参数保留 99% 的旧值,再加入 1% 的在线值。比如旧目标 0.2、在线 0.8,一次同步后为 0.99×0.2+0.01×0.8=0.206。它不是“每 100 次硬复制一次”,而是每轮小幅移动。
两个目标 Actor 和两个目标 Critic 都同步。只同步目标 Critic,会继续用没有跟上的目标 Actor 生成下一步动作;只同步目标 Actor,则评分器没有跟上。一次联合更新包含两次 Critic step()、两次 Actor step(),最后四个目标副本完成软同步。
8. 主训练循环:随机预热、带噪声动作、每步回放更新
本次实际配置如下:
| 配置 | 值 | 作用 |
|---|---|---|
| 随机种子 | 7 | 固定本次初始化与随机过程 |
| 共同训练回合 | 2500 | 每局两轮 |
| 随机预热环境步 | 256 | 先积累较丰富的联合动作 |
| 批量大小 | 128 | 每次抽取 128 条共同转移 |
| 回放容量 | 5000 | 保留转移数量 |
| Actor / Critic 学习率 | 0.0005 / 0.002 | 两类参数更新幅度 |
| 折扣 / 软同步系数 | 0.9 / 0.01 | 未来价值与目标移动幅度 |
| 探索标准差 | 0.3 → 0.08 | 逐回合减少高斯噪声 |
把第七节的 Critic 更新、Actor 更新和软同步按顺序封装进 update_from_replay()。函数每次重新抽一个批次,记录两份 Critic loss、两份 Actor loss 和 Actor 梯度范数并返回;梯度范数反映更新信号大小,不直接代表合作效果。
环境交互只需要干净局部动作:
@torch.no_grad()
def local_actions(actor_models, state):
    obs = local_observations(state)
    return tuple(
        actor_models[i](obs[i:i+1]).item() for i in range(2)
    )
obs[i:i+1] 保留批次维度,得到 [1,2];.item() 把单元素输出变成环境接受的 Python 数值。这段用于真实采样与评估,不能替换第七节需要梯度的 Actor 调用。
num_episodes, start_steps = 2500, 256
noise_start, noise_end = 0.3, 0.08
exploration_rng = random.Random(seed + 2)

train_env = TwoRoundAgreementEnv(seed + 3)
environment_steps = joint_updates = target_syncs = 0
episode_rewards = []

for episode in range(num_episodes):
    state, finished, total_reward = train_env.reset(), False, 0.0
    noise_std = (
        noise_start
        + (noise_end - noise_start) * episode / (num_episodes - 1)
    )
    while not finished:
        if environment_steps < start_steps:
            actions = tuple(
                exploration_rng.uniform(-1, 1) for _ in range(2)
            )
        else:
            clean_actions = local_actions(actors, state)
            actions = tuple(
                max(-1.0, min(1.0, a + exploration_rng.gauss(0, noise_std)))
                for a in clean_actions
            )

        next_state, reward, finished = train_env.step(actions)
        save_transition(state, actions, reward, next_state, finished)
        environment_steps += 1
        total_reward += reward
        if environment_steps >= start_steps:
            c_losses, a_losses, grad_norms = update_from_replay()
            joint_updates += 1
            target_syncs += 1
        state = next_state
    episode_rewards.append(total_reward)
每步的顺序是:选动作 → 环境真实执行 → 保存共同转移 → 更新网络。预热结束后,clean_actions 加独立高斯噪声,再裁剪到动作范围;回放必须保存这里的 actions。
第 256 个动作仍在随机预热中。它执行并保存之后,计数达到 256,立即发生第一次更新。因此 5000 个环境步对应:
联合更新 = 5000 - 256 + 1 = 4745
优化器 step = 4745 × 4 = 18980
完整软同步 = 4745
这些计数分别描述环境交互、网络优化和目标移动,不能混成一个“训练步”。冻结评估用独立环境,不写入回放,也不增加训练环境步数。
9. 冻结评估:只用在线局部 Actor,完整走到第二轮
训练每 200 回合和最后一回合,在固定 9×9=81 个起点上评估,便于比较不同训练时刻。结束后另采 500 个连续随机起点。
import itertools

grid = torch.linspace(-1, 1, 9).tolist()
grid_initials = list(itertools.product(grid, repeat=2))
eval_rng = random.Random(seed + 200)
random_initials = [
    (eval_rng.uniform(-1, 1), eval_rng.uniform(-1, 1))
    for _ in range(500)
]
product 枚举两个数的全部网格组合;另一次随机采样让评估不局限在这 81 个离散起点。每次都运行完整两轮,成功定义为两轮动作差都不超过 0.1。
@torch.no_grad()
def evaluate(actor_models, initials):
    for actor in actor_models:
        actor.eval()
    eval_env = TwoRoundAgreementEnv(seed + 100)
    gaps, totals, discounted, successes = [], [], [], []
    for initial in initials:
        state = eval_env.reset(initial)
        finished, step = False, 0
        total, g0, success = 0.0, 0.0, True
        while not finished:
            actions = local_actions(actor_models, state)
            next_state, reward, finished = eval_env.step(actions)
            gap = abs(actions[0] - actions[1])
            gaps.append(gap)
            total += reward
            g0 += gamma ** step * reward
            success = success and gap <= 0.1
            state, step = next_state, step + 1
        assert step == 2
        totals.append(total)
        discounted.append(g0)
        successes.append(success)
    return {
        "mean_gap": sum(gaps) / len(gaps),
        "max_gap": max(gaps),
        "mean_reward": sum(totals) / len(totals),
        "mean_discounted": sum(discounted) / len(discounted),
        "success_rate": sum(successes) / len(successes),
    }
这是评估主体,省略原练习的调用统计和轨迹保存。mean_gap 平均所有评估局的每一轮差距;mean_reward 先求各局两轮奖励之和,再对局取平均;mean_discounted 用 r0+0.9*r1;success_rate 要求整局两轮都达标。
三个开关要区分:
| 做法 | 实际作用 |
|---|---|
actor.eval() |
切换 Dropout、BatchNorm 等层的行为,本 MLP 没有这些层 |
torch.no_grad() |
不记录反向计算图 |
| 评估中不加高斯噪声 | 真正关闭本例的探索 |
eval() 和 no_grad() 都不会自动删除代码里显式添加的噪声。[3] 这里的评估函数没有加噪声,也没有任何优化器调用。
传入的只有两个在线 Actor。对所有在线及目标网络进行参数快照、给 Critic 和目标 Actor 注册调用计数后,实际检查结果是:评估参数不变,Critic 调用 0,目标 Actor 调用 0。这使“训练集中评价,执行局部行动”的信息边界能在代码中验证。
10. 实际结果:奖励趋近 0,双方形成稳定约定
本节数值来自当前保存输出:CPU,PyTorch 2.10.0+cu128,随机种子 7;图中的训练历史由同源代码重新执行取得,关键结果与保存输出一致。
| 指标 | 训练前 | 训练后 |
|---|---|---|
| 固定 81 起点的每轮平均差 | 0.809328 | 0.018731 |
| 固定 81 起点的两轮平均总奖励 | -1.341871 | -0.001405 |
| 固定 81 起点的整局成功率 | 0/81 | 81/81 |
| 另采 500 起点的每轮平均差 | — | 0.016863 |
| 另采 500 起点的所有轮次最大差 | — | 0.079457 |
| 另采 500 起点的两轮平均总奖励 | — | -0.001142 |
| 另采 500 起点的整局成功率 | — | 500/500 |
成功率使用差距阈值 0.1,表示这 500 局的两轮都达标,不表示动作精确相等,也不表示所有可能起点已经被穷尽。奖励仍略为负,正是因为双方还有小差距。
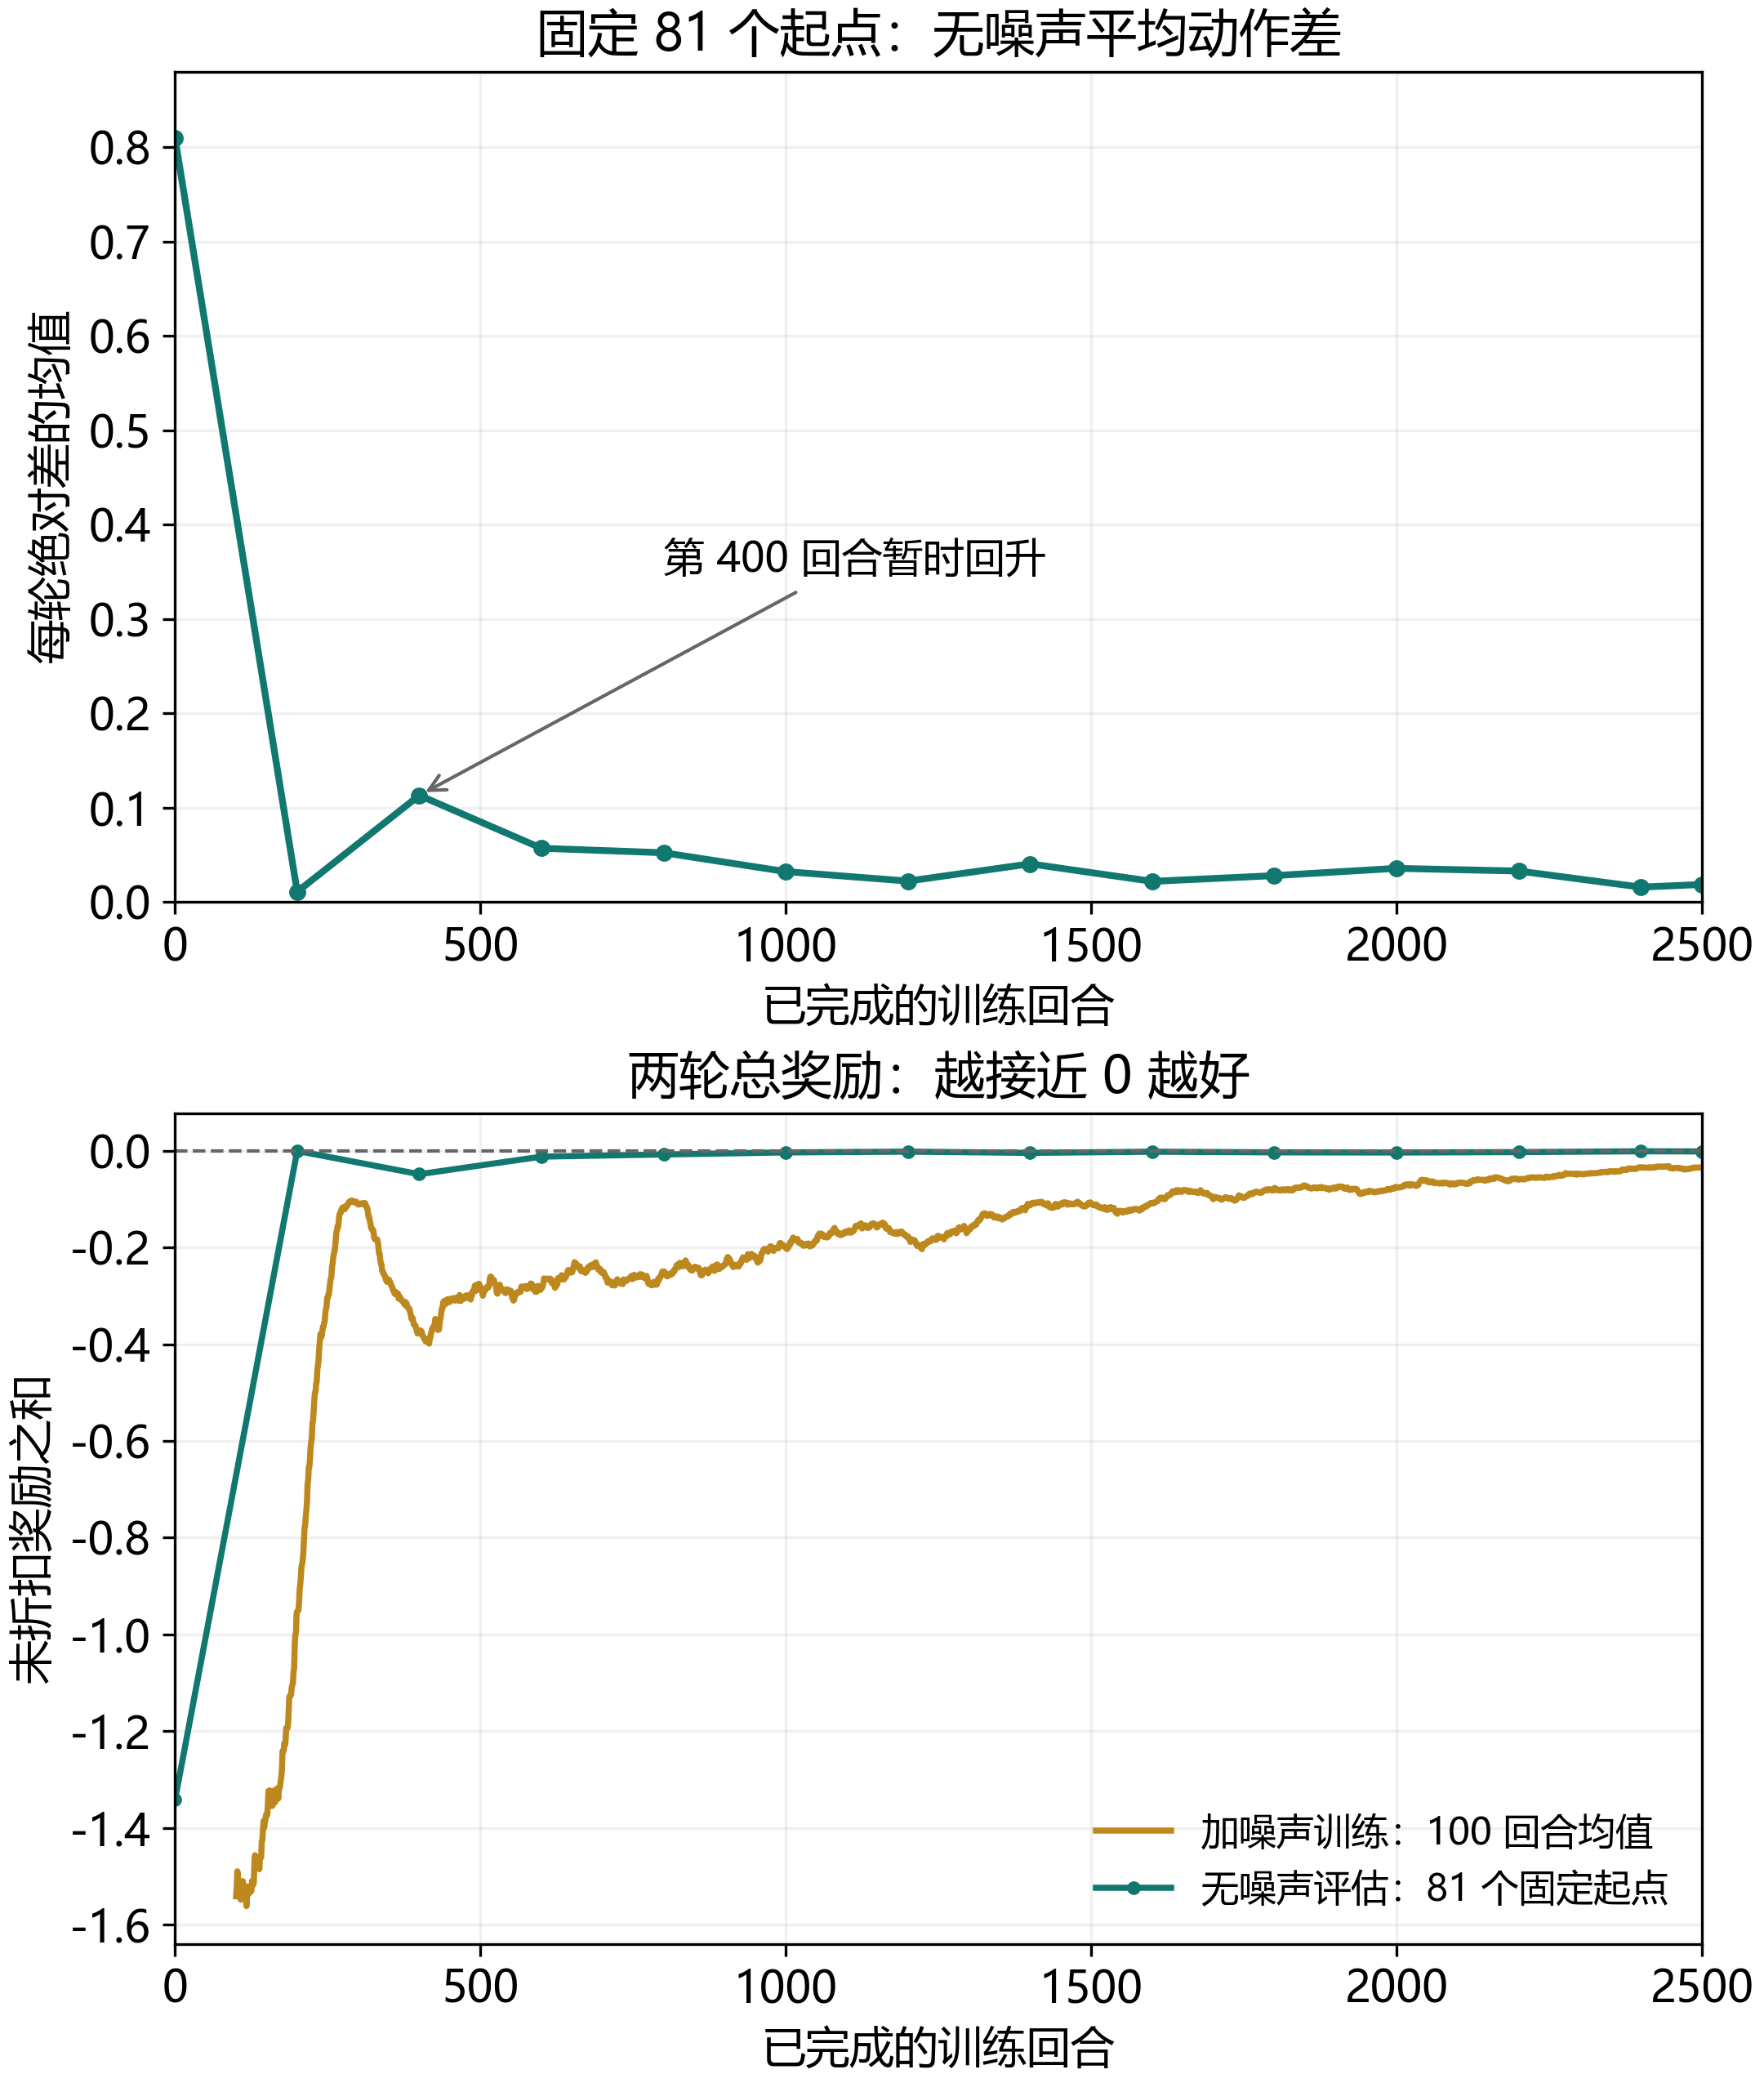
第 200 回合冻结平均差约 0.0110,第 400 回合约 0.1131,随后再次下降。训练中双方策略、回放批次和目标网络持续变化,不能要求每个评估点单调改善;这条曲线本身也不能单独确定某次回升由哪一个因素造成。
训练最后 100 局平均奖励约 -0.034447,低于最终无噪声评估的 -0.001405。训练末仍有约 0.08 的探索标准差,双方实际动作会被噪声拉开,起点集合也不同。比较两个策略的质量,应在相同起点分布、噪声、奖励与终止条件下分别冻结评估。
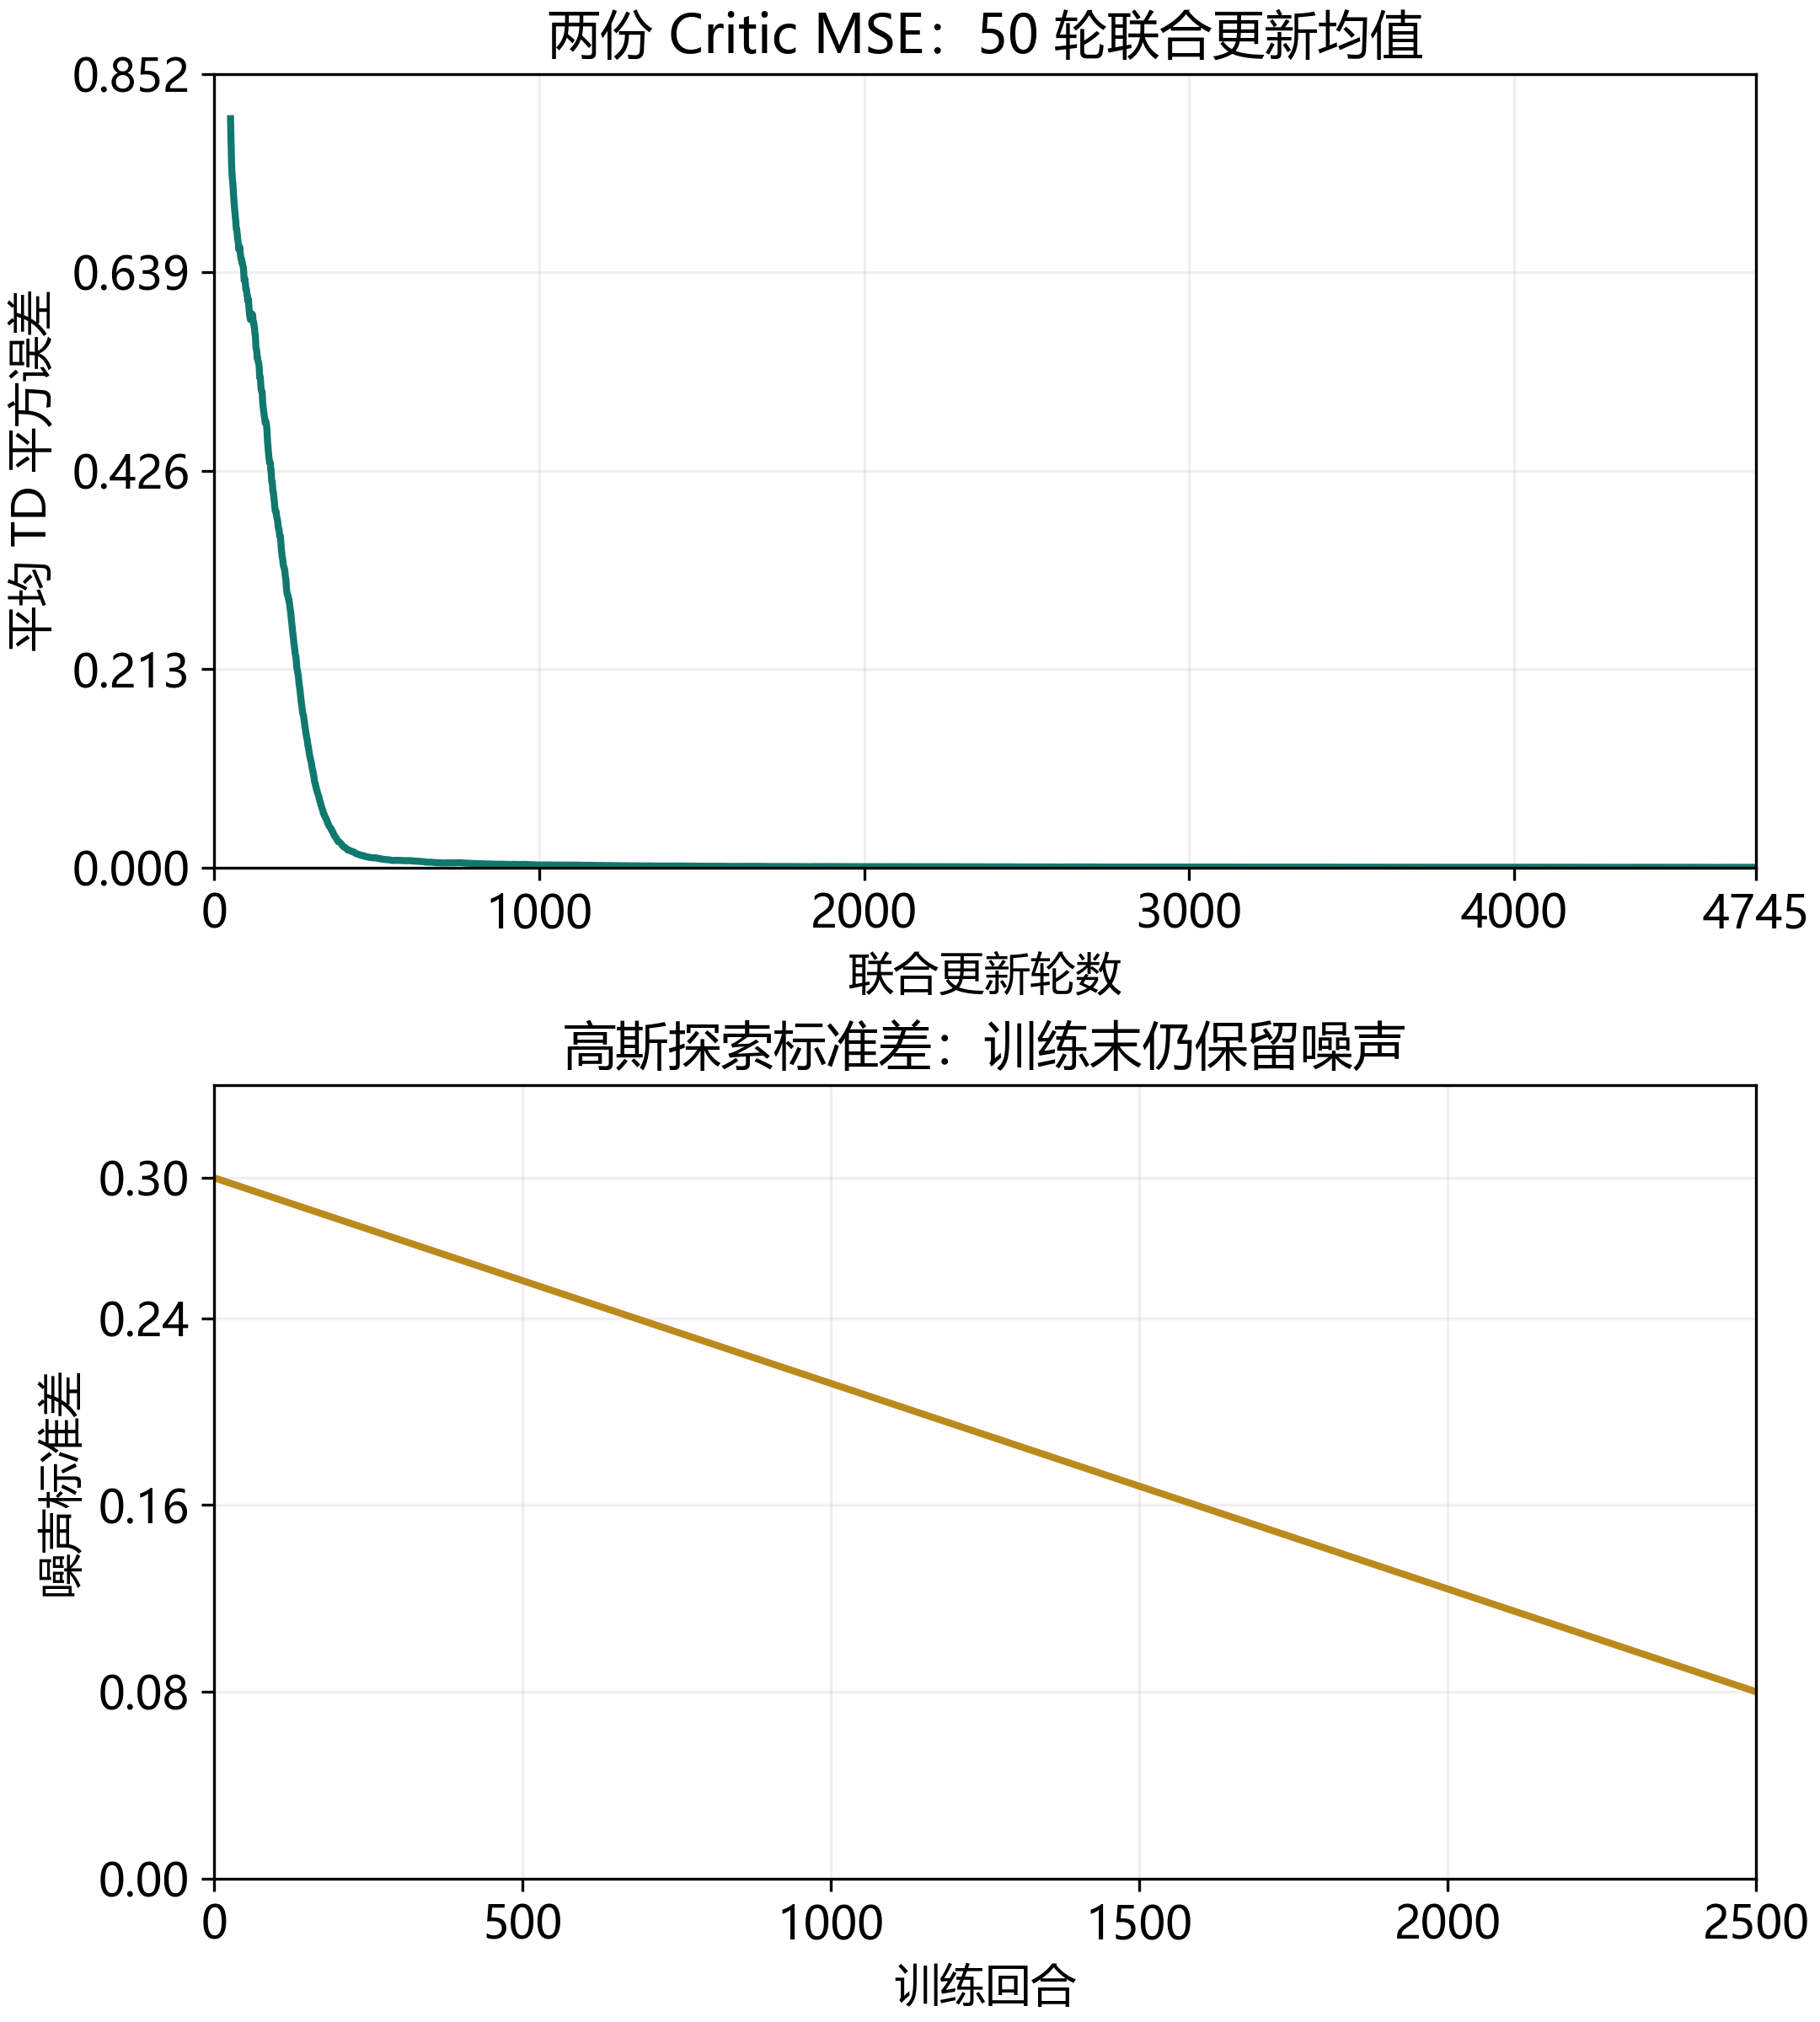
最后 50 轮联合更新的平均 Critic MSE 约 0.00019963。这个值表示抽到的批次上,预测接近当前 TD 目标;目标和批次仍在变化,低 loss 不能替代真实环境中的成功证据。
两条实际轨迹展示了第二轮如何真正结束:
| 初始数值 | 轮次 | 智能体 0 动作 | 智能体 1 动作 | 共同奖励 | 真正终止 |
|---|---|---|---|---|---|
(-1,1) |
1 | 0.408557 | 0.363995 | -0.001986 | 否 |
(-1,1) |
2 | 0.454844 | 0.437522 | -0.000300 | 是 |
(0.7,-0.3) |
1 | 0.362993 | 0.419413 | -0.003183 | 否 |
(0.7,-0.3) |
2 | 0.444480 | 0.450764 | -0.000039 | 是 |
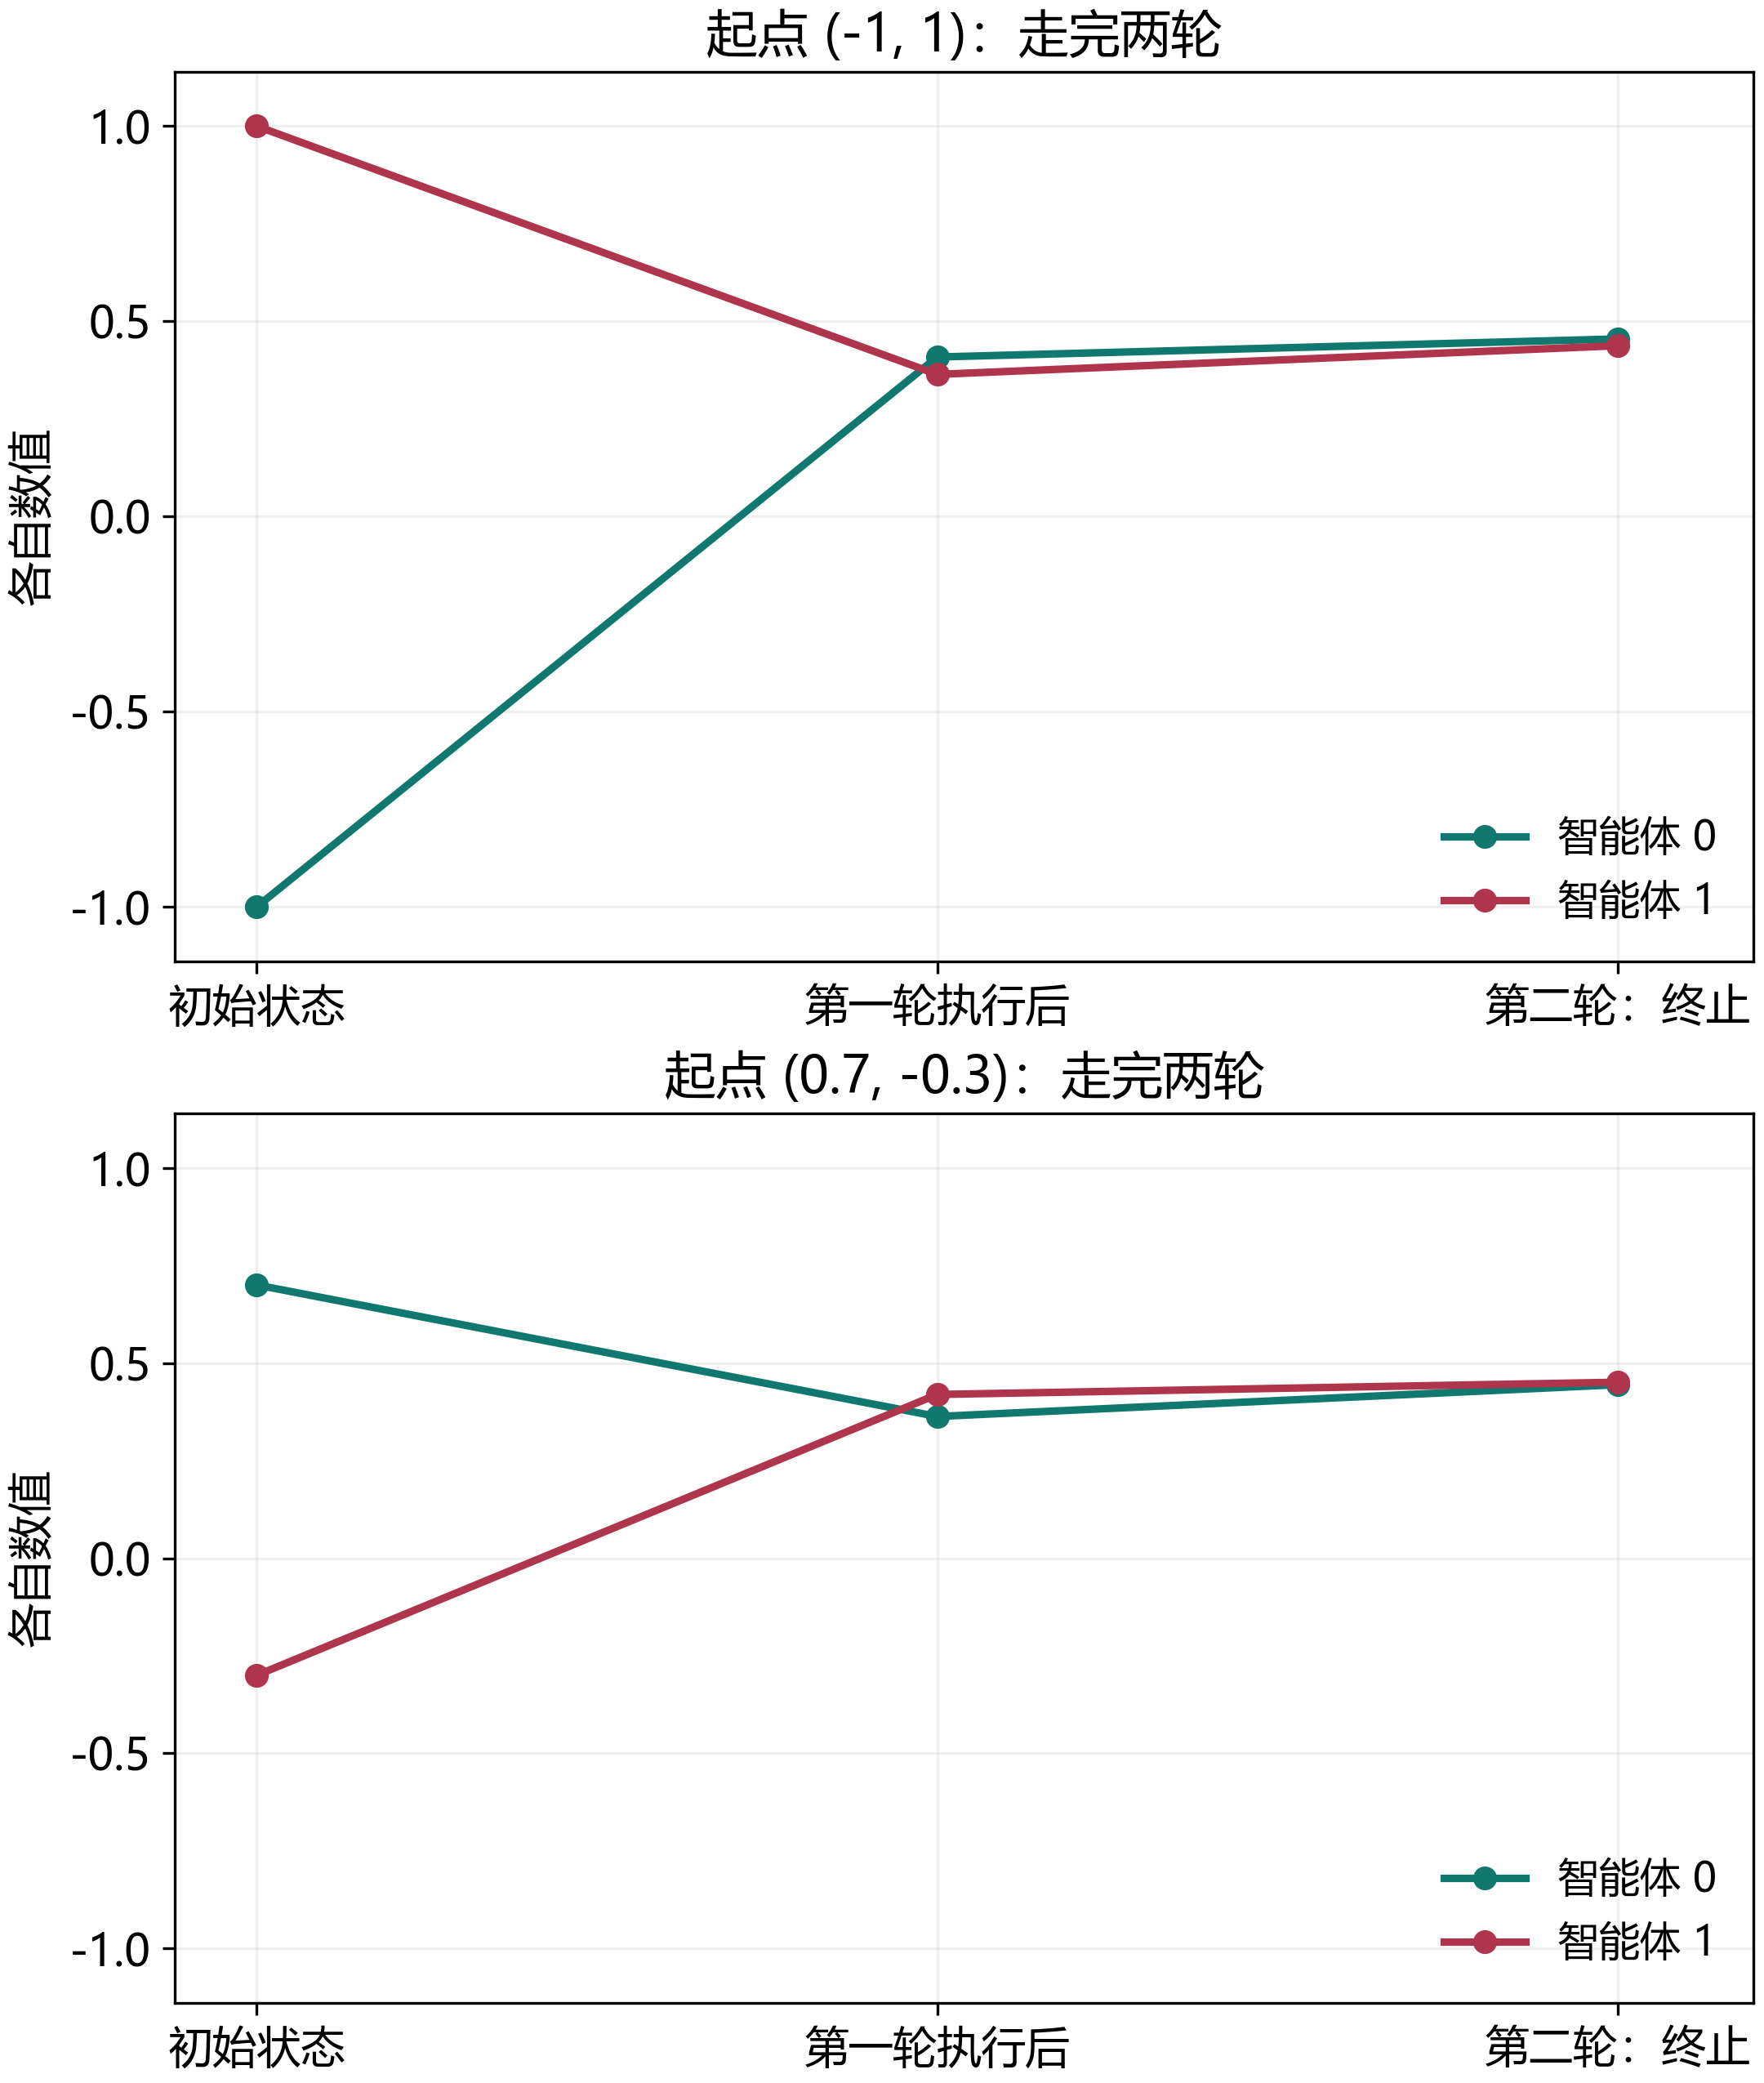
这里学出的共同值接近 0.4~0.45。奖励没有指定它必须等于多少;双方接近就获得较高回报。它说明当前训练形成了相容的局部策略,而不是 Actor 在执行时直接看见队友动作。
把 Day6–Day8 放在一起,三条路线的区别更清楚:
| 学习内容 | 训练时怎样评价 | 执行时怎样行动 | 本次任务中的重点 |
|---|---|---|---|
| Day6 合作训练 | 集中式状态价值与共同优势 | 各自局部概率 Actor | 联合采样与团队反馈 |
| Day6 消息通道 | 发送、接收动作都获得任务学习信号 | 先发消息,再依据消息行动 | 将随机提示送到缺信息的一方 |
| Day7 QMIX | 局部 utility 经单调 Mixer 形成团队 Q | 局部网络选离散贪心动作 | 价值分解与分散选择 |
| Day8 MADDPG 风格 | 每个集中式 Q 看联合观测和动作 | 各自局部连续 Actor | 从动作梯度学习配合 |
集中式训练使用更多信息,分散执行遵守本人的可见信息。通信是执行时增加可用信息的一种机制;当前连续对齐任务用固定约定就能成功。联合 Critic 帮助评价具体动作组合,是否需要消息仍由任务的信息需求决定。
参考资料
- Lowe et al. Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments. NeurIPS 2017,重点对应第 4.1 节的集中式 Q、确定性策略梯度和目标策略:论文。
- 作者实现中 Q 输入联合观测和动作,策略更新只替换本人动作,目标 Actor 与目标 Critic 分别同步:MADDPG 源码。
- PyTorch 官方关于
requires_grad、no_grad和 evaluation mode 的说明:Autograd mechanics。