· 强化学习 / 多智能体 / VDN / QMIX / Double Q
Day7 · 价值分解:从 VDN 到 QMIX 合作训练
这一天解决的问题
Day6 用局部 Actor 和集中式评价接通了合作训练。Day7 换一条路线:每个智能体先给自己的动作打分,再把这些局部评分混合成团队价值,用同一份团队奖励训练。
这里最容易混淆的是“局部评分”和“个人贡献”。局部网络输出的 utility 是团队价值模型的一部分;它服务于选动作,也通过共同损失学习,不能直接解释成某个人实际获得的回报或应当承担的责任。
学习从 VDN 的加和开始,接上 QMIX 的单调混合,再把联合回放和更新放进完整合作训练。单步实验用来观察梯度与参数变化,两轮灯控实验则检查策略能否走完一局。文章中的价值表和 Double Q 小算例是教学数值;训练表格和曲线来自当前练习的实际结果。
1. VDN:把局部动作评分加成团队价值
VDN 是 Value-Decomposition Networks,价值分解网络。合作任务使用一个团队动作价值 $Q_{\mathrm{tot}}$,模型将它写成各智能体局部 utility 的和:[1]
\[Q_{\mathrm{tot}}(\boldsymbol{\tau},\mathbf a) =\sum_{i=0}^{n-1}Q_i(\tau_i,a_i).\]$n$ 是智能体数量,$\mathbf a$ 是同一时刻的联合动作,$\tau_i$ 是智能体 $i$ 能获得的局部行动观测历史。当前简单任务的观测已经足够,局部网络直接用 $o_i$;后文再说明什么时候需要历史。
先固定局部信息,给两个智能体设一组教学评分:
| 局部 utility | 动作 A | 动作 B |
|---|---|---|
| 智能体 0 | 1.2 | 0.3 |
| 智能体 1 | 0.4 | 1.1 |
相加得到团队预测:
| 智能体 0 \ 智能体 1 | A | B |
|---|---|---|
| A | 1.6 | 2.3 |
| B | 0.7 | 1.4 |
import torch

q0 = torch.tensor([1.2, 0.3])  # 智能体 0:A/B 的局部评分
q1 = torch.tensor([0.4, 1.1])  # 智能体 1:A/B 的局部评分
team_table = q0[:, None] + q1[None, :]
actions = (q0.argmax().item(), q1.argmax().item())
print(team_table)
print(actions)  # (0, 1),即 AB
[:, None] 把两个数变成一列,[None, :] 把两个数变成一行,广播相加产生四种联合动作的预测。各自选最高分动作,就得到联合最大值 2.3。
训练时由总和去拟合一个团队目标。例如团队目标为 4.7,约束是总和接近 4.7,不能让两个局部网络分别拟合同一个 4.7,再相加成 9.4。团队奖励在一条共同经历中记录一次。
局部 utility 的分解也不唯一。把一个分量整体加上常数、另一个减去同样的常数,总价值可以不变。因此,直接比较“谁的 utility 更大”,不足以判断谁贡献更多。
2. 从可加关系到单调关系:QMIX 多表达了什么
VDN 的固定价值表满足一个恒等式:
\[Q_{\mathrm{tot}}(A,A)+Q_{\mathrm{tot}}(B,B) =Q_{\mathrm{tot}}(A,B)+Q_{\mathrm{tot}}(B,A).\]展开两边,每边都恰好出现四个局部评分。上表左边为 $1.6+1.4=3.0$,右边为 $2.3+0.7=3.0$。不满足这个等式的表,固定信息下的纯加和就无法精确表示。
QMIX 用单调混合函数替代简单求和。在固定全局状态下,提高任何一个局部 utility,都不能让团队预测降低:[2]
\[Q_{\mathrm{tot}}=f_s(Q_0,\ldots,Q_{n-1}), \qquad \frac{\partial Q_{\mathrm{tot}}}{\partial Q_i}\geq0.\]$s$ 是训练时的全局状态,$f_s$ 表示混合方式可以随状态变化。下面是便于手算的单调非线性例子:
def monotonic_example(x, y):
    return x + y + max(0.0, x + y - 1.0)

table = [[monotonic_example(x, y) for y in (0.0, 1.0)]
         for x in (0.0, 1.0)]
print(table)  # [[0.0, 1.0], [1.0, 3.0]]
双方都从 A 的 0 分提高到 B 的 1 分时,团队值从 0 提高到 3。这张表的两条对角线之和是 3 与 2,超过了 VDN 的可加范围;每个方向的局部排序却保持一致。
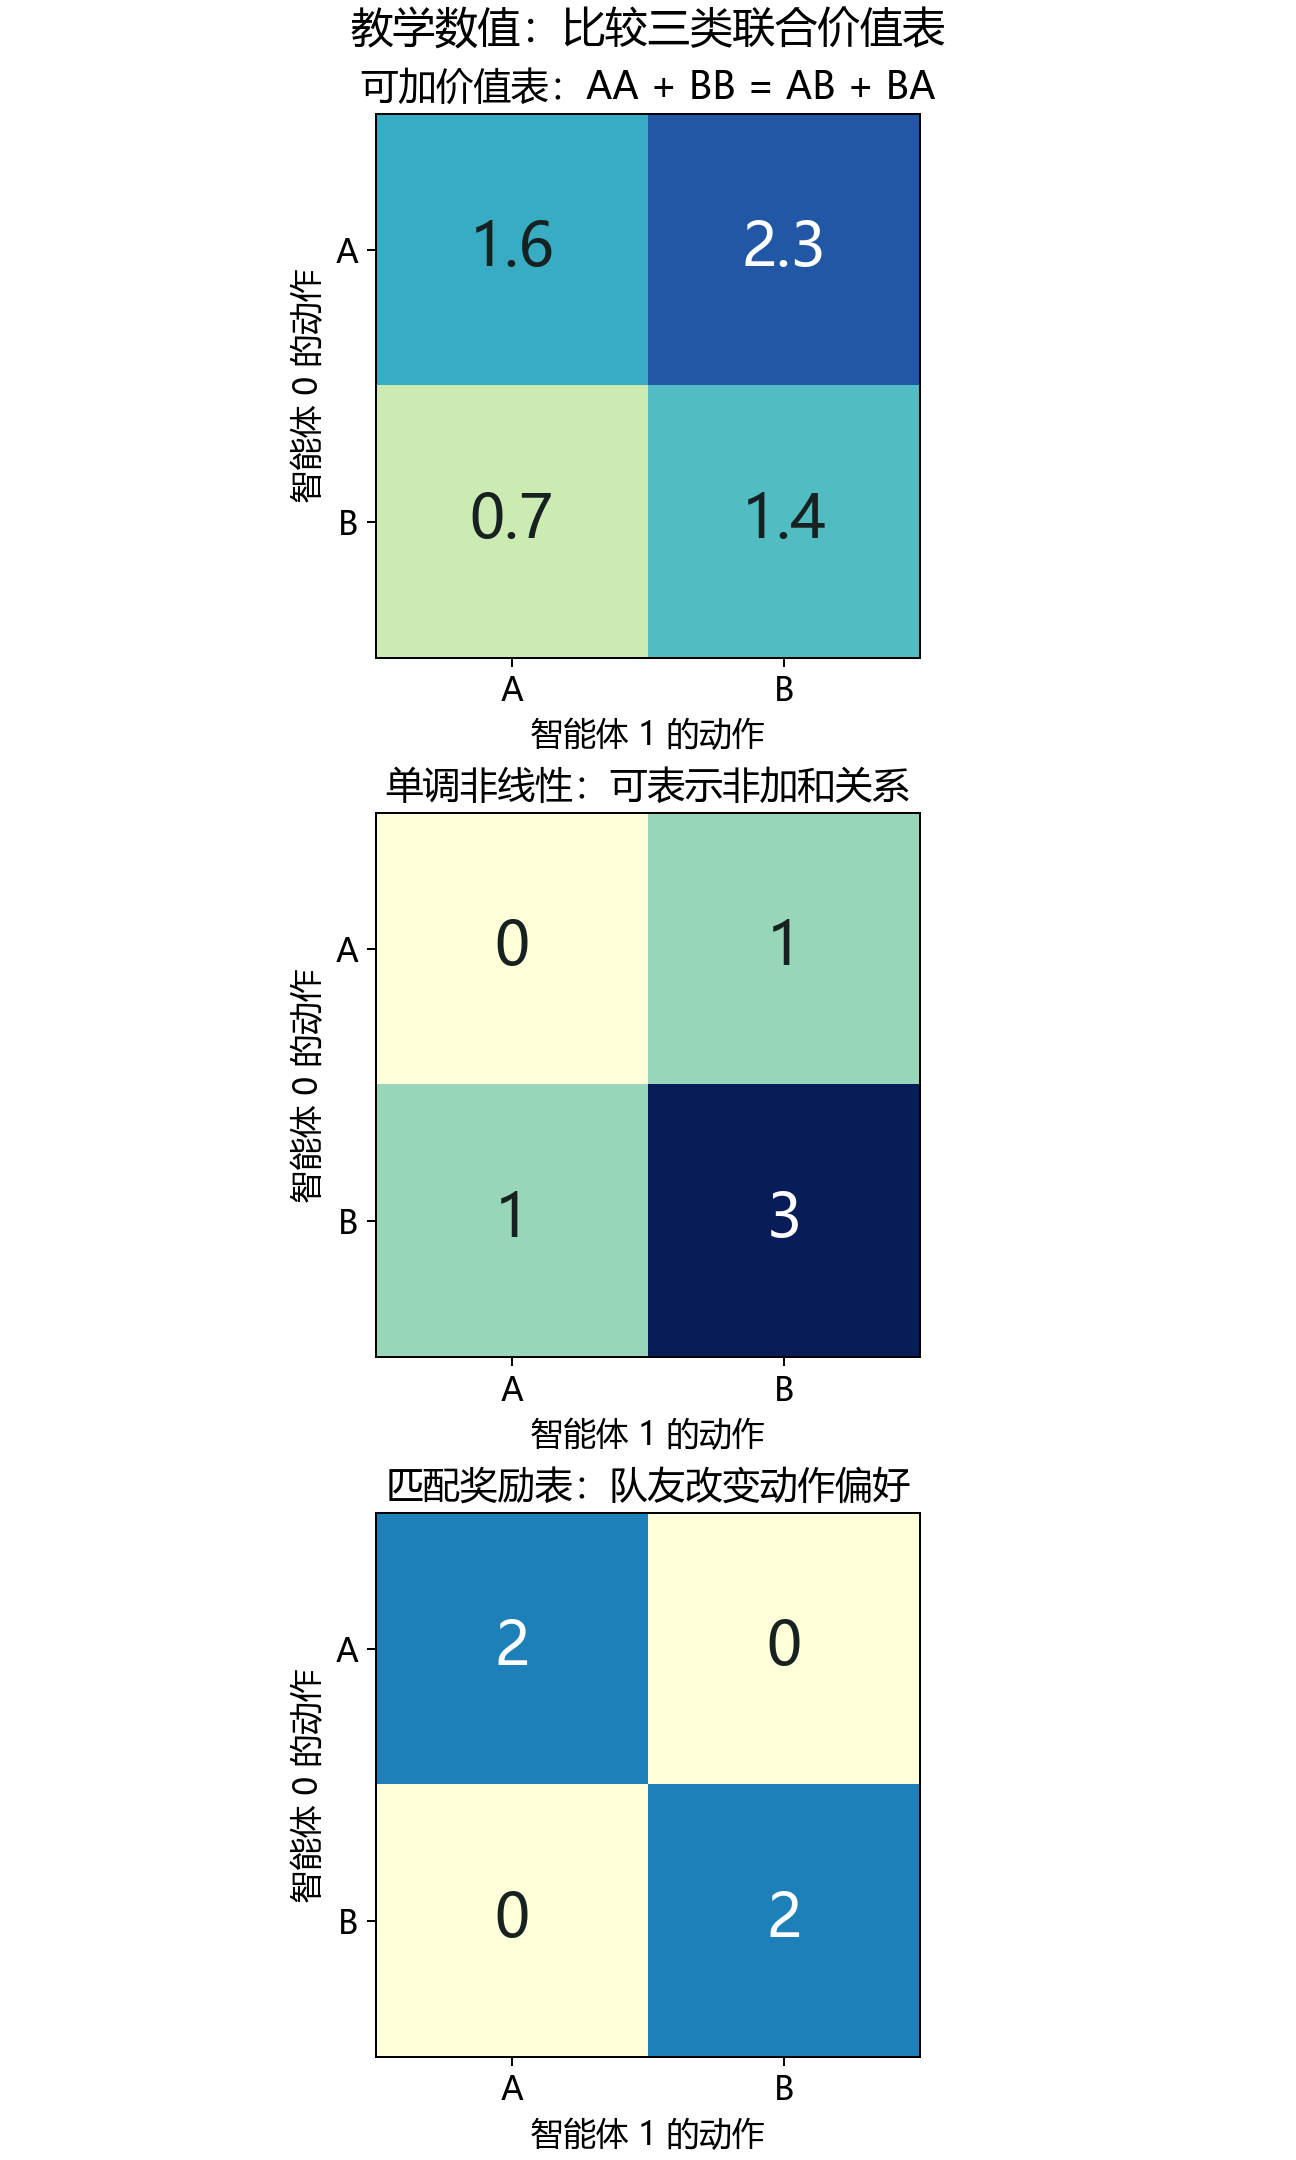
第三张匹配表中,AA 和 BB 为 2,AB 和 BA 为 0。队友选 A 时,自己偏好 A;队友选 B 时,自己偏好 B。固定自己的信息后,动作偏好发生反转,标准单调 QMIX 也无法精确拟合整张表。
模型表示范围与策略成绩要分别看。学出始终选 AA 的合作约定,可以获得好成绩;精确拟合四种联合动作的真实价值,则是另一项要求。QMIX 的结构保证是“局部贪心拼接最大化模型预测”,真实任务的最优性还取决于信息、表达能力和训练。
3. Mixer 与超网络:状态怎样参与混合
当前完整训练由两个局部 Q 网络和一个 Mixer 组成。每个局部网络输入自己的观测,输出保持、翻转两个动作的评分。
from torch import nn

obs_dim, n_actions, n_agents, state_dim = 2, 2, 2, 3

class LocalQNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(obs_dim, 16),
            nn.ReLU(),
            nn.Linear(16, n_actions),
        )

    def forward(self, own_obs):
        return self.net(own_obs)
own_obs 为 [B,2],B 是批次大小;返回 [B,2],最后一维是两个动作的 utility。两个网络分别运行,再按智能体维度放在一起:
def collect_agent_qs(networks, observations):
    return torch.stack(
        [net(observations[:, i, :])
         for i, net in enumerate(networks)],
        dim=1,
    )  # [B, n_agents, n_actions]
observations 是 [B,2,2]。observations[:, i, :] 只取智能体 $i$ 的局部输入,避免把队友私有观测直接送进执行网络。
超网络读取全局状态,输出 Mixer 所需的权重。它生成的是另一张网络在本次前向中的权重数值,自身参数仍由普通优化器学习。两层 Mixer 的实际结构如下:
from torch.nn import functional as F

class TwoLayerMonotonicMixer(nn.Module):
    def __init__(self):
        super().__init__()
        self.embed_dim = 16
        self.hyper_w1 = nn.Linear(state_dim, n_agents * self.embed_dim)
        self.hyper_b1 = nn.Linear(state_dim, self.embed_dim)
        self.hyper_w2 = nn.Linear(state_dim, self.embed_dim)
        self.state_bias = nn.Sequential(
            nn.Linear(state_dim, self.embed_dim),
            nn.ReLU(),
            nn.Linear(self.embed_dim, 1),
        )

    def forward(self, utilities, state):
        batch = utilities.shape[0]
        w1 = self.hyper_w1(state).abs().reshape(
            batch, n_agents, self.embed_dim)
        b1 = self.hyper_b1(state).reshape(batch, 1, self.embed_dim)
        hidden = F.elu(torch.bmm(utilities.unsqueeze(1), w1) + b1)
        w2 = self.hyper_w2(state).abs().reshape(
            batch, self.embed_dim, 1)
        bias = self.state_bias(state).reshape(batch, 1, 1)
        return (torch.bmm(hidden, w2) + bias).reshape(batch)
utilities 为 [B,2],state 为 [B,3]。unsqueeze(1) 将 utility 变为 [B,1,2],与 [B,2,16] 的 w1 批量相乘,得到 16 个隐藏特征;第二层再混合成每条经历一个团队值。
两层权重取绝对值,保证非负;ELU 是单调激活函数,保持局部评分提高时团队值不降低。偏置可以为负,最终团队 Q 也可以为负,单调性约束的是变化方向。
训练阶段,Mixer 可以读取全局状态。执行时,每人直接对自己的局部评分取 argmax,无需调用 Mixer 或超网络。局部动作选择依靠执行时能获得的信息。
4. 一条共同经历怎样产生一个 TD 损失
一条经验记录同一局、同一时刻的双方数据:局部观测、全局状态、实际联合动作、团队奖励、下一观测、下一状态和终止标记。
当前评分必须取实际执行过的动作,即使它来自探索,也不能偷偷替换成当前最高分动作:
current_all = collect_agent_qs(online_agents, batch["obs"])
actual_utilities = current_all.gather(
    2, batch["actions"].unsqueeze(-1),
).squeeze(-1)
prediction = online_mixer(actual_utilities, batch["state"])
current_all 是 [B,2,2]。actions 为 [B,2],加一维后变为 [B,2,1],告诉 gather 每个智能体实际选了哪个动作。结果 actual_utilities 为 [B,2],Mixer 输出 prediction 为 [B]。
如果还没真正终止,目标包含当前奖励和下一步团队价值;真正终止时目标就是当前奖励:
\[y=r+\gamma(1-d)Q_{\mathrm{tot}}^{-}(s',\mathbf a'), \qquad L=\frac1B\sum_{b=1}^B\bigl(\widehat Q_b-y_b\bigr)^2.\]$d$ 是真正终止标记,$\gamma=0.9$,上标负号表示目标副本,$\widehat Q_b$ 是在线 Mixer 对第 $b$ 条经历的预测。目标分支在 no_grad() 中计算。
单步演示采用一个单层状态条件线性 Mixer、普通 target-max 和一条手工经历。执行一次 SGD 更新,学习率 0.05,当前保存输出为:
| 数值 | 更新前 | 一次更新后 |
|---|---|---|
| 在线团队 Q | 0.3083004 | 1.1381497 |
| 固定 TD 目标 | 2.2751551 | 2.2751551 |
| 对固定目标的 MSE | 3.8685174 | 1.2927811 |
| 智能体 0 的实际动作 utility | 0.2346437 | 0.6928017 |
| 智能体 1 的实际动作 utility | -0.0079036 | 0.0478739 |
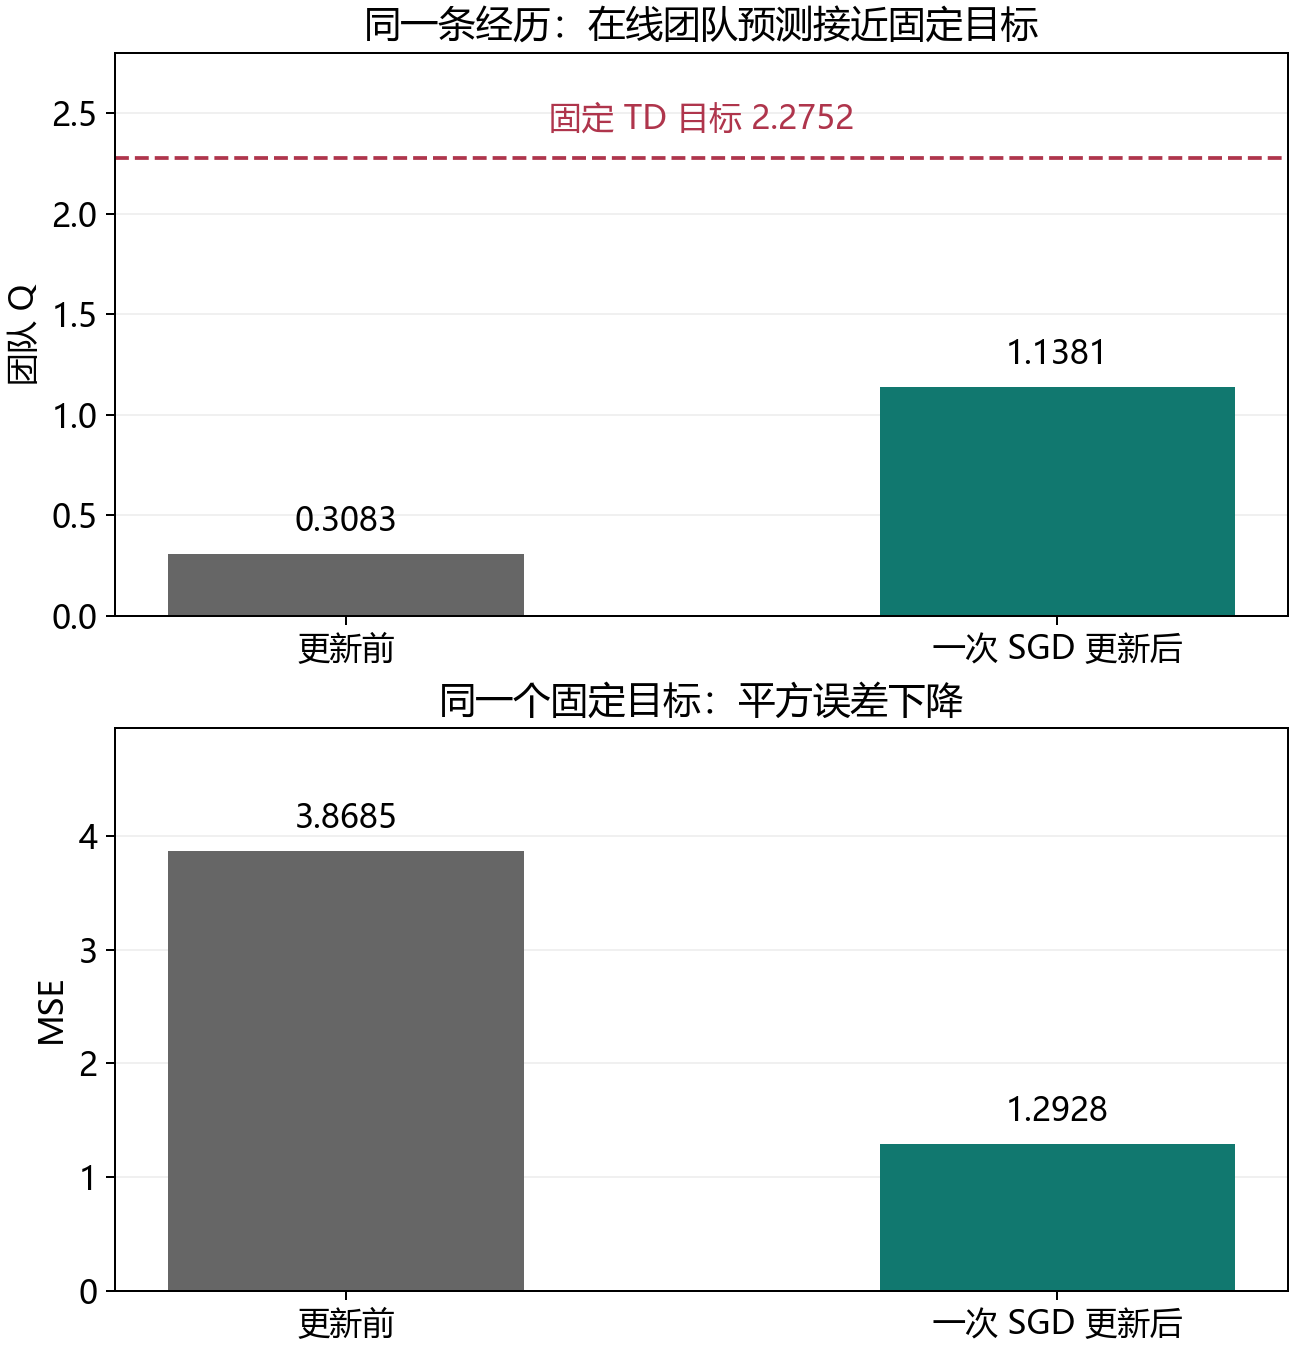
这次更新中,两名智能体的在线局部网络和在线 Mixer 都改变了,目标副本保持原样。两份 utility 改善幅度不同,因为共同误差经过 Mixer 产生的局部梯度不同。
这个实验有一次参数更新、一次后续同步、零环境步。它说明联合梯度怎样工作;合作成绩则由后面的完整轨迹检验。
5. Double Q:在线网络选动作,目标网络评价
完整训练使用 Double Q。下一状态先由在线局部网络选出动作,再由目标局部网络评价这些指定动作,最后交给目标 Mixer。[3][4]
先看一个与训练数据分开的教学算例:
| 智能体 | 在线评分 A/B | 在线选择 | 目标评分 A/B | 取出的目标评分 |
|---|---|---|---|---|
| 0 | 1.2 / 1.0 | A | 0.7 / 1.5 | 0.7 |
| 1 | 0.4 / 1.1 | B | 1.3 / 0.6 | 0.6 |
online_scores = torch.tensor([[[1.2, 1.0], [0.4, 1.1]]])
target_scores = torch.tensor([[[0.7, 1.5], [1.3, 0.6]]])
next_actions = online_scores.argmax(dim=-1, keepdim=True)
next_utilities = target_scores.gather(2, next_actions).squeeze(-1)
print(next_actions.squeeze(-1))  # [[0, 1]]
print(next_utilities)            # [[0.7, 0.6]]
目标网络对另一个动作评分更高,也不能替换在线网络已经选定的动作,否则又变回目标网络自己选择、自己评价。职责分离有助于降低同一估计同时选优与评价造成的过估计。
完整训练中的下一步分支:
with torch.no_grad():
    target = batch["reward"].clone()
    alive = ~batch["terminated"]
    if alive.any():
        next_obs = batch["next_obs"][alive]
        next_actions = collect_agent_qs(
            online_agents, next_obs,
        ).argmax(dim=-1, keepdim=True)
        next_utilities = collect_agent_qs(
            target_agents, next_obs,
        ).gather(2, next_actions).squeeze(-1)
        next_team = target_mixer(
            next_utilities, batch["next_state"][alive],
        )
        target[alive] += gamma * next_team
alive 是 [B] 的布尔筛选,只处理未终止经历。先把所有目标设成真实奖励,再对有效下一状态补上折扣预测,终止样本完全跳过未来计算。这里的 next_state 必须和 next_obs 来自同一条经历。
6. 联合回放:存交互事实,取出后重新计算目标
回放池保存当时发生了什么。网络训练以后,同一条旧经历的下一步估计可以变化;奖励、状态、实际动作和终止标记仍保留原值。
from collections import deque
from typing import NamedTuple

class Transition(NamedTuple):
    obs: tuple
    state: tuple
    actions: tuple
    reward: float
    next_obs: tuple
    next_state: tuple
    terminated: bool

replay = deque(maxlen=4000)
deque(maxlen=4000) 最多保留 4000 条共同转移,满后自动丢弃最早记录。一条记录包含双方的联合数据,取样时按整条记录抽取。
replay.append(Transition(
    obs, state, actions, reward,
    local_observations(next_state),
    next_state, terminated,
))
不能把智能体 0 在某局的动作和智能体 1 在另一局的动作拼起来,再拿一个奖励训练。Mixer 评价的是实际共同经历。
rows = replay_rng.sample(list(replay), batch_size)
actions = torch.tensor(
    [row.actions for row in rows],
    dtype=torch.long, device=device,
)
rewards = torch.tensor(
    [row.reward for row in rows],
    dtype=torch.float32, device=device,
)
其它字段沿用同一个 rows 顺序转换,所以每一行仍然对应同一条转移。当前批次为 64 条。
目标副本暂时不变,也不等于 Double Q 的重算目标必定不变:在线 argmax 可能改变,目标网络因而评价另一个动作。已经算出来的旧目标张量不会自动刷新;只有重新前向计算才会产生新目标。
7. 一次优化与一次同步,是两件操作
优化器接收在线局部网络和在线 Mixer 的参数,目标副本不参与优化:
import copy

target_agents = copy.deepcopy(online_agents)
target_mixer = copy.deepcopy(online_mixer)
for module in (target_agents, target_mixer):
    module.eval()
    module.requires_grad_(False)

online_parameters = (
    list(online_agents.parameters()) + list(online_mixer.parameters())
)
optimizer = torch.optim.Adam(online_parameters, lr=0.003)
deepcopy 建立独立副本,requires_grad_(False) 关闭目标参数梯度。完整训练的一次批量更新如下:
prediction, target = team_prediction_and_target(batch)
loss = ((prediction - target) ** 2).mean()
optimizer.zero_grad(set_to_none=True)
loss.backward()
nn.utils.clip_grad_norm_(online_parameters, max_norm=10.0)
optimizer.step()
update_count += 1
zero_grad 清除旧梯度,backward 计算当前共同误差对各在线参数的梯度,step 才修改参数。梯度范数裁剪限制一次更新的梯度大小,与 PPO 的概率比裁剪是不同操作。
当前代码每 100 次优化器更新进行一次完整硬同步:
if update_count % sync_interval == 0:
    target_agents.load_state_dict(online_agents.state_dict())
    target_mixer.load_state_dict(online_mixer.state_dict())
    target_sync_count += 1
两部分都要复制。只同步局部网络、遗漏 Mixer,会把新局部评分送给旧混合参数,团队目标评估器没有整体同步。超网络属于 Mixer,随它的 state_dict 一起复制。
单步实验同步后,新计算的目标从 2.2751551 变成 2.9790525;原先保存的目标张量仍是 2.2751551。目标数值发生变化与“历史奖励被改了”没有关系。
8. 两轮灯控任务:把更新接成完整训练
双方各控制一盏灯。灯的状态是 0/1,动作 0=保持、1=翻转。第一轮要求双方都亮,第二轮要求双方都灭;每轮共同成功奖励 1,第二轮之后真正终止。
全局状态是 [灯0, 灯1, 阶段]。每人只看 [自己的灯, 公共阶段]。这两项已经足以决定本人的正确动作,因此当前局部网络使用 MLP。
环境更新的关键代码:
desired_bit = 1 - self.phase
self.bits = tuple(
    bit ^ action for bit, action in zip(self.bits, actions)
)
reward = float(all(bit == desired_bit for bit in self.bits))
self.phase += 1
terminated = self.phase == 2
^ 是异或:与 0 异或保持原值,与 1 异或翻转。阶段 0 要求亮,阶段 1 要求灭。第一轮即使失败也会进入第二轮,成功判断需要查看两次奖励。
训练动作采用 epsilon-greedy,执行接口只接收局部网络和局部观测:
@torch.no_grad()
def choose_actions(networks, observations, epsilon=0.0, rng=None):
    obs_tensor = torch.tensor(
        [observations], dtype=torch.float32, device=device,
    )
    greedy = collect_agent_qs(
        networks, obs_tensor,
    )[0].argmax(dim=-1).tolist()
    return tuple(
        rng.randrange(n_actions)
        if epsilon > 0 and rng.random() < epsilon else action
        for action in greedy
    )
每人以 epsilon 的概率从两个合法动作中随机选一个,其余时候选择自己的最高分动作。随机分支也可能碰巧选中贪心动作。
训练主循环的关键顺序:
for episode in range(1, num_episodes + 1):
    fraction = min((episode - 1) / epsilon_decay_episodes, 1.0)
    epsilon = epsilon_start + fraction * (epsilon_end - epsilon_start)
    state = training_env.reset()
    terminated = False
    while not terminated:
        obs = local_observations(state)
        actions = choose_actions(
            online_agents, obs, epsilon, exploration_rng,
        )
        next_state, reward, terminated, _ = training_env.step(actions)
        replay.append(Transition(
            obs, state, actions, reward,
            local_observations(next_state), next_state, terminated,
        ))
        state = next_state
    if len(replay) >= batch_size:
        train_one_batch(sample_batch())
num_episodes=2000,epsilon_start=1.0,epsilon_end=0.1,epsilon_decay_episodes=1500。每局完整采两步,回放条数达到 64 后,每局结束更新一次。
因此,第 32 局开始更新,更新总数为 $2000-31=1969$;每 100 次更新同步,总计 19 次。这些计数按各自职责记录:
| 项目 | 实际数量 | 含义 |
|---|---|---|
| 共同训练回合 | 2000 | 每回合双方一起参与 |
| 训练环境步 | 4000 | 每回合固定两步 |
| 优化器更新 | 1969 | 预热后每回合一次 |
| 目标同步 | 19 | 每 100 次更新一次 |
| 最终回放条数 | 4000 | 一条是一个联合转移 |
下图的损失横轴是优化器更新次数,探索率横轴是训练回合,两个计数不能互换:
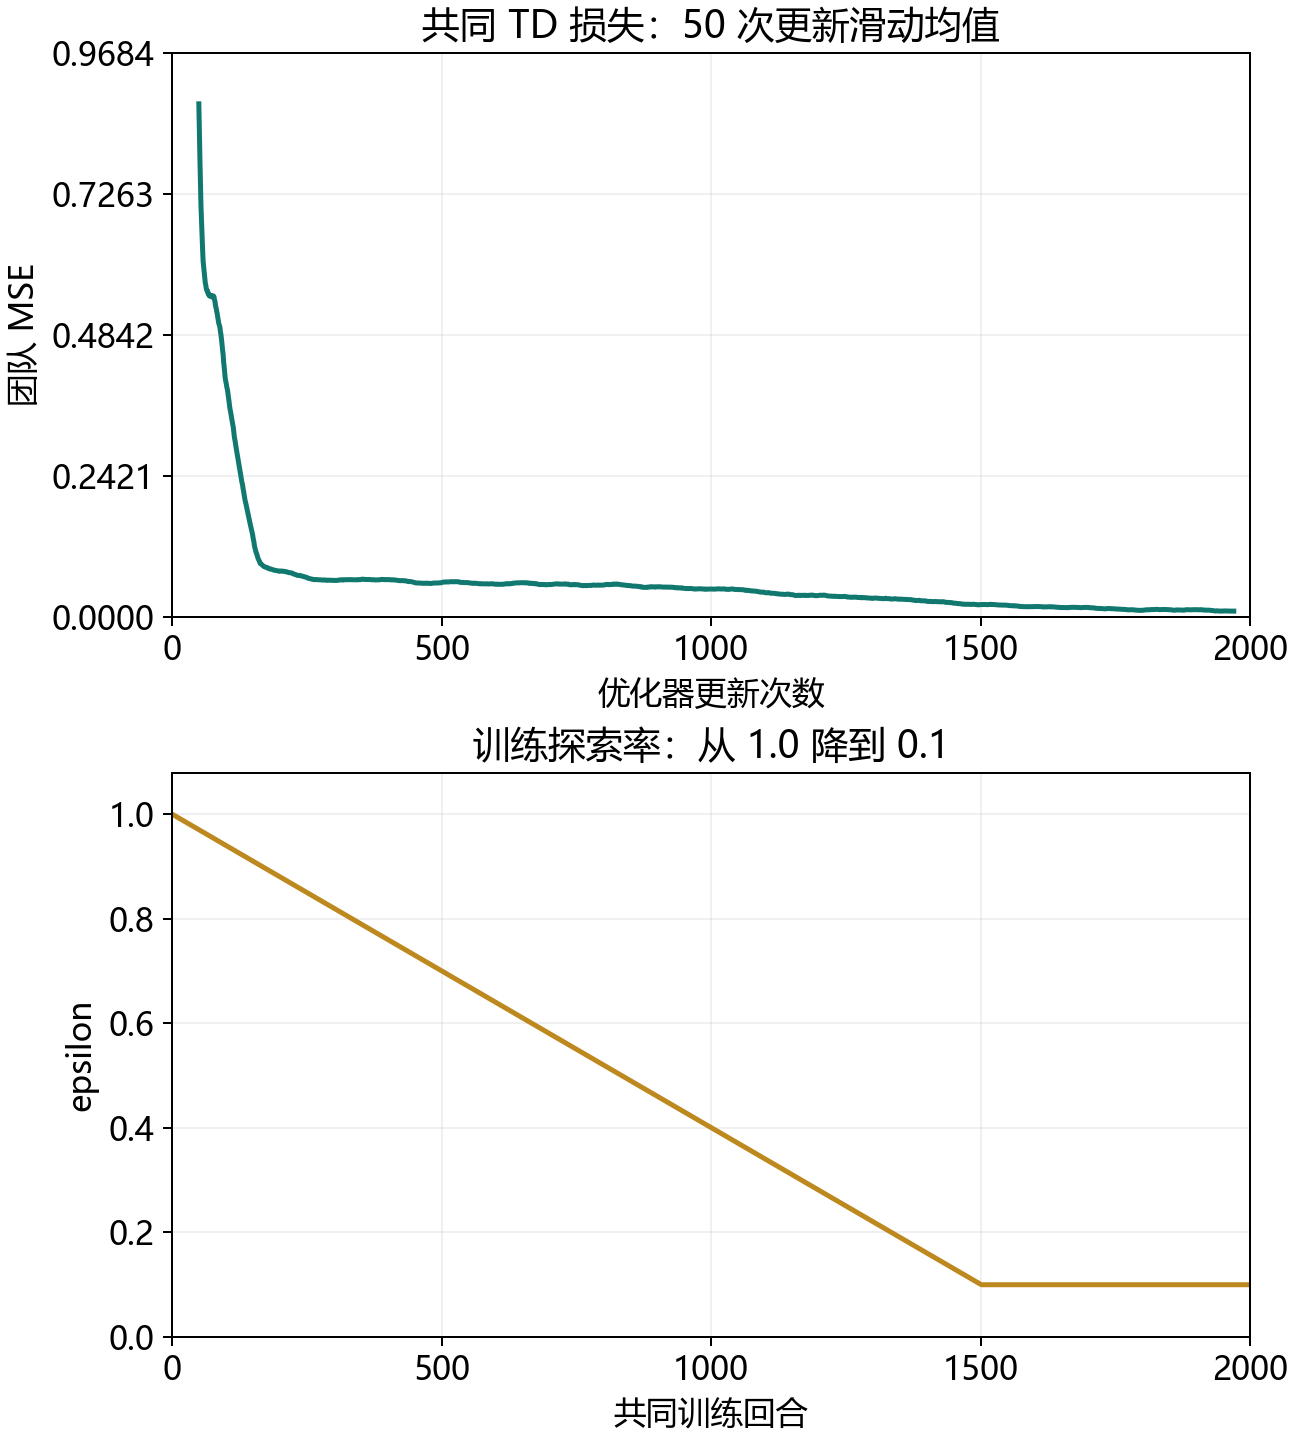
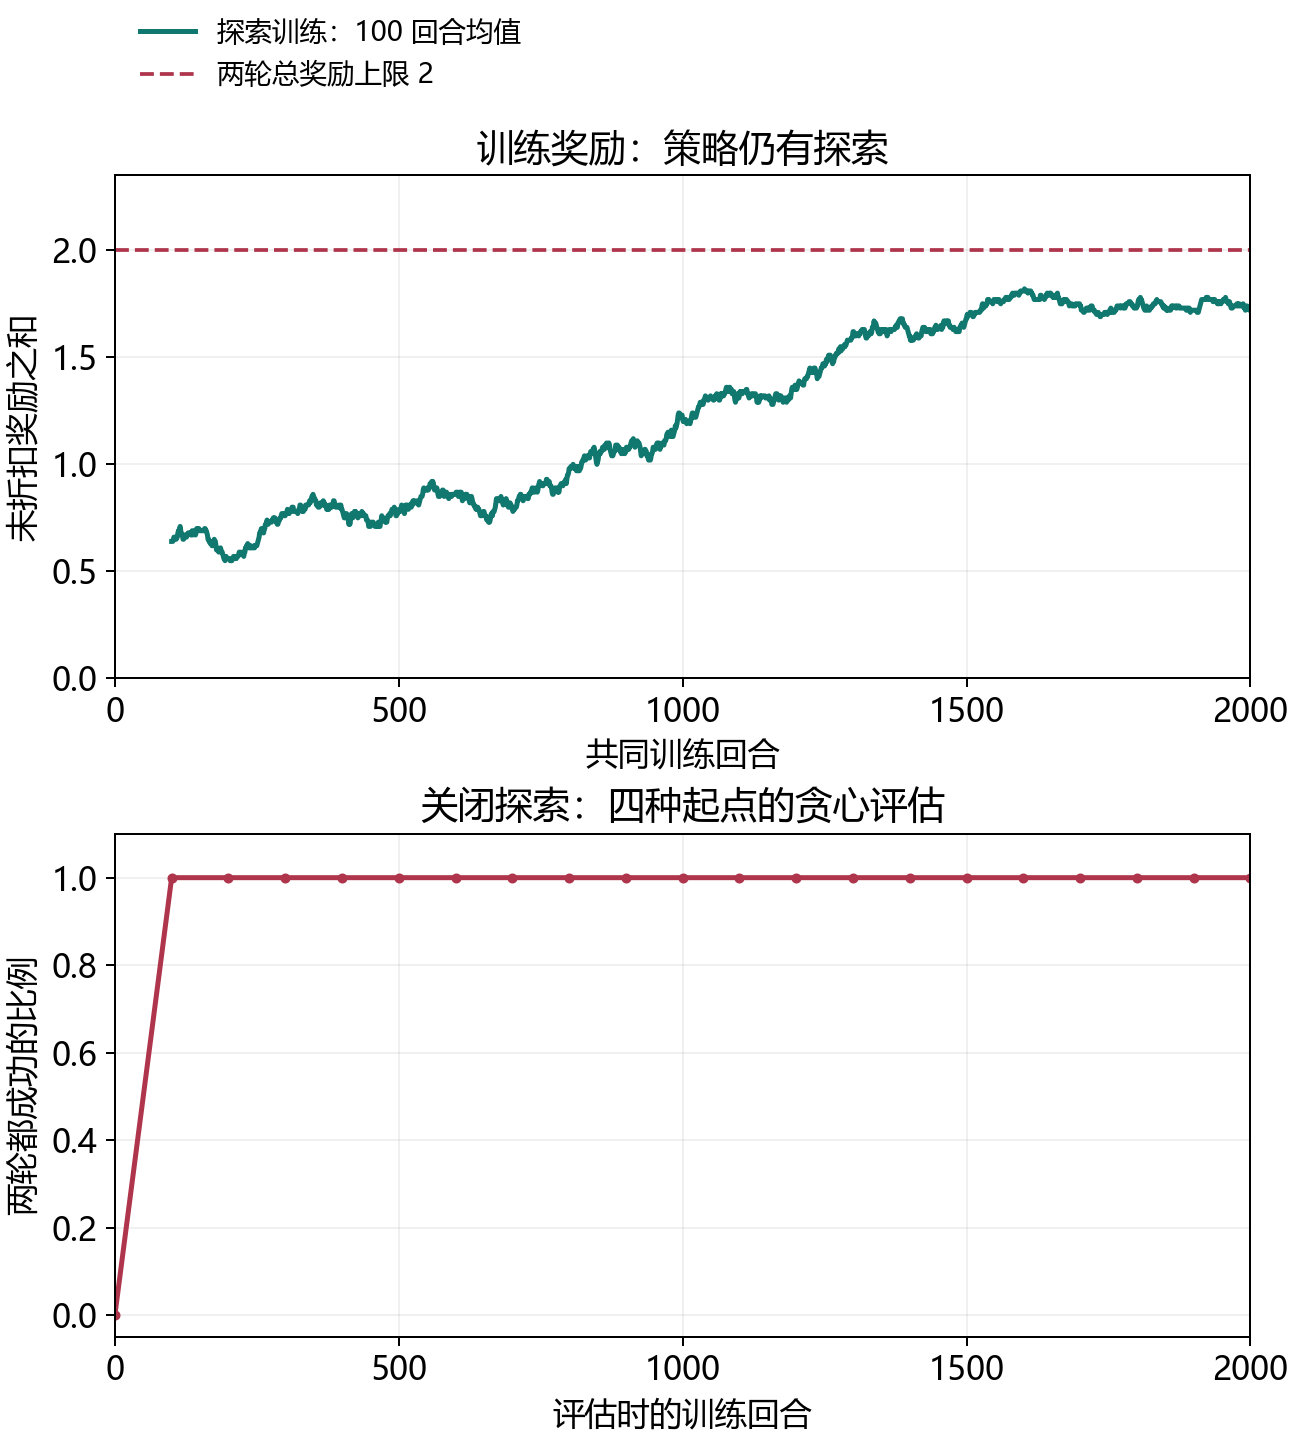
训练后期 TD 损失最近 50 次更新均值约 0.01010。它表示当前回放预测和目标较接近,策略是否完成合作还要检查冻结评估和完整轨迹。
9. 为什么训练均值 1.72,评估却是 2.0
评估冻结参数,关闭探索,让每人独立选自己的贪心动作,并一直走到第二轮真正终止。关键调用省略 epsilon,使用默认 0:
with torch.no_grad():
    actions = choose_actions(
        online_agents, local_observations(state),
    )
    next_state, reward, terminated, info = env.step(actions)
no_grad() 关闭梯度记录,eval() 切换网络运行模式,二者都不会自动把 epsilon 变成 0。探索关闭来自这次函数调用的参数。
实际冻结结果:
| 指标 | 训练前 | 训练后 |
|---|---|---|
| 四种起点两轮都成功的比例 | 0% | 100% |
| 四起点平均未折扣总奖励 | 0.5 | 2.0 |
| 四起点平均折扣回报 | 0.475 | 1.9 |
另外随机抽取 500 个初始状态评估,500/500 两轮成功,共 1000 个评估环境步。随机性来自起点抽样;固定起点和参数后的动作采用贪心规则。
两轮都成功时,未折扣奖励为 $1+1=2$,折扣回报为 $1+0.9\times1=1.9$。这是不同统计口径,表格必须区分。
四种起点的完整动作与轨迹:
| 初始两盏灯 | 第一轮动作 | 第一轮结果与奖励 | 第二轮动作 | 最终结果与奖励 |
|---|---|---|---|---|
| (0,0) | (翻转,翻转) | (1,1),1 | (翻转,翻转) | (0,0),1,终止 |
| (0,1) | (翻转,保持) | (1,1),1 | (翻转,翻转) | (0,0),1,终止 |
| (1,0) | (保持,翻转) | (1,1),1 | (翻转,翻转) | (0,0),1,终止 |
| (1,1) | (保持,保持) | (1,1),1 | (翻转,翻转) | (0,0),1,终止 |
评估检查确认所有网络参数不变,Mixer 调用次数为 0,目标局部网络调用次数也为 0。执行确实只依赖各自在线局部网络。
训练最后 100 局平均奖励是 1.72,当时仍使用 epsilon≈0.1,而且参数持续更新。假设某次贪心动作正确,单个智能体仍选对的条件概率为:
\[0.9+0.1\times0.5=0.95.\]在双方探索随机选择独立的条件下,该轮双方都选对的概率是 $0.95^2=0.9025$。这个条件算例解释探索为什么可能拉低训练成绩,具体窗口的 1.72 还受到实际采样和参数更新影响。
比较两个策略时,应冻结各自参数,统一探索率、起点分布、奖励与终止定义。当前定期评估每 100 局一次,第一个检查点已成功,曲线不能定位它恰好在哪一局学会。
当前保存结果的环境也分别记录:单步演示用 CUDA;完整灯控训练显式使用 CPU,PyTorch 为 2.10.0+cu128。版本名中的 CUDA 后缀说明安装包支持 CUDA,实际运算设备由张量和模型所在位置决定。
10. 历史、序列和掩码:任务变复杂后要保留什么
当前灯控观测足够决定动作,所以逐条转移回放适用。如果双方在开头看过提示,后来提示消失,只剩相同画面,正确动作就可能取决于历史。
MLP 对相同当前输入给出相同输出。循环局部网络把观测和自己的历史摘要结合,再输出动作评分。[5]
class RecurrentLocalQ(nn.Module):
    def __init__(self, obs_dim, hidden_dim, n_actions):
        super().__init__()
        self.gru = nn.GRUCell(obs_dim, hidden_dim)
        self.q_head = nn.Linear(hidden_dim, n_actions)

    def forward(self, observation, hidden):
        next_hidden = self.gru(observation, hidden)
        return self.q_head(next_hidden), next_hidden
这是循环网络的结构示例。两个智能体即使共享网络参数,也要分别维护自己的 hidden;每局开头重置,避免把上一局信息带进下一局。
回放可以随机抽完整回合,但回合内部必须按时间顺序运行。连续片段也可以使用,起始 hidden 需要由正确历史重建,或配合适当历史前缀;只抽提示消失后的最后一步并清零 hidden,会丢掉用于区分历史的信息。
在线网络和目标网络参数不同,必须各自按序列重建 hidden。同一时刻两个智能体的评分再送到对应状态的 Mixer。循环网络处理局部历史,集中混合仍遵守相同的信息边界。
长度不同的回合放成批次时,短回合常被补零。例如:
| 位置 | 是否真实经历 | 是否真正终止 | valid |
|---|---|---|---|
| 第一步 | 是 | 否 | 1 |
| 第二步 | 是 | 是 | 1 |
| 第三步 | 补齐 | 不适用 | 0 |
| 第四步 | 补齐 | 不适用 | 0 |
终止步仍有真实奖励,必须参与损失;去掉的是终止后的未来价值。补齐位置完全不参与训练,损失按有效转移数平均:[4]
td_error = prediction - target       # [B,T],每条序列每一步
valid = valid_mask.to(td_error.dtype)
loss = (td_error.square() * valid).sum() / valid.sum()
这里假定批次至少有一条有效转移。若按全部 [B,T] 元素平均,补齐多的批次会人为缩小损失。
还有一种不同用途的掩码:当前状态禁止某些动作时,在选动作之前屏蔽它们。
masked_scores = q_scores.masked_fill(~available_actions, -torch.inf)
actions = masked_scores.argmax(dim=-1)
available_actions 与动作评分同形状,合法动作为 True,并假定每个有效决策至少有一个合法动作。当前动作选择和 Double Q 的下一动作选择都需要遵守可行动作集合;时间 valid mask 则决定哪些经历计入损失。
循环网络、变长序列补齐和不可用动作是扩展机制;本次两轮 MLP 灯控训练固定两步、所有动作合法。单调混合能增加价值表达能力,记忆和掩码则分别处理历史信息与训练数据的有效性,三者各有职责。
参考与继续阅读
- Sunehag et al. Value-Decomposition Networks For Cooperative Multi-Agent Learning. 2017,arXiv:1706.05296。VDN 原论文。
- Rashid et al. QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning. ICML 2018,PMLR 80:4295–4304。论文与 PDF。
- van Hasselt et al. Deep Reinforcement Learning with Double Q-learning. AAAI 2016,arXiv:1509.06461。Double DQN 原论文。
- 作者实现 PyMARL:混合网络、团队 TD 与序列掩码。本文的小任务使用自己的网络规模与更新计数约定。
- Hausknecht & Stone. Deep Recurrent Q-Learning for Partially Observable MDPs. 2015,arXiv:1507.06527。循环 Q 网络。