· 强化学习 / 多智能体 / 通信 / 实验评估 / 可复现性
Day12 · 让实验结果只支持它真正证明的结论
前面已经把局部观测、循环记忆、离散消息、团队奖励和冻结评估接进了训练。Day12 用同一个通信任务回答一个接下来的问题:
一个实验跑出了很高的成功率,究竟能说明什么?
单次评估描述当前策略的表现;固定参数干预检查当前策略依赖的信息;重新训练消融、多随机种子和交叉配对则分别检查替代解法、训练波动和队友兼容性。读懂这些区别,才能把高成功率写成有依据的结论。[1][2][3]
1. 先看信息条件,再看成功率
本轮沿用四步延迟通信任务。每局独立、均匀地抽取两个二值线索,四种组合各占四分之一:
- 发送者只看到私有线索 $a$;
- 接收者只看到私有线索 $b$;
- 发送者先输出一个二值消息 $m$;
- 接收者稍后结合自己的记忆和收到的消息选择门;
- 目标门为 $a\oplus b$,选对得到团队奖励1,选错得到0。
四种情况如下:
| $a$ | $b$ | 正确门 $a\oplus b$ |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
如果删掉消息,接收者只能根据自己的 $b$ 决定动作。固定 $b=0$ 时,$a=0$ 要求选0,$a=1$ 要求选1;但接收者看到的仍然是同一个输入。固定 $b=1$ 时也一样。
因此,在四种 $(a,b)$ 组合等概率的条件下,任意只依赖 $b$ 的确定性规则都只能答对两种组合:
\[P(\text{success})=\frac{2}{4}=0.5.\]把多个确定性规则随机混合,也只是这些规则成功率的加权平均,仍然等于0.5。这里还假设随机性与本局的 $a$ 独立,历史中也没有其他关于 $a$ 的信息。这个50%来自信息条件,与网络大小、训练时长无关。
下面可以直接枚举所有只依赖 $b$ 的确定性规则。rule[0] 表示见到 b=0 选哪扇门,rule[1] 表示见到 b=1 选哪扇门:
from itertools import product

cases = list(product((0, 1), repeat=2))
for rule in product((0, 1), repeat=2):
    success = sum(rule[b] == (a ^ b) for a, b in cases) / len(cases)
    print(rule, success)  # 四种规则的结果都是 0.5。
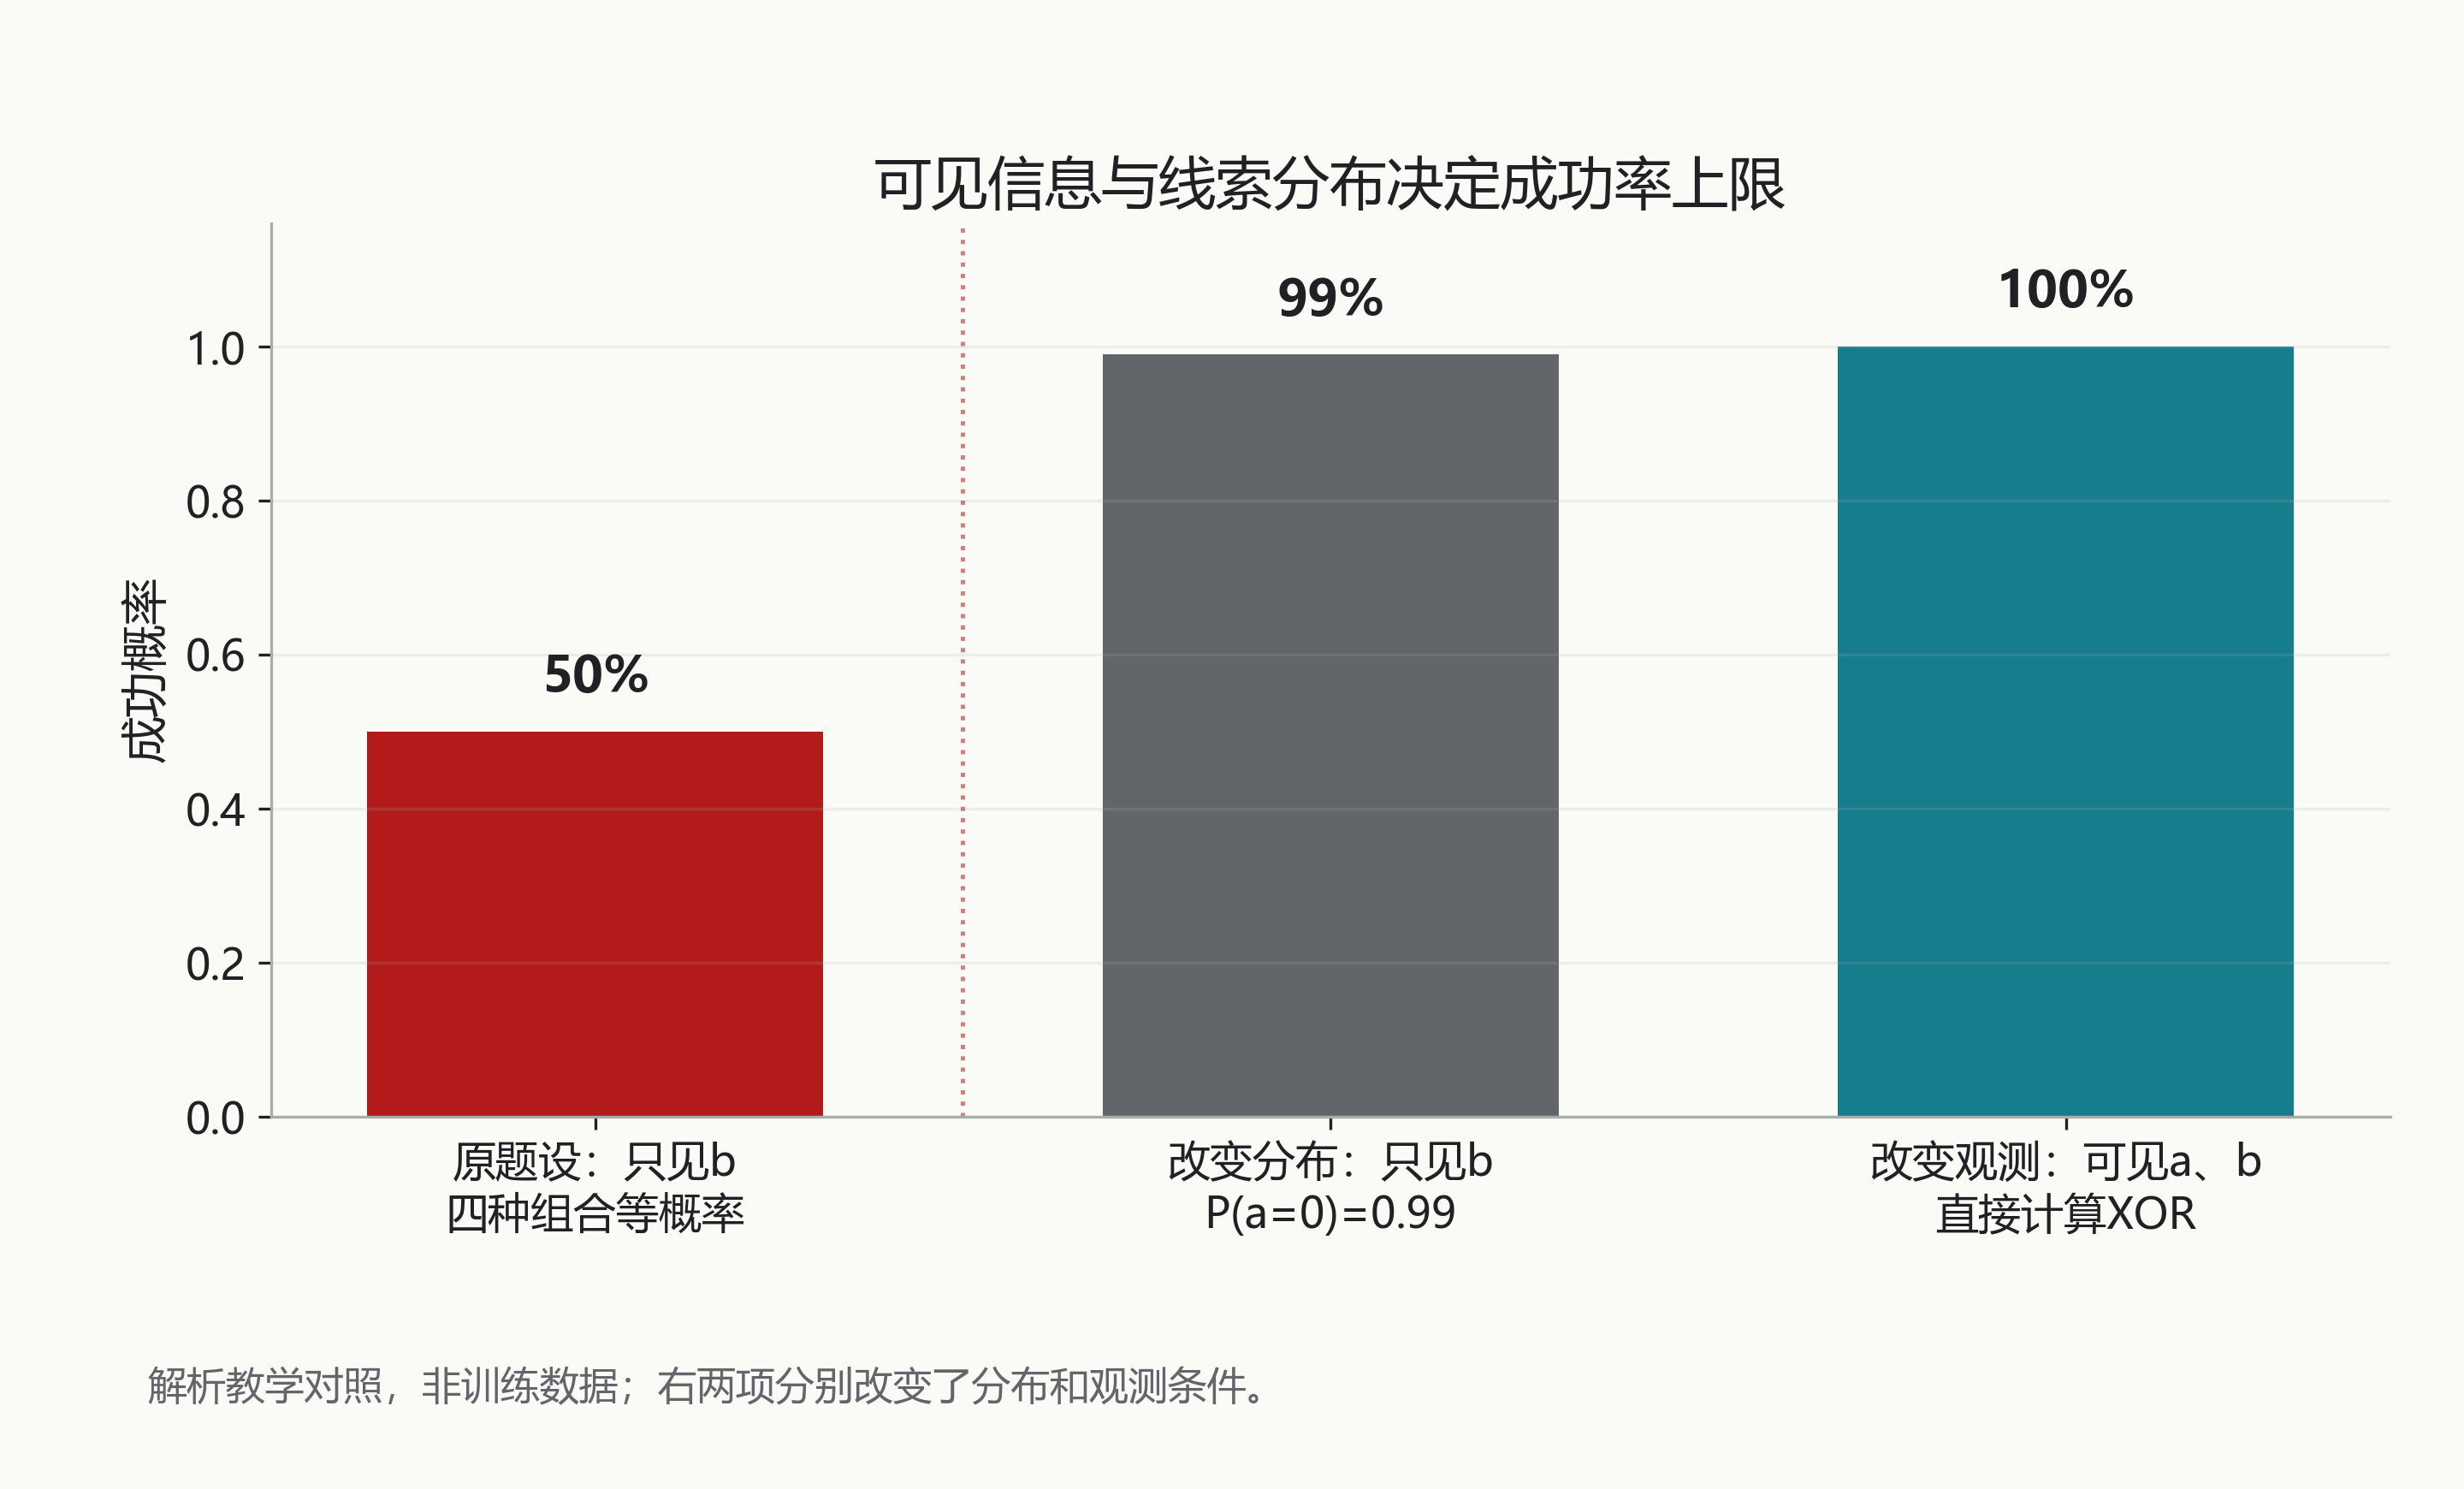
图中是解析教学对照:原题设无消息时为50%;改成 P(a=0)=0.99 后,始终用 door=b 就能取得99%;直接给接收者 $a,b$ 后,计算 XOR 就能全对。后两项分别改变了分布和可见信息,不能和原题设当作同一实验比较。
如果无消息版本在完全相同的四种等概率线索下仍然达到99%,优先排查观测张量、共享状态、历史动作、奖励字段、环境缓存和评估统计。不能直接把异常结果写成“模型突破了信息限制”。
2. 消息在环境中如何流动
消息的生效时刻决定了谁需要记住什么:
| 时刻 | 发送者能看到什么、做什么 | 接收者能看到什么、做什么 |
|---|---|---|
t=0 |
看自己的 $a$,等待 | 看自己的 $b$,等待 |
t=1 |
原线索消失,根据记忆发送消息 | 等待 |
t=2 |
等待 | 看见送达消息,等待 |
t=3 |
等待 | 消息消失,根据记忆选门,随后真正终止 |
等待阶段把“看见信息”和“使用信息”隔开,让记忆是否有效可以被单独检查。四步是这个练习的任务设计。
局部观测为 [B,2,5]:B 是并行共同回合数,第二个轴表示发送者/接收者,最后五项依次是“自己的线索是否可见、线索编码、消息是否可见、消息编码、阶段”。二值信息用 -1/+1 编码;不可见时对应字段为0。环境的观测函数是:
def observe(self):
    assert not self.finished
    obs = torch.zeros(self.batch_size, 2, 5)
    if self.phase == 0:
        obs[:, :, 0] = 1
        obs[:, :, 1] = 2 * self.cues.float() - 1
    if self.phase == 2:
        obs[:, 1, 2] = 1
        obs[:, 1, 3] = 2 * self.received.float() - 1
    obs[:, :, 4] = self.phase / (horizon - 1)
    return obs
self.cues 为 [B,2],两列是环境保管的真实 $a,b$;每人只能读分给自己的那一行观测。self.received 是送达接收者的消息,horizon=4。
环境只在发送阶段保存消息,在接收阶段把消息放进第二个智能体的局部观测;最后选门时,奖励仍然由真实的 $a\oplus b$ 计算:
def step(self, actions):
    assert not self.finished and actions.shape == self.cues.shape
    expected = torch.full_like(actions, WAIT)

    if self.phase == 1:
        expected[:, 0] = actions[:, 0]
        self.sent = actions[:, 0].clone()
        self.received = (
            torch.zeros_like(self.sent)
            if self.erase_message
            else self.sent.clone()
        )

    if self.phase == 3:
        expected[:, 1] = actions[:, 1]

    assert torch.equal(actions, expected)

    reward = torch.zeros(self.batch_size)
    if self.phase == 3:
        target = self.cues[:, 0] ^ self.cues[:, 1]
        reward = (actions[:, 1] == target).float()

    self.phase += 1
    self.finished = self.phase == horizon
    return reward, torch.full(
        (self.batch_size,), self.finished, dtype=torch.bool
    )
这里 actions 为 [B,2],WAIT=2 是被强制执行的等待动作。消息和门的合法选项都为0/1,但只有 t=1 的发送者与 t=3 的接收者可以自由选择。erase_message=True 把实际送达值固定成0,通道中仍显示“消息0”,奖励目标始终不变。
3. 当前训练练习到底学到了什么
当前练习用两个参数独立的 GRU Actor,发送者学习消息分布,接收者学习选门分布。每人有自己的本局记忆 hidden,形状为 [1,B,H],其中 H=24。这份练习使用 REINFORCE 与固定参照0.5。
更新时沿保存的原历史重新计算两次实际选择的概率:
def compute_losses(model, batch):
    distributions = []
    for i, decision_time in ((0, 1), (1, 3)):
        actor = model.actors[i]
        own_history = batch["obs"][:, :, i]  # [B,4,5]。
        logits, _ = actor(
            own_history, actor.initial_hidden(len(own_history))
        )
        distributions.append(Categorical(logits=logits[:, decision_time]))

    score = (batch["rewards"][:, -1] - 0.5).detach()  # [B]。
    sender_logp = distributions[0].log_prob(batch["actions"][:, 1, 0])
    receiver_logp = distributions[1].log_prob(batch["actions"][:, 3, 1])
    sender_loss = -(sender_logp * score).mean()
    receiver_loss = -(receiver_logp * score).mean()
    entropy = sum(dist.entropy().mean() for dist in distributions)
    return sender_loss + receiver_loss - 0.01 * entropy
Categorical 来自 torch.distributions。batch["obs"] 为 [B,4,2,5],actions 为 [B,4,2],rewards 为 [B,4];同一行必须对应同一共同回合。两份策略损失分别训练发消息和选门,评分都是本局最终奖励减0.5。整局的折扣因子为1,前三步奖励为0,因此两次自由决策的完整回报都等于最后的奖励。
消息通过普通整数进入环境。接收者的损失没有沿这个整数直接反传到发送者;发送者靠自己的 log_prob × score 获得任务梯度。0.01乘以熵项用于保留探索。这些都是现有训练逻辑,不含 Critic 或 COMA 的个体 Q 优势。
已经保存的运行使用训练种子7,计数如下:
| 项目 | 数值 |
|---|---|
| 训练批次 | 800 |
| 每批新共同回合 | 256 |
| 训练共同回合 | 204800 |
| 每局环境转移 | 4 |
| 环境转移总数 | 819200 |
| 参数更新 | 800 次 |
| 训练方式 | 两个独立 GRU Actor + REINFORCE |
| 当前保存运行环境 | CPU / PyTorch 2.10.0+cu128 |
这是现有 Notebook 保存的完整运行摘要,本篇没有重新训练。训练前的精确成功概率约为 0.4999995828,训练后提高到:
这次保存输出学到的是一套反向编码:
\[m=1-a.\]接收者随后主要执行“消息与自己的 $b$ 相等时选右,否则选左”。把两步合起来,正好得到原任务所需的 $a\oplus b$。
发送者的消息概率约为:
| 发送者看到的 $a$ | $P(m=1\mid a)$ |
|---|---|
| 0 | 0.999999 |
| 1 | 0.00000151 |
接收者在不同 $b$ 和消息下选择右门的概率为:
| 自己的 $b$ | 收到消息0 | 收到消息1 |
|---|---|---|
| 0 | 0.999993 | 0.000015 |
| 1 | 0.000006 | 0.999987 |
例如 $(a,b)=(1,0)$ 时,发送者主要发0,接收者结合自己的 b=0 选右门1,正好等于 1 XOR 0。两张表共同说明这组参数形成了有效的编码和解码约定。其他训练种子是否成功、形成哪套约定,需要另做独立训练。
4. 正确率是怎样精确算出来的
评估不能只跑一条贪心轨迹,也不能只看某一批随机采样。精确评估枚举四种线索,并为每种线索枚举两条可能的消息分支,再把发送者产生该消息的概率和接收者选对门的概率相乘:
@torch.no_grad()
def exact_stats(model, intervention="normal"):
    branch_cues = cue_cases.repeat_interleave(2, dim=0)
    messages = torch.tensor([0, 1] * 4)

    branches = run_batch(
        model,
        branch_cues,
        intervention=intervention,
        forced_messages=messages,
    )

    sender_probability = branches["message_probs"].gather(
        1, messages[:, None]
    ).squeeze(1)
    correct_moves = branch_cues[:, 0] ^ branch_cues[:, 1]
    receiver_probability = branches["move_probs"].gather(
        1, correct_moves[:, None]
    ).squeeze(1)

    per_case = (sender_probability * receiver_probability).reshape(4, 2).sum(-1)
    return per_case.mean().item()
cue_cases 是第1节四种线索组成的 [4,2] 整数张量。每种线索重复两次,形成 [8,2] 的 branch_cues,分别强制走消息0、消息1两条分支。run_batch 仍然执行完整四步,返回发送端的 message_probs 和接收端的 move_probs,两者均为 [8,2];gather 取出该分支实际消息的概率和正确门的概率。
forced_messages 只用于评估时枚举分支。最后还要乘上发送者本来选择该消息的概率,不能把强制分支当作自然发生概率。评估的目标是:
所以“精确成功率接近1”和“1000局随机采样全部成功”是两个不同的结果:
- 精确成功率计算固定策略在四种线索分布下的期望表现,数值精度受浮点运算影响;
- 1000局采样只是有限样本检验;
- 即使真实成功概率略小于1,1000局也可能恰好全部成功。
按保存值 p=0.9999883175,1000次独立测试全部成功的概率约为 p**1000=0.9883854,约98.84%。因此,保存输出的 1000/1000 与精确概率略低于1完全一致。
冻结评估还要同时管好模块模式、计算图和参数更新:[4]
model.eval()
before = {
    name: value.detach().clone()
    for name, value in model.state_dict().items()
}
with torch.no_grad():
    normal = exact_stats(model)
    erased = exact_stats(model, "erase_message")
assert all(
    torch.equal(before[name], value)
    for name, value in model.state_dict().items()
)
eval() 设置 Dropout、BatchNorm 等模块的评估行为;no_grad() 停止记录计算图。当前 Actor 没有 Dropout/BatchNorm,但仍使用统一评估入口。评估过程不调用 optimizer.step(),并逐项核对状态未变。动作使用贪心还是概率采样要另行指定,eval() 本身不会把随机策略变成贪心策略。
5. 冻结参数干预回答的是“当前策略依赖什么”
hidden 应在每局开始清零,在同一局里按时间传递。下面摘出完整的逐步循环,展示干预插在什么位置:
hidden = [actor.initial_hidden(len(cues)) for actor in model.actors]
for t in range(horizon):
    obs = env.observe()
    if intervention == "reset_sender" and t == 1:
        hidden[0] = model.actors[0].initial_hidden(len(cues))
    if intervention == "reset_receiver_before_message" and t == 2:
        hidden[1] = model.actors[1].initial_hidden(len(cues))
    if intervention == "reset_receiver_at_choice" and t == 3:
        hidden[1] = model.actors[1].initial_hidden(len(cues))

    actions = torch.full_like(cues, WAIT)
    for i, actor in enumerate(model.actors):
        logits, hidden[i] = actor(obs[:, i:i + 1], hidden[i])
        if (i, t) not in ((0, 1), (1, 3)):
            continue
        probs = logits[:, 0].softmax(-1)
        choice = probs.argmax(-1)  # 此片段展示贪心执行。
        if i == 0 and forced_messages is not None:
            choice = forced_messages
        actions[:, i] = choice
    reward, terminated = env.step(actions)
这段循环放在 no_grad() 的评估函数内。cues 为 [B,2],env 是用这些线索初始化的环境,model.actors 包含发送者和接收者;普通贪心执行时 forced_messages=None,精确评估时用它枚举消息分支。每次 Actor 调用读入 [B,1,5],输出 [B,1,2] 的 logits 和下一时刻 hidden。等待时也更新记忆,只有自由决策时才采用输出动作。
同一组保存参数的精确评估结果为:
| 评估条件 | 精确成功概率 | 解释 |
|---|---|---|
| 正常消息和正常记忆 | 0.999988 | 当前策略可以完成任务 |
| 实际送达消息固定为0 | 0.500000 | 当前策略失去区分 $a$ 的信息 |
| 发消息前清空发送者记忆 | 0.500000 | 发送者失去已经看到的 $a$ |
| 收消息前清空接收者记忆 | 0.500000 | 接收者失去自己的 $b$ |
| 选门前清空接收者记忆 | 0.500000 | 接收者失去决策所需的历史 |
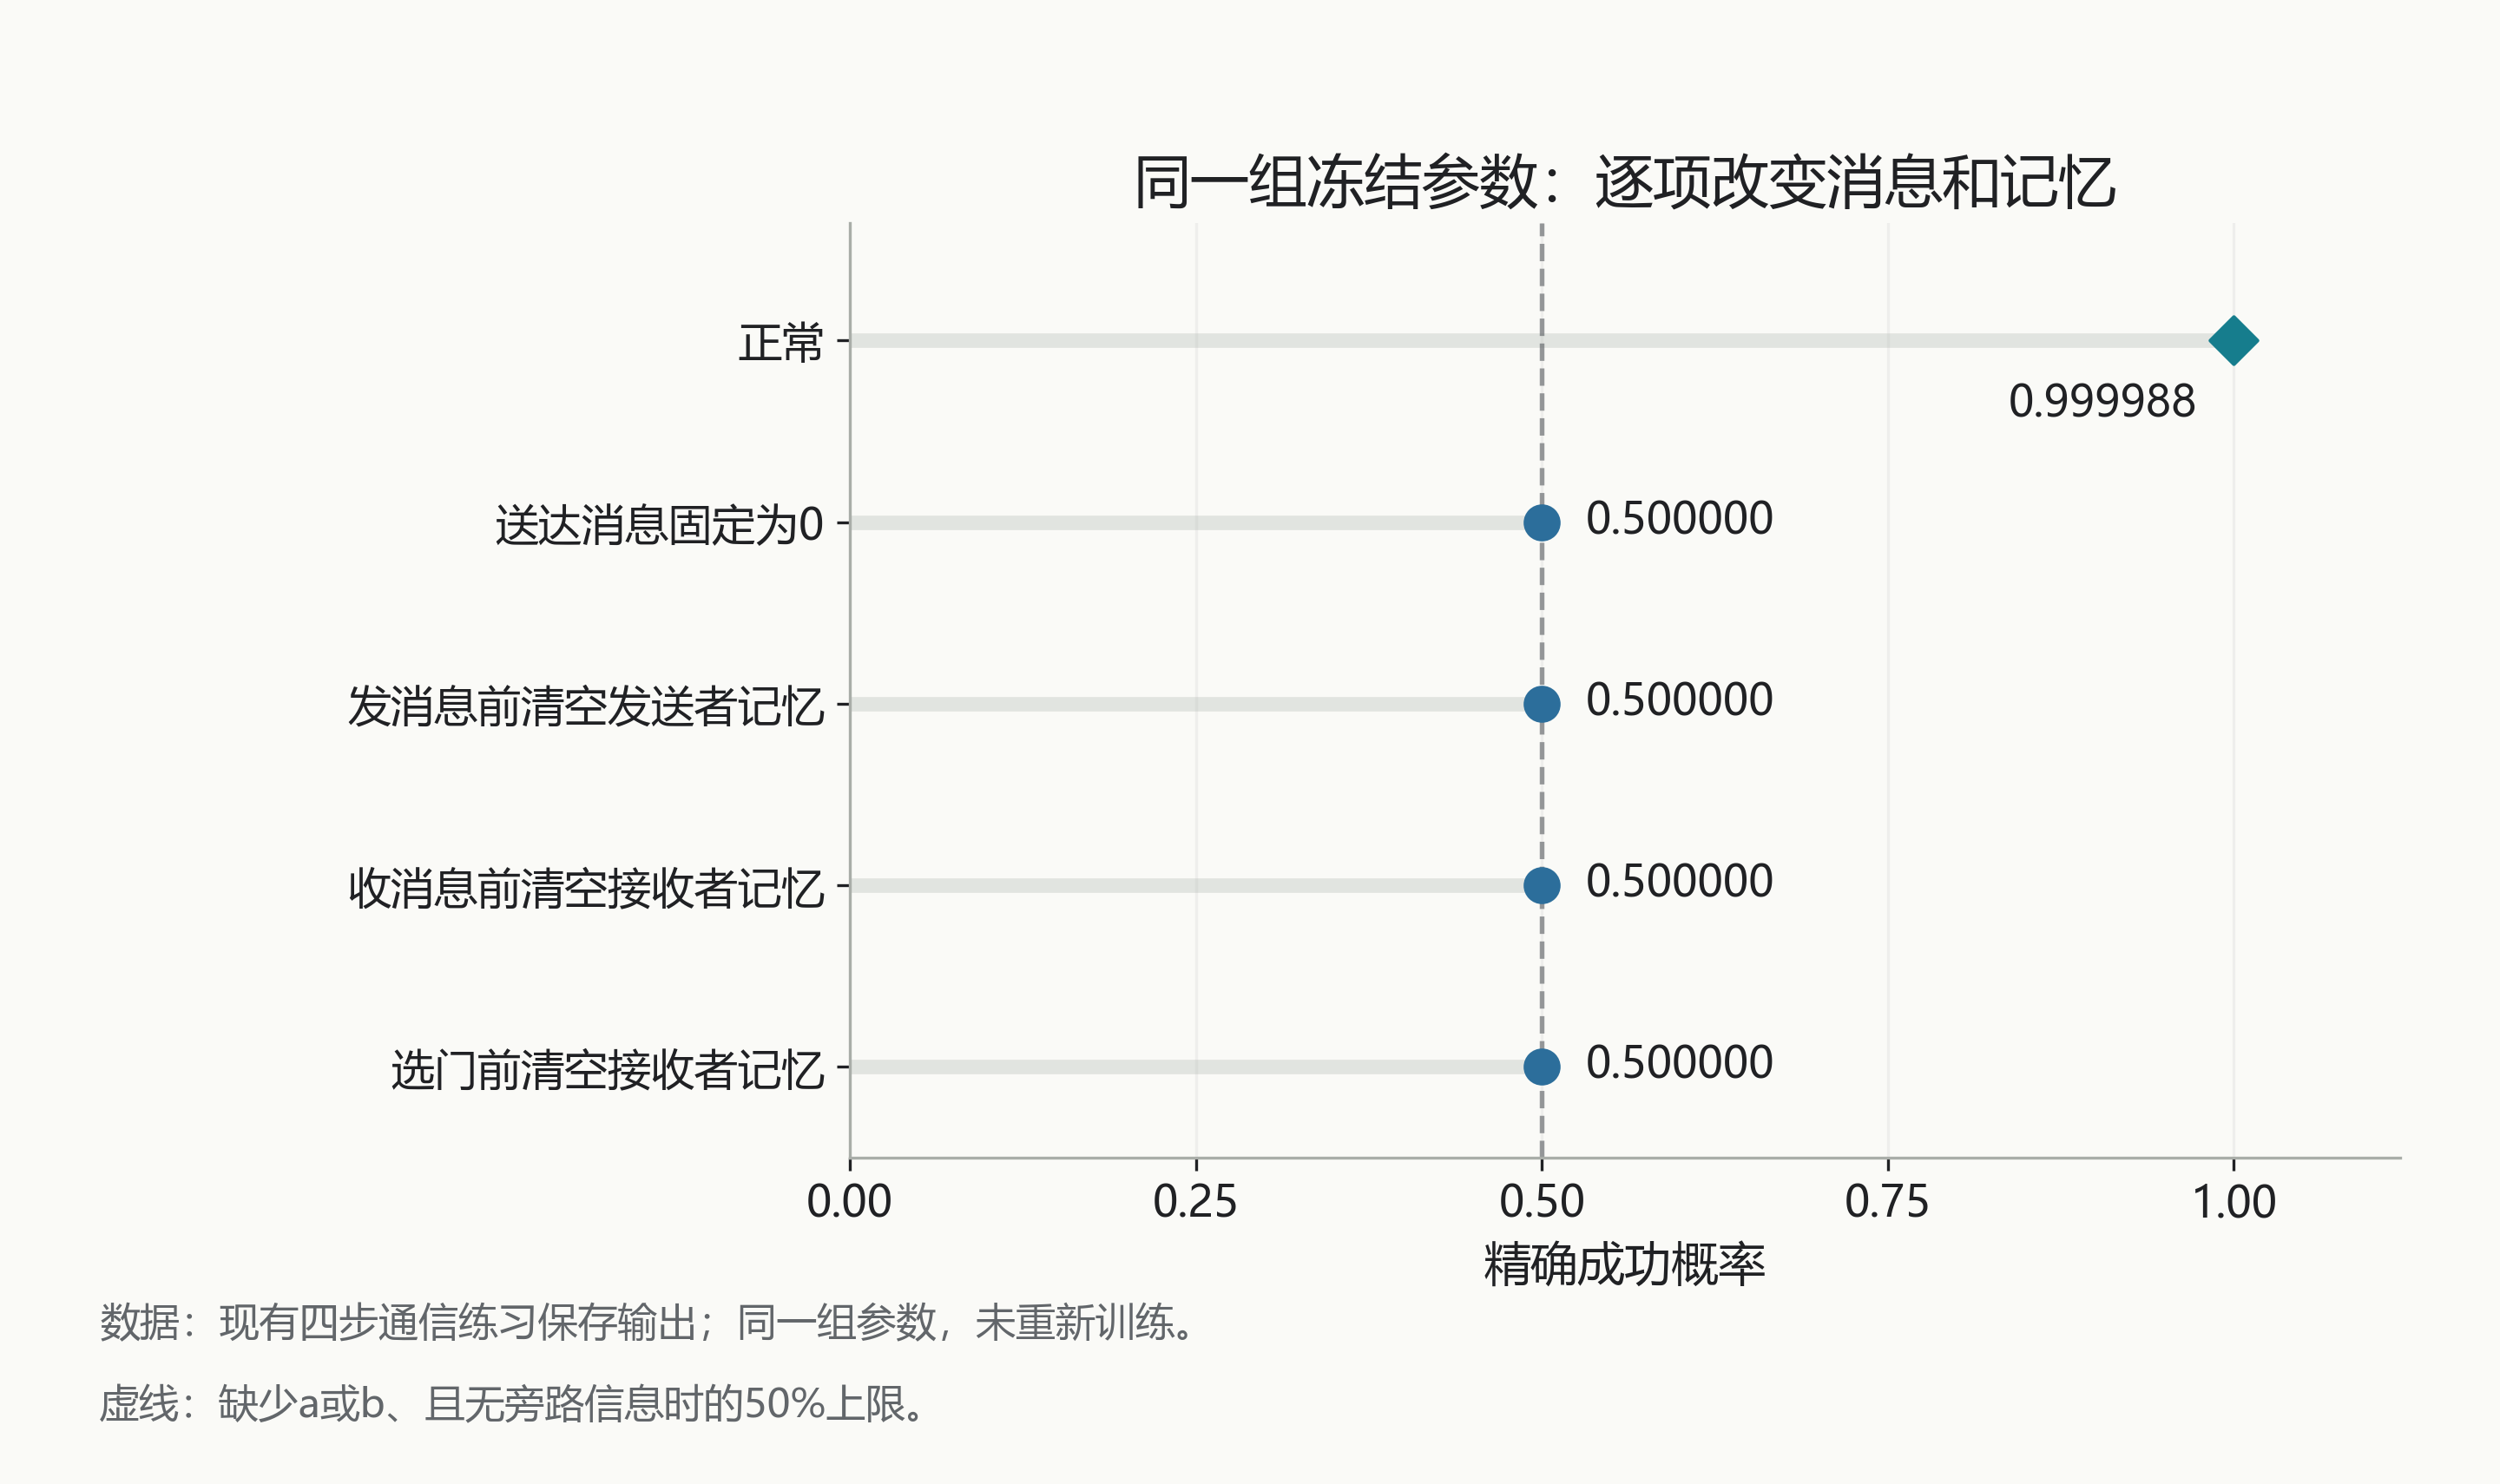
这个对照支持的结论是:
当前这组已经训练好的策略,在当前评估条件下依赖正常消息和必要的本局记忆。
表中的 0.4999999702 与0.5的差别来自浮点运算。发消息前清空发送者记忆会丢掉 $a$;收消息前清空接收者记忆会丢掉 $b$,即使随后仍然能收到消息;选门前清空接收者记忆则会丢掉本次决策需要的历史。
单看“把消息置零后掉分”,还要考虑输入分布变化的影响。[2] 这里可以结合第3节的两张概率表:发送者按 $a$ 改变消息,接收者固定自己的 $b$ 时,切换消息会切换选门分布,而且两者配合实现了 XOR。信息条件、编码、解码和逐项干预一起支持“当前策略利用消息完成任务”。
6. 固定策略干预与重新训练消融
固定策略干预始终保留原参数,检查已形成的行为。重新训练消融从新初始化开始,把无消息条件贯穿整个训练和评估,检查在给定预算下能学到什么。
训练消融中,一个批次应该采用这样的顺序。cues 是本批新抽的线索,action_generator 控制动作采样;ablation_model 是新初始化的模型,ablation_optimizer 只持有它的参数:
batch = run_batch(
    ablation_model, cues,
    sample_generator=action_generator,
    intervention="erase_message",  # 训练时送达消息也固定成0。
)
loss = compute_losses(ablation_model, batch)
ablation_optimizer.zero_grad(set_to_none=True)
loss.backward()
torch.nn.utils.clip_grad_norm_(ablation_model.parameters(), 1.0)
ablation_optimizer.step()
这里调用第3节返回一个总损失的 compute_losses。完整消融还应为每批抽取新线索、重复同样的交互与更新预算,最后用 exact_stats(ablation_model, "erase_message") 评估;只在训练结束后改一次评估开关,属于固定策略干预。
本篇用代码说明实验设计,没有新增无消息训练结果。对当前严格 XOR 任务,第1节已经给出无消息且无旁路信息的50%期望上限,重新训练也无法改变它。
“无消息重新训练也能接近满分”只适用于另一类信息充分的任务。例如前面的灯控任务,每人看自己的灯和公共阶段就能决定正确动作,任务存在独立完成各自部分的解法。在这种任务中,无消息重训成功能证明存在替代解法;重训失败则只说明该模型在本次配置与预算内没有学成,不能据此证明不存在解法。
7. 一次训练成功,不能代替多次独立训练
评估同一组固定参数10000局,主要减少的是这组参数的测试误差。它不能观察重新初始化、重新采样和优化过程带来的训练波动。
多次独立训练需要重新完成:
- 设置新的训练随机种子;
- 重新初始化网络;
- 重新采样交互数据;
- 重新更新参数;
- 用统一的评估方式测试最终策略。
下面两组是假设的五次训练结果,用来演示汇总方法,均未作为当前项目的实跑数据:
from statistics import mean

A = [1.00, 0.99, 1.00, 0.99, 1.00]
B = [1.00, 0.50, 0.50, 1.00, 0.50]
threshold = 0.90  # 在查看结果前定义达标线。
for name, scores in (("A", A), ("B", B)):
    passed = sum(value >= threshold for value in scores)
    print(name, mean(scores), f"{passed}/{len(scores)}")
# A: 0.996,5/5;B: 0.7,2/5。
两组均值分别为99.6%和70%。如果预先把0.9设为达标阈值,A组5次达标,B组只有2次达标。
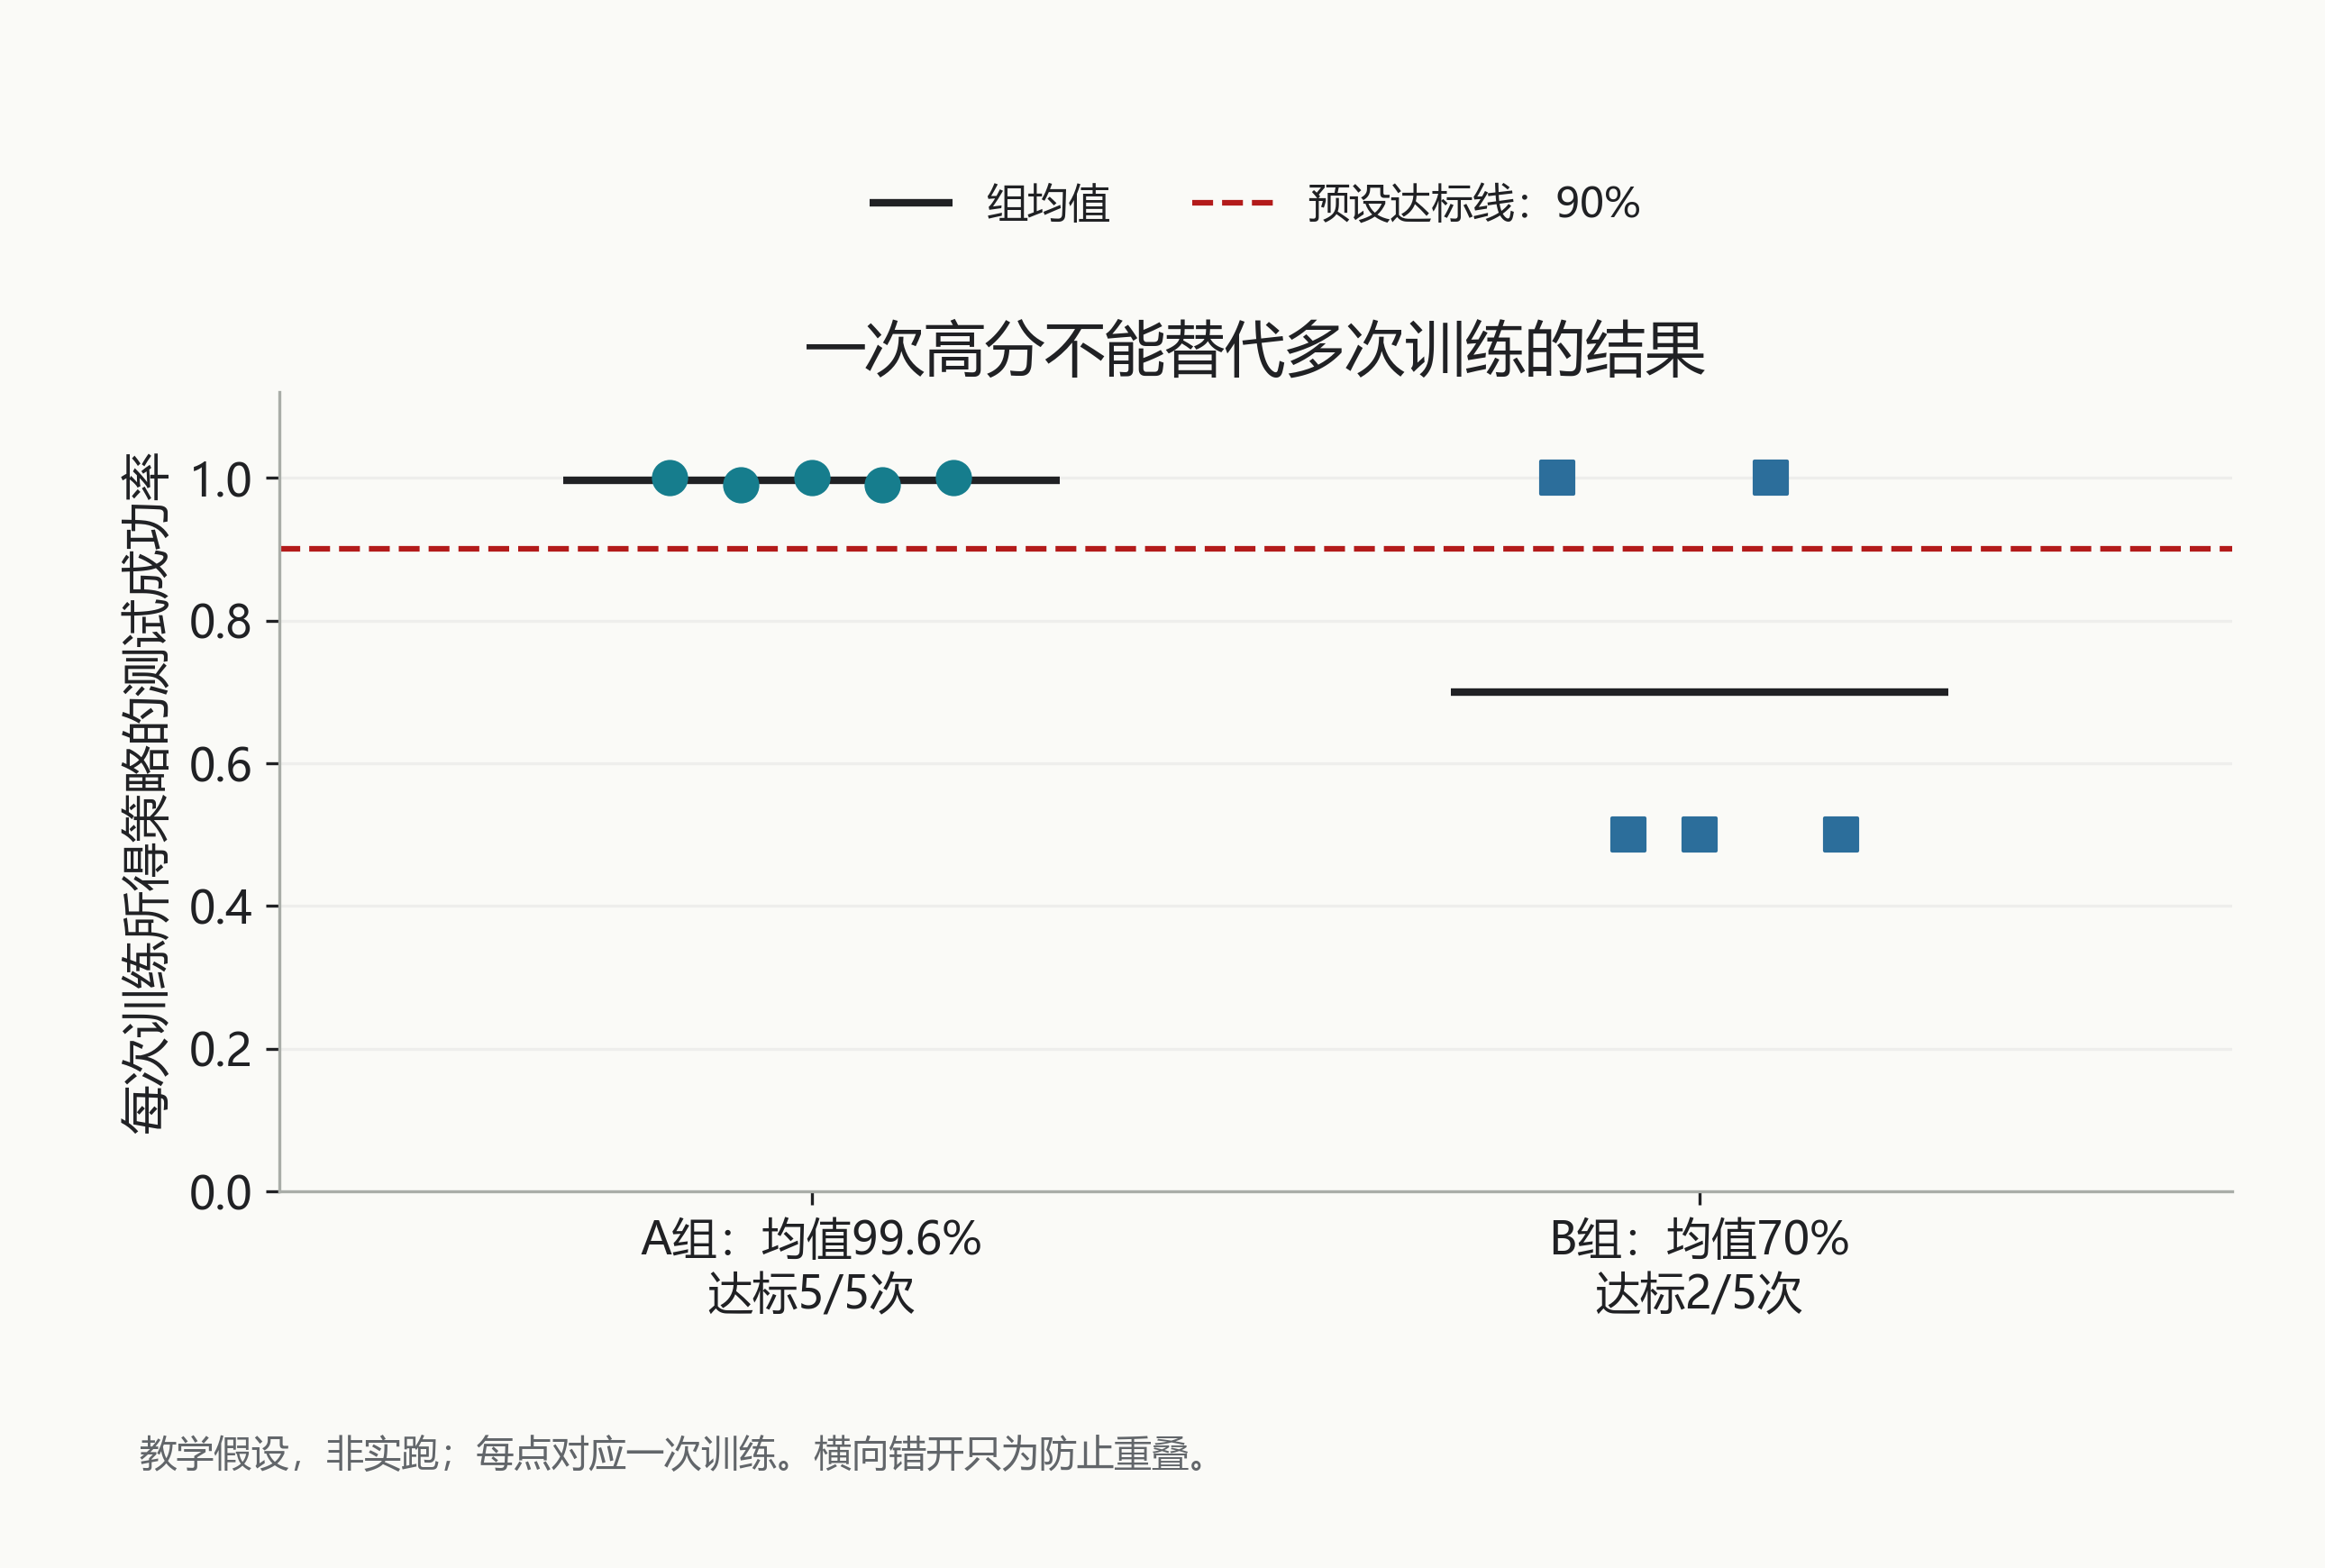
图中每个点是一份训练结果;横向偏移只为避免重叠,不表示时间先后。均值反映平均表现,预定阈值下的达标比例描述这批重复训练中成功的频率。五次是教学数量,不是对所有实验都充分的样本量;实际应连同逐种子结果和合适的不确定性统计报告。[1]
比较两个训练方法时,还要统一任务分布、可用信息、环境交互预算和评估方式,说明计算预算与调参资源。训练种子控制初始化和训练采样,评估种子控制固定策略的测试采样;给同一个模型换五个测试种子,仍然只训练过一次。[4]
8. 两套协议都能成功,换队友仍可能失败
通信还有一个容易被忽略的维度:符号含义是否一致。
协议A可以使用:
发送:m = a
接收:door = m XOR b
协议B也可以使用:
发送:m = 1 - a
接收:door = (1 - m) XOR b
两套协议都能在自己的发送者和接收者之间完成任务,因为编码和解码是配套的。但把协议A的发送者交给协议B的接收者,或者反过来,符号含义就对不上。
配对结果可以直接枚举:
from itertools import product

encoders = [lambda a: a, lambda a: 1 - a]
decoders = [lambda b, m: m ^ b, lambda b, m: (1 - m) ^ b]
cases = list(product((0, 1), repeat=2))
matrix = [
    [sum(decode(b, encode(a)) == (a ^ b) for a, b in cases) / len(cases)
     for decode in decoders]
    for encode in encoders
]
print(matrix)  # [[1.0, 0.0], [0.0, 1.0]]。
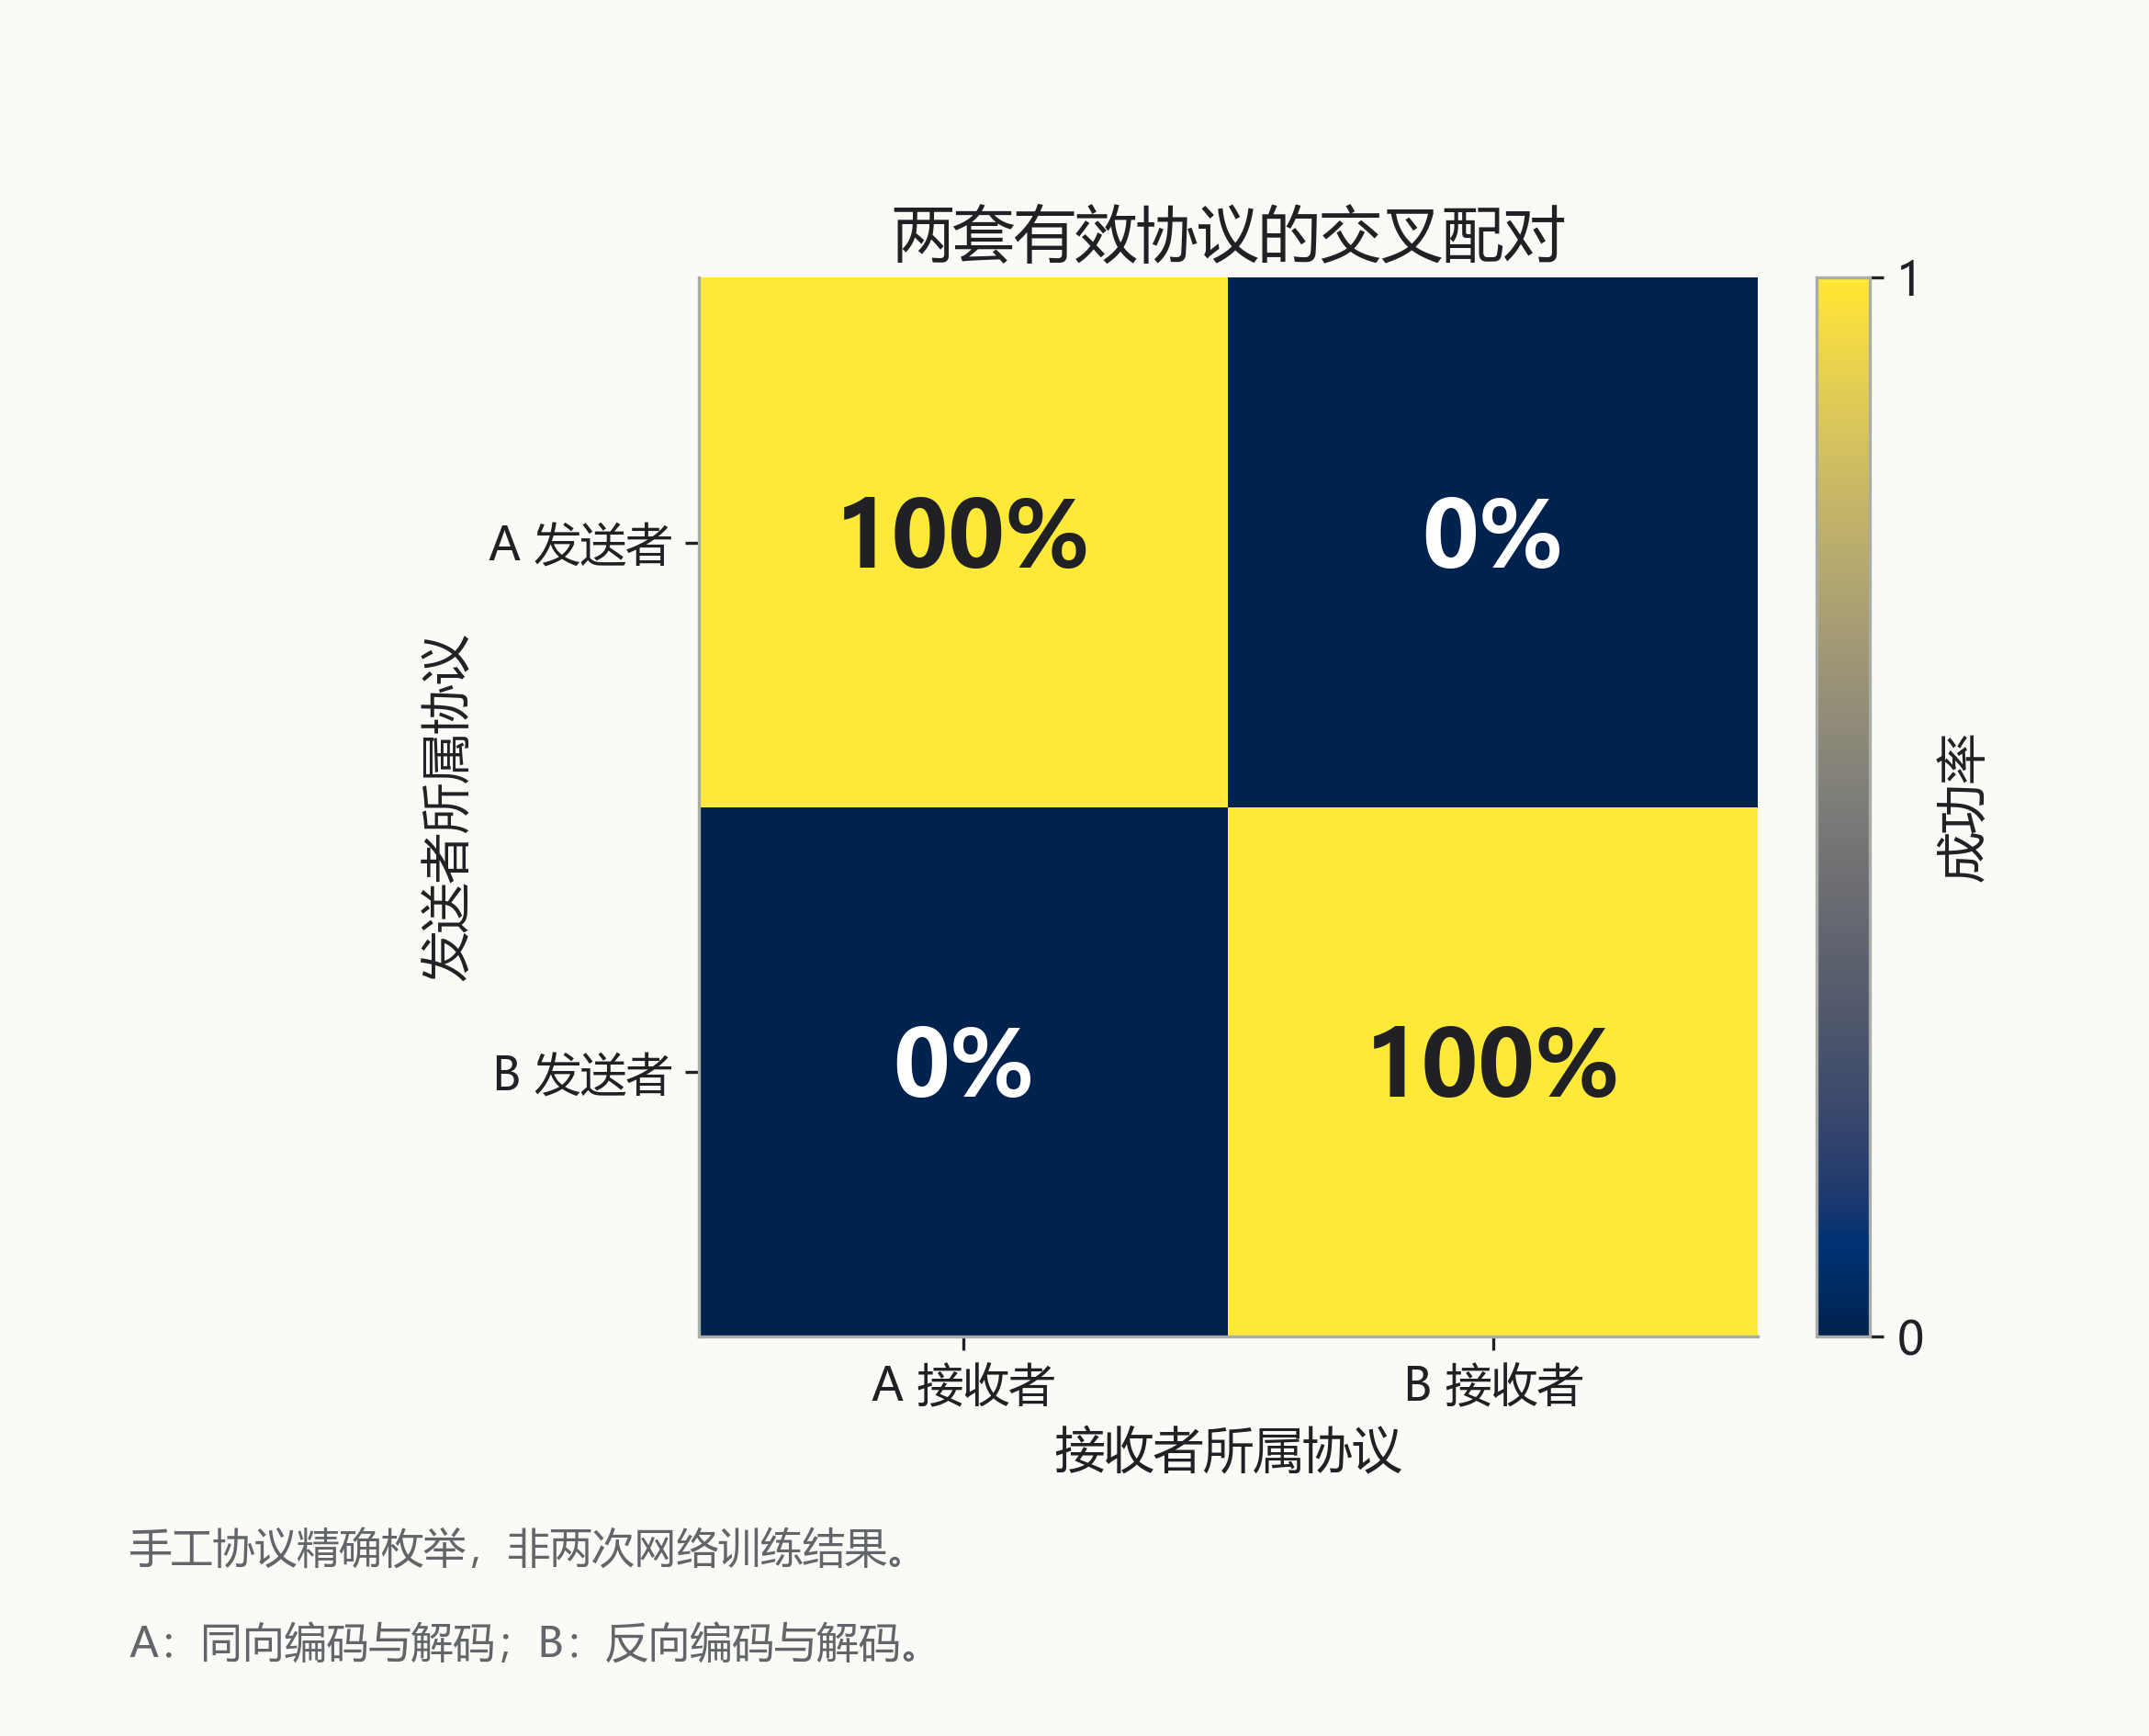
教学枚举得到:
| 发送者 / 接收者 | A 接收者 | B 接收者 |
|---|---|---|
| A 发送者 | 100% | 0% |
| B 发送者 | 0% | 100% |
因此:
原配成功说明队伍内部形成了有效约定;交叉失败说明协议不兼容。
这张图来自两套手工规则的精确枚举,并非两次独立网络训练的测试结果。交叉失败说明符号解释不配套。“会通信”和“能否直接理解新队友”是两个评价指标;Other-Play 研究的零样本协调就关注这一类问题。[3]
测试训练得到的策略时,原配与交叉配对都要先固定参数;如果允许换队友后继续学习,应另外报告适应预算,以及适应前后的表现。
9. 实验名称和论文结论要一一对应
Day12 最重要的一张表如下:
| 实验 | 它主要回答的问题 | 可以支持的结论 |
|---|---|---|
| 正常评估 | 当前策略能否完成任务 | 这组参数在当前条件下成功 |
| 固定参数干预 | 当前策略是否依赖某个输入 | 当前策略依赖该输入 |
| 无消息重新训练 | 删除通道后能学到什么 | 成功可展示替代策略;失败描述该配置与预算内的学习结果 |
| 多个随机种子 | 训练结果是否稳定 | 这些种子和预算下的稳定性 |
| 交叉配对 | 协议是否兼容 | 不同队伍之间能否直接协调 |
| 精确策略评估 | 固定策略的期望表现是多少 | 按指定分布对线索与消息分支加权后的成功概率 |
| 信息条件分析 | 缺少某条信息后有何上限 | 在明确观测与分布约束下的可达成功率 |
例如,在一般任务中,只报告“正常评估99.9%”和“固定消息后50%”,可以写成:
在当前训练得到的策略和评估条件下,消息固定后表现从99.9%降至50%;结合消息编码与接收端的行为变化,可见该策略利用消息完成任务。
如果这个任务的局部信息本来就充分,无消息重新训练又达到99.5%,则可以补充:
在该任务的信息条件下,重新训练找到了不依赖消息通道的替代策略。
这组99.9%/99.5%是假设的证据组合,适用条件已经改变,不能套到本篇无旁路信息的严格 XOR 任务。
多次独立训练才提供训练波动的证据;跨队伍冻结配对才提供协议兼容性的证据。要用“更好”“更稳定”“能泛化”这些词,就为它们分别安排有共同比较口径的实验。
10. 读一篇 MARL 论文时固定抽取这些字段
把 Day12 的方法卡片固定下来,阅读任何多智能体强化学习论文时都先问:
| 字段 | 要确认的内容 |
|---|---|
| 任务目标 | 智能体共同完成什么 |
| 局部观测 | 每个智能体实际看到了什么 |
| 训练时信息 | Critic 或训练模块是否看到全局状态 |
| 执行时信息 | 测试时是否仍然可以使用全局信息 |
| 奖励 | 团队奖励、个体奖励还是混合奖励 |
| 信用分配 | 如何评价某个智能体对团队结果的贡献 |
| 通信机制 | 谁发送、谁接收、消息何时出现 |
| 记忆机制 | hidden 是否跨时间保留,何时重置 |
| 训练随机性 | 使用多少独立种子,如何汇总 |
| 泛化评估 | 是否换队友、换任务、换环境或改变信息条件 |
| 实验主张 | 结果实际支持哪一句话 |
这样阅读时,方法结构、训练过程和实验结论就不会混在一起。看到一张成功率表,先定位它属于当前策略表现、机制依赖、替代可学习性、稳定性还是协议兼容性。
按这张卡片描述当前练习:任务是四步延迟 XOR 选门,两人分别保有私有线索;GRU 保存本局历史,离散消息在指定时刻送达;两份 REINFORCE 损失使用共同回报减固定参照;冻结后枚举四种线索与消息分支,再分别改变消息和记忆。当前保存结果展示了一套有效协议及其信息依赖,多种子训练与真实跨队伍配对则各有独立的实验职责。
参考资料
- Henderson et al. (2018), Deep Reinforcement Learning that Matters:训练随机性、结果报告与可复现比较。
- Lowe et al. (2019), On the Pitfalls of Measuring Emergent Communication:区分消息相关性与对接收者行为的影响。
- Hu et al. (2020), Other-Play for Zero-Shot Coordination:独立训练智能体之间的零样本协调。
- PyTorch 官方说明:Reproducibility、Locally disabling gradient computation、Module.eval。