Day2 · 从 Q 表到 DQN 的一次更新
前言:这次实际解决的问题
Day1 的 Q 表能为 24 个离散状态各存一行动作价值。状态一多、状态连续(比如小车的位置和速度),为每个精确状态建一格就不成立了。这一节处理的问题是:用神经网络近似 $Q(s,a)$ 之后,”一次更新”到底发生了什么。
本节只观察一条经验的一次参数更新。这样每个数都能手算:当前估计 $0.30$、下一状态最大估值 $0.60$、学习目标 $0.50$、损失 $0.04$。完整训练所需的回放池、批量采样、行为策略和周期同步留到后续项目。
实验设计
实验用两个最小的线性层 Linear(2, 2, bias=False) 分别充当在线网络和目标网络:输入 2 个特征,输出 2 个动作的 Q 值。权重手动设成整齐的数,再喂进一条经验,走完“取当前估计 → 算目标 → 算损失 → 反传 → 更新 → 同步”的全过程。代码分十个区块,每块后面都打印形状或数值做检查,第 4 节逐块摘录。
1. 先用最小例子理解概念
从表格换成网络后,先分清三个变化:
① 参数共享。 表格里改一格只影响那一格;网络共享权重,一次更新可能同时改变多个状态的估值。相近状态因此有机会共享信息。
② 经验回放。 把已经发生的 $(s,a,r,s’)$ 存进回放池,训练时随机抽取。重复抽到一条经历,只会增加这条样本参与更新的次数;环境奖励 $r$ 已经记录下来,变化的是网络对它的价值估计。
③ 目标网络。 在线网络负责当前估计,目标网络提供一段时间内相对稳定的学习目标:
\[y = r+\gamma\max_{a'}Q_{\mathrm{target}}(s',a')\]这里有一个口径差别:当前状态取回放记录中的实际动作,下一状态取最大值。gather 读取历史动作对应的列;下一状态按 Q-learning 的规则取最大 Q 值。
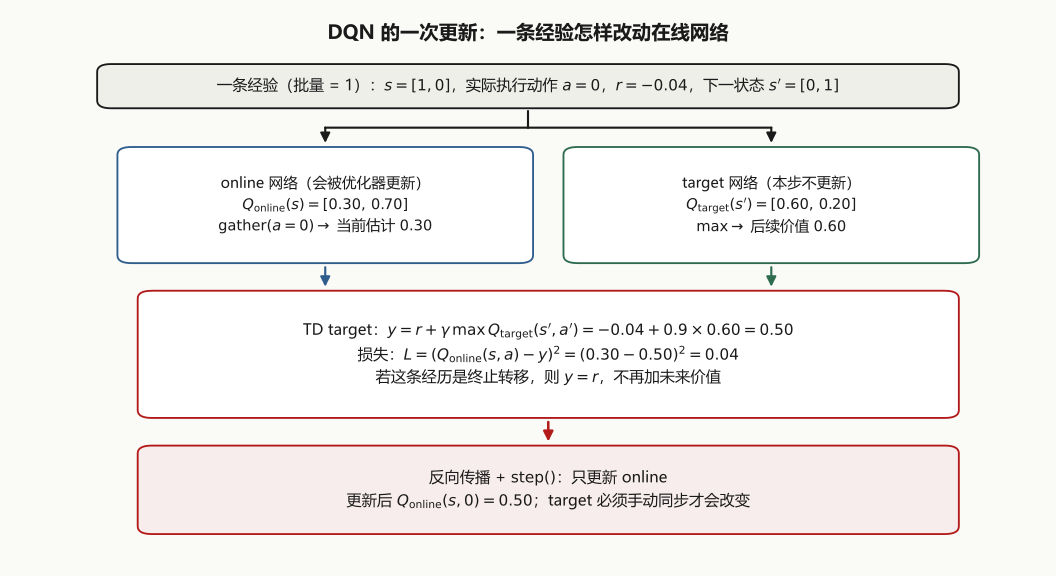
2. 变量和公式逐步对应
| 代码 | 张量形状 | 算式 / 含义 |
|---|---|---|
s |
(1, 2) |
动作发生前的状态,批量大小为 1 |
action |
(1, 1) |
当时实际执行的动作编号 $0$ |
reward |
(1,) |
环境给出的单步奖励 $-0.04$ |
s_next |
(1, 2) |
这一步到达的状态 |
q_values = online(s) |
(1, 2) |
在线网络对两个动作的估值 $[0.30,\,0.70]$ |
current_q = q_values.gather(1, action).squeeze(1) |
(1,) |
先取出形状为 (1,1) 的值,再去掉动作维度,得到 $0.30$ |
next_q_values = target(s_next) |
(1, 2) |
目标网络对下一状态两个动作的估值 $[0.60,\,0.20]$ |
next_q, _ = next_q_values.max(dim=1) |
(1,) |
取最大值 $0.60$(第二个返回值是动作编号) |
td_target |
(1,) |
$r+\gamma\cdot 0.60=0.50$ |
loss |
() |
$(0.30-0.50)^2=0.04$ |
终止转移要单独处理。$s’$ 是终止状态时没有”下一状态价值”,两种写法等价:
y = reward                                 # 终止:直接等于当前奖励
y = reward + gamma * next_q * not_done     # not_done = 0 时后一项归零
terminated 指任务真的结束;如果是被人为步数上限截断,任务本可继续,仍要保留未来项。把截断当终止会系统性低估接近上限的状态。
3. 手算一个具体数值
这一次更新。
当前估计:Q_online(s, a=0) = 1×0.30 + 0×0 = 0.30
下一状态:Q_target(s', ·)  = [0×0 + 1×0.60, 0×0 + 1×0.20] = [0.60, 0.20]
后续价值:max(0.60, 0.20) = 0.60
TD target:-0.04 + 0.9 × 0.60 = 0.50
TD 误差:0.50 - 0.30 = +0.20   → 原来低估了这个动作
损失:(0.30 - 0.50)² = 0.04
更新之后动作 0 的估值恰好等于 $0.50$。这是线性层、输入 $[1,0]$、学习率 $0.5$ 和一次 SGD 步共同造成的结果;一般 DQN 更新不保证一步就到达 target。
同步之后会变成多少? 要按当前矩阵重算。这份演示的在线网络第二列权重全是 $0$:
同步后 target 权重 = online 权重 = [[0.50, 0.00], [0.70, 0.00]]
target(s_next = [0,1]) = [0×0.50 + 1×0, 0×0.70 + 1×0] = [0.0, 0.0]
新的 TD target = -0.04 + 0.9 × 0 = -0.04
抽象数值题里“同步后 target 从 $0.50$ 变成 $0.68$”的前提是该状态输出 $0.8$;这份代码同步后的第二列全为 $0$,所以结果不同。遇到同步题,先读矩阵,再计算输出。
4. 关键代码逐段解释
下面的区块按顺序运行即可完成一次更新,不依赖附件中的变量。每个区块保留计算过程,详细输出集中在第 5 节。
区块 1–2:两个网络与手动权重
import torch

online = torch.nn.Linear(2, 2, bias=False)   # 负责学习
target = torch.nn.Linear(2, 2, bias=False)   # 只负责提供学习目标

with torch.no_grad():
    online.weight.copy_(torch.tensor([[0.30, 0.0], [0.70, 0.0]]))
    target.weight.copy_(torch.tensor([[0.0, 0.60], [0.0, 0.20]]))
online_weight_before = online.weight.detach().clone()
权重矩阵的两行对应动作 0、动作 1,两列对应输入的两个特征。输入 $[1,0]$ 时输出就是第一列 $[0.30,0.70]$,输入 $[0,1]$ 时输出就是第二列。这样设计是为了让每个数都能心算。copy_ 是原地赋值,不是训练;no_grad() 只在这个代码块里关闭梯度记录,离开后 online 照常可以学习。
区块 3:一条经验
s      = torch.tensor([[1.0, 0.0]])   # 最外层 [...] 是批量维度,批量大小 1
action = torch.tensor([[0]])          # 当时实际执行的动作编号,不是 Q 值
reward = torch.tensor([-0.04])        # 环境当时给的奖励,之后不会变
s_next = torch.tensor([[0.0, 1.0]])
gamma  = 0.9
区块 4–5:当前估计与后续价值
q_values  = online(s)                                 # [[0.30, 0.70]]
current_q = q_values.gather(1, action).squeeze(1)     # [0.30]

with torch.no_grad():
    next_q_values = target(s_next)                    # [[0.60, 0.20]]
    next_q, next_action_index = next_q_values.max(dim=1)  # [0.60], [0]
这两行是 DQN 最容易写错的地方,口径不同:当前状态用 gather 取回放记录里实际执行的动作(动作 0 的 $0.30$),不能拿动作 1 的 $0.70$;下一状态用 max 取最大值($0.60$)。max 同时返回值和编号,构造 target 只用值。可以用一句话检验:回放记录里的动作是历史事实,不能因为网络现在觉得另一个动作更好就改写它。
区块 6–7:TD target 与损失
terminated = False
not_done = 0.0 if terminated else 1.0
with torch.no_grad():
    td_target = reward + gamma * next_q * not_done   # 非终止为 0.50;终止为 -0.04

loss = ((current_q - td_target) ** 2).mean()          # (0.30 - 0.50)² = 0.04
no_grad() 包住目标计算,损失的梯度就不会流进目标网络。mean() 是对批次求平均,这里批量只有 1,结果还是 $0.04$。
区块 8:反传与更新
optimizer = torch.optim.SGD(online.parameters(), lr=0.5)   # 只把 online 交给优化器

optimizer.zero_grad()   # 清空旧梯度(PyTorch 默认累加)
loss.backward()         # 算出梯度,参数此时还没变
optimizer.step()        # 用梯度更新 online 的参数
梯度可以手算:$L=(w_{00}\cdot1-0.50)^2$,对 $w_{00}$ 求导得 $2\times(0.30-0.50)\times1=-0.40$;更新后 $w_{00}=0.30-0.5\times(-0.40)=0.50$。target 不变有两个原因:它不在优化器里,目标值也是在无梯度路径中算出来的。
区块 9:看哪些参数真的动了
q_after = online(s)   # 必须重新前向计算;旧的 current_q 不会自动更新
delta = (online.weight.detach() - online_weight_before).tolist()
区块 10:目标网络同步
target.load_state_dict(online.state_dict())   # 参数复制,不是训练

with torch.no_grad():
    next_q_after_sync = target(s_next).max(dim=1).values
    td_target_after_sync = reward + gamma * next_q_after_sync
同步改的是 target,online 在这一步保持不动。同步后用同一条经历重算目标,就能看到目标网络换了参数以后学习目标怎样跟着变。
5. 实际运行结果
区块 2:手动设置权重后
online 权重: [[0.30000001192092896, 0.0], [0.699999988079071, 0.0]]
target 权重: [[0.0, 0.6000000238418579], [0.0, 0.20000000298023224]]
区块 4–7:当前估计、后续价值、目标与损失
online(s) 全部动作的估值: [[0.30, 0.70]]
gather 取出的当前估计 current_q: [0.30]
target(s_next) 两个动作的估值: [[0.60, 0.20]]
最大值 next_q: [0.60]
非终止转移的 TD target: 0.5
假设为终止转移时的 TD target: -0.04
带符号的 TD 误差 (target - current_q): 0.2 → 正数表示原来低估了这个动作
损失 loss: 0.04
区块 8:梯度与参数更新
优化器管理的参数:
  online.weight  requires_grad=True
target 是否在优化器里: False

backward 之后、step 之前的 online 梯度:
  [[-0.3999999761581421, -0.0], [0.0, 0.0]]
backward 之后、step 之前的 online 权重:
  [[0.30, 0.0], [0.70, 0.0]] (与更新前完全相同)

step 之后的 online 权重:
  [[0.5, 0.0], [0.699999988079071, 0.0]]
target 的梯度: None (本次损失反传没有向目标网络参数累积梯度)
区块 9:参数变化
更新前 online(s): [[0.30, 0.70]]
更新后 online(s): [[0.5, 0.70]]

权重变化(更新后 - 更新前):
  动作 0 的一行:[0.19999998807907104, 0.0]
  动作 1 的一行:[0.0, 0.0]

动作 0 的估值变化: 0.3 → 0.5
动作 1 的估值变化: 0.7 → 0.7
更新后的动作 0 估值是否等于 TD target: True
只有动作 0 那一行、第一个特征那一列动了。原因是输入是 $[1,0]$:第二列权重乘的是 $0$,对输出没有贡献,梯度也是 $0$。这不是 DQN 的一般性质,而是这个刻意设计的输入造成的;一般网络里一次更新会同时改动很多参数,动作 1 的估值也可能跟着变。
区块 10:目标网络同步
同步前 online: [[0.5, 0.0], [0.70, 0.0]]      同步前 target: [[0.0, 0.60], [0.0, 0.20]]
同步后 online: [[0.5, 0.0], [0.70, 0.0]]      同步后 target: [[0.5, 0.0], [0.70, 0.0]]

online 在同步过程中是否被改动: False
同步后 target 是否与 online 完全一致: True
同步前 target(s_next): [[0.60, 0.20]] → 最大 0.6
同步后 target(s_next): [[0.0, 0.0]]   → 最大 0.0
同一条经历的 TD target: 0.5 → -0.04
形状检查(8 个张量)
state          shape=(1, 2)
q_values       shape=(1, 2)
action         shape=(1, 1)
current_q      shape=(1,)
next_q_values  shape=(1, 2)
next_q         shape=(1,)
target         shape=(1,)
loss           shape=()
最外层维度是批量。s 的 (1, 2) 表示“1 条状态、2 个输入特征”;q_values 的 (1, 2) 表示“1 条状态、2 个动作的估值”。形状相同,第二维的含义不同。squeeze(1) 只去掉第 1 维上长度为 1 的轴,不改数值。
6. 常见误区
- 把
gather取到的值当成”最优动作的 Q 值”。 它取的是回放记录里实际执行的动作;哪个动作当前估值最高与这条经验无关。 - 把
max用到当前状态上。 当前状态取实际动作、下一状态取最大值,两边口径不同,这是最容易写错的一行。 - 以为
target会累积梯度。 目标值在no_grad()内计算,target.weight.grad始终是None。 - 以为
no_grad()会永久冻结网络。 它只作用于所在代码块。 - 以为
copy_是训练。 它是原地赋值,没有梯度、没有学习率参与。 terminated与truncated混为一谈。 真正终止时未来项为 $0$;被步数上限截断时仍要保留未来项。- 把训练损失的平均当成评估指标。
loss.mean()是对一个批次的误差求平均;测试回报的平均是对多局完整回合的成绩求平均。 - 以为一次更新后 Q 值一定等于 TD target。 本例恰好相等是构造出来的。
- 照着抽象例子套数字。 同步后的 target 取决于目标网络当前的实际权重矩阵;本例第二列全为 $0$,同步后目标退化为 $-0.04$,而不是 $0.68$。
- 以为”目标网络稳定”是自动的。 它靠两件事共同保证:不把
target交给优化器 + 定期手动同步。