Day3 · 从策略概率到 Actor–Critic
前言:这次实际解决的问题
Day2 的网络输出的是 $Q(s,a)$:先估计动作价值,再由价值导出选择。这一节换成另一种问法:让网络直接输出”在这个状态下每个动作有多大概率”,再根据结果好坏直接调整这些概率。
这一节先固定三条关系:
- 分清两种输出的语义——$Q(s,a)$ 是预期回报的估计,可以为负、不要求和为 $1$;$\pi_\theta(a\mid s)$ 是概率,非负且求和为 $1$;
- 分清 Actor 与 Critic 的职责:Actor 管动作概率,Critic 管状态价值 $V(s)$;
- 用 TD 误差解释 advantage 的方向——”这一步比预期好还是差”,而不是”这一步的奖励是正是负”。
实验设计
实验自己写了一个只有两个非终止状态的环境 TinyChainEnv,再用一个“共享主体 + 两个输出头”的小网络同时充当 Actor 和 Critic,训练 1000 局。训练后做三件事:逐步打印一局里的 reward、advantage 和两条损失;关掉采样做 100 局贪心评估;用断言确认轨迹真的走完长路线。第 4 节逐段摘录关键代码。
1. 先用最小例子理解概念
环境只有两个非终止状态,两条路线都会结束:
起点 s=0 ──动作0 / 奖励0──> 中间状态 s=1 ──任意动作 / 奖励2──> 终点
         └─动作1 / 奖励1───────────────────────────────────> 终点
设 $\gamma=0.9$:
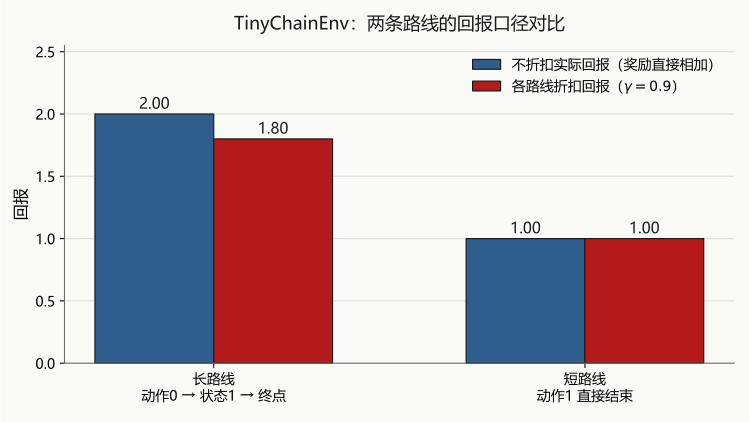
| 口径 | 长路线 | 短路线 |
|---|---|---|
| 不折扣实际回报(奖励直接相加) | $0+2=2.0$ | $1.0$ |
| 各路线的折扣回报 | $0+0.9\times2=1.8$ | $1.0$ |
走长路线时,episode_return 是奖励直接相加的 $2.0$,折扣回报是 $1.8$。Critic 学的是当前策略的期望折扣回报:若起点选长路线的概率为 $p$,则 $V^\pi(0)=1.8p+1(1-p)$。当 $p$ 接近 $1$,价值才接近 $1.8$。
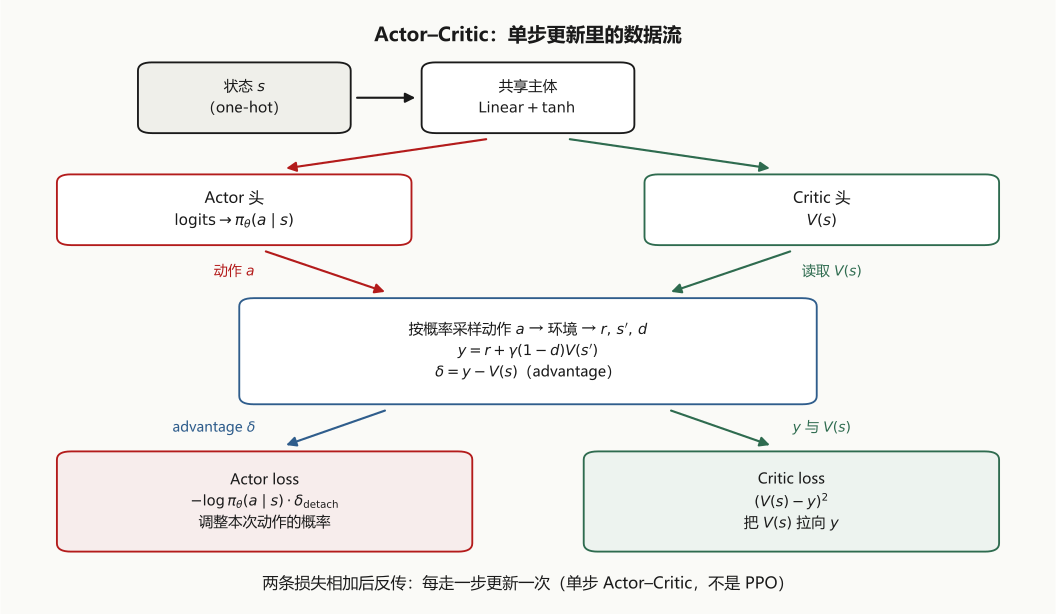
三项分工:
- Actor:看到状态输出各动作概率,训练时按概率采样动作(保留探索),测试时才用
argmax; - Critic:输出 $V(s)$,用 TD 误差把自己拉向 $r+\gamma(1-d)V(s’)$;
- advantage:把同一次 TD 误差同时交给两边——符号决定 Actor 把这个动作的概率往上调还是往下调。
2. 变量和公式逐步对应
| 代码 | 形状 | 含义 |
|---|---|---|
logits, value = model(state_tensor) |
(1,2) / (1,) |
Actor 原始分数与 Critic 状态价值 |
distribution = Categorical(logits=logits) |
— | 自动 softmax 得到动作分布 |
action_tensor = distribution.sample() |
(1,) |
训练期按概率采样 |
log_prob |
() |
本次实际抽中动作的对数概率(squeeze(0) 后是标量) |
td_target |
() |
$r+\gamma(1-d)V(s’)$,$d=1$ 时只剩 $r$ |
advantage |
() |
$\delta=\text{TD target}-V(s)$ |
actor_loss |
() |
$-\log\pi_\theta(a\mid s)\cdot\delta_{\text{detach}}$ |
critic_loss |
() |
$\big(V(s)-y\big)^2$ |
两条损失的分工:
| Actor loss | Critic loss | |
|---|---|---|
| 调整什么 | 本次动作被选中的概率 | 状态价值估计 $V(s)$ |
| 用到 TD 误差吗 | 用,并且 detach() 只当系数 |
用它的平方,梯度通过当前价值估计传播 |
| 符号含义 | 前面的负号把”最大化收益”写成”最小化损失” | 平方误差,恒非负 |
advantage.detach() 的作用是让 Actor 读取 advantage 的数值,但不让 Actor loss 的梯度沿着它回传到 Critic——否则同一份 TD 误差会被两个目标同时拉扯。td_target.detach() 同理,表示”这一轮把目标当常量”。
训练循环的收尾有三条规则:
terminated=False时执行state = next_state,下一步才能在新状态做决定;- 只有
terminated=True才break; - 终止时 $\text{TD target}=r$,不能把当前奖励再乘一次 $\gamma$——折扣只作用于未来价值。
3. 手算一个具体数值
折扣回报的比较。
长路线:0 + 0.9 × 2 = 1.8
短路线:1.0
1.8 > 1.0  →  Actor 应当把起点的动作 0 概率推高
非终止转移的 TD target。 动作 0:reward=0、terminated=False、$V(s’)=2$、$\gamma=0.9$:
td_target = 0 + 0.9 × 2 × 1 = 1.8
终止转移的 TD target。 动作 1:reward=1、terminated=True:
td_target = 1 + 0.9 × V(s') × 0 = 1.0
这里容易写成 $1+0.9\times 0=0.9$。当前奖励不打折,折扣只作用于未来价值。
advantage 的方向。 设 $\text{TD target}=1.8$、$V(s)=0.5$:
\[\delta = 1.8-0.5 = 1.3>0\]表示实际结果好于 Critic 原来的估计,Actor 倾向提高本次动作的概率;Critic 则把 $V(s)$ 往 $1.8$ 靠近。若 $\delta<0$,方向相反。再看一例:$V(s)=8$、$r=-1$、$V(s’)=10$、$\gamma=1$,则 $\delta=-1+10-8=1>0$——即时奖励是负的,advantage 仍然为正,因为下一状态的估值更高。
4. 关键代码逐段解释
下面按环境、网络、训练、评估分段展示。第 4.1 至 4.4 节按顺序运行,便能完成训练并打印完整轨迹;第 4.5 节另建环境演示循环错误。
4.1 环境:step() 定义两条路线
class TinyChainEnv:
    def __init__(self):
        self.n_states, self.n_actions = 2, 2
        self.current_state = 0

    def reset(self):
        self.current_state = 0
        return self.current_state

    def step(self, action):
        if action not in (0, 1):
            raise ValueError("action 必须是 0 或 1")
        if self.current_state == 0:
            if action == 0:          # 长路线:先拿 0 分,还没结束
                next_state, reward, terminated = 1, 0.0, False
            else:                    # 短路线:立即结束,拿 1 分
                next_state, reward, terminated = None, 1.0, True
        elif self.current_state == 1:   # 中间状态:任意动作都结束,拿 2 分
            next_state, reward, terminated = None, 2.0, True
        else:
            raise RuntimeError("当前回合已经结束,请先调用 reset()")

        self.current_state = next_state
        return next_state, reward, terminated, {}
结束时 current_state 被设成 None,之后如果忘了 reset() 又调用 step(),就会走进最后那个 else 直接报错,不会悄悄返回错误的结果。
4.2 网络:共享主体 + 两个头
import torch
from torch import nn
from torch.distributions import Categorical

torch.manual_seed(7)

def state_to_tensor(state, n_states):
    state_tensor = torch.zeros((1, n_states), dtype=torch.float32)
    state_tensor[0, state] = 1.0          # 状态 0 -> [[1, 0]],状态 1 -> [[0, 1]]
    return state_tensor

class ActorCritic(nn.Module):
    def __init__(self, state_dim, action_dim):
        super().__init__()
        self.shared = nn.Sequential(nn.Linear(state_dim, 16), nn.Tanh())
        self.actor_head = nn.Linear(16, action_dim)   # 输出 logits,还不是概率
        self.critic_head = nn.Linear(16, 1)           # 输出一个数:V(s)

    def forward(self, state_tensor):
        features = self.shared(state_tensor)
        logits = self.actor_head(features)
        value = self.critic_head(features).squeeze(-1)   # [1, 1] -> [1]
        return logits, value

env = TinyChainEnv()
model = ActorCritic(state_dim=env.n_states, action_dim=env.n_actions)
gamma, critic_coef = 0.9, 0.5
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
one-hot 编码把离散状态当成类别,不让网络误以为状态 1 比状态 0“大”。两个头共用 shared 提取的特征,一次前向计算同时得到动作分数和状态价值。
4.3 训练循环:一步走完六件事
for episode in range(1000):
    state = env.reset()
    while True:
        # 1. Actor 和 Critic 同时看当前状态
        logits, value = model(state_to_tensor(state, env.n_states))
        distribution = Categorical(logits=logits)       # 自动 softmax
        action_tensor = distribution.sample()            # 按概率采样,保留探索
        action = int(action_tensor.item())
        log_prob = distribution.log_prob(action_tensor).squeeze(0)
        current_value = value.squeeze(0)

        # 2. 和环境交互
        next_state, reward, terminated, _ = env.step(action)

        # 3. TD target:终止时没有未来价值
        with torch.no_grad():
            if terminated:
                next_value = torch.tensor(0.0)
            else:
                _, next_value = model(state_to_tensor(next_state, env.n_states))
                next_value = next_value.squeeze(0)
            not_done = 0.0 if terminated else 1.0
            td_target = torch.tensor(float(reward)) + gamma * next_value * not_done

        # 4. advantage = 这一步比 Critic 原来的估计好多少
        advantage = td_target - current_value

        # 5. 两条损失
        actor_loss = -log_prob * advantage.detach()
        critic_loss = (current_value - td_target.detach()).pow(2)
        total_loss = actor_loss + critic_coef * critic_loss

        # 6. 反传更新
        optimizer.zero_grad()
        total_loss.backward()
        optimizer.step()

        if terminated:
            break
        state = next_state
advantage.detach() 让 Actor loss 把 $\delta$ 当作固定系数。它的梯度通过 log_prob 到达动作输出头和共享主体,不经过价值输出头;Critic loss 的梯度通过 current_value 到达价值输出头和共享主体。共享主体同时收到两边的梯度,因此一次联合更新也可能同时影响概率和价值。最后三行负责推进循环变量,并在回合结束时退出。
4.4 贪心评估:测试时才用 argmax
def run_greedy_episode(model, env):
    state, total_return, trajectory = env.reset(), 0.0, []
    while True:
        with torch.no_grad():
            logits, _ = model(state_to_tensor(state, env.n_states))
            action = int(logits.argmax(dim=1).item())    # 不再采样
        next_state, reward, terminated, _ = env.step(action)
        trajectory.append((state, action, reward))
        total_return += reward
        if terminated:
            break
        state = next_state
    return total_return, trajectory
长路线的轨迹应当是两步:
[(0, 0, 0.0), (1, 0, 2.0)]
 ↑ 状态0 动作0 奖励0    ↑ 状态1 动作0 奖励2
只有第二步出现,才说明状态被正确推进到了 $s=1$。代码里用断言把这一点写死:
one_return, one_trajectory = run_greedy_episode(model, env)
print("轨迹:", one_trajectory)
print("未折扣回报:", one_return)
assert len(one_trajectory) == 2
assert one_trajectory[0][1] == 0      # 起点选动作 0(长路线入口)
assert one_trajectory[1][0] == 1      # 第二步发生在状态 1:状态被正确推进
assert one_trajectory[1][2] == 2.0    # 最后一步拿到奖励 2
4.5 反例:忘了 state = next_state
env_demo = TinyChainEnv()
state = env_demo.reset()
try:
    for i in range(1, 4):
        next_state, reward, terminated, _ = env_demo.step(0)
        print(i, "循环状态:", state, "环境状态:", env_demo.current_state,
              "奖励:", reward, "结束:", terminated)
        # 故意不更新 state,也不在 terminated 时退出
except RuntimeError as exc:
    print(f"第 {i} 次调用报错:{exc}")

# 正确写法:未结束时更新循环变量,结束时退出
state = env_demo.reset()
while True:
    next_state, reward, terminated, _ = env_demo.step(0)
    print("当前状态:", state, "奖励:", reward)
    if terminated:
        break
    state = next_state
第 1 次调用 step:reward=+0.0  terminated=False  next_state=1,但循环变量 state 仍然是 0
第 2 次调用 step:reward=+2.0  terminated=True   next_state=None,但循环变量 state 仍然是 0
第 3 次调用 step:环境报错——当前回合已经结束,请先调用 reset()
环境内部会自行前进,循环变量却仍是 $0$。这个反例固定执行动作 $0$,第二次调用仍能到终点拿到奖励 $2$;第三次报错的直接原因是终止后没有退出。若改为把 state 输入策略网络,旧状态还会导致网络依据错误的观测选动作。这是两个需要分别处理的问题。
5. 实际运行结果
两条路线的回报口径
折扣因子 gamma = 0.9
长路线(动作0 → 状态1 → 终点)
    奖励序列:[0.0, 2.0]
    不折扣实际回报:2.000
    折扣回报:      1.800
短路线(动作1 直接结束)
    奖励序列:[1.0]
    不折扣实际回报:1.000
    折扣回报:      1.000
训练过程(每 200 局打印一次)
第    1 局  起点动作概率:[动作0=0.599, 动作1=0.401]  起点 V(s):-0.257
第  200 局  起点动作概率:[动作0=0.998, 动作1=0.002]  起点 V(s):1.628
第  400 局  起点动作概率:[动作0=0.999, 动作1=0.001]  起点 V(s):1.803
第 1000 局  起点动作概率:[动作0=1.000, 动作1=0.000]  起点 V(s):1.799
            最近 100 步平均 Actor loss:+0.0000   平均 Critic loss:0.0000
两条损失的量级变化可以对照着看:第 1 局附近 Actor loss 约 $+0.62$、Critic loss 约 $2.11$;到第 400 局两条都接近 $0$。由于 $-\log\pi(a\mid s)\geq0$,Actor loss 的符号由 advantage 决定,优势为负时损失可以为负;Critic loss 是平方误差,恒非负。两种损失承担不同职责,不能直接比较大小判断谁学得更好。
单局逐步追踪(训练后,$\delta$ 已接近 $0$)
第 1 步:状态=0  动作=0  动作概率=[1.0, 0.0]
    reward=+0.00  累计 return=+0.00  terminated=False
    V(s)=+1.7990  V(s_next)=+1.9993  td_target=+1.7994
    advantage=+0.0003  actor_loss=+0.0000  critic_loss=0.00000
第 2 步:状态=1  动作=0  动作概率=[0.9939, 0.0061]
    reward=+2.00  累计 return=+2.00  terminated=True
    V(s)=+1.9993  V(s_next)=+0.0000  td_target=+2.0000
    advantage=+0.0007  actor_loss=+0.0000  critic_loss=0.00000
对照一个刚初始化、还没训练的网络跑同一局:
第 1 步:状态=0 动作=0  reward=+0.00  V(s)=+0.3468  td_target=+0.3612  advantage=+0.0143
第 2 步:状态=1 动作=1  reward=+2.00  V(s)=+0.4013  td_target=+2.0000  advantage=+1.5987
训练前 $V(s)$ 离 $1.8$ 很远、advantage 也不接近 $0$。训练做的就是让 Critic 把 $V(s)$ 拉到折扣回报附近,让 Actor 把长路线的概率推高。
评估与轨迹断言
起点最终动作概率:[动作0=1.000, 动作1=0.000]
起点最终价值 V(s):1.799
贪心测试平均实际回报(未折扣):2.000
贪心测试选择长路线的比例:100.0%
一条贪心轨迹:[(0, 0, 0.0), (1, 0, 2.0)]

轨迹检查通过:从起点出发、经过中间状态、在终点结束。
终止语义检查通过:回合结束后继续 step 会报错,必须先 reset()。
额外一局评估前后参数是否保持不变:True
参数快照取在 100 局评估之后,上述参数断言实际覆盖随后额外运行的一局。概率显示为 $1.000$ 是保留三位小数的结果,不代表其他动作的概率严格为零。
五项对照
| 指标 | 这次的值 | 含义 |
|---|---|---|
| 长路线折扣回报(理论值) | $1.800$ | 策略趋向长路线时,起点价值趋近此值 |
| 起点 $V(s)$(训练后估计) | $1.799$ | Critic 输出 |
| 不折扣实际回报(测试平均) | $2.000$ | 奖励直接相加 |
| 起点动作 0 的概率 | $1.000$ | Actor 输出 |
| 长路线比例(贪心 100 局) | $100\%$ | 轨迹统计 |
这五项分别描述回报、价值估计、动作概率和实际路线。结合起来可以看出:Actor 偏向长路线,Critic 的价值靠近 $1.8$,贪心轨迹经过中间状态后到达终点。
6. 常见误区
log_prob取成概率最大动作的对数概率。 它对应本次实际采样到的动作;概率分布是 $[0.8, 0.2]$ 而实际抽到动作 1 时,要取 $\log 0.2$。- 终止转移的 target 再乘一次 $\gamma$。 终止时 $y=r$;写成 $\gamma r$ 就把当前奖励也打了折。
- 忘记
state = next_state。 环境内部仍会前进,但策略网络接收到的是旧状态,记录的轨迹也会错误;结束后还要及时break。 - 把 advantage 的符号与奖励正负混为一谈。 即时奖励为 $-1$ 时 advantage 仍可能为正:$\delta=-1+V(s’)-V(s)$,只要下一状态估值足够高。
- 把本例训练采样改成
argmax。 本例的随机策略梯度依赖按策略分布采样;总选最大概率动作可能让另一条路线不再被尝试。这里用贪心评估观察所学路线,随机策略本身也可以通过采样评估。 - 把整局回报当成单步优势。 本节用单步 TD 误差 $y-V(s)$;原始 REINFORCE 用整局回报 $G_t-b(s_t)$,两者是不同的优势估计。
- 以为
detach()会改变数值。 它只切断梯度路径,数字不变。 - 把
critic_loss当评估指标。 它是训练用的平方误差,与测试回报不是同一个量。 - $V(s)$ 与
episode_return混用。 一个是折扣期望、一个是未折扣实际值,$1.8$ 与 $2.0$ 的差别不是误差。 - 把”一步一更新”当成 PPO。 本节没有多步回报、没有 GAE、没有概率比值裁剪、没有批量采样后多轮更新。