Day1 · 从奖励、回报到 Q-learning 与 SARSA
前言:这次实际解决的问题
那我们就入门一下强化学习这个深奥玄妙的领域吧!
这一节围绕三个可核对的问题展开:
- 把”奖励”和”回报”分开,并知道第一步的负分怎样被后续收益抵消;
- 把一次 Q 表更新拆成
future、target、TD 误差三个可打印的量; - 看清 Q-learning 与 SARSA 的唯一分叉点:target 里的”下一步”取哪个值。
验收看三处:Q-learning 与 SARSA 的 target 是否分清,悬崖环境是否真的走到终点,终止转移是否停止读取未来价值。
1. 先用最小例子理解概念
从一个只有两条路线的例子入手:
路线 A:起点 → 普通格 ×6 → 终点     共 7 步
路线 B:起点 → 普通格 ×8 → 终点     共 9 步

普通格奖励 = -0.04      终点奖励 = +1
两条路线的终点奖励相同,区别只在中间的普通格数量。第一个要建立的区分就在这里:
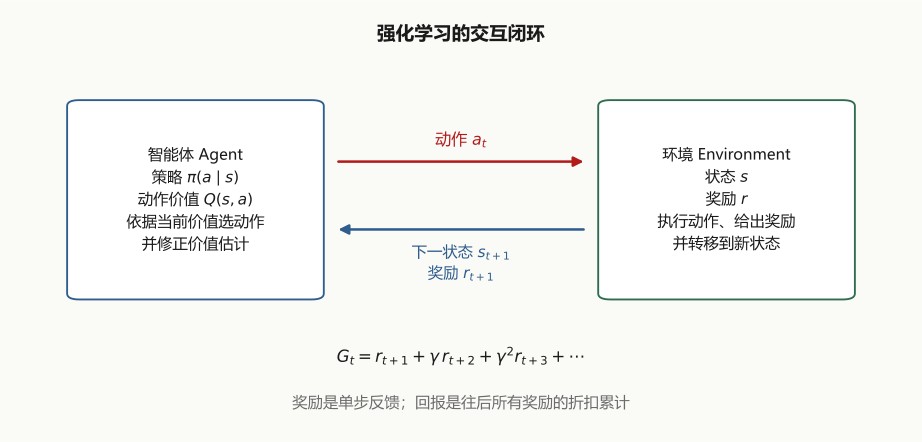
- 奖励是单步反馈:走一格扣 $0.04$,到终点得 $+1$;
- 回报是从某个时刻起往后所有奖励的总量:A 路线是 $6\times(-0.04)+1=0.76$。
于是”第一步是负分”不再矛盾:$-0.04$ 那一步本身是亏的,但它把智能体接上了后面 $+1$ 的收益。用折扣因子 $\gamma$ 表示”未来打折”,回报就有了递推写法:
\[G_t = r_{t+1} + \gamma G_{t+1}\]这条式子是后面所有更新的骨架:一次更新只需要当前奖励和下一状态的价值,不必等整条轨迹算完。
再往下需要三个词:
- 策略 $\pi$:看到状态后怎么选动作的规则;
- 动作价值 $Q(s,a)$:在状态 $s$ 做动作 $a$ 大概能拿多少总分;
- 学习率 $\alpha$:一次更新走多大幅度。它不是覆盖式的——新估计 = 旧估计 + $\alpha\times$(这次的目标 − 旧估计),旧经验仍占一部分。
2. 变量和公式逐步对应
Q-learning 与 SARSA 共用同一个更新外形:
\[Q(s,a)\leftarrow Q(s,a)+\alpha\big(\underbrace{\text{target}}_{y}-Q(s,a)\big)\]括号里的部分叫 TD 误差:这次的目标比原来的估计高还是低。两个算法的差别只在 target:
\[\begin{aligned} \text{Q-learning:}\quad & y = r+\gamma\max_{a'}Q(s',a') \\ \text{SARSA:}\quad & y = r+\gamma\,Q(s',a') \end{aligned}\]- Q-learning 假设下一步会挑当前估计最好的动作,即使实际没走那一步;
- SARSA 只用行为策略实际选中的下一个动作 $a’$ 的价值。
对应到代码里的三个中间变量:
| 变量 | 算式 | 含义 |
|---|---|---|
future |
下一状态的最大 Q 值(终止时 0) | 对”以后还能拿多少”的当前估计 |
target |
reward + gamma * future |
这一步希望 Q 值靠近的数 |
td_error |
target - q_old |
正数表示原来低估,负数表示原来高估 |
3. 手算一个具体数值
第一组:两条路线的回报。
A:6 × (-0.04) + 1 = 0.76
B:8 × (-0.04) + 1 = 0.68
A 路线更优,靠的是更少的步数成本,不需要”终点奖励特别大”这个额外假设。若按 $\gamma=0.9$ 打折,两条路线的差距会被放大(A 约 $0.344$、B 约 $0.203$),排序不变。
第二组:一次更新走一半。 设 $Q(S,A)$ 原来是 $0$,执行 $A$ 后直接到终点拿到 $+1$,学习率 $\alpha=0.5$:
target   = 1 + 0.9 × 0 = 1
td_error = 1 - 0 = +1
Q_new    = 0 + 0.5 × 1 = 0.5
新估计没有直接跳到 $1$,而是停在旧估计和新经验的中点。$\alpha=1$ 时才会一步跳到 $1$。
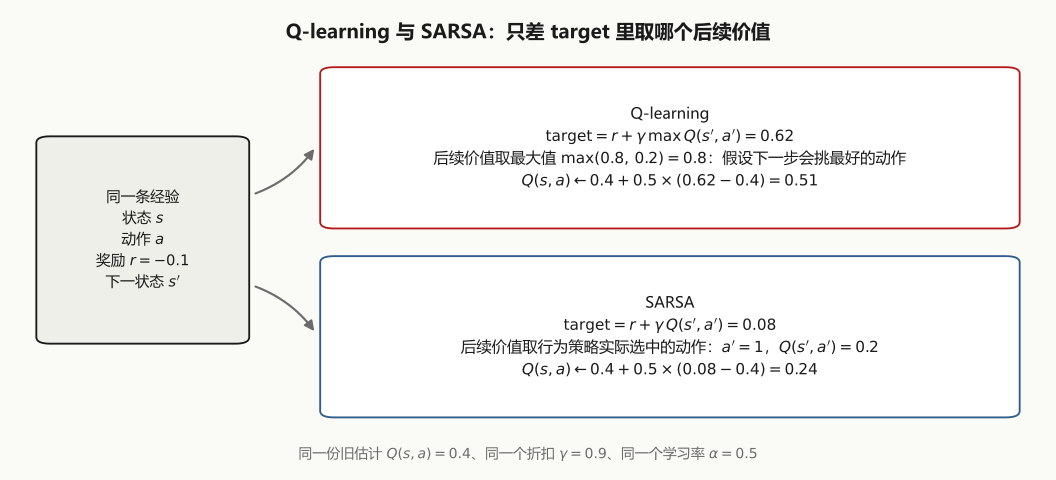
第三组:非终止转移。 设 $Q(s,a)=0.4$、$r=-0.1$、$\gamma=0.9$、下一状态的两个动作价值是 $[0.8,\,0.2]$、实际选中第二个动作、$\alpha=0.5$:
| 量 | Q-learning | SARSA |
|---|---|---|
| 后续价值 | $\max(0.8,0.2)=0.8$ | $Q(s’,a’{=}1)=0.2$ |
| target | $-0.1+0.9\times0.8=0.62$ | $-0.1+0.9\times0.2=0.08$ |
| TD 误差 | $+0.22$ | $-0.32$ |
| 新 $Q$ | $0.51$ | $0.24$ |
同一个旧估计 $0.4$,Q-learning 把它往上推,SARSA 把它往下压。差别来自这次实际选的是价值只有 $0.2$ 的动作,而 Q-learning 只认最大值 $0.8$。
4. 关键代码逐段解释
这一节的代码分两组实验:先在只有“起点”和“中途”两个状态的小世界里训练 Q 表,再换到 $4\times6$ 的悬崖网格。第 4.1 节可单独运行;第 4.2 节第一块是循环内的更新片段;第 4.3 节是独立的数值比较;第 4.4 至 4.6 节需要按顺序运行,依次定义环境、训练 Q 表、输出完整轨迹。
4.1 两状态小世界:Q 表训练循环
起点有两个动作:A 一步到终点拿 $+1$;B 先拿 $0$ 到中途,再走一步拿 $+2$。Q 表就是一个字典,每个状态对应一组动作价值:
import random

# 固定随机数生成器,重复运行时探索到的动作顺序一致。
rng = random.Random(7)

q = {"起点": [0.0, 0.0], "中途": [0.0]}  # 起点动作 0=A、1=B
alpha, gamma, epsilon = 0.2, 0.9, 0.2

for epoch in range(400):
    state = "起点"
    while True:
        actions = range(len(q[state]))
        if rng.random() < epsilon:
            action = rng.choice(list(actions))                  # 探索
        else:
            action = max(actions, key=lambda a: q[state][a])    # 利用

        # 环境转移:A 立即得 1;B 先得 0,到中途后继续得 2
        if state == "起点" and action == 0:
            reward, next_state, terminated = 1.0, None, True
        elif state == "起点":
            reward, next_state, terminated = 0.0, "中途", False
        else:
            reward, next_state, terminated = 2.0, None, True

        future = 0.0 if terminated else max(q[next_state])
        target = reward + gamma * future
        q[state][action] += alpha * (target - q[state][action])

        if terminated:
            break
        state = next_state
整段代码的核心是最后三行计算,它们和第 2 节的公式一一对应:future 是 $\max_{a’}Q(s’,a’)$,target 是 $r+\gamma\cdot$future,+= 那一行就是 $Q\leftarrow Q+\alpha(y-Q)$。terminated 为真时 future 直接取 $0$,这是“终止之后没有未来”的代码写法。
400 回合后 $Q(\text{起点},B)\approx1.8$ 高于 $Q(\text{起点},A)\approx1.0$:B 那一步的即时奖励是 $0$,价值全部来自折扣后的未来 $0.9\times2$。
4.2 拆开一次更新:把中间量存下来
训练循环里的 += 把三步压成了一行。下面是替换循环中更新语句的片段,需要放在取得 reward、next_state 和 terminated 之后运行;它本身不负责选择动作或推进环境:
q_old = q[state][action]
future = 0.0 if terminated else max(q[next_state])
target = reward + gamma * future
td_error = target - q_old
q[state][action] = q_old + alpha * td_error
运行结果(见第 5 节)里两步的 td_error 保留四位小数后都是 $0$,说明这两步的目标与估计已经很接近。显示为零不等于误差严格为零,也不能据此证明所有状态都已收敛。下面独立计算训练开始时的一次终止更新:起点执行 A,拿到 $1$,回合结束。
q_start = [0.0, 0.0]
gamma = 0.9
action, reward, terminated = 0, 1.0, True
future = 0.0 if terminated else float("nan")
target = reward + gamma * future            # 1.0
td_error = target - q_start[action]         # +1.0
alpha_demo = 0.5
q_new = q_start[action] + alpha_demo * td_error   # 0.5
这就是第 3 节“一次更新走一半”的代码版。
4.3 Q-learning 与 SARSA:只差一行
old_q, reward, gamma, alpha = 0.4, -0.1, 0.9, 0.5
next_q = [0.8, 0.2]
actual_next_action = 1   # 假设探索实际选中了第二个动作

q_learning_target = reward + gamma * max(next_q)
sarsa_target      = reward + gamma * next_q[actual_next_action]

q_learning_new = old_q + alpha * (q_learning_target - old_q)
sarsa_new      = old_q + alpha * (sarsa_target - old_q)
两个算法的全部差别就是 target 那一行:max(next_q) 还是 next_q[actual_next_action]。更新公式、学习率、旧估计完全相同,结果却一个往上推到 $0.51$、一个往下压到 $0.24$。
4.4 悬崖环境:step() 定义了全部规则
网格 4 行 6 列,起点在左下角 $(3,0)$、终点在右下角 $(3,5)$,中间 4 格是悬崖。状态用一维编号 row * COLS + col 表示,起点是 $18$、终点是 $23$:
import random

ROWS, COLS = 4, 6
START = (3, 0)
GOAL = (3, 5)
CLIFF = {(3, 1), (3, 2), (3, 3), (3, 4)}

# 0=上,1=下,2=左,3=右
ACTIONS = [(-1, 0), (1, 0), (0, -1), (0, 1)]   # 0=上 1=下 2=左 3=右
ARROWS = ["↑", "↓", "←", "→"]
STEP_REWARD, CLIFF_REWARD, GOAL_REWARD = -0.04, -1.0, 1.0
N_STATES = ROWS * COLS
N_ACTIONS = len(ACTIONS)
MAX_STEPS = 100

def state_id(cell):
    row, col = cell
    return row * COLS + col

def step(state, action):
    row, col = divmod(state, COLS)
    d_row, d_col = ACTIONS[action]
    # min/max 把坐标卡在网格内:撞墙就停在原地
    next_row = min(max(row + d_row, 0), ROWS - 1)
    next_col = min(max(col + d_col, 0), COLS - 1)
    next_cell = (next_row, next_col)
    next_state = state_id(next_cell)

    if next_cell == GOAL:
        return next_state, GOAL_REWARD, True
    if next_cell in CLIFF:
        return next_state, CLIFF_REWARD, True
    return next_state, STEP_REWARD, False
训练前先逐项验证这个函数,每一项都用 assert 写死预期:
| 检查 | 结果 |
|---|---|
| 起点 / 终点状态编号 | $(3,0)\rightarrow18$,$(3,5)\rightarrow23$ |
| 悬崖格 | $(3,1)$ 到 $(3,4)$ 共 4 格,夹在起点与终点之间 |
| 普通移动 | 奖励 $-0.04$,terminated=False |
| 越界(撞墙) | 停在原地、奖励 $-0.04$、回合继续 |
| 到达终点 | 奖励 $+1$,terminated=True |
| 掉进悬崖 | 奖励 $-1$,terminated=True |
| 终止语义 | 终止后不存在未来价值,future 必须取 $0$ |
环境没错,训练才有意义。否则策略学歪了,分不清是算法的问题还是规则写错了。
4.5 悬崖环境的训练循环
更新规则和两状态小世界完全一样,多出来的只有 $\varepsilon$ 衰减和步数上限:
rng = random.Random(7)  # 这是新的实验,重新固定探索序列
q = [[0.0 for _ in range(N_ACTIONS)] for _ in range(N_STATES)]

def choose_action(q_row, epsilon):
    if rng.random() < epsilon:
        return rng.randrange(N_ACTIONS)
    return max(range(N_ACTIONS), key=lambda action: q_row[action])

alpha, gamma = 0.5, 0.95
epsilon_start, epsilon_min, num_episodes = 0.2, 0.02, 3000

for episode in range(num_episodes):
    state = state_id(START)
    # 前期多试错,后期更多利用已学到的 Q 值
    epsilon = max(epsilon_min,
                  epsilon_start - (epsilon_start - epsilon_min) * episode / num_episodes)

    for _ in range(MAX_STEPS):                      # MAX_STEPS = 100
        action = choose_action(q[state], epsilon)  # ε-greedy
        next_state, reward, terminated = step(state, action)

        future = 0.0 if terminated else max(q[next_state])
        target = reward + gamma * future
        q[state][action] += alpha * (target - q[state][action])

        state = next_state
        if terminated:
            break
choose_action 以概率 $\varepsilon$ 随机选动作,否则选当前 Q 值最大的动作;并列时 max 返回编号最小的那个。
4.6 用贪心策略走一条完整轨迹
策略图只显示每个格子各自的推荐动作,回答不了“从起点出发到底有没有走到终点”。所以训练后关掉探索,真走一遍:
def run_greedy_trajectory(q):
    trajectory, state, total_return = [], state_id(START), 0.0
    for step_index in range(1, MAX_STEPS + 1):
        action = max(range(N_ACTIONS), key=lambda a: q[state][a])   # 只利用,不探索
        next_state, reward, terminated = step(state, action)
        total_return += reward
        trajectory.append({"step": step_index,
                           "cell": divmod(state, COLS), "action": action,
                           "next_cell": divmod(next_state, COLS), "reward": reward,
                           "terminated": terminated, "total": total_return})
        state = next_state
        if terminated:
            break
    return trajectory

trajectory = run_greedy_trajectory(q)
for row in trajectory:
    print(row)
last = trajectory[-1]
reached_goal = last["next_cell"] == GOAL and last["terminated"]
entered_cliff = any(row["next_cell"] in CLIFF for row in trajectory)
assert reached_goal, "贪心轨迹没有真正到达终点,请检查训练结果"
assert not entered_cliff, "贪心轨迹经过了悬崖,与预期策略不符"
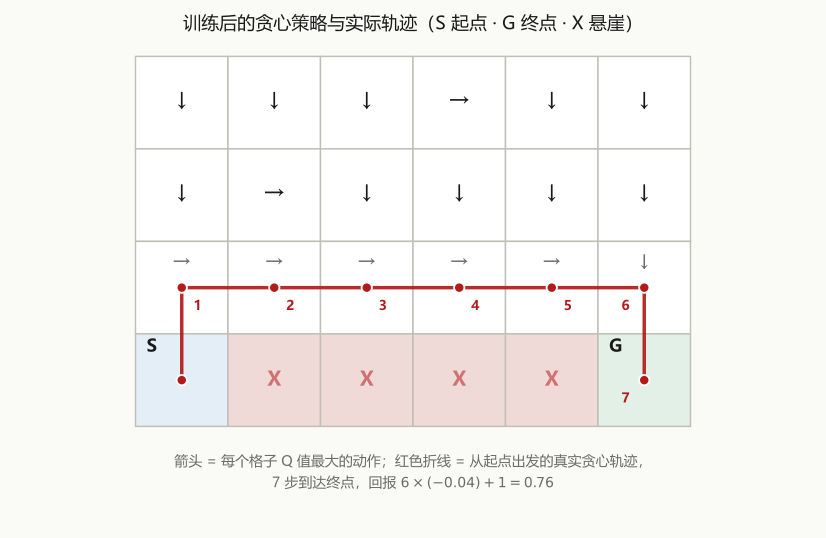
最后两条 assert 就是这一节的验收标准:最后一步踩在终点并且回合结束,整条路径不经过悬崖。下图是训练后的策略和这条轨迹:
5. 实际运行结果
两状态小世界(400 回合后):
Q(起点, A)    = 1.0      动作 A 一步得 1,之后没有未来
Q(起点, B)    = 1.8      0 + 0.9 × 2,单步奖励为 0 反而更值钱
Q(中途, 继续) = 2.0      唯一的路,走一步拿 2
一局贪心轨迹(训练后):
第 1 步 状态=起点  动作=1  q_old=1.8000  reward=0.00  future=2.0000
        target=1.8000  td_error=+0.0000  q_new=1.8000  terminated=False
第 2 步 状态=中途  动作=0  q_old=2.0000  reward=2.00  future=0.0000
        target=2.0000  td_error=+0.0000  q_new=2.0000  terminated=True

这一局的未折扣实际回报 = 2.00
单步对照实验:
Q-learning: 0.6200000000000001  0.51
SARSA:       0.08000000000000002 0.24000000000000002

Q-learning 的 TD 误差:  0.22
SARSA      的 TD 误差: -0.32
两个 target 的差: 0.54      两个新 Q 值的差: 0.27
悬崖环境(3000 回合后):
学到的贪心策略:
↓ ↓ ↓ → ↓ ↓
↓ → ↓ ↓ ↓ ↓
→ → → → → ↓
S X X X X G

第  1 步:(3, 0) --↑--> (2, 0)  reward=-0.04  累计=-0.04  terminated=False
第  2 步:(2, 0) --→--> (2, 1)  reward=-0.04  累计=-0.08  terminated=False
第  3 步:(2, 1) --→--> (2, 2)  reward=-0.04  累计=-0.12  terminated=False
第  4 步:(2, 2) --→--> (2, 3)  reward=-0.04  累计=-0.16  terminated=False
第  5 步:(2, 3) --→--> (2, 4)  reward=-0.04  累计=-0.20  terminated=False
第  6 步:(2, 4) --→--> (2, 5)  reward=-0.04  累计=-0.24  terminated=False
第  7 步:(2, 5) --↓--> (3, 5)  reward=+1.00  累计=+0.76  terminated=True

总步数:7
本局回报:+0.760
最后一步是否踩到终点并结束回合:True
轨迹中是否经过悬崖:False
成功率: 100.0%      平均回报: 0.760
轨迹和平均回报一致,是因为环境和贪心动作都是确定性的。当前环境测一局就能得到同样的结果;代码仍保留多局评估接口,方便以后接入随机转移、随机起点或带噪声奖励的环境。
6. 常见误区
- 把单步奖励当成动作好坏。 起点选 B 那一步奖励是 $0$,但它的 $Q$ 值最高($1.8$)。动作好坏由”这一步 + 后续”决定。
- 混淆一次回报与期望回报。 一条实际轨迹产生回报 $G$;动作价值 $Q$ 估计的是后续回报的期望。环境和后续策略都确定时,只有一种结果,期望就等于这条轨迹的回报,因此这里用“期望”也成立。
- TD target 当成标准答案。 target 是用当前估计搭出来的,它自己也会随训练变化。
- 以为取了
max就一定变大。 变不变取决于 TD 误差的符号:SARSA 那次 TD 误差为 $-0.32$,Q 值被压低。 max与argmax混用。max返回值(构造 target 用),argmax返回动作编号(选动作用)。一次更新里两者都会出现。- 乘方与乘法记号。 Python 里
0.6**0.9是乘方(约 $0.632$);折扣项要写0.6 * 0.9。例如 target 为-0.1 + 0.6 * 0.9 = 0.44,新估计为0.4 + 0.5 * (0.44 - 0.4) = 0.42。 - 以为小环境里 SARSA 和 Q-learning 必有差别。 只有一条后续动作时,$\max$ 和”实际选中”取到同一个值,两者合流。
- 终止后继续 bootstrap。
terminated=True时future取 $0$ 是语义要求,不是”下一格价值恰好为 0”。 - 越界当成额外惩罚。 撞墙后停在原地、拿普通步奖励,代价只是白走一步并扣 $0.04$。
- 未访问格子的箭头当成有依据。 没走过的格子 Q 值可能全是初值 $0$,此时
max按编号最小选中动作,箭头表示”没学过”而不是”学过的最好选择”。