· 多智能体 / 强化学习 / PPO / 综述 / 信用分配 / 奖励设计
Day13:把论文放回地图——MARL + LLM 的两条主线与一个汇聚层
从基础术语和 PPO 出发,理解语言智能体、多智能体强化学习,以及奖励与信用分配之间的关系。
前言:三篇论文读完了,地图还没拼起来
既然原本的课题结束了,那就正好投身于新的一轮研究吧。
之前把导师给的三篇论文看了一下,发现自己对很多东西都不了解:无论是技术细节,还是对强化学习这个领域目前的研究进展。
于是启动codex神力,让它帮我搜集论文总结该领域的研究。多库检索、开放全文下载、逐页文本抽取、发展树与时间线,最后落到一份中文综述和一份「LLM 角色说明」。本地归档 150 篇全文、130 条核心文献、75 个关键节点——codex牛逼!
0. 先理解术语
设想两个机器人共同搬运箱子。它们需要观察周围、决定移动方向,在合作失败后调整行为。把机器人换成「分析需求的语言智能体」和「编写代码的语言智能体」,决策形式变了,但仍然有观察、行动、反馈和协作的问题。
0.1 LLM、agent、RL 和 MARL 分别是什么
LLM(大语言模型)根据输入上下文预测并生成后续 token。token 是模型处理的文本单位,可能是字、词的一部分或标点,不等同于一个汉字。模型能生成回答、计划和工具调用文本,但完成任务还需要外部程序执行工具、传回结果、维护上下文。
Agent(智能体)是持续接收信息、作出决策并影响环境的主体。一个语言智能体通常由 LLM、上下文或记忆、工具接口和控制循环组成。例如,模型提出运行测试,程序执行测试,再把报错送回模型继续修改代码。单次生成一段文字与这种闭环交互的区别,在于是否持续根据环境反馈行动。
RL(强化学习)利用行动后获得的奖励调整策略,使长期回报更高。MARL(多智能体强化学习)研究多个决策主体相互影响时的学习,既包括合作,也包括竞争和混合关系。多 agent 系统可以完全不训练参数;有多个角色对话,也不自动意味着使用了 MARL。
同一个基础模型可以支撑多个 agent:只要各主体维护自己的上下文或决策过程,并通过消息、工具或共享环境相互影响,就可以构成多智能体系统。是否共享模型权重与是否存在多个智能体,是两个问题。至于开五个会话是否比单个智能体有效,需要另做预算相当的实验。
0.2 状态、观测、动作与策略
在搬箱子例子中,状态 state 可以包括所有机器人的位置、箱子重量和障碍物分布;观测 observation 是某个机器人实际能看到的部分,例如局部摄像头画面。动作 action 是它能执行的选择,例如向前移动或抓取。状态描述环境,观测描述主体拿到的信息,二者在部分可观测任务中并不相同。
策略 policy 是根据已有信息选择动作的规则,常写作:
\[\pi_\theta(a\mid o).\]这里的 $\theta$ 是模型参数,$\pi_\theta(a\mid o)$ 是看到观测 $o$ 后选择动作 $a$ 的概率。策略可以是神经网络,也可以是规则。部分可观测任务通常还需要历史信息 $h_t$,实际使用的是 $\pi_\theta(a_t\mid h_t)$,而不仅是当前画面。
对于 LLM,输入信息可以是任务、对话历史和工具返回值,动作可以按 token、整段回复或一次工具调用定义。读公式时必须先确认动作粒度:一个 token 的概率和一整段回复的概率不是同一个量。
训练 training 更新参数;推理 inference 使用当前参数产生输出。增加提示词、保存反思记录、扩充上下文,可以改变后续行为,但这些操作本身不等于梯度训练。后文的「被训练对象」指实际接受参数更新的模型或模块。
0.3 奖励与回报:眼前得分和长期收益
奖励 reward 是某一步得到的反馈,记为 $r_t$。例如搬运成功得到 10 分,每次碰撞扣 1 分。回报 return 把之后的奖励累计起来:
\[G_t=\sum_{k=0}^{T-t-1}\gamma^k r_{t+k},\]其中 $T$ 是任务结束时刻,$\gamma$ 是折扣因子。取 $\gamma=0.9$,未来依次得到 0、0、10 分,那么当前回报为 $0+0.9\times0+0.9^2\times10=8.1$。这是一条实际轨迹的回报;对可能的后续轨迹求平均,才得到期望回报。
只有任务结束才给分,称为稀疏奖励;每步根据接近目标等进展给分,称为稠密奖励。稠密信号更容易指导学习,也可能诱导钻空子:机器人反复靠近目标刷分,却始终不完成搬运。这类优化代理分数、偏离真实任务的行为称为 reward hacking(奖励投机)。
团队得到一个总分之后,还要回答「哪个主体的哪次行动促成了结果」。这就是 credit assignment(信用分配)。这里的信用指贡献归属,不是可信度评分。
0.4 一段交互到底有多长
| 术语 | 含义 | 代码智能体例子 |
|---|---|---|
| trajectory,轨迹 | 按时间排列的观测、动作、奖励等记录,可以是完整任务也可以是片段 | 查看代码、编辑、运行测试及各步反馈 |
| rollout,采样交互 | 用某个策略与环境交互来收集轨迹的过程,也常指收集到的片段或批次 | 用当前模型实际跑一批修复任务 |
| episode,完整任务回合 | 从任务初始化到结束的一次完整交互 | 从接到 issue 到通过测试、失败或超时 |
| turn,对话轮次 | 协议定义的一次发言或交互轮,具体边界依论文而定 | 分析者发言,或一次模型与工具往返 |
| token,生成单位 | 模型逐步生成的最小文本单位 | 一次发言内部的许多个生成步骤 |
一个 episode 往往包含多个 turn,每个 turn 又包含多个 token。一次 rollout 可以在 episode 结束前截断,也可以收集多个 episode。因此,「回合级奖励」必须说明指完整任务还是对话轮次,不能把这些粒度混用。
1. 领域地图:两条主线与一个汇聚层
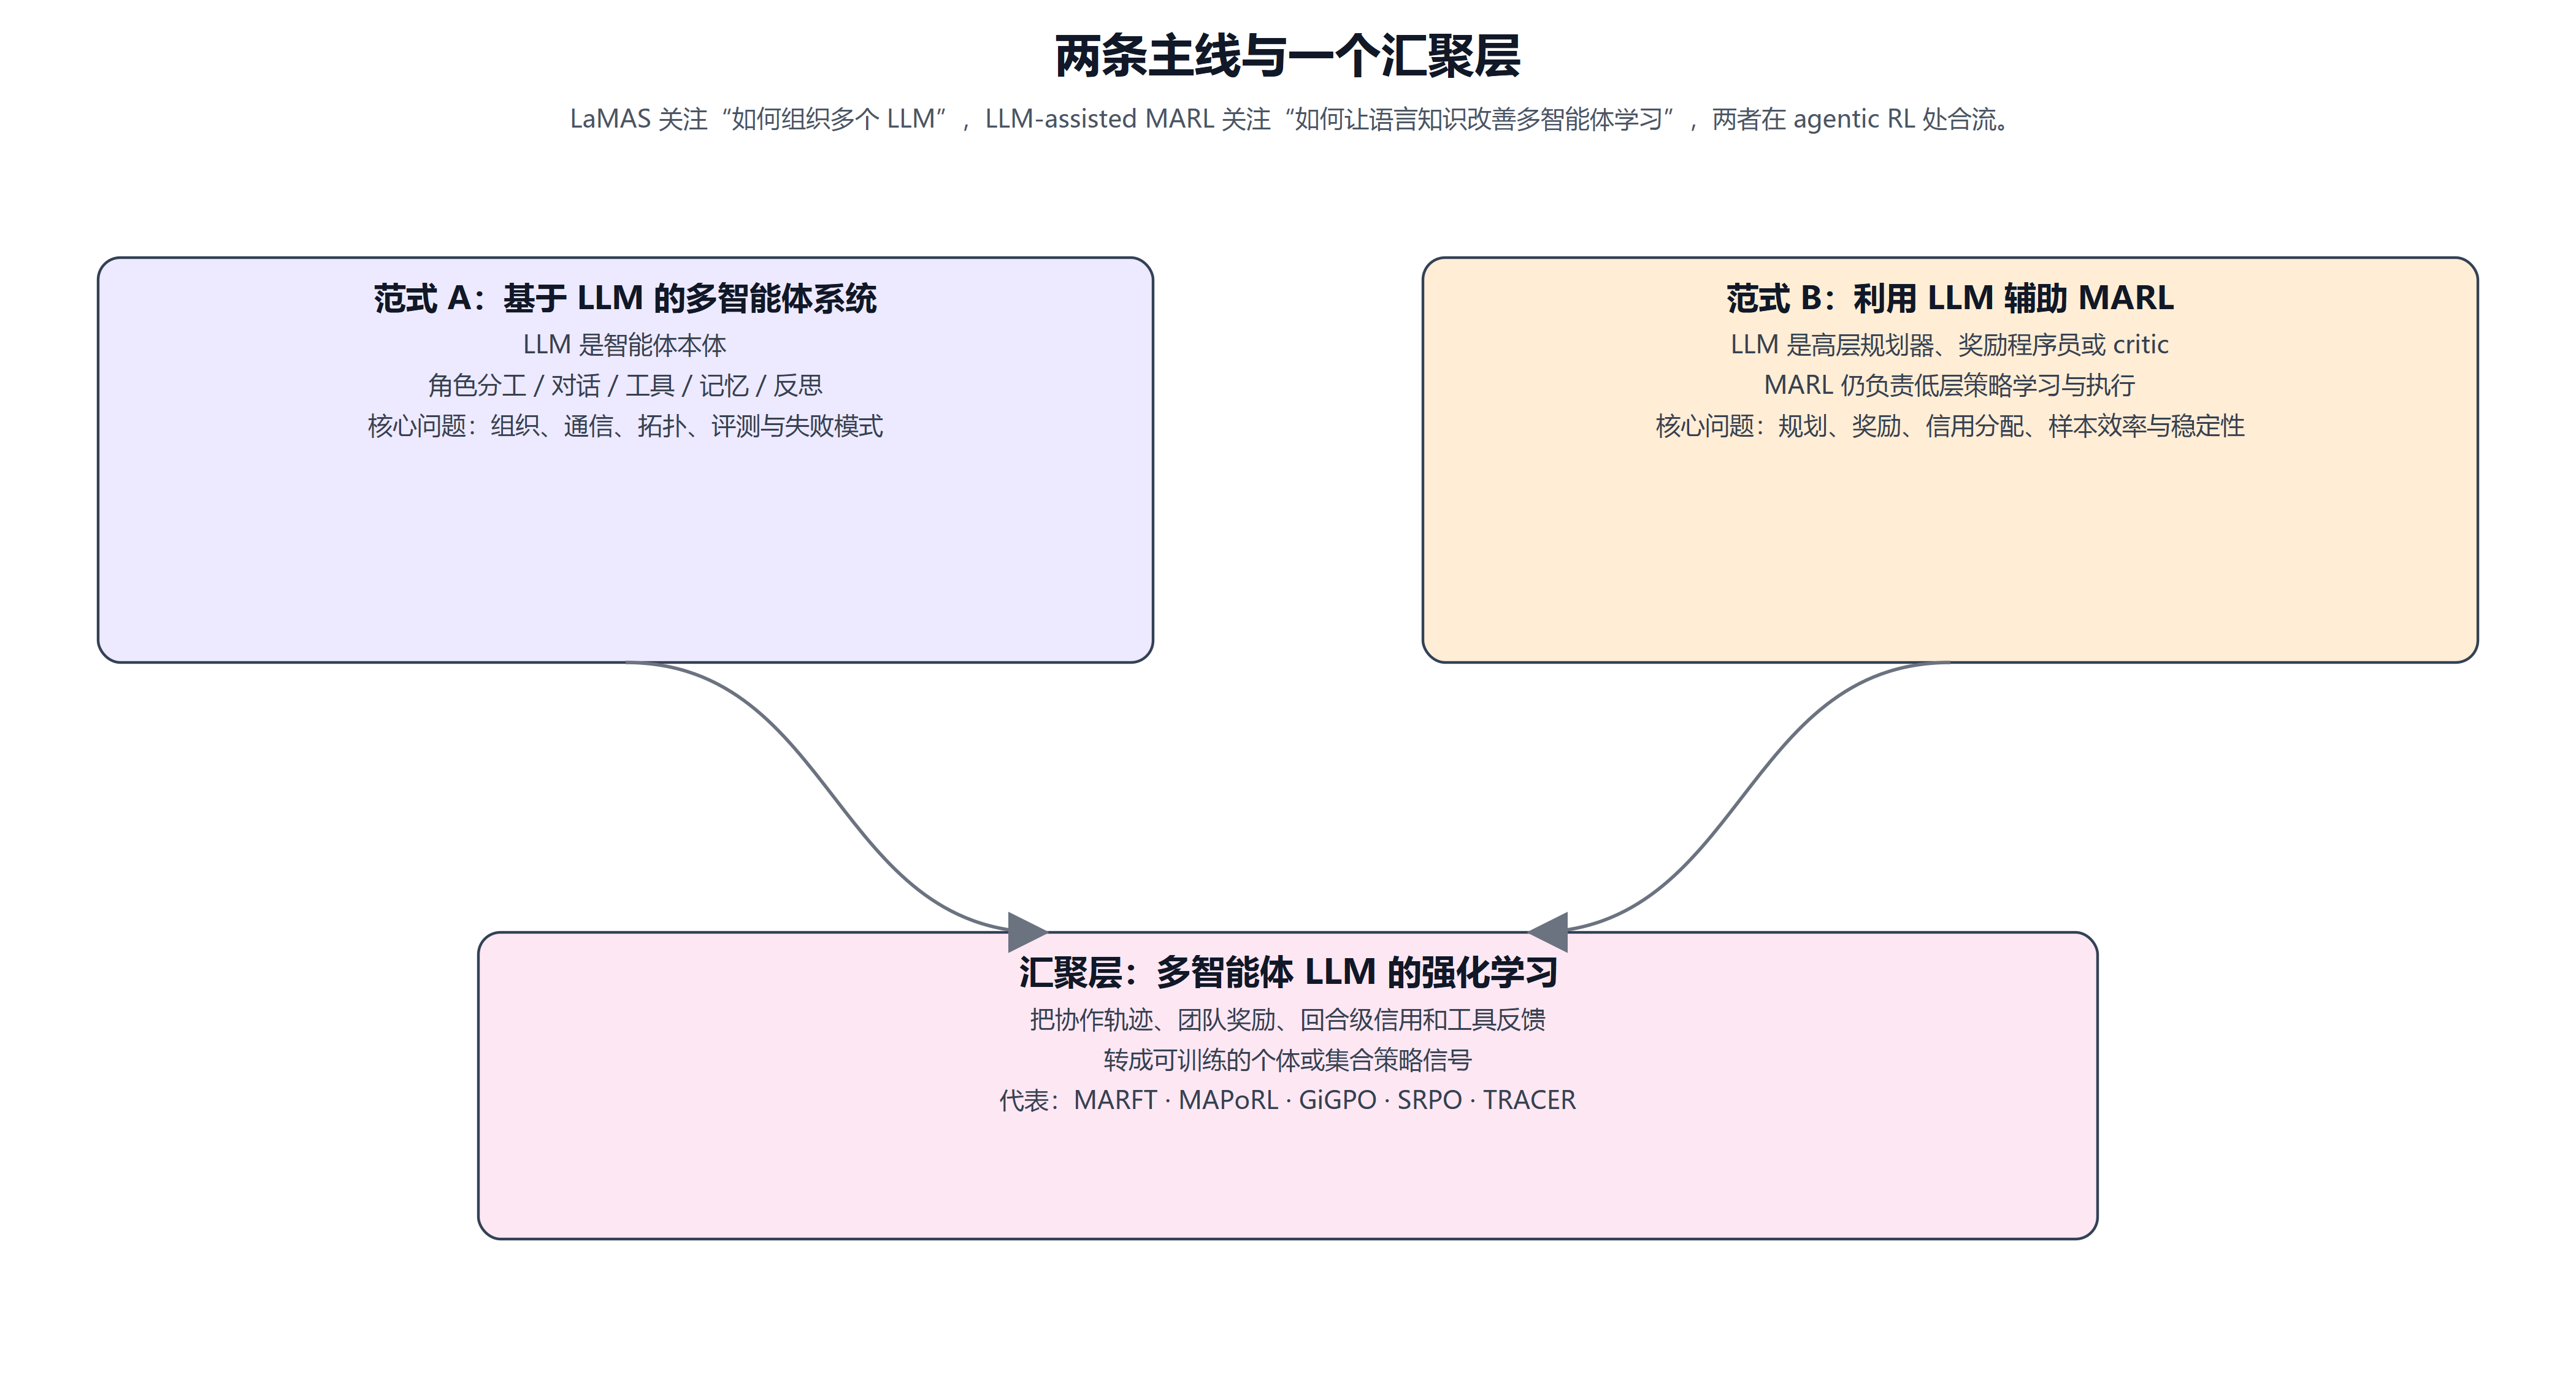
范式 A 把 LLM 作为智能体的决策核心;范式 B 用 LLM 辅助传统 MARL 的规划与学习信号。汇聚层关注多个语言智能体的强化学习。来源:综述工作区的两范式示意。图中 GiGPO 应理解为相关的多轮 agent 训练方法,不能直接列作多智能体训练证据。
1.1 主线一:怎样组织多个语言智能体
基于 LLM 的多智能体系统常简称 LaMAS。典型系统让不同主体负责规划、检索、编码或检查,再通过消息交换结果。这里的主要问题是角色怎样分工、消息传给谁、什么时候结束,以及最终结果怎样验证。
例如,分析者拆解需求,编码者完成实现,检查者运行测试。LLM 直接输出影响任务的行动,而多个主体之间的依赖由程序组织。CAMEL、AutoGen、MetaGPT、ChatDev 的原始系统主要属于这条路线,角色编排并不要求重新训练基础模型。
1.2 主线二:怎样用语言知识辅助 MARL
LLM-assisted MARL 让语言模型提供高层计划、奖励程序、贡献评价或策略建议,再由低层策略学习和执行。搬箱子时,LLM 可以提出「先共同抓取,再同步移动」,而具体速度和转向由控制策略决定。
这里最重要的区分是:LLM 输出建议,并不意味着 LLM 参数正在被训练。ReMAC 生成奖励程序,LLM-MCA 生成贡献反馈,接受强化学习更新的主要是低层策略。
1.3 汇聚层:直接训练协作中的语言策略
当语言智能体根据协作轨迹和任务奖励更新参数,研究对象就进入多个 LLM 策略的联合或协调优化。MAPoRL、MARFT、SRPO 分别探索协作训练、顺序优势分解和集合级优化。
组织多个 LLM、训练多个 LLM、用 LLM 辅助 MARL,是并行且可组合的技术路径,不是依次替代的三代历史。 一个系统可以同时用固定提示词安排角色、用奖励模型打分,再用强化学习更新部分角色的参数。
这些路径都可能遇到信用分配问题,但各自还受制于任务表示、探索、观测不足、通信和计算成本。团队最终得分无法自动说明每个成员的贡献,只是其中一项共同困难。
1.4 综述覆盖了什么
本笔记所依据的综述版本日期为 2026-09-22,记录了 177 条检索候选、150 篇归档全文、130 条核心文献和 75 个关键节点。这些数字描述本地资料集,核心文献和归档全文是不同口径。
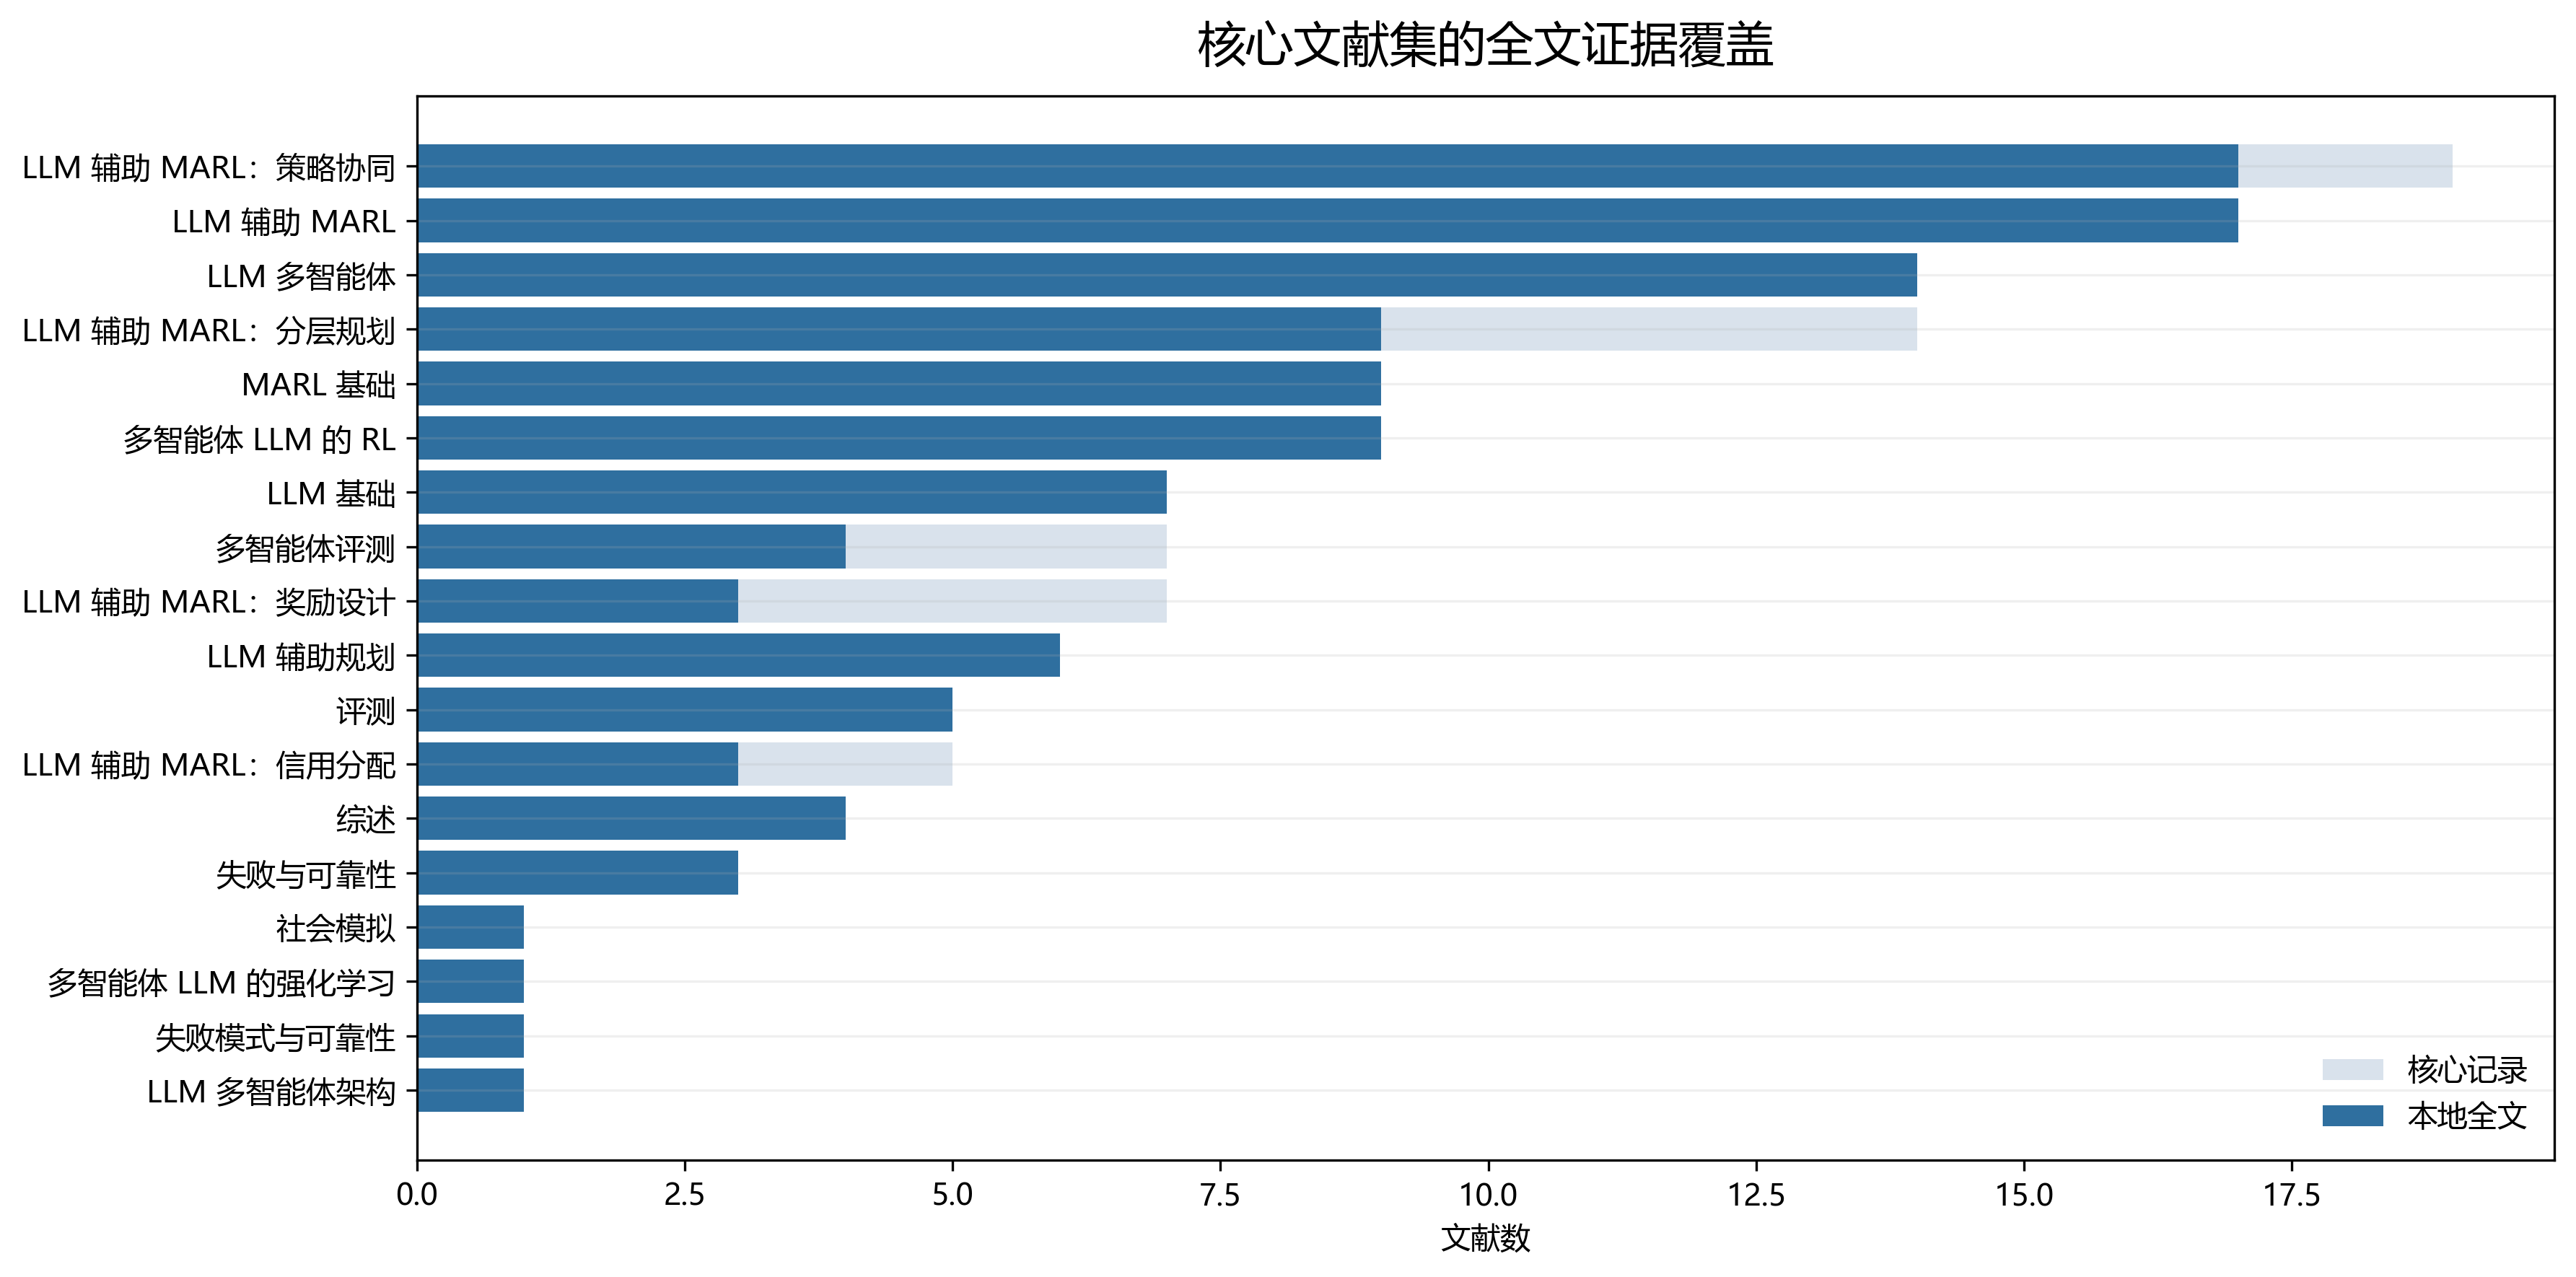
深色表示本地已有全文,浅色表示核心记录的覆盖范围。来源:综述工作区的全文覆盖统计。条目分类存在相近名称,阅读时宜把它作为资料分布,而非严格互斥的领域分类。
能下载多少全文,受检索词、分类和开放获取情况影响。判断某项结论是否可靠,需要看具体实验、对照设置和独立复现;不能由某个分支的本地文件较多,就推断该方向的科学证据更强。
2. PPO:怎样从一次尝试更新策略
PPO 是后文 MAPPO、语言模型强化学习与集合策略优化的共同背景。以下讲解的是常用的 PPO-Clip;PPO 原论文还讨论了基于 KL 惩罚的变体(Schulman et al., 2017)。
2.1 Actor 负责行动,critic 估计前景
设机器人来到一个路口,可以走左边或右边。Actor(策略网络)给出动作概率,例如左边 0.4、右边 0.6,再据此采样。Critic(价值估计器)估计当前位置或当前动作之后能获得多少长期回报,帮助判断这次行动是否比通常水平好。
有两种常见价值函数:
\[V^\pi(s)=\mathbb{E}_\pi[G_t\mid s_t=s], \qquad Q^\pi(s,a)=\mathbb{E}_\pi[G_t\mid s_t=s,a_t=a].\]- $V^\pi(s)$ 是状态价值:从这里出发,之后按策略 $\pi$ 行动,平均能拿多少分。
- $Q^\pi(s,a)$ 是动作价值:先明确做动作 $a$,之后继续按 $\pi$ 行动,平均能拿多少分。
优势 advantage 比较某个动作与当前策略在该状态下的平均水平:
\[A^\pi(s,a)=Q^\pi(s,a)-V^\pi(s).\]假设当前策略下左转的期望回报为 8,右转为 3,则 $V^\pi(s)=0.4\times8+0.6\times3=5$。左转的优势为 $+3$,右转为 $-2$。正优势表示比通常选择好,负优势表示更差;负优势并不要求动作的绝对回报为负。
实际训练通常不知道真实的 $V$ 和 $Q$。标准 PPO 常训练一个 $V_\phi$ 网络,用采样回报构造优势估计 $\hat A_t$,不必另训练一个 Q 网络。最直观的估计是 $G_t-V_\phi(s_t)$;critic 再用回报目标做回归,例如最小化预测值与目标之间的平方误差。Actor 与 critic 可以共享部分网络,也可以完全分开。
2.2 策略梯度:好动作多做一点,差动作少做一点
策略梯度用带权的对数概率梯度更新参数,常见采样估计写作:
\[\widehat{\nabla_\theta J} =\frac{1}{N}\sum_{t=1}^{N} \nabla_\theta\log\pi_\theta(a_t\mid s_t)\,\hat A_t.\]梯度上升时,正优势样本推动已采样动作的概率增加,负优势样本推动它降低。网络参数在很多状态与动作之间共享,所以一次更新会连带改变其他输出;这不是给每个动作单独存一个分数再加减。
减去状态基线的作用是降低估计方差。回报 8 分是否值得强化,取决于该状态平常能拿 5 分还是 10 分。优势把这种难度差异纳入比较,减少仅因某些任务容易得高分而产生的偏差。
PPO 要处理的进一步问题是:同一批经验如果重复训练很多次,策略可能改得太快,而这批数据已经不再代表新策略经常遇到的情况。
2.3 新旧概率比:比较同一个状态下的同一个动作
先冻结采样策略 $\pi_{\mathrm{old}}$,用它收集数据,再更新新策略 $\pi_\theta$。定义概率比:
\[\rho_t(\theta)= \frac{\pi_\theta(a_t\mid s_t)} {\pi_{\mathrm{old}}(a_t\mid s_t)}.\]分子和分母都评价数据中同一个动作,不是分别采样两个动作。旧策略左转概率为 0.4,新策略变成 0.5,则比值为 1.25,表示相对增加了 25%;绝对概率只增加了 0.1。这里用 $\rho$ 表示比值,避免与奖励 $r_t$ 混淆。
$\rho_t\hat A_t$ 构成一个局部替代目标,让旧策略采集的动作在新策略下重新加权。但它没有完整校正新旧策略的状态访问分布差异,所以还需要控制更新幅度。
对自回归 LLM,token 级概率是在相同文本前缀下计算的。如果把整段回复作为一个动作,其概率是各 token 条件概率的乘积,对数概率则是它们的和。token 级、序列级和集合级裁剪不能仅凭名字相似就互换。
2.4 Clip 和 min 到底限制了什么
PPO-Clip 最大化下面的采样平均目标:
\[L^{\mathrm{CLIP}}(\theta) =\mathbb{E}_t\left[ \min\left( \rho_t(\theta)\hat A_t, \operatorname{clip}(\rho_t(\theta),1-\epsilon,1+\epsilon)\hat A_t \right)\right].\]$\operatorname{clip}$ 把输入数值截到指定区间,$\epsilon$ 是裁剪超参数。取 $\epsilon=0.2$,比值的裁剪区间就是 $[0.8,1.2]$。$\min$ 比较原始项与裁剪项,采用数值较小的一项;因为这里在最大化目标,它相当于对这条样本的改进采取保守计分(OpenAI Spinning Up 的裁剪解释)。
下面沿用左转正优势 $+3$、右转负优势 $-2$ 的例子。各行是分别假设的新策略,不是同时生效的一组概率。
| 优势与更新方向 | 旧概率 → 新概率 | 比值 $\rho$ | 原始项 $\rho\hat A$ | 裁剪项 | 取较小值 |
|---|---|---|---|---|---|
| 左转好,概率明显提高 | 0.40 → 0.60 | 1.50 | 4.50 | $1.2\times3=3.60$ | 3.60 |
| 左转好,概率却降低 | 0.40 → 0.20 | 0.50 | 1.50 | $0.8\times3=2.40$ | 1.50 |
| 右转差,概率明显降低 | 0.60 → 0.30 | 0.50 | -1.00 | $0.8\times(-2)=-1.60$ | -1.60 |
| 右转差,概率却提高 | 0.60 → 0.90 | 1.50 | -3.00 | $1.2\times(-2)=-2.40$ | -3.00 |
正优势时,提高概率是有利方向。但比值超过 1.2 后,继续提高不再给这条样本增加目标收益。反过来,如果好动作的概率下降,原始项更小,仍会被选中,下降带来的损失不会被遮掉。
负优势时,降低概率是有利方向。乘上负数后大小关系翻转,所以比值低于 0.8 时,目标停在 $0.8\hat A$。例如 $-1.6$ 小于 $-1$,必须取 $-1.6$,不能把负优势情况也理解为「取绝对值较小的项」。差动作概率上升时,目标仍会变得更差。
因此,clip 限制的是这条样本沿有利方向继续改变概率的收益,不是把新策略概率硬性锁在区间内。 其他样本的梯度、共享参数和其他损失仍可能把比值推到区间外。实际实现常监测 KL 散度,即新旧概率分布的偏离程度,并在超过阈值时提前停止当前批次更新;裁剪本身不保证严格的策略距离上界。
2.5 优势怎样估计,一批数据怎样使用
PPO 常用 GAE(广义优势估计),把不同长度的价值预测误差加权组合:
\[\delta_t=r_t+\gamma V_\phi(s_{t+1})-V_\phi(s_t), \qquad \hat A_t=\sum_{l\ge0}(\gamma\lambda)^l\delta_{t+l}.\]实际求和只覆盖可用轨迹。$\lambda$ 调节长短期信息的权衡:较短估计更依赖 critic,较长估计更多依赖采样回报,通常对应偏差与方差的折中。真正终止时不再计入后续价值;只是因为采样长度限制而截断时,通常要用边界处的价值估计补上未观察的后续回报,即 bootstrap(自举估计)。
常见训练循环是:
- 用当前策略采集一批 rollout,保存动作、奖励、旧策略对数概率与价值估计。
- 计算回报目标和优势,本轮更新中固定旧概率与这些优势。
- 把这批数据分成 minibatch(小批次),重复若干 epoch(遍历整批数据的轮数),更新 actor 和 critic;必要时根据 KL 提前停止。
- 用更新后的策略重新采样,再开始下一轮。
PPO 通常归为 on-policy(同策略)方法:数据主要来自最近的采样策略。一批新 rollout 做多轮更新,与 on-policy 并不矛盾。 它与长期从历史经验池反复抽取旧样本的 off-policy(异策略)方法不同。实现还常加入熵奖励,鼓励策略保留一定探索,而不是过早只选择一个动作。
2.6 SFT、DPO、RLHF、GRPO 与 PPO 的关系
这些缩写分别指训练目标、算法或训练流程,不能当成同一层级的替代品。
| 名称 | 学习信号从哪里来 | 参数怎样更新 | 与 PPO 的区别 |
|---|---|---|---|
| SFT,监督微调 | 示范回答或成功轨迹 | 最大化示范 token 的条件概率 | 学习「示范怎样做」,标准目标不需要优势与环境回报 |
| DPO,直接偏好优化 | 同一输入下偏好与非偏好回答的配对 | 用相对参考模型的概率构造偏好损失 | 标准离线形式不需要 PPO rollout 与显式价值 critic;效果取决于偏好数据与覆盖范围 |
| RLHF,人类反馈强化学习 | 人类偏好,通常用于训练奖励模型 | 经典流程先 SFT,再拟合奖励模型,最后优化策略 | 是反馈与训练流程;PPO 可以承担其中的策略优化,二者不是互斥算法 |
| PPO,近端策略优化 | 环境奖励或奖励模型得分 | 用优势与新旧概率比优化裁剪目标 | 是通用策略优化算法,不限定奖励必须来自人类 |
| GRPO,组相对策略优化 | 同一问题下多个采样回答或轨迹的奖励 | 常用组内奖励均值、标准差构造相对优势,再优化概率比目标 | 典型形式省去独立价值网络,仍需采样与奖励;分组样本不是多个交互 agent |
例如,同一道题采样四个回答,得分为 0、0、1、1,组均值为 0.5。正确回答的相对优势为正,错误回答为负;若再除以组标准差,就是常见的标准化形式。所有回答同分时,组内差异信号很弱或为零,需要处理零方差。GRPO 的具体裁剪、归一化和 KL 写法随变体变化。
PPO 更新中的 old policy 是收集本批数据的策略;LLM 对齐中的 reference model 常是固定的参考模型,用来约束偏离初始行为。两者即使起点相同,训练中也承担不同角色。
ChatDev、MetaGPT 的原始方法属于角色化编排,不能因为系统产生了代码或协作轨迹就归类为 SFT。只有明确用这些轨迹更新参数时,才发生监督微调。Prompt-only 则表示依靠提示词和流程工作,基础模型参数保持不变。
3. 多个主体一起学,比单个主体多了什么
3.1 非平稳性与 CTDE
单个机器人学习时,通常把环境的转移规则视为固定。多个机器人同时学习时,队友的行为也在变化:昨天队友会让路,今天它可能抢先通过。即使物理规则没变,单个主体看到的有效环境也变了,这就是 MARL 中的非平稳性 nonstationarity。
CTDE(集中训练、分散执行)是一种训练与部署的信息安排。训练阶段,critic 或价值混合模块可以利用全局状态、联合动作等额外信息;执行阶段,每个 actor 根据自己允许获得的观测和通信作决策。它帮助训练理解「队友做了什么」,但不会自动解决探索、信用分配或所有非平稳问题。
部署阶段拿不到的信息,不能偷偷放进 actor 输入。如果允许通信,也需要把通信内容、频率和费用算进执行条件。
3.2 MAPPO:把 PPO 放进合作任务
MAPPO 是 PPO 在多智能体合作中的常用实现路线。各 actor 用本地信息选择动作,训练时 critic 可以利用更丰富的联合信息估计价值,再为策略更新提供优势信号。它保留了 PPO 的采样、优势估计和裁剪思路,额外处理多主体数据、共享奖励和信息可见性。
MAPPO 的经验结果说明,经过合适实现和调参,PPO 在多种合作基准上可以成为强基线。这里的「强」指特定实验中的表现,不是所有多智能体任务上的最优保证。使用团队优势训练也不意味着已得到每个成员的因果贡献。
3.3 VDN 与 QMIX:把团队价值分解成局部效用
另一类方法直接学习动作价值,再从价值较高的动作中选择。VDN(价值分解网络)把团队动作价值表示为各主体局部效用之和:
\[Q_{\mathrm{tot}}=\sum_i Q_i.\]例如两台机器人分别给自己的候选动作打分,团队价值由这些分数组合得到。只有团队奖励也可以训练这套结构,执行时各主体再按自己的局部效用选择动作。
QMIX 用一个可学习的混合网络代替简单相加,并要求团队价值对每个局部效用单调不减,即 $\partial Q_{\mathrm{tot}}/\partial Q_i\ge0$。在这种结构下,各主体分别选择局部最高效用动作,可以与所表示的团队价值最大化保持一致。代价是表达能力受单调性约束,某些复杂协作关系难以准确表示。
这些 $Q_i$ 是为优化团队决策学出的局部效用,不应直接解释为成员「真正创造了多少收益」。价值分解解决可学习、可分散执行的问题,贡献解释还需要额外定义。
3.4 信用分配与反事实基线
Counterfactual(反事实)提出一个明确的替代情景:如果其他条件尽量相同,但这个成员采取另一个动作,结果会怎样?在 COMA 中,固定其他主体的动作,用当前主体所有备选动作的策略加权平均值构造基线:
\[A_i(s,\mathbf a)=Q(s,\mathbf a) -\sum_{a_i'}\pi_i(a_i'\mid h_i) Q\bigl(s,(a_i',\mathbf a_{-i})\bigr).\]$\mathbf a$ 是所有主体的联合动作,$\mathbf a_{-i}$ 是除主体 $i$ 外的其他动作。这个优势回答「在队友动作不变时,本次选择相对自己的通常选择好多少」。它依赖 critic 的估计与所选基线,不是直接从环境中读到的贡献真值。
另外两种常见的贡献参考是:
- LOO(leave-one-out,留一法):比较完整团队与去掉某个成员后的表现,例如 $v(N)-v(N\setminus{i})$。这是该成员对完整团队的边际作用。移除后任务是否仍可执行、是否允许队友重新适应,都必须明确。
- Shapley 值:对成员加入不同队伍时的边际作用做加权平均,等价于在各种加入顺序上平均贡献。它考虑多种联盟,而 LOO 只看完整团队去掉一人的情景;主体较多时通常通过采样近似。
在一个纯教学例子中,A、B 单独都搬不动箱子,空团队和单人团队得分均为 0,两人合作得 10 分。LOO 给 A、B 各 10 分,因为少任何一人都会损失全部收益;Shapley 值按加入顺序平均后各为 5 分。两种数值都能由同一个任务算出,却回答不同问题。
所以反事实贡献始终依赖基准、干预方式、后续策略和随机性的定义。小环境可以帮助精确计算某个已定义的量,但不会产生脱离这些条件的唯一真实贡献。
4. 发展脉络:传统 MARL 与语言智能体怎样相遇
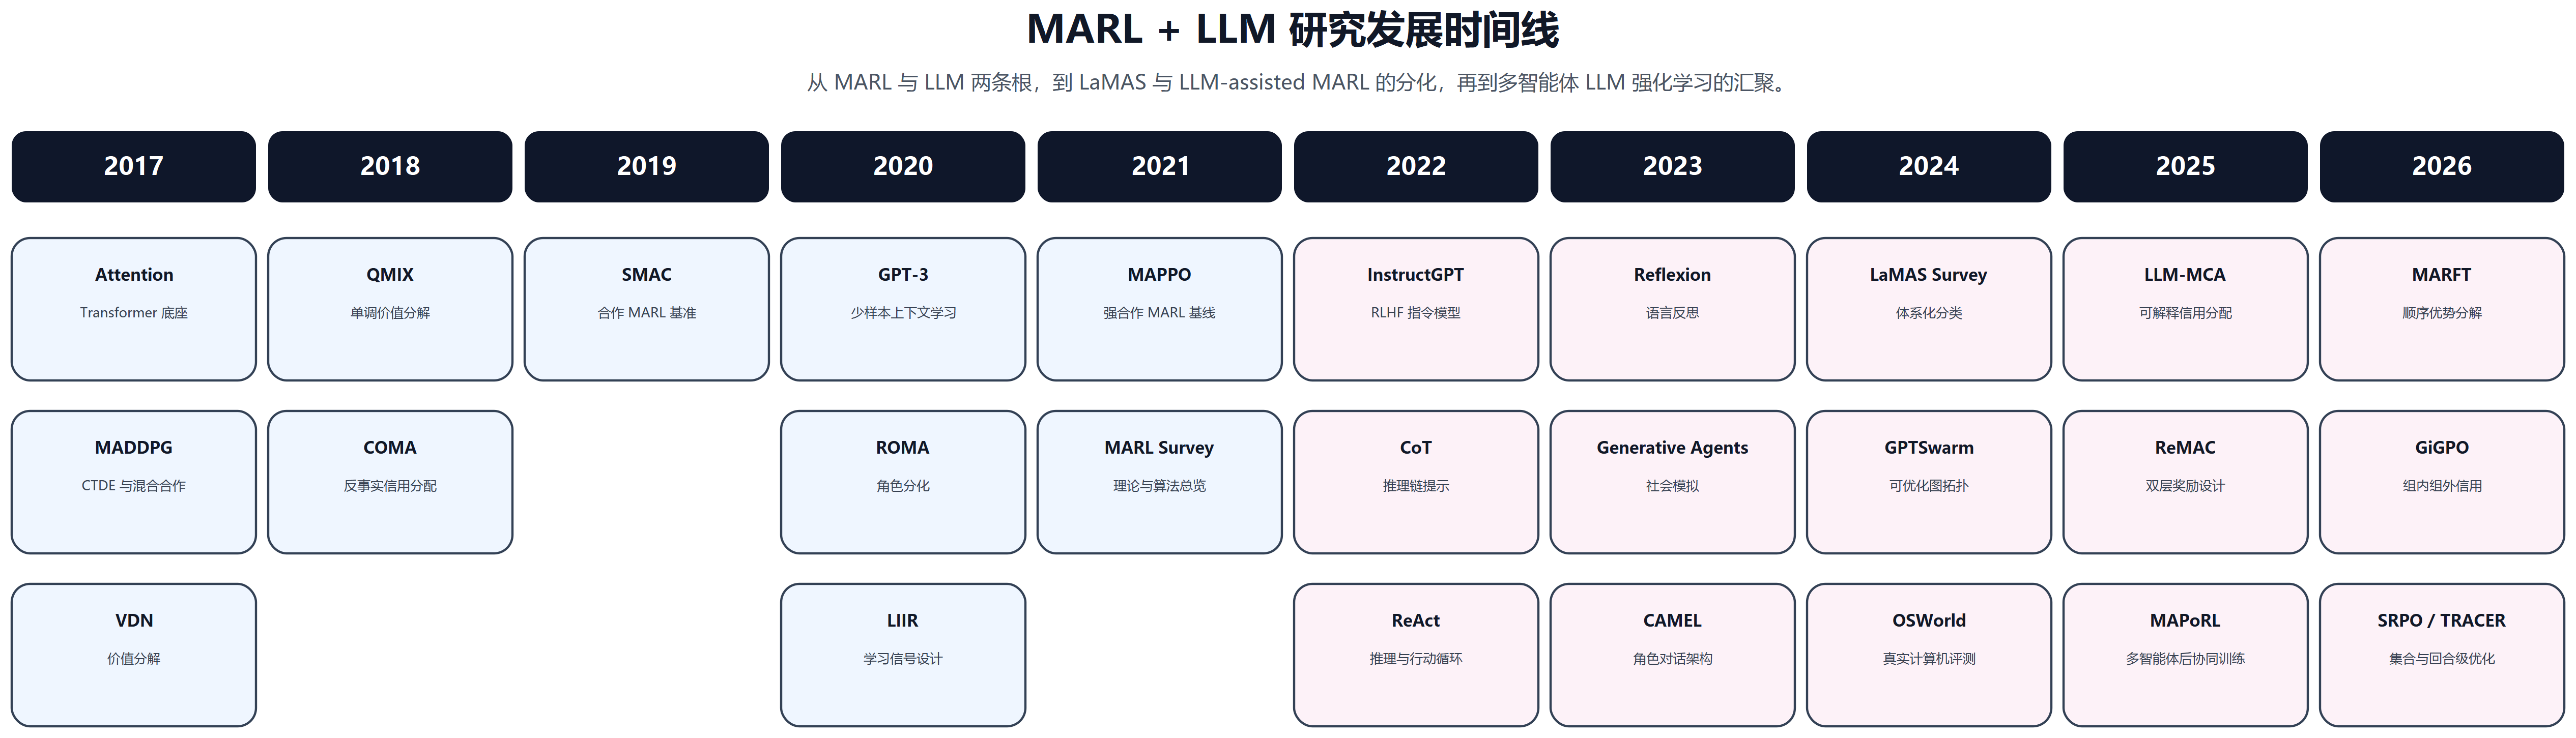
时间线串联了 MARL 基础、语言模型基础与后续交叉工作,来源为综述工作区。它混合了预印本与发表年份,不能把所有列项都看成 MARL 方法;GiGPO 的相关预印本工作见 2025 年,图中的 2026 年位置不宜作为首次提出年份。LIIR 与另一篇激励学习论文的名称、作者和年份也不能混用。
4.1 传统 MARL 与语言模型的基础
2017—2021 年的 MARL 工作集中解决联合决策与训练困难。MADDPG 把集中式 critic 与分散 actor 用于连续动作及合作—竞争任务;VDN、QMIX 研究价值分解,COMA 研究反事实基线,MAPPO 展示 PPO 式方法在合作任务中的表现。SMAC 提供基于星际争霸微操的合作评测,ROMA 则探索通过学习形成角色分工。
内在奖励学习也是相关分支。LIIR 通常指 Learning Individual Intrinsic Reward in Multi-Agent Reinforcement Learning;Learning to Incentivize Other Learning Agents 是另一项学习如何激励其他主体的工作。两者不因都涉及「奖励学习」就共用缩写、作者或年份。
语言模型一侧,Transformer 提供序列建模架构,GPT-3 展示少样本上下文学习。到 2022 年,InstructGPT 使用人类反馈训练指令模型;CoT(思维链提示)让模型生成中间推理步骤;ReAct 把推理、行动和环境反馈交替组织。上下文学习指通过输入示例改变当前输出,不要求当场更新模型参数。
4.2 2022—2023 年:规划、反思与角色协作
SayCan 用语言模型评价技能与任务的相关性,再结合技能的可执行性得分选择行动;Inner Monologue 把执行反馈送回规划循环。Code as Policies、ProgPrompt 让语言计划落实为程序或控制接口;Voyager 在 Minecraft 中积累可复用技能。
这些规划与具身控制工作解释了「语言怎样影响行动」,主要作为相关先行路线。Eureka、Text2Reward 说明 LLM 可以生成奖励程序;Reflexion 则把失败反馈写成文字记忆,供后续尝试使用。它们各自的原始设置不能直接充当多智能体强化学习实验的证据。
同期,CAMEL、AutoGen、MetaGPT、ChatDev 展开角色对话与软件工程协作;Generative Agents 用多个带记忆和计划的主体模拟社会互动;Multiagent Debate、ChatEval 分别将多方讨论用于答题和评价;RoCo 研究多机器人语言协作与重规划。多机器人合作是否还包含学习,需要继续看低层策略和训练流程。
4.3 2024 年以后:组织结构与训练信号进入优化对象
LaMAS 综述开始按智能体、通信、能力与评测组织文献。GPTSwarm 把系统表示为图,DyLAN 动态选择参与者,MACNET 研究更大协作网络,Optima 用生成、排序、选择与训练改善通信效率。ProAgent 与 Hypothetical Minds 研究伙伴建模:根据队友的行为推测其目标、知识或策略,再调整自己的行动。
到 2025—2026 年,MAPoRL、MARFT、SRPO 等工作更直接地优化协作中的语言策略;LLM-MCA、ReMAC 继续探索语言模型怎样改善传统 MARL 的反馈。GiGPO、RAGEN、AgentGym-RL 则提供相关的多轮 agent 训练思路。多轮描述时间长度,多智能体描述决策主体数量;两者需要分别判断。
5. 主线一:基于 LLM 的多智能体系统
5.1 角色、流程与可执行的分工
| 工作 | 主要做法 | 解决的具体问题 |
|---|---|---|
| CAMEL | 角色扮演与对话协议 | 让不同角色按约定交换任务信息 |
| AutoGen | 可编程对话与工具调用 | 把模型、工具和控制流程接起来 |
| MetaGPT | SOP,即标准作业流程,与角色流水线 | 规定需求、设计、实现等阶段的交付关系 |
| ChatDev | 多角色软件开发工作流 | 用角色协作组织软件生成 |
| AgentVerse | 成员调整与协作组织 | 根据任务调整参与者 |
| MACNET | 规模化协作网络 | 研究团队规模与连接方式的影响 |
| MoRSE | 角色—子任务专家分工,按综述所列前沿工作理解 | 研究更细的专业化分配 |
角色名本身不会产生专业能力。分工有效,需要每个角色获得相应信息、可执行工具与明确输出接口。例如「检查者」若只能读编码者的自述,不能运行测试,就很难独立验证代码。
5.2 辩论与反思能提供什么
Multiagent Debate 让多个主体先提出答案,再相互质疑;ChatEval 把这种讨论用于评价文本。有效的分歧可以暴露遗漏条件,重复同一错误则只会增加成本。多轮讨论达成一致,也不等于答案已经正确,仍需要测试、事实核验或任务判定。
Reflexion 的文字反思机制可以被多智能体系统借用,但原方法不应仅因有执行与反思模块就归入 MARL。判断 agent 数量,需要看交互主体和决策边界,而不是数提示词模板。
相同基础模型的多个主体可以构成协作系统。独立上下文、不同工具权限和可验证的中间结果,可能带来信息互补;收益大小仍应与预算相当的单智能体、多次采样或自检方案比较。
5.3 拓扑、路由与动态编排
拓扑 topology 指谁能向谁发送信息。链式流程按顺序传递,全连接让各方互相交流,DAG(有向无环图)用没有循环的依赖关系组织任务。动态编排则根据当前进展选择参与者和下一条通信边。
GPTSwarm、DyLAN、Optima 关注结构或通信优化;Evolving Orchestration 用中心编排器调度;综述中的 E2-Explainer 研究通信子图的解释;AgentNet 为主体配置 router(路由器,决定任务或消息发给谁)与 executor(执行器,完成分配到的工作)。
通信会占用输入输出 token,增加等待时间,也可能传播错误。稀疏连接能降低开销,但可能切断必要信息;动态拓扑是否更好,要比较任务质量、调度费用与总延迟,而不是只数通信边。
5.4 应用、评测与失败分析
Generative Agents 和 AgentSociety 用于社会模拟;ChatDev、MapCoder 用于代码生成;Agent Laboratory 涉及科研辅助;综述列出的 PhySciBench 以专家题评价物理研究任务。社会模拟与开放研究尤其需要明确评价标准,专家判断、现实数据对照和自动验证各自覆盖不同问题。
| 评测或分析工具 | 主要测量对象 |
|---|---|
| AgentBench、GAIA | 多环境任务、工具与综合推理能力 |
| WebArena、OSWorld | 网页、桌面的长程操作 |
| SWE-bench | 真实软件仓库中的问题修复 |
| τ-bench | 业务规则约束下的工具—用户交互 |
| MultiAgentBench | 多主体协作、竞争与通信 |
| SOTOPIA | 社会互动与社交目标 |
| MAST、ToMAS | 多智能体失败分类与心理理论相关诊断 |
其中不少基准最初用于一般 agent 评测;在上面运行多个主体,并不能单凭最终分数证明协作机制有效。
MAST 将所研究系统的失败整理为规格与系统设计、主体间协调、任务验证与终止等类别。它提示评测应记录完整过程:信息是否传到、约束是否被遵守、任务是否被错误宣布完成。没有相应样本与统计数据时,不能把这种分类推广为「多数多智能体失败都由组织问题造成」。ToMAS 在综述中被列为利用失败轨迹诊断心理理论能力的后续工作;心理理论在这里指推测其他主体的知识、信念与意图。
6. 主线二:LLM 怎样辅助 MARL
6.1 先定位 LLM 的输出与使用者
| LLM 的位置 | 输出由谁使用 | 相关例子与范围 |
|---|---|---|
| 高层规划器 | 低层控制器或技能库 | SayCan 是先行规划方法;L2M2 连接高层规划与 MARL |
| 奖励设计器 | RL/MARL 训练程序 | Eureka、Text2Reward 是奖励生成先行工作;ReMAC 面向多智能体双层奖励 |
| 信用分配器 | 各主体的学习模块 | LLM-MCA 读取联合轨迹并生成个体反馈 |
| 策略指导模块 | 采样器或低层策略 | LAMARL、LLM-Mediated Guidance 用先验或建议影响学习 |
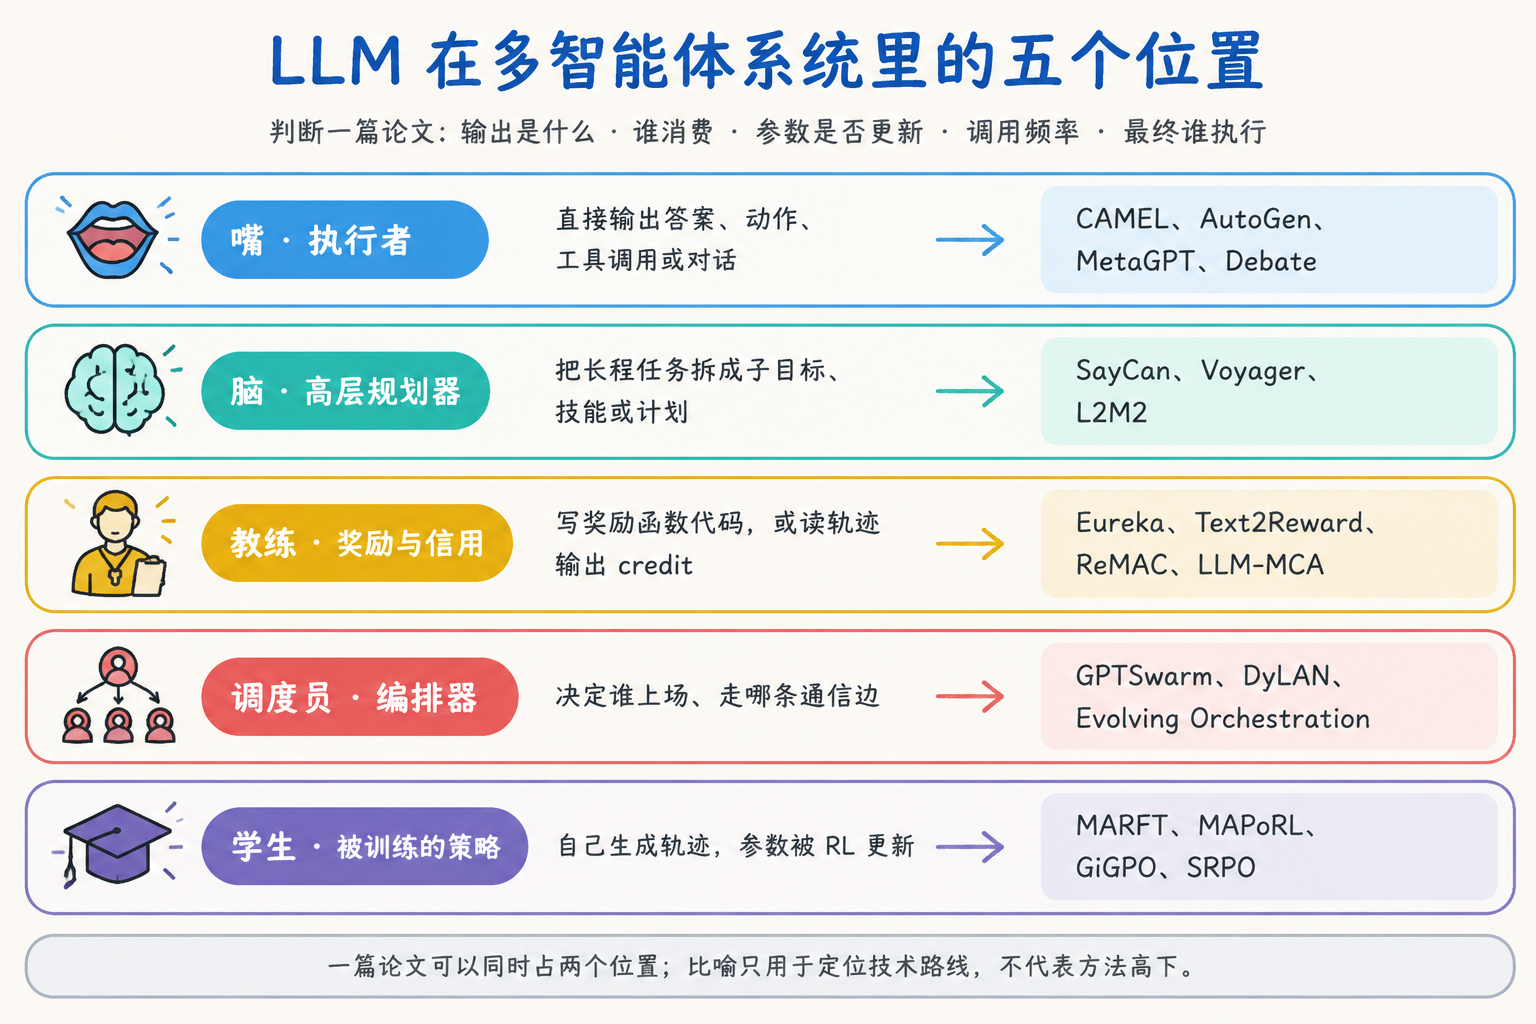
配图按执行、规划、反馈、编排与参数训练区分角色,依据《LLM角色说明》制作。SayCan、Eureka、GiGPO 等例子展示可借鉴的机制,不能因列在这张多智能体示意中就认定原方法属于 MARL;GiGPO 主要讨论多轮 LLM agent 的训练。
阅读方法时,可以依次确认五件事:LLM 输出什么,谁使用输出,更新哪些参数,多久调用一次,以及部署时最终由谁行动。这比仅凭论文标题中的「agent」或「RL」分类更明确。
6.2 高层规划与低层控制
高层规划决定「先抓住箱子再移动」,低层控制决定「这一刻施加多大的力」。技能 skill 是可重复调用的一段行为,例如抓取、导航或运行测试;行为原语则是更基础的可执行操作。
SayCan 的 affordance 得分表达某项技能在当前条件下能否成功;Inner Monologue 通过实际反馈修正计划;Voyager 用技能库减少重复构造动作;RoCo 结合多机器人对话与运动规划;L2M2 在综述中对应高层语言规划与低层 MARL 的连接。共同的接口问题是:语言提出的子目标能否被执行器实现,以及失败后是否有可靠反馈。
6.3 奖励设计、PBRS 与经验回放
奖励设计定义「怎样才算做得好」,奖励塑造 reward shaping 则在原任务奖励之外增加学习信号。例如只在箱子搬到目标时给分很稀疏,于是额外奖励有效进展。增加的信号如果写错,可能把最优行为改成刷分行为。
经典的 PBRS(基于势函数的奖励塑造)采用:
\[r'_t=r_t+\gamma\Phi(s_{t+1})-\Phi(s_t),\]其中固定势函数 $\Phi(s)$ 可以表示状态的进展程度,并使用与原回报相同的折扣因子。新增奖励在折扣累计后逐项抵消:
\[\sum_{t=0}^{T-1}\gamma^t \bigl(\gamma\Phi(s_{t+1})-\Phi(s_t)\bigr) =-\Phi(s_0)+\gamma^T\Phi(s_T).\]如果初始状态固定,且终止边界处理使最后一项为零或不依赖所选策略,塑造回报与原回报只差一个不影响策略排序的量。例如有限回合任务可令终止势为零;无限折扣情形常要求势函数有界,使远端项消失。不能忽略不同终止状态或不同结束时间留下的边界项。
这些是固定势函数形式的基本条件。动态势函数需要说明时间索引、更新规则与相应边界条件,再检查是否仍能得到不变性;不能断言任何动态势函数都必然破坏最优策略。多智能体系统还要说明塑造的是团队奖励还是个人奖励,以及奖励变化如何影响博弈目标。
经验回放池 replay buffer 存储历史状态转移,供 off-policy 算法重复训练。若 LLM 不断改写奖励,而旧样本保留旧得分,同一类行为可能同时带有不同版本的标签。价值网络就可能拟合一个含义混杂的目标。可比较固定奖励、周期更新、版本化存储、按当前奖励重标注等方案,而不是把「奖励会变」直接等同于算法不能工作。
Eureka、Text2Reward 提供自动奖励生成的思路;ReMAC 同时设计个体与团队奖励,并搜索多个奖励—策略候选组合,即种群。LLM-ALSO 与综述中的 Regime-Conditional Stabilisation 关注迭代奖励和训练稳定性。评价这类方法时,要记录奖励尺度、版本与更新频率,并检验最终原任务指标,而不只看塑造后的训练回报。
6.4 LLM critic 与其他细粒度信用方法
LLM-MCA 让集中式语言模型读取联合轨迹,生成逐主体的 credit 和文字解释。这里的 LLM critic 是贡献评估模块;它不必等同于 PPO 中通过回归训练的数值价值网络。名字都叫 critic,输入、输出和训练目标仍可能不同。
解释通顺、团队回报提高、贡献估计符合某项反事实定义,是三种不同的证据。要检验最后一种,需要在确定的替代动作或移除规则下重新评估,再比较信用排序和贡献变化。
与此相邻的工作包括:
- GiGPO 为多轮 LLM agent 构造细粒度优势:用完整轨迹的相对表现提供整体信号,再对共享锚点状态的步骤分组比较。critic-free 指不另训练独立价值网络,不是没有奖励评价。它解决的是长轨迹中的时间信用问题,不能仅因有多个采样组就认定为多智能体信用分配。
- TRACER 在综述中以控制器与生成器两层处理协作。控制器决定发言还是跳过,遗憾匹配根据「若换一个选择可能多得多少收益」调整选择;生成层优化提议和审查内容。具体的回合边界与奖励定义决定其信用含义。
- MASkills 以可复用技能为单位组织持续优化,关注某项技能对后续任务的作用。
- Divide and Cooperate 把搜索与生成等角色分开,研究不同角色间怎样传递学习信号。
这些方法的共同比较轴是信用分到哪里:主体、时间步、对话轮次、技能,还是一组共同生效的输出。不同粒度对应不同问题,不构成天然优劣顺序。
6.5 从辅助信号到语言策略训练
MAPoRL 直接优化多个语言智能体的协作。MARFT 用 Flex-MG 形式表示异构、异步和动态组织的交互;异构指主体能力或模型不同,异步指它们不必同时行动。其顺序优势分解把联合改进与按顺序加入的主体决策联系起来,再更新相应策略。
SRPO 的优化单位是活跃集:一次状态转移实际使用的那组主体输出。它把成员的对数概率比组合并按集合大小归一化,再构造集合级比值、相对优势与裁剪目标。理解它与 PPO 的关系,首先要辨认「一个动作」已从单个输出变成共同生效的集合;不能把逐成员裁剪与整组裁剪视为同一操作。
RAGEN、AgentGym-RL 研究相关的长程、多轮交互训练问题,其是否属于多智能体学习仍取决于具体任务设置。LAMARL 则用 LLM 生成先验策略与奖励,辅助低层 MARL。先验指开始探索前已有的结构或建议,样本效率指达到同等效果需要多少环境交互;语言指导减少交互步数的同时,也可能增加模型调用费用。
7. 前沿工作可以沿哪些问题比较
2025—2026 年的相关研究同时改变优化粒度、优化对象和评测方式。按问题对齐,比把所有新名字放进同一条技术演进链更容易比较。
| 问题 | 代表工作 | 需要对照的内容 |
|---|---|---|
| 协作怎样进入参数训练 | MAPoRL、MARFT | 更新哪些主体,联合优势怎样分解,异构角色是否稳定 |
| 长轨迹怎样获得细粒度反馈 | GiGPO,以及相关多轮训练工作 | 时间信用与主体信用的区别,状态分组能否可靠构造 |
| 共同生效的输出怎样优化 | SRPO | 集合大小、归一化、裁剪粒度与估计方差 |
| 发言、角色与技能怎样获得反馈 | TRACER、MASkills | 跳过决策、角色搭便车、技能冲突与长期任务迁移 |
| 语言生成的奖励与信用是否有效 | ReMAC、LLM-MCA | 原任务回报、信用干预验证、部分观测与团队规模 |
| 奖励迭代如何保持训练稳定 | LLM-ALSO、Regime-Conditional | 奖励版本、回放重标注、势函数条件与尺度 |
| 失败和不安全动作如何传播 | MAST、ToMAS、Unsafe Actions Propagation | 失败分类、故障传播路径、恢复与防护成本 |
角色搭便车指某成员依赖队友完成任务,却仍共享团队收益;安全传播指一个主体受到错误信息或恶意输入影响后,通过通信使其他主体也采取不安全行动。两者都需要过程记录,最终成功率无法单独区分原因。
上述前沿条目的定位主要依据随文综述,其中部分为预印本或审稿稿。跨论文比较时,模型规模、任务难度、外部工具和采样预算必须一并考虑,方法名称的新旧不能代替效果证据。
8. 实验方法地图:怎样分辨改进来自哪里
8.1 环境选择与可枚举条件
| 环境或任务 | 适合观察的问题 | 使用条件 |
|---|---|---|
| 小型 Matrix Game(矩阵博弈) | 联合动作、合作收益和明确定义的贡献 | 动作组合有限,收益表已知 |
| Spaceworld、LBF、RWARE 的受控小配置 | 导航、合作采集、仓储协作和干预测试 | 需检查状态、动作、时域与模拟器重置能力 |
| SMAC、ManiCraft、Multi-Agent MuJoCo | 战术、任务或连续控制协作 | 固定环境版本、观测条件与交互预算 |
| ALFRED、RoboSuite、RoCo 任务 | 语言计划到具身执行 | 区分规划错误和控制失败 |
| MATH、CMATH、GSM8K、CodeForces、SWE-bench | 数学推理、竞赛代码与仓库修复 | 规定验证器、工具权限与采样次数 |
| WebArena、τ-bench、OSWorld、GAIA | 长程工具、网页、桌面与综合任务 | 记录环境变化、交互成本和成功判定 |
| SOTOPIA、AgentSociety、PhySciBench | 社会互动、模拟与研究任务 | 说明专家评估或现实数据对照标准 |
LBF 是合作采集环境,RWARE 是多机器人仓储环境。名称本身不保证「可枚举」:地图规模、主体数量和任务长度一增加,联合状态与轨迹数量就可能迅速增长。能够重置并运行替代动作,也不等于能穷举所有可能轨迹。
小配置的价值在于控制变量。若转移规则已知,可以精确计算定义好的反事实量;若主要依靠模拟器,则可用多次反事实 rollout 估计期望差异,并报告采样误差。环境、基准动作和干预规则应随结果一起给出。
8.2 训练协议与低层骨干
Backbone(骨干)在这里指承担主要策略或价值学习的基础算法。比较 LLM 辅助方法时,固定骨干有助于分离新增信号的作用。
| 协议 | 主要更新对象 | 需要控制的变量 |
|---|---|---|
| Prompt-only | 不做梯度参数更新 | 提示词、角色、工具、通信与调用预算 |
| SFT | 语言策略参数 | 示范质量、数量、角色覆盖和训练步数 |
| DPO | 语言策略参数 | 偏好对来源、参考模型、数据分布 |
| PPO / GRPO 等 RL | 采样策略或部分可训练参数 | 奖励、优势、rollout 数量、更新轮数与 KL |
| QMIX / MAPPO / MASAC 等 MARL 骨干 | 局部价值、actor、critic 或混合网络 | 观测范围、团队奖励、经验回放与动作空间 |
| LLM-as-signal | 主要是消费语言反馈的低层模型 | LLM 输出定义、调用频率、解析失败与信号版本 |
DDQN(Double DQN)是离散动作的价值学习方法,用在线网络选择下一动作,再用目标网络评价该动作,减轻同一个噪声估计既挑选又评价时产生的高估。它常使用经验回放与延迟更新的目标网络。
MASAC 通常指多智能体 Soft Actor-Critic 类方法。SAC 在追求回报之外加入策略熵,鼓励保留探索;多智能体版本常结合集中式 critic 与分散 actor,并使用 off-policy 经验回放。具体实现对动作空间、critic 输入与参数共享的选择不同,不能仅凭缩写判断细节。
LoRA(低秩适配)则不是强化学习算法。它冻结基础权重 $W$,只训练较小的低秩增量,如 $\Delta W=BA$,有效权重变为 $W+\Delta W$。PPO、SFT 或其他目标都可以用来更新这些增量。各角色共享基础模型但使用独立 LoRA,意味着共享语言能力底座,同时保留可分别训练的角色参数。
8.3 指标与基线必须回答同一个问题
| 指标类别 | 可读的衡量方式 |
|---|---|
| 任务表现 | 成功率、每个完整任务的累计回报、达到同等回报所需的环境步数 |
| 学习信号 | 与明确定义的贡献参考之间的排序相关、错误归因率、奖励投机发生率 |
| 协作作用 | 移除主体后的变化、角色替换效果、通信中断后的恢复、同预算单主体对照 |
| 成本 | 输入输出 token、每任务调用次数、GPU/CPU 小时、实际经过的墙钟时间 |
| 可靠性 | 多个随机种子的波动、失败恢复率、安全约束违反率 |
排序相关衡量「谁更重要」的顺序是否一致,不证明贡献数值准确,更不单独证明因果解释正确。消融 ablation 指去掉或替换一个组件,观察结果变化;若同时改变预算、模型大小和角色数,就很难把变化归因于该组件。
基线宜覆盖无 LLM 的同骨干策略、人工奖励、随机或打乱的 credit、固定与动态拓扑、一次性与迭代信号,以及预算相当的单主体方案。错误奖励或打乱信用可用于受控诊断,测试应限定在安全的实验环境内。
比较多智能体和单智能体时,可以为单主体提供相当的总采样、工具与 token 预算。否则团队更高的成功率可能主要来自更多计算,而非分工本身。零样本迁移指在新任务上不提供该任务示范,少样本迁移则允许少量示范;两者都需要说明是否继续更新参数。
8.4 分层验证模板
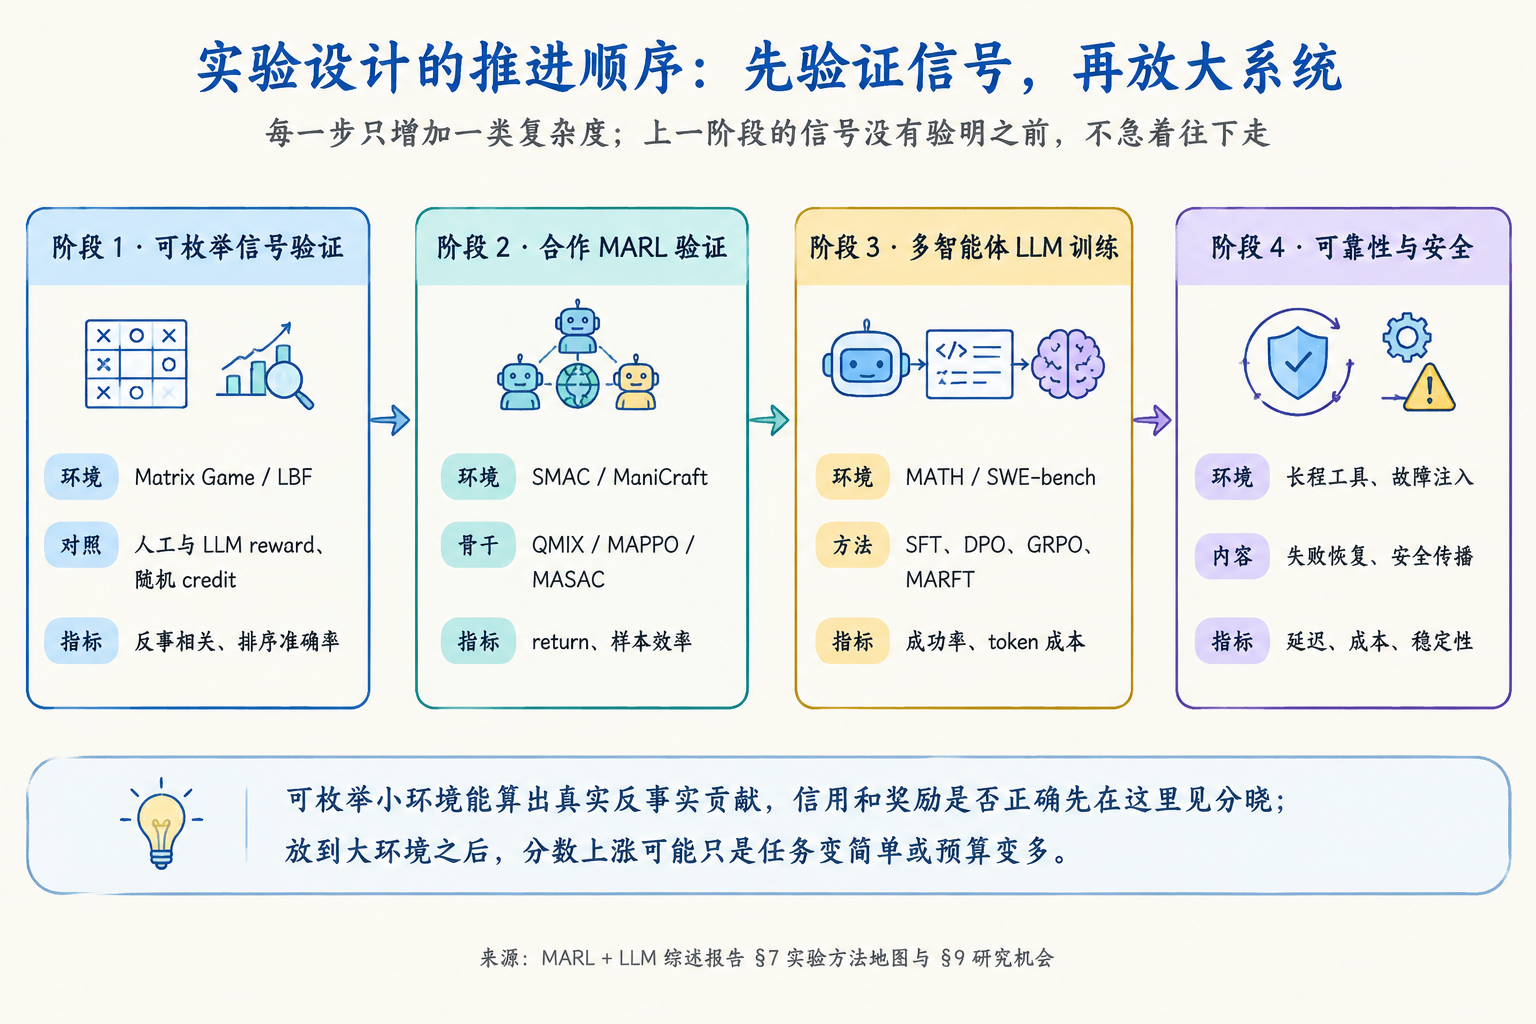
配图依据综述的实验模板制作。图中文字中的「真实反事实贡献」应按本文解释为指定干预与基准下的贡献参考;LBF 也只有经过规模与时域限制后,才适合作为可穷举候选环境。
模板包含四类验证:在受控小任务中检验奖励与信用信号;在合作 MARL 中观察策略改进;在语言智能体任务中比较训练粒度;最后测试故障、成本与安全。它们是逐步增加实验复杂度的选择,不是必须依次完成的个人日程。
跨层迁移时,应保留原任务奖励、对照方法与预算口径。例如在小任务中信用排序更准确,迁移后却没有减少环境交互,就需要区分信号是否失真、低层算法是否无法利用,以及额外调用成本是否抵消收益。
9. 五个可检验的问题
9.1 贡献解释是否经得起干预
固定任务和策略,明确替代动作、成员移除或联盟形成规则,再比较 LLM credit 与反事实回报变化。LOO 和 Shapley 应分别报告,不能把两者统称为同一份贡献真值。随机或打乱信用可以检验算法是否真正依赖信用内容。
9.2 奖励更新会怎样改变学习目标
比较固定、周期更新与更频繁更新的奖励,记录回放池中的版本分布,再对照重标注或版本隔离。评价既包括训练波动,也包括原任务表现。若使用 PBRS,需要明确势函数和终止处理,而不只展示一个形式相似的奖励公式。
9.3 动态通信的收益是否超过费用
在相同模型、任务与总预算下比较固定链、静态 DAG、动态拓扑与随机连接。除了成功率,还要计入编排器本身消耗的 token、延迟和失败恢复成本。动态连接减少消息数,却增加昂贵路由调用时,总费用仍可能上升。
9.4 协作是否依赖特定成员与信息条件
对某个已验证的两主体设置,可以增加到三至五个主体,再改变局部观测、模型规模或通信预算。成员移除、角色替换与消息中断能检验系统是否真的使用了分工。这是扩展某项实验的检验方式,不能据此概括整个领域都只研究两主体或全局观测。
9.5 预算相当时,结论还成立吗
环境步数、梯度更新步数、rollout token、外部模型调用和奖励候选搜索,都属于训练费用;部署延迟、显存与工具调用属于使用费用。可以报告单位 token 或单位 GPU 小时的表现,同时给出原始质量与成本,避免一个比值掩盖任务质量的大幅下降。
10. 回到 Day12:三篇论文在地图上的位置
| 论文 | 所属路线 | LLM 的角色 | 主要被训练对象 |
|---|---|---|---|
| MARFT | 多智能体语言策略训练的汇聚层 | 直接行动、接受反馈的策略 | 各角色的可训练参数,如 LoRA |
| LLM-MCA | LLM 辅助 MARL 的信用分配 | 读取联合轨迹、输出贡献反馈的集中式评估器 | Double DQN 策略所用的价值网络 |
| ReMAC | LLM 辅助 MARL 的奖励设计 | 奖励程序生成与反思 | MASAC 类低层策略及价值网络 |
ReMAC 改变用于学习的奖励规则;LLM-MCA 提供个体贡献反馈;MARFT 更新协作中的语言策略参数。它们都利用任务反馈,但反馈进入训练的位置不同,也就对应不同的验证问题。
三篇论文的公式与具体实验记录见 Day12 笔记。定位方法时,先确认输出、使用者、参数更新、调用频率与最终执行者,再追踪优势、奖励或信用如何进入损失函数。