· 多智能体 / 强化学习 / MARFT / LLM-MCA / ReMAC / 信用分配 / 奖励设计
Day12:多个智能体,怎样才算学会了合作?
MARFT × LLM-MCA × ReMAC:从训练队员,到分配贡献,再到设计奖励。
前言:把几个模型拉进群,就能组成一个好团队吗?
博士生导师给我推了几份论文让我读读,好像是关于多智能体强化学习的。
又是一个没接触过的板块,看看能不能读懂吧QAQ。
其实我还不知道LoRA什么的是个啥呢,少了好多前置知识来的,真是坐牢了。
前面学习 GPT 时,主要关心的是:一个模型怎样根据前文预测下一个 token。学习 LangGraph 时,问题又往前走了一步:怎样把不同节点连接起来,让它们传递状态、调用工具、完成任务。
这次再往前问一步:
工作流能跑通之后,里面的成员怎样通过反馈,真正学会配合?
以一个写代码的小组为例:A 分析题目,B 写程序,C 检查错误。最后程序通过了测试,只能说明“小组做对了”,尚不能确定 A 的思路是不是关键、B 有没有修正错误、C 的检查是不是多余。
如果每个人都拿同一个分数,反馈可能不够具体;如果只奖励最后交答案的人,又会忽略前面必要的准备。甚至,评分规则本身也可能有问题:奖励“说得长”,未必能让答案更正确;奖励机械臂“靠近物体”,也未必能让它把物体搬到终点。
这三篇论文正好从三个位置切入这个问题:
- MARFT:训练做事的人。 让 LLM 智能体依据团队任务反馈,更新协作策略。
- LLM-MCA:改进分数的分配。 让 LLM 读团队经历,给不同成员更具体的训练反馈。
- ReMAC:设计打分的规则。 让 LLM 编写并迭代奖励函数,教策略网络学会协作。
三篇论文的区别首先在于:LLM 参与了学习闭环中的哪一环。 它们的任务和训练对象不同,公式中的策略、奖励与评价对象也要分别对应。
0. 先看全局:LLM 在队伍里扮演什么角色?
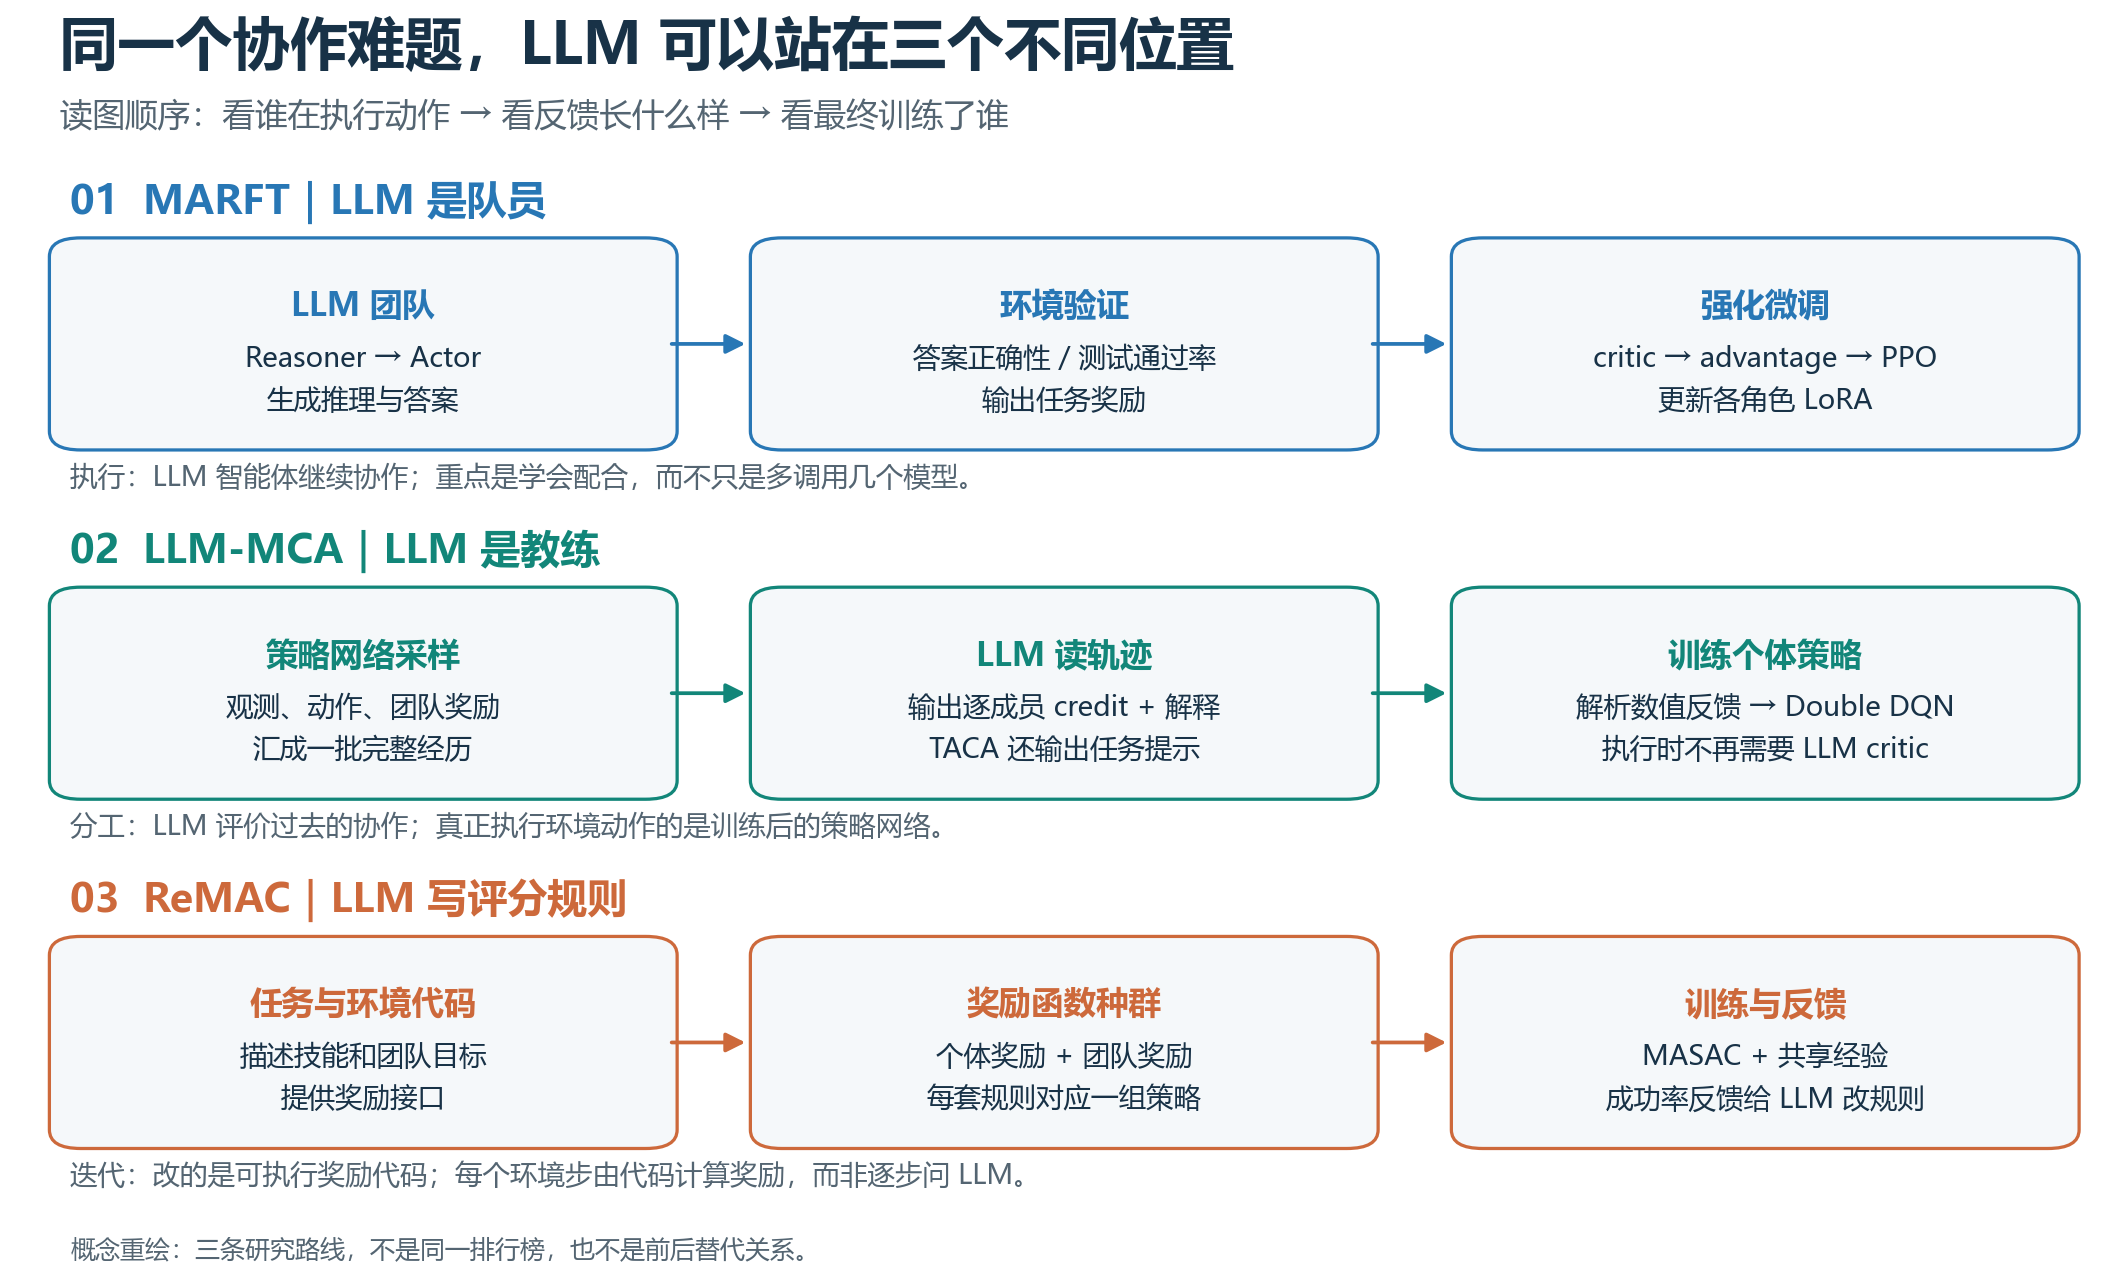
图 1 · 三条路线的知识地图。 从左向右看每一行的数据流。第一行最终修改的是 LLM 智能体的可训练参数;第二行把 LLM 输出解析为数值反馈,训练常规策略网络;第三行让 LLM 输出奖励代码,再由强化学习算法训练策略。这里的箭头表达各方法的主要流程,不表示三篇论文互相调用。依据:[1] §4;[2] §3;[3] §3。
| 要问的问题 | MARFT [1] | LLM-MCA / LLM-TACA [2] | ReMAC [3] |
|---|---|---|---|
| 谁执行环境动作? | LLM 智能体 | Double DQN 策略网络 | MASAC 中的策略网络 |
| LLM 做什么? | 推理、生成答案或代码 | 看轨迹,分配 credit、解释,必要时给任务提示 | 生成并修改奖励函数代码 |
| 核心优化对象 | LLM 智能体的协作策略 | 接收个体反馈的策略网络 | 奖励函数与其对应的策略团队 |
| 反馈形式 | 答案正确性、测试通过率,经 critic 转成优势估计 | 按成员、按时间步组织的数值 credit | 个体奖励 + 团队奖励 |
| 实验场景 | 数学、代码 | 矩阵博弈、网格采集、仓库等 | 仿真机械臂协作操作 |
| 最容易混淆的点 | 多个角色不等于已经训练出协作 | 被训练的机器人策略不是 Gemma 本身 | 写奖励代码不等于直接输出机械臂动作 |
读后面时只要记住一句:第一篇是“训练 LLM”,后两篇主要是“用 LLM 帮忙训练其他策略”。
1. 预备知识:为什么团队学习比单人学习更难?
1.1 从“预测下一个词”到“选择下一步行动”
自回归语言模型按以下方式分解序列概率:
\[p_\theta(x_t\mid x_{\lt t})\]模型根据前文,为下一个 token 给出概率。在强化学习里,可以用相似的眼光看策略:
\[\pi_\theta(a_t\mid o_t)\]这里的 $o_t$ 是当前可见的信息,$a_t$ 是动作。机械臂的动作可以是末端位移,网格机器人可以选择上下左右,语言智能体的一次动作则可以是一段推理、代码或工具调用。
相似处在于都由模型产生输出;区别在于强化学习还要追踪输出对后续环境和最终结果的影响。
用一个常见的教学写法,策略希望最大化:
\[J(\theta)= \mathbb{E}_{\tau\sim\pi_\theta} \left[\sum_{t=0}^{T}\gamma^t r_t\right]\]- $\tau$:一整段经历,即轨迹,包括观测、动作和奖励。
- $r_t$:环境或训练规则在第 $t$ 步给出的奖励。
- $\gamma$:折扣因子,控制未来奖励在当前目标中的权重。
- $\theta$:最终需要通过训练更新的策略参数。
这是理解三篇文章的公共语言,不是说三篇论文使用完全相同的目标函数。[1] §3–4;[2] §3.1;[3] §2。
1.2 “团队得了分”不等于“每个人都知道该怎么改”
假设两个人搬桌子:A 扶住一端,B 扶住另一端,一起抬起,最后成功放下。环境只在最后给一个成功奖励。
这里有两个不同问题:
| 维度 | 问题 | 搬桌子的例子 |
|---|---|---|
| 时间信用分配 | 哪一步对后来成功有帮助? | 之前的抓稳、等待、抬起分别起了什么作用? |
| 结构信用分配 | 哪个成员做出了什么贡献? | A 的稳定支撑和 B 的引导移动该怎样评价? |
“信用”是 credit 的直译,这里不是银行信用,而是把结果与产生结果的行为联系起来,为学习提供贡献信号。
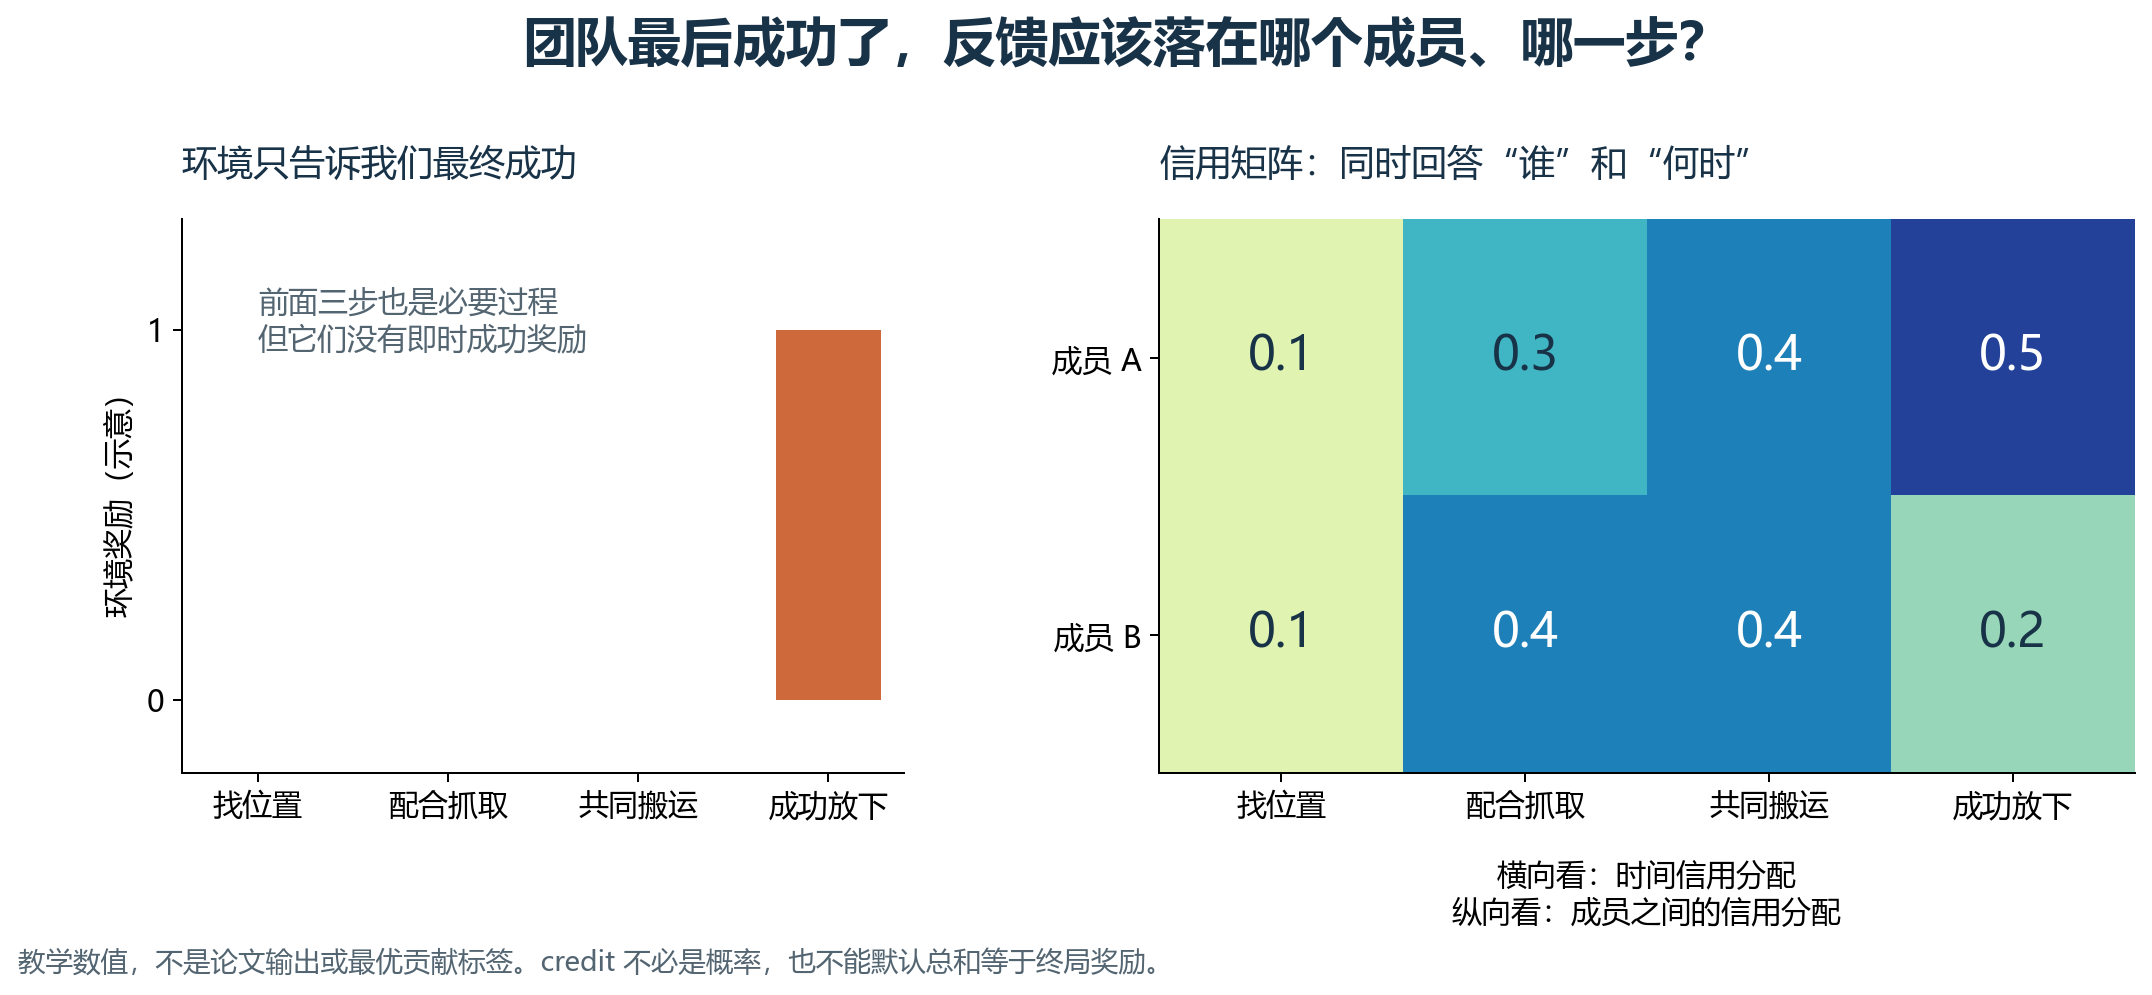
图 2 · 为什么需要更具体的反馈。 左图只有最后一步得到环境奖励,右图把反馈展开成“成员 × 时间”的矩阵。沿一行看,是一个成员在不同时间的贡献;沿一列看,是同一步不同成员的贡献。右图数字是本文构造的教学示例,不是论文实验输出,也不是已验证的真实贡献。credit 不是概率分布,不能默认它们相加必须等于左侧的终局奖励。概念依据:[2] PDF pp.2、4–6。
1.3 还有一个问题:队友也在学习
如果 A 昨天总是向左,B 可以围绕这个习惯学习;但 A 今天更新了策略,改成向右,B 昨天学会的配合可能突然失效。
这就是多智能体学习里常说的非平稳性:从一个成员的视角看,环境变化的一部分来自其他成员策略的变化。
因此会出现 CTDE:集中训练、分散执行 这一思路:
训练时,教练可以汇总团队信息来指导学习;执行时,由各成员自己的策略做决定。
不过,“分散执行”描述的是决策结构,不自动等于所有实验都只有局部观测。LLM-MCA 的部分环境采用局部观测;ReMAC 的当前 ManiCraft 设置则让每个成员获得全局观测。读论文时要把“谁做决策”和“谁看得到什么”分开。[2] §1、§4;[3] §4、附录 B.1。
2. MARFT:不只是让 LLM 合作,而是训练它们怎样合作
2.1 从熟悉的工作流进入
先看一个两人组合:
题目 → Reasoner 分析思路 → Actor 按思路求解 → 环境验证答案
在这种工作流里,后一个成员的输入包含前一个成员的输出。这与“大家同时、互不依赖地选动作”不同。
MARFT 用 Flex-MG 表达这种依赖。它引入依赖函数 $D$,例如:
\[D(a^i,a^j)=1\]表示成员 $j$ 的行动依赖成员 $i$ 的行动。可以把它理解为工作流里的“必须先拿到上游结果,才能完成下游决策”。框架允许依赖随时间改变;论文实际算法与主要实验采用顺序协作形式。[1] PDF pp.4–5。
和 LangGraph 的联系: 节点、边和状态描述协作过程;MARFT 进一步研究如何用任务反馈更新节点背后的可训练策略。工作流编排本身不等于强化学习。
2.2 后面的成员,应该在前面已经做了什么的条件下行动
论文把当前成员的策略写成:
\[a^m\sim\pi^m\left(a^m\mid s,a^{1:m-1}\right)\]其中 $s$ 是任务状态,$a^{1:m-1}$ 是排在前面的成员已经产生的动作。
例如,写代码的人不仅看原题,还看分析者给出的算法。这样优化“写代码的人”时,就要考虑:面对这份具体分析,他采取什么行动更有利于整个团队?
这里的顺序是成员之间的依赖顺序。不要把它与语言模型内部逐 token 生成的顺序混为一谈;两种顺序可以同时存在。
2.3 优势分解:团队改进可以拆成条件化的增量
论文借用多智能体优势分解定理:
\[A^\pi(s,a^{1:n}) = \sum_{m=1}^{n} A^\pi(s,a^{1:m-1},a^m)\]优势 advantage 表示相对某个基准,当前选择有多好。 它不是“答对了几分”,而是“比基准预期好多少”。
可以用一个望远镜求和的教学例子理解。假设按照同一套条件价值定义:
| 已确定的行动 | 条件价值(教学数值) |
|---|---|
| 尚未固定任何成员的行动 | 0.2 |
| 固定 A 的行动 | 0.5 |
| 再固定 B 的行动 | 0.8 |
那么总增量是 $0.8-0.2=0.6$,也等于:
\[(0.5-0.2)+(0.8-0.5)=0.3+0.3\]前一项对应先固定 A 后的增量,后一项对应已经固定 A 时再固定 B 的增量。
这帮助理解了为什么顺序条件化有用。但要记住:它不是与顺序无关的“真实功劳排行榜”,也不是给每个 agent 随意打一个分之后再相加。分解依赖所定义的价值函数、策略和成员顺序。[1] PDF p.4,Theorem 1。
2.4 训练闭环到底怎样连接?
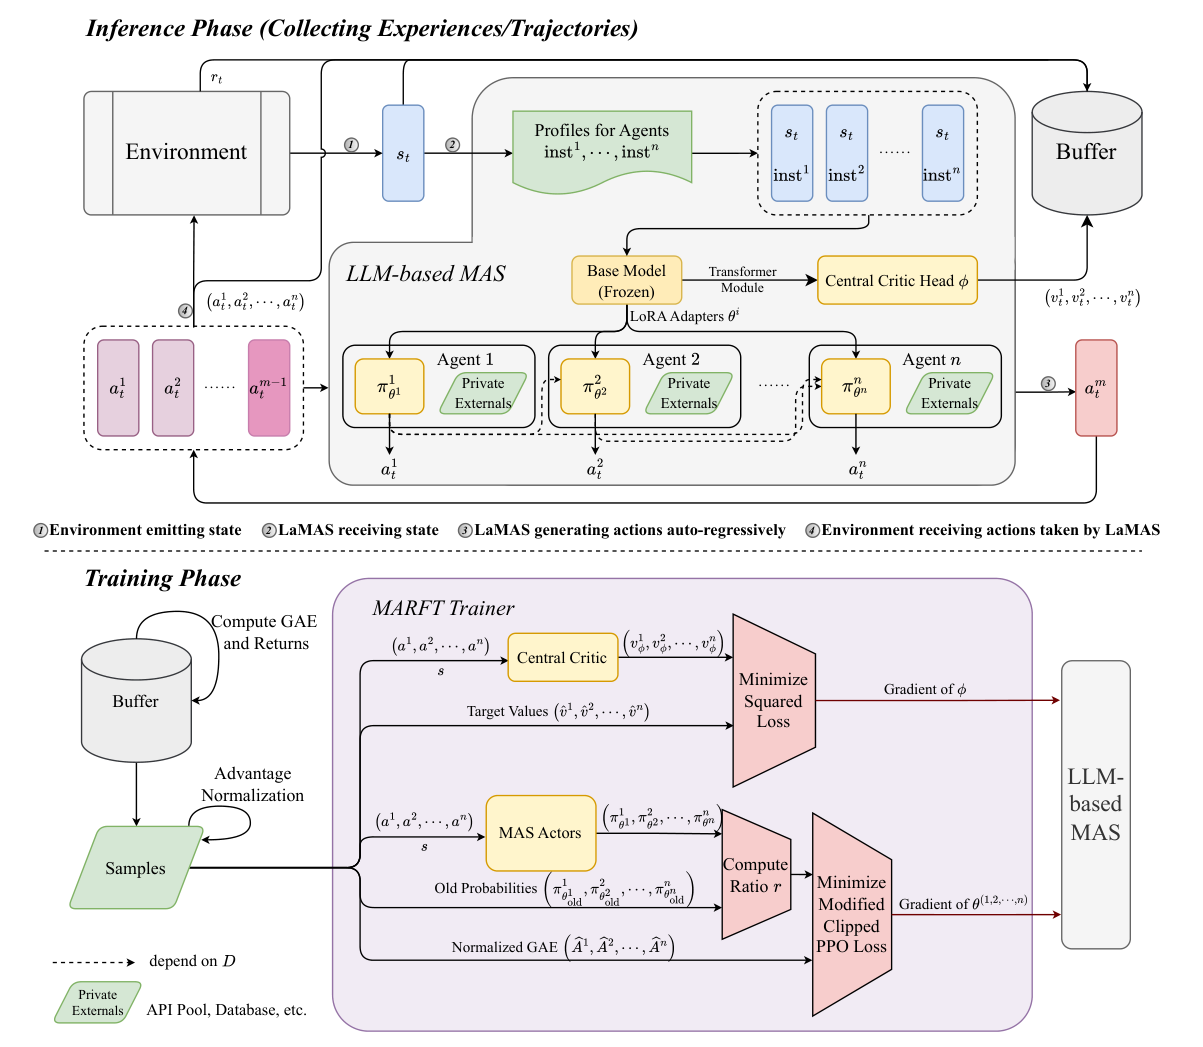
图 3 · MARFT 的真实训练流程。 原图来自 [1] PDF p.6,Figure 3。上半部分是采样:环境给状态,各角色读取自己的 profile 和依赖信息,产生动作,经历进入 buffer。下半部分是学习:中心 critic 估计价值,计算 GAE 等优势信号;actor 使用新旧策略概率比与 clipped PPO 目标更新。图中还区分冻结的基础模型与各角色的 LoRA。这里标注的 “Inference Phase” 是训练循环里的采样阶段,并不只指最终部署。
把它压缩成六步:
- 给不同角色设定 profile,并配置各自的 LoRA。
- 让团队按工作流完成题目,记录经历。
- 数学答案由验证器判对错,代码按测试用例通过率评分。
- 中心 critic 学习估计价值,计算优势信号。
- 在前序行动条件下,以 PPO 风格目标更新各角色。
- 用更新后的团队重新采样,继续训练。
如果只记一个优化公式,可以先记住 PPO 的核心形式:
\[L_{\mathrm{clip}} = \mathbb{E}\left[ \min\left( \rho\hat A,\, \operatorname{clip}(\rho,1-\epsilon,1+\epsilon)\hat A \right)\right]\]这里用 $\rho$ 表示新旧策略对已采样动作的概率比,避免与奖励 $r$ 混淆;$\hat A$ 是估计优势;$\epsilon$ 控制裁剪区间。它试图提高有利动作的概率,同时抑制过大的单次更新。上式是教学简写,省略论文中的成员、时间与条件变量。[1] PDF p.5,Eq.2。
裁剪是一种限制更新幅度的优化设计,不应理解为“实际训练保证每一步都变好”。
2.5 MARFT-A 与 MARFT-T:颗粒度越细,一定越好吗?
| 版本 | 把什么当作动作? | 直觉 | 需要处理的问题 |
|---|---|---|---|
| MARFT-A | 某个 agent 的完整输出 | 评价这次分析或这段代码的作用 | 完整文本动作空间很大 |
| MARFT-T | 一个 token | 更细地处理生成过程 | 序列更长,奖励传播更稀疏,价值学习也随之改变 |
在论文的 MARFT-T 构造里,中间 token 和前序成员没有即时任务奖励,奖励放在整段多智能体输出的最后一个 token。因此,token 级并不等于获得了更多真实监督,只是把决策过程切得更细。[1] PDF pp.5–6。
论文中的 DUO 数学实验里,MARFT-A 的曲线整体更好。但两者不仅粒度不同,Bellman 构造和学习率等也不同。这里值得记住的不是“token 级永远不行”,而是:
优化粒度需要与反馈粒度配合。切得更细,不代表每一小步都能得到更可靠的学习信号。
来源:[1] PDF p.8,Figure 6;PDF p.18,Tables 4、6。
2.6 结果:角色编排与协作训练的收益
在 MATH500 上,论文 Table 2 给出:
| 配置 | 正确率 |
|---|---|
| SOLO | 36.44% |
| 未微调 DUO | 43.90% |
| 在 MATH 上用 MARFT-A 微调的 DUO | 47.14% |
| 在 CMATH 上用 MARFT-A 微调的 DUO | 47.18% |
这里有两次不同的比较:
- SOLO → DUO: 36.44% 到 43.90%,对应组织成两角色工作流后的表现变化。
- DUO → 微调 DUO: 43.90% 到 47.14%,对应在该工作流上进一步训练,提升 3.24 个百分点。
CodeForces 的 DUO 也从 27.45 提升到 31.50。但未微调 TRIO 为 26.58,并没有随着成员数量增加而自动超过 DUO。因此,“成员多”与“配合好”是两件事。[1] PDF p.8,Tables 2–3。
此处采用 Table 2 的数值;同页正文中的 49.4% 和 83.0% 与表格有出入。代码任务的分数来自 Table 3,和数学题正确率分开看。
3. LLM-MCA:让 LLM 做一个能讲理由的训练教练
3.1 与 MARFT 的关键区别:这次不是训练大模型队员
LLM-MCA 中,环境里的成员由常规策略网络控制。LLM 位于训练反馈环节:它读取经历,分析谁做了什么,再输出数值 credit。
可以想象成:
队员实际练习,教练看录像。教练不替队员完成每个动作,而是把观察转成下一轮训练的反馈。
论文实验用 Gemma-7B 作为 LLM critic,策略使用 Double DQN。不要把“LLM critic”与前一篇通过价值损失训练的神经网络 critic 完全等同:这里强调的是 LLM 通过提示词与轨迹分析产生反馈。[2] PDF pp.4–6。
3.2 LLM 为什么看得懂这些经历?
不是直接扔给它一堆坐标,就期待它自动知道规则。论文的基础提示包含四类信息:
| 提示部分 | 作用 |
|---|---|
| 环境规则与目标 | 什么算成功,哪些行为会造成碰撞或失败 |
| 输入字段说明 | 数组每一项是什么意思,动作编号对应什么行为 |
| 信用与协作定义 | 怎样理解时间贡献、成员贡献、协作不足和协作过度 |
| 输出任务与格式 | 要给谁评分,输出多长的数组,如何提供解释 |
“协作过度”这个词很有意思。比如一个苹果只需要一个人摘,所有人却都跑过去,就会浪费机会;反过来,需要两个人一起搬的物体,只有一个人来,也是失败的协作。
目标不是让大家永远凑在一起,而是让恰当数量的成员在恰当任务上协作。 论文称之为 Agreement Problem。[2] PDF pp.4–5。
3.3 输出不能停留在一句“你们合作得不错”
LLM 需要给出可以接入训练的数值。用简化符号写:
\[C=\operatorname{Parse}\big( \operatorname{LLM}(\text{规则},\text{轨迹},\text{团队奖励}) \big)\]单条轨迹的 credit 可以组织成 $C\in\mathbb{R}^{T\times N}$:$T$ 个时间步,$N$ 个成员。每个元素 $c_t^i$ 对应一个成员在一个时间步的反馈。
自然语言解释帮助人理解;解析出来的数值才接入策略学习。论文用格式约束、正则解析与归一化,把文本变成数值数组。[2] PDF p.5,§3.2。
注意这里不是天然满足“分数守恒”的分账系统。论文使用 LLM 生成的代理目标指导学习,不能未经证明就认为它与原团队奖励目标完全等价。
3.4 一次看一批经历,比每一步都问一次更自然
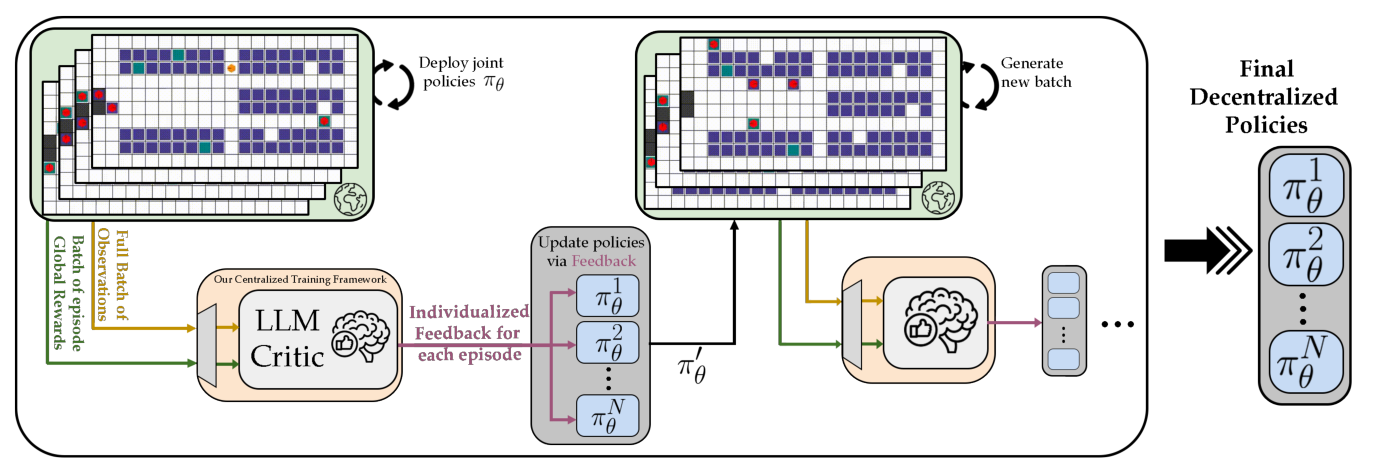
图 4 · 训练期有教练,执行期由策略独立行动。 原图来自 [2] PDF p.2,Figure 2。左侧把环境观测、动作与奖励汇集成批量轨迹,交给 LLM critic;中间用个体反馈更新策略,再采集新经历;右侧部署训练后的分散策略,不再需要 LLM critic。批量回顾既减少调用次数,也让评价能看到后续结果,而不是只凭当前一步判断。
这点很适合与之前的工作流知识连接:不是所有模块都必须出现在最终在线执行链里。 有些昂贵模块只用于训练阶段,产出的效果被保留在策略参数里。
3.5 LLM-TACA:既然按分工打分,不如把分工说清楚
假设教练心里想的是“A 去左边,B 去右边”,但没有告诉队员。A 恰好选择右边,结果被扣分,却不知道为什么。
LLM-TACA 在 credit 之外,再给出显式任务输入:
\[(c_t^i,\;g_t^i)\]这里用 $g_t^i$ 表示任务提示,避免与时间下标 $t$ 混淆;论文 Eq.3 使用的是任务变量 $t_k^i$。
接下来有一个实际问题:训练时有任务提示,执行时却没有,策略会不会离不开它?
论文的做法是随着训练推进,逐渐把任务输入替换成零,并增加相关输入神经元的 dropout,让策略降低对提示的依赖。可以理解为逐步撤掉辅助,但这是一种训练设计,不是所有环境里都自动成功的保证。[2] PDF p.6,§3.3。
3.6 结果怎么看:团队回报与贡献准确性要分开
论文在 LBF 的平均团队回报上报告:LLM-MCA 为 0.93,LLM-TACA 为 0.98,MAPPO 为 0.85;在 RWARE 上,相应平均值为 13.34、24.12 和 1.83。它们是各自 benchmark 的回报,不是跨任务通用的准确率。[2] PDF p.11,Table 1。
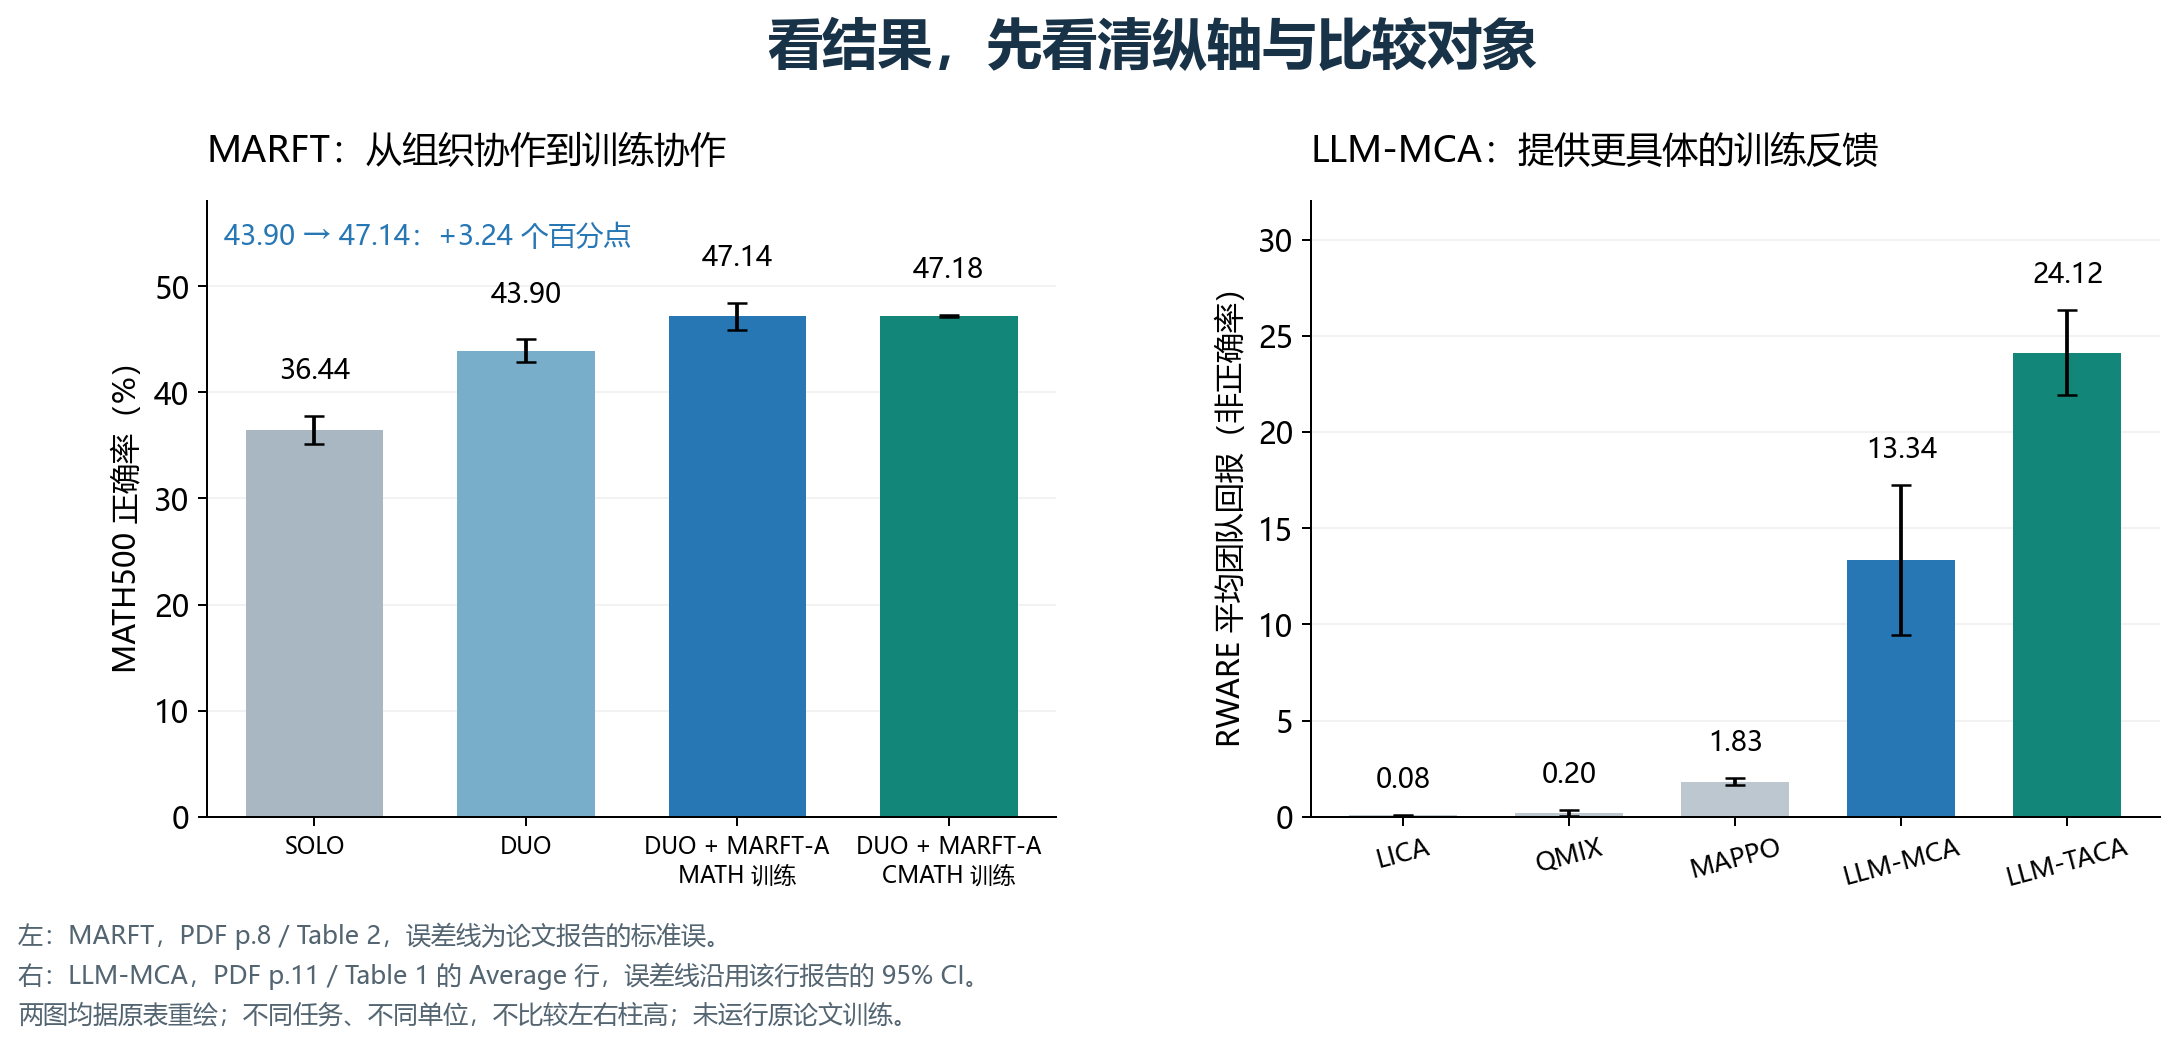
图 5 · 数学题正确率与仓库任务回报。 分别按 [1] Table 2 和 [2] Table 1 的 RWARE Average 行重绘。左图误差线为原表的标准误,右图为原表的 95% 置信区间。两边单位不同,分别在各自任务内比较。
这篇论文最值得带走的是一条可操作的思路:
让 LLM 对轨迹的理解落到结构化反馈上,才能真正接进数值学习过程。
团队分数、解释是否可读、解释是否对应真实贡献,是三个不同的评价维度。论文展示了前两类证据;要进一步判断因果贡献,还需要反事实或干预检验。
4. ReMAC:让 LLM 编写“怎样才算做得好”
4.1 从评一次作业,变成写评分规则
LLM-MCA 更像看完录像后给队员反馈;ReMAC 则让 LLM 写出可反复执行的奖励函数。
输入通常包含:
任务描述 + 环境代码 + 可用变量 + 奖励函数接口
输出不是“机械臂下一步向左移动”,而是:
怎样根据环境状态计算个体奖励?
怎样计算团队协作奖励?
随后每个环境步调用这些函数得到奖励,用 MASAC 训练执行动作的策略网络。因此,LLM 不需要在每个控制步重新读状态并打分。[3] PDF pp.3–5。
4.2 关键拆分:先学会自己的技能,再满足团队目标
ReMAC 为每个成员组合两类奖励:
\[r_i = r_i^{\mathrm{individual}} + r^{\mathrm{team}}\]以两个机械臂共同搬运为教学类比:
| 层次 | 可以指导什么 | 不能只看什么 |
|---|---|---|
| 个体奖励 | 接近抓取点、抓稳、把物体向目标移动 | 只靠近物体但不完成搬运 |
| 团队奖励 | 配合抓取、满足共同约束、完成任务 | 一味追求自己的动作指标而阻碍队友 |
公式中的加法对应两类任务要求:单个智能体的动作效果与团队共同完成任务的效果,需要同时体现在奖励中。
这里的奖励分解依然属于训练信号设计,并不自动等于精确测量了每个成员的因果贡献。[3] PDF p.5,§3.2。
4.3 为什么 exp(-distance) 这样的项有用?
论文展示的 Co-StackOn 奖励代码含有接近、抓取和物体移动等分量。例如,下面摘取其基本计算思想,以便理解:
reach_reward = np.exp(-distance)
move_reward = np.exp(-object_to_target_distance)
距离越小,值越大。相比“只有最终成功才得分”,它能为中间过程提供更密的反馈。上述片段对应 [3] PDF p.9 的代码示例,不是一份完整可运行的环境奖励实现。
但也容易看到一个隐患:如果“接近物体”的奖励过强,策略可能一直停在物体旁边,而不愿冒险抓起它。
所以 ReMAC 的方法不是让 LLM 一次写完就结束,而是看训练反馈,继续调整奖励结构、权重和计算方式。
4.4 两层循环:里面学动作,外面改奖励
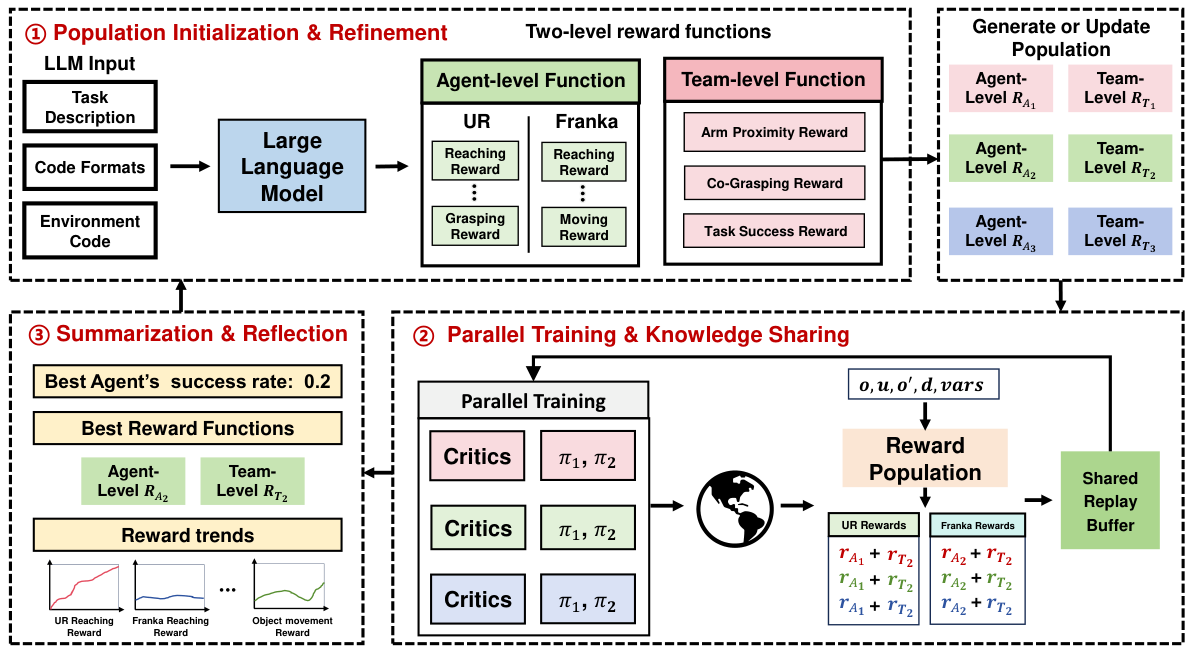
图 6 · ReMAC 最重要的是闭环。 原图来自 [3] PDF p.4,Figure 2。上方生成多个“个体奖励 + 团队奖励”候选;右下方为每个候选训练对应的策略团队,共享环境经验;左下方汇总成功率和奖励分量变化,再交给 LLM 改进候选。种群中的一个个体是一套奖励方案及其对应的策略团队,不是一个机器人。 图中画出的候选数量是示意,实验种群大小为 5。
这里存在两个速度不同的循环:
- 内层循环: 在当前奖励下与环境交互,用 MASAC 更新策略。
- 外层循环: 隔一段环境步数,用成功率和奖励分量趋势评估方案,让 LLM 修改奖励代码。
论文使用 5 个候选,依据任务难度每 200k 或 500k 环境步进行一次演化。[3] PDF p.23,附录 B.1。
4.5 共享经验,不等于共用一套奖励
同一条经验,例如“两个机械臂接近了目标但发生阻挡”,可以被不同候选奖励函数重新评分:
\[(s,a,s') \longrightarrow r^{(1)},r^{(2)},\ldots,r^{(K)}\]这是教学简写,实际 buffer 还保存终止状态等训练所需字段。
共享的是发生过什么;不同的是怎样评价这件事。 因而多个策略团队可以利用共同收集的经历,按照各自的奖励进行学习。[3] PDF p.5,§3.3。
4.6 不只告诉 LLM“分数低”,还告诉它哪里没有学会
ReMAC 的反思有三个层次:
| 层次 | 看什么 | 可能怎样修改 |
|---|---|---|
| 技能 | 某个技能对应的奖励是否真在指导学习 | 修改距离函数、尺度或触发条件 |
| 个体 | 某个成员是否缺少必要指导,或存在干扰项 | 增删该成员的奖励分量 |
| 团队 | 个体都在行动,为什么合作仍然失败 | 修改协作条件或团队奖励 |
例如,成功率一直不变,但接近奖励已经很高,接下来需要看的就不是“再增加接近奖励”,而可能是抓取、转移、配合条件是否缺失。
论文给出的反思提示和规则见 [3] PDF pp.30–32。
4.7 实验结论:任务结构决定奖励设计的效果
ManiCraft 的 Table 1 列出 11 个任务定义,其中 Co-Sweep 有三档难度;主结果 Figure 3 展示 9 个任务标签。下图按 Figure 3 的标签与柱上均值重绘。
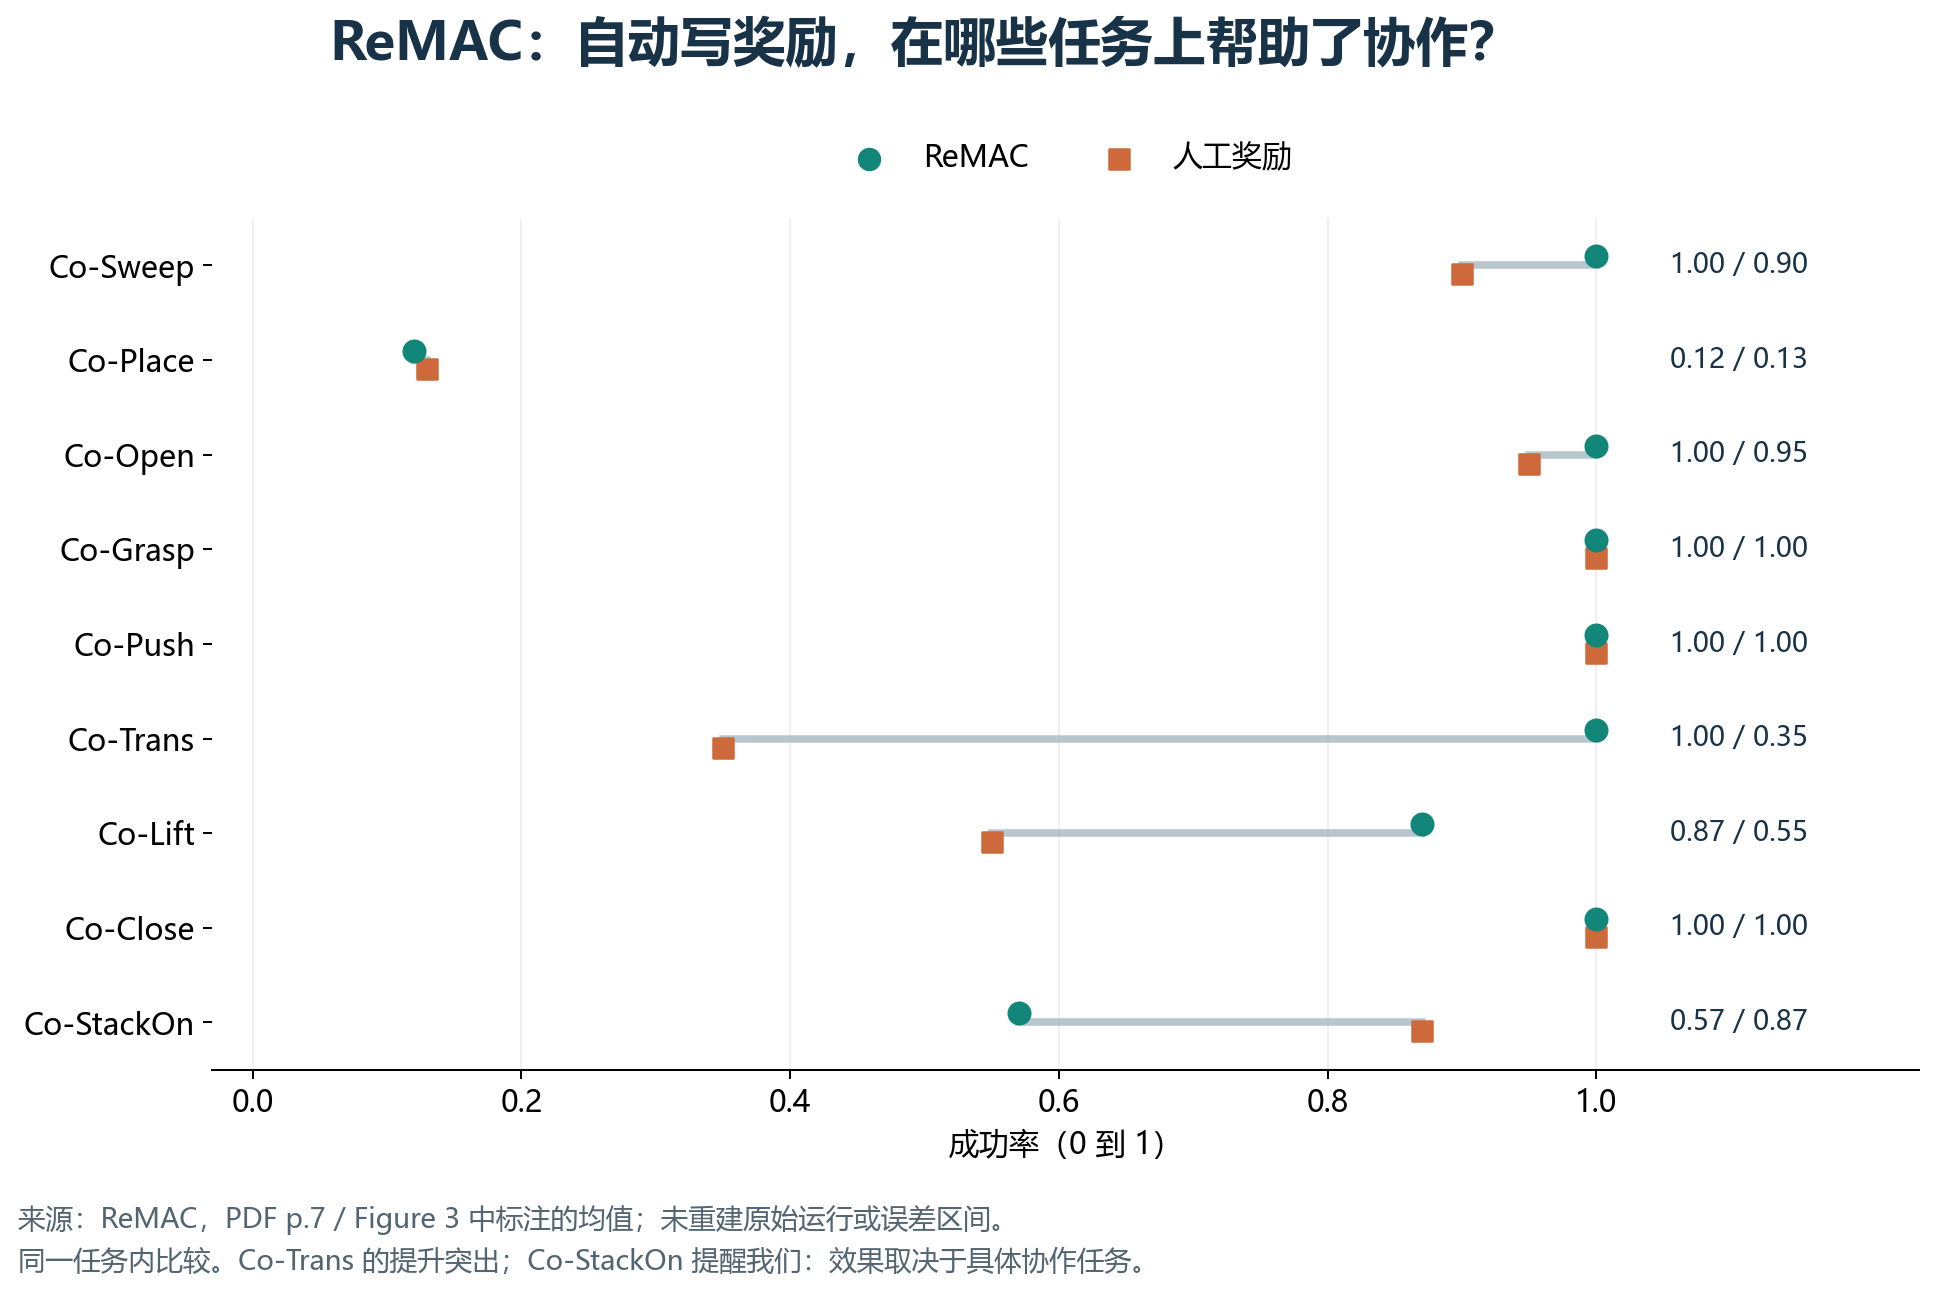
图 7 · 同一任务内比较奖励方案。 按 [3] PDF p.7,Figure 3 标注的均值重绘。圆点为 ReMAC,方点为人工奖励。Co-Trans 为 1.00 对 0.35,Co-Grasp、Co-Push、Co-Close 的均值相同,Co-StackOn 为 0.57 对 0.87。奖励方案的表现随任务变化,值得结合各任务的协作要求来看。
消融实验还回答了“哪些设计值得保留”:
- 双层奖励: Co-Sweep、Co-Open 中,相比统一团队奖励,分开设计个体和团队奖励的表现更好。
- 奖励种群: 移除种群后,Co-Sweep、Co-Open、Co-Grasp、Co-Trans 的成功率分别由 1.00 降至 0.30、0.47、0.38、0.03。
- 共享经验: 所展示的 Co-Sweep、Co-Open 实验中,共享经验改善了学习速度与最终表现。
这些结果分别来自 [3] Figures 5–7,支持相应组件在这些实验设置中的作用。种群也会改变探索与训练资源的组织方式,因此不把消融读成对单一因素的无限泛化。
这篇最值得记住的机制是:
LLM 提供候选规则,强化学习产生行为反馈,环境成功率检验这些规则是否真的有用。
5. 三篇合起来:一套“行动—反馈—学习”的坐标系
5.1 三者的差别,不是换一个名字叫 reward
| 概念 | 回答什么问题? | 本次阅读中的典型形式 |
|---|---|---|
| Reward:奖励 | 当前发生的事情按规则值多少分? | 答案判分、测试通过率、距离与成功项 |
| Credit:贡献反馈 | 该把怎样的学习反馈给哪个成员、哪一步? | LLM-MCA 输出的个体数值数组 |
| Advantage:优势 | 当前行动比某个基准预期好多少? | MARFT 中用于策略更新的估计量 |
| Policy:策略 | 看到信息后采取什么行动? | LLM 输出策略、Double DQN、MASAC actor |
它们有关联,但不能混写成同一个量。例如,一个动作奖励为正,并不意味着它的优势一定为正:如果它比基准预期差,优势仍可能是负的。
5.2 同样是“让 LLM 帮忙”,调用位置决定工程形态
| 观察角度 | MARFT | LLM-MCA | ReMAC |
|---|---|---|---|
| LLM 的主要输出 | 行动文本 | 数值 credit 与解释 | 奖励函数代码 |
| 怎样进入训练? | 环境反馈经 critic/优势估计更新 LLM 参数 | 解析后的 credit 训练策略网络 | 运行奖励代码,为策略提供训练信号 |
| 核心检查点 | 角色依赖、优势估计、策略更新 | 轨迹表达、输出解析、反馈尺度 | 奖励接口、分量设计、成功率反馈 |
| 主要成本位置 | 模型采样、梯度更新、环境验证 | 批量轨迹的 LLM 评价 | 奖励候选搜索与多团队训练 |
调用发生的位置决定了不同的运行开销:每步生成动作、批量评价轨迹和搜索奖励候选,对调用频率与计算成本的要求不同。
5.3 能不能把三者组合?
从接口角度,可以设想:让 ReMAC 风格的方法设计奖励,让 LLM-MCA 风格的方法提供更细的反馈,再用 MARFT 风格的训练更新语言智能体。
但这目前只能视为一个待验证的组合设想。它们的状态、动作、奖励与训练算法并不相同,把框图接上不代表方法就成立。
最重要的问题反而是:反馈是否保持一致?如果终局验证器认为答案错了,语言评价却因为过程流畅而给高分,策略到底该学什么?
所以组合前先确定:哪个信号定义最终任务成功,哪些信号只用于辅助学习。
6. Agent 系统的比较维度
6.1 多智能体不是“人数竞赛”
增加成员会增加分工机会,也会增加传递错误、重复工作和协调成本。MARFT 的 SOLO、DUO、TRIO 对照,以及 LLM-MCA 对协作过度的讨论,都说明角色数量需要结合任务的协作需求判断。
6.2 会生成解释,与解释已经被验证,是两个层次
一个 LLM 可以写出很像样的“为什么 A 比 B 贡献大”。但更有力的检查是:在明确的环境与对照条件下,替换某个行为后,结果是否按解释所预测的方向变化?
自然语言解释给了人一个可检查的入口。要把它升级为因果贡献结论,还需要定义干预、基准和评价方式。不能直接把“移除一个成员后性能下降”当成适用于所有协作情境的唯一贡献标准,因为成员之间可能存在相互依赖。
6.3 不要只看训练奖励,还要看真实任务是否完成
奖励是训练用的工具,不是任务本身。
机械臂获得很高的接近奖励,不代表物体已经送到目标;语言智能体获得很高的过程评价,也不代表代码通过测试。ReMAC 把成功率与奖励分量趋势一起反馈给 LLM,正是在把“分数变化”与“行为目标”联系起来。
比较这类方法时,有四个具体问题:
- 谁在行动,谁在评价,谁的参数被更新?
- 评价信号来自环境验证、模型判断,还是可执行规则?
- 实验指标是训练 reward、最终成功率,还是对贡献本身的准确性评价?
- 图中的比较是否使用相同任务、单位和预算口径?
参考与资料
| 编号 | 本次阅读版本 | 重点回看位置 |
|---|---|---|
| [1] | 匿名作者,MARFT: Multi-Agent Reinforcement Fine-Tuning,ICLR 2026 匿名评审稿(PDF 标注 “Under review as a conference paper at ICLR 2026”) | PDF pp.4–6:依赖、优势分解、训练流程;p.8:Tables 2–3;p.18:超参数 |
| [2] | K. Nagpal, D. Dong, J.-B. Bouvier, N. Mehr,Leveraging Large Language Models for Effective and Explainable Multi-Agent Credit Assignment。引用版本标注 AAMAS 2025,arXiv:2502.16863v1 | PDF pp.4–6:方法与 TACA;p.2:Figure 2;p.11:Table 1 |
| [3] | P. Li, H. Tang, Y. Yuan, J. Hao,ReMAC: Large Language Model-Driven Reward Design for Multi-Agent Manipulation Collaboration。引用版本标注 NeurIPS 2025 | PDF pp.4–5:闭环;pp.7–9:实验与消融;pp.23–24:训练设置;pp.30–32:提示词 |