· 算法设计与分析 / 选择问题 / 随机快速选择 / 中位数的中位数 / 线性时间
算法设计与分析 Day5:选择问题与线性时间算法
RedMoon · 2026-10-22 · 课堂阅读笔记
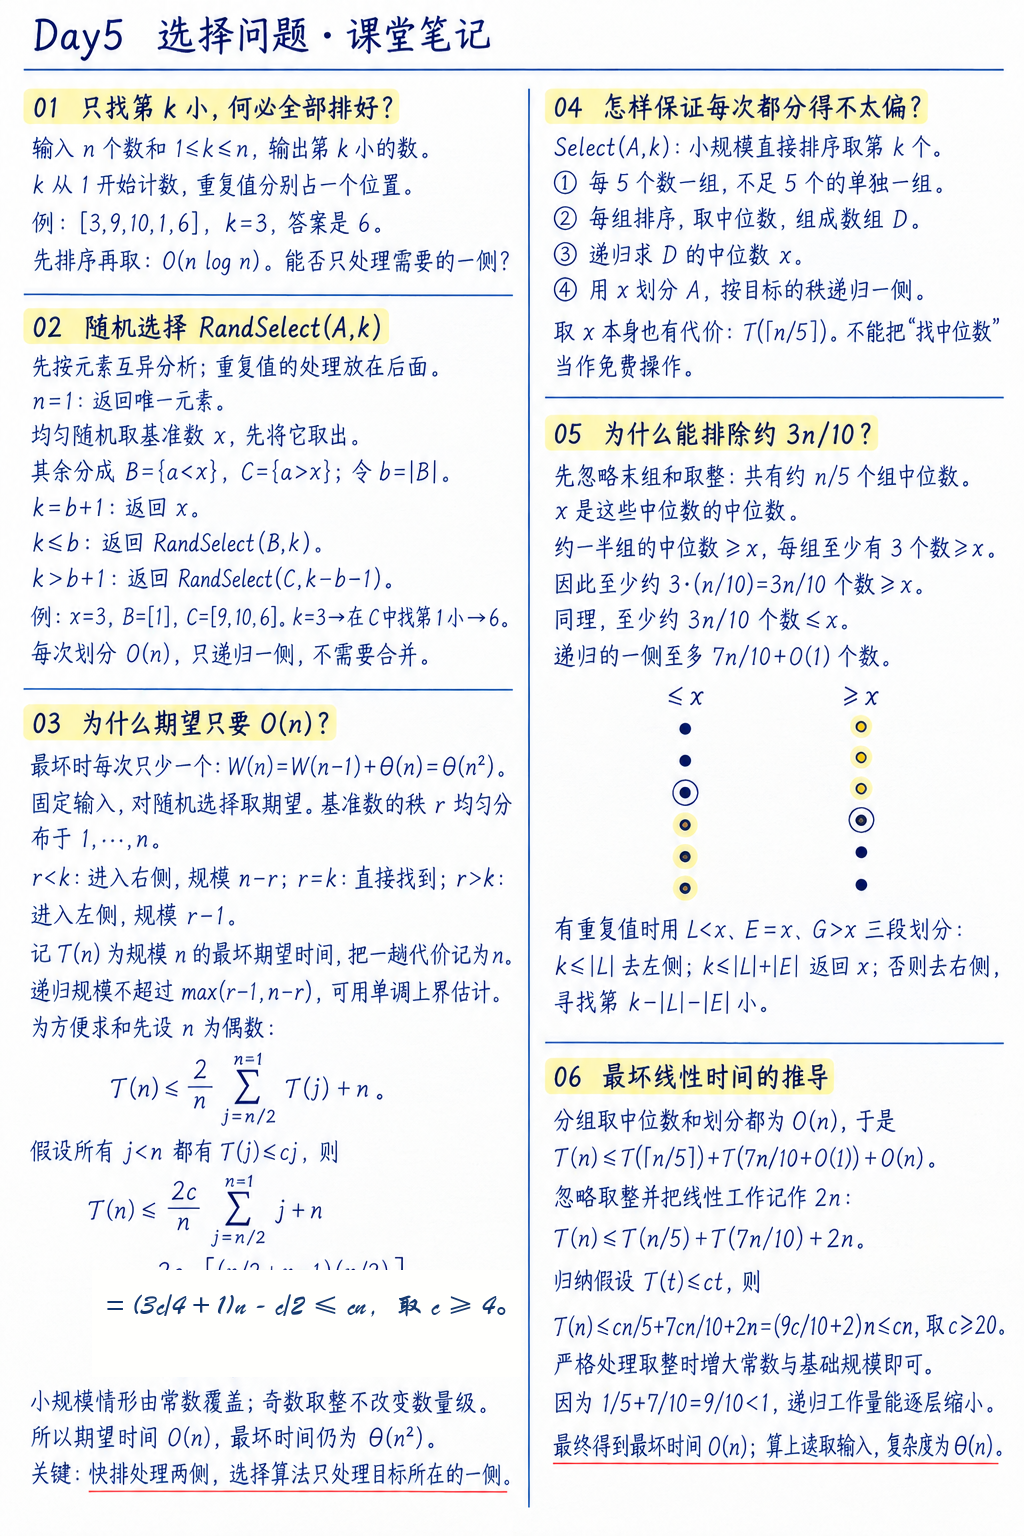
这节课接着分治方法往下走。排序要求把所有元素都放到正确的位置,而选择问题只关心其中一个位置:给定 $n$ 个数和一个整数 $k$,找出第 $k$ 小的数。看上去只是少做一点工作,算法结构却因此改变了:划分之后,目标只会落在一边,另一边可以直接放下。
课堂先从排序和分治框架回到选择问题,再沿着两个方向推进。随机选择利用一个均匀随机的基准数,平均只需线性时间;中位数的中位数则把基准数的质量固定下来,把最坏情况也压到线性时间。中间最值得记住的,是两段“先猜再证”的推导:一段得到随机算法的期望 $O(n)$,另一段得到确定性的最坏 $O(n)$。
一、从排序转到选择
1. 选择问题到底要返回什么
输入是数组 \(A=(a_1,a_2,\ldots,a_n)\) 以及一个满足 $1\le k\le n$ 的整数 $k$。输出是按非降序排列后排在第 $k$ 个位置的元素。重复值仍然分别占据位置,因此“第 $k$ 小”说的是排名,不是不同数值的个数。
例如:
- $A=[3,2,1,4]$,$k=2$,答案是 $2$;
- $A=[3,9,10,1,6]$,$k=3$,排序后为 $[1,3,6,9,10]$,答案是 $6$;
- 当 $k$ 取中间位置时,问题就变成寻找中位数。
最直接的做法是先排序,再读取 $A[k]$。比较排序需要 \(O(n\log n)\) 时间。这个答案当然正确,却把与目标无关的元素也全部排好了。选择问题真正追问的是:能不能只确认第 $k$ 个位置,而不把其他位置全部算清楚?
2. 分治框架在这里怎样变化
分治问题通常按四步处理:
- 边界处理:规模很小时直接解决;
- 分解:把原问题切成更小的子问题;
- 递归求解:分别得到子问题的结果;
- 组合结果:把子问题答案组织成原问题答案。
归并排序的分解很容易,组合需要线性合并;快速排序的组合很容易,但划分阶段需要扫描整个区间。选择问题比快速排序再少一步:划分之后只递归目标所在的那一侧,所以不需要同时维护两棵递归树,也不需要把两个排好序的结果重新合并。
这就是这节课的主线:
\(\text{一次划分 }O(n) \quad+\quad \text{只递归一侧} \quad\Longrightarrow\quad \text{有机会做到线性时间。}\)
3. 顺带回顾:什么叫就地处理
如果算法主要在原数组上交换和移动,只使用常数级辅助变量,通常称为就地处理。插入排序、堆排序和快速排序都可以按这种方式实现;归并排序在合并时通常需要额外数组,计数排序也要为值域建立计数结构。
选择算法的划分同样可以在原数组上完成。这里先用集合形式解释逻辑,真正写程序时再把它改成双指针或三指针的原地划分。
二、随机快速选择
1. 一次划分只留下目标所在的一边
先假设数组中的元素互不相同。均匀随机选出一个元素 $x$,把它从当前问题中单独取出,再把剩余元素分为 \(B=\{a\mid a<x\},\qquad C=\{a\mid a>x\}.\) 令 $b=|B|$。如果把所有元素按顺序写出来,$x$ 的排名就是 $b+1$:
- $k=b+1$:直接返回 $x$;
- $k\le b$:答案在 $B$ 中,继续找 $B$ 的第 $k$ 小;
- $k>b+1$:答案在 $C$ 中,改为找 $C$ 的第 $k-b-1$ 小。
与快速排序相比,快速排序会递归处理 $B$ 和 $C$ 两边;快速选择只保留包含目标排名的那一边。因此每一层虽然仍要扫描当前数组,但递归规模只沿一条路径下降。
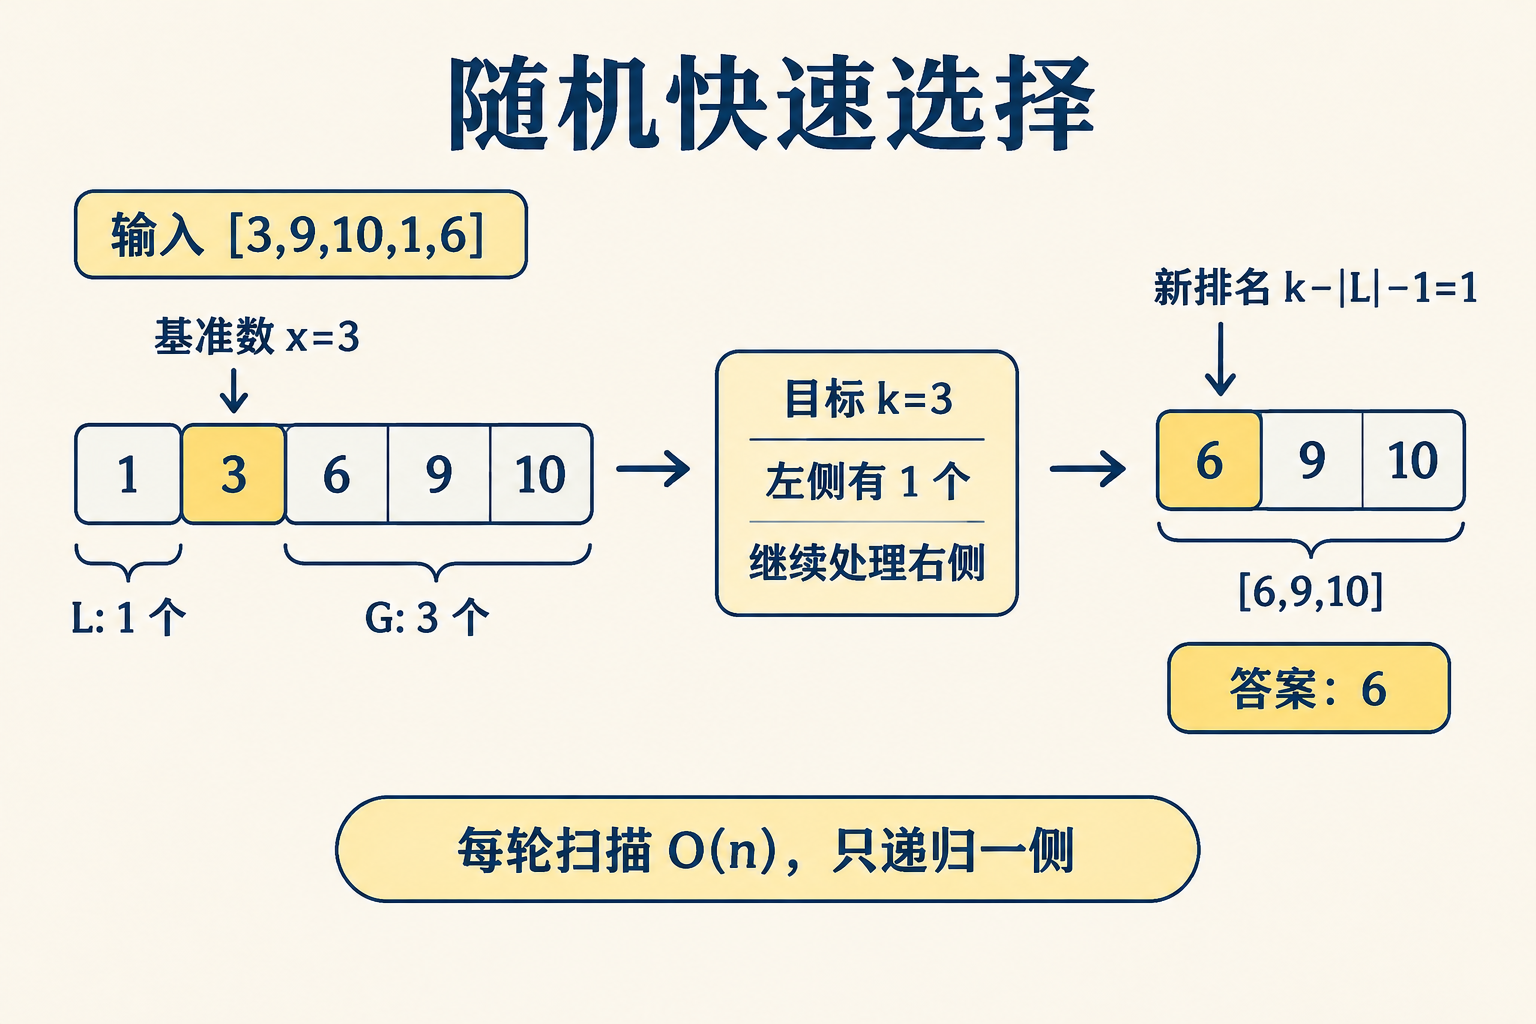
2. 伪代码
下面的写法把重复值也考虑进去。将数组分成 $L$、$E$、$G$ 三段:
- $L={a\mid a<x}$;
- $E={a\mid a=x}$;
- $G={a\mid a>x}$。
RANDOM-SELECT(A, k)
    如果 |A| 很小:
        直接排序 A,返回第 k 小

    均匀随机选择基准数 x
    按 x 把 A 划分为 L、E、G

    如果 k ≤ |L|:
        返回 RANDOM-SELECT(L, k)
    如果 k ≤ |L| + |E|:
        返回 x
    否则:
        返回 RANDOM-SELECT(G, k - |L| - |E|)
三段划分解决了一个容易被忽略的边界:如果数组中有很多相同元素,把其中一个 $x$ 简单塞进“小于等于 $x$”的一侧,可能让递归区间几乎不缩小;把相等元素单独收集起来,目标排名落入 $E$ 时可以整段结束。
3. 一个小例子
对 \(A=[3,9,10,1,6],\qquad k=3\) 取 $x=3$,则 \(L=[1],\qquad E=[3],\qquad G=[9,10,6].\) 左侧有 $|L|=1$ 个元素,前两段合起来有 $2$ 个元素,而 $k=3$,所以目标在 $G$ 中,新的排名为 \(k-|L|-|E|=3-1-1=1.\) 接下来只需在 $[9,10,6]$ 中找第 1 小的数,答案就是 $6$。右侧数组内部的顺序并不重要,真正需要保留的是它的排名关系。
三、为什么随机选择的期望时间是 $O(n)$
1. 最坏情况先放在这里
如果每次随机选到的数都恰好接近当前最小值或最大值,划分后只少掉一个元素。设一次划分的线性代价记为 $\Theta(n)$,最坏情况满足 \(W(n)=W(n-1)+\Theta(n).\) 展开以后就是 \(\Theta(n)+\Theta(n-1)+\cdots+\Theta(1) =\Theta(n^2).\) 所以“随机”并没有让每一种输入、每一种随机结果都变成线性;它改变的是平均意义下遇到坏划分的频率。
2. 对随机基准数取期望
固定一个输入,随机选择的基准数在输入中的秩 $r$ 均匀分布于 $1,2,\ldots,n$。假设我们寻找的是前半段的排名,即 $k\le n/2$。如果 $k>n/2$,可以把大小关系反过来,分析完全对称。
当基准数的秩为 $r$ 时:
- $r<k$:目标进入右侧,规模为 $n-r$;
- $r=k$:这次直接找到;
- $r>k$:目标进入左侧,规模为 $r-1$。
为了统一不同的 $k$,令 $T(n)$ 表示规模为 $n$ 时、对目标排名取最坏情况的期望时间,并把当前层的划分代价简写成 $n$。每个可能的递归规模都小于 $n$,而从 $n/2$ 到 $n-1$ 的规模至多各出现两次,于是得到上界 \(T(n) \le \frac{2}{n}\sum_{j=n/2}^{n-1}T(j)+n.\) 这个式子正是“每次只走一边”的数学表达:若两边都递归,递推式会保留两个子问题;这里只留下较大的那一边,并通过随机秩的均匀性把所有可能规模平均起来。
3. 先猜一个线性上界,再把它证出来
假设对所有 $j<n$,都有 \(T(j)\le cj.\) 将假设代入递推式: \(\begin{aligned} T(n) &\le \frac{2c}{n}\sum_{j=n/2}^{n-1}j+n\\ &=\frac{2c}{n}\cdot \frac{\left(\frac n2+n-1\right)\left(\frac n2\right)}{2}+n\\ &=\left(\frac{3c}{4}+1\right)n-\frac c2. \end{aligned}\) 只要 $c\ge4$,就有 \(\frac{3c}{4}+1\le c,\) 从而 \(T(n)\le cn.\) 规模很小时直接排序,其时间可以由基础情形的常数统一吸收。于是随机快速选择的期望时间为 \(\boxed{T(n)=O(n)}.\) 这里的分析方法很实用:面对一个看不出形状的递推式,可以先根据递归规模猜一个候选上界,再用归纳法检查常数是否能闭合。课堂里把它概括成“先猜,再证”。
四、从平均线性到最坏线性
随机快速选择的平均表现已经很好,但最坏情况仍然是 $O(n^2)$。如果任务需要一个无论怎样划分都稳定的上界,就不能把希望寄托在随机数上,必须主动构造一个不会太偏的基准数。
问题变成了:怎样在不先完整排序的情况下,找到一个“足够居中”的数?
中位数的中位数方法给出的答案是:
- 把数组每五个数分成一组;
- 找出每组的中位数;
- 递归求这些中位数的中位数,记为 $x$;
- 用 $x$ 划分原数组;
- 只在包含第 $k$ 小元素的一侧递归。
它没有要求 $x$ 恰好是整个数组的中位数,只要求 $x$ 足够靠近中间,能够保证两边都删掉一块固定比例的元素。
五、中位数的中位数算法
1. 算法步骤
设当前数组规模为 $n$。
- 当 $n$ 很小(例如不超过 10)时,直接排序并取第 $k$ 个;
- 从左到右每五个元素分成一组,最后不足五个的元素单独成组;
- 每组内部只需找中位数,得到中位数数组 $D$;
- 递归求 $D$ 的中位数,得到 $x$;
- 用 $x$ 将原数组分成 $L,E,G$;
- 根据 $k$ 落在哪一段,只递归一侧。
伪代码如下:
SELECT(A, k)
    如果 |A| ≤ 10:
        直接排序 A,返回第 k 小

    将 A 每 5 个元素分为一组
    对每组排序,取出组中位数
    令 D 为所有组中位数组成的数组

    x ← SELECT(D, ceil(|D| / 2))
    按 x 将 A 划分为 L、E、G

    如果 k ≤ |L|:
        返回 SELECT(L, k)
    如果 k ≤ |L| + |E|:
        返回 x
    否则:
        返回 SELECT(G, k - |L| - |E|)
这里要把 $D$ 的递归代价写进分析。找“中位数的中位数”并不是免费的操作,它本身需要处理大约 $n/5$ 个元素。
2. 为什么五个一组
五个元素的中位数两边各至少有两个元素,而连同中位数本身,一侧至少能数出三个元素。这个“3”正是后面 $3n/10$ 的来源。
如果每组只取三个元素,中位数一侧能保证的元素更少;如果组得过大,找每组中位数的代价和常数会变大。五个一组在证明和实现之间取得了一个常用的平衡。
六、为什么至少能排除约 $3n/10$
为了看清比例,先暂时忽略最后一组不足五个的情况,也忽略向上取整。这样大约有 \(\frac n5\) 个五元组,也就有 $n/5$ 个组中位数。
令 $x$ 是这些组中位数的中位数。于是,至少约有一半的组中位数不小于 $x$,也就是约有 \(\frac12\cdot\frac n5=\frac n{10}\) 个组的中位数满足“$\ge x$”。
对其中任意一个五元组,既然它的中位数 $\ge x$,那么这个组里至少有三个元素 $\ge x$:中位数本身以及排在它右边的两个元素。因此,整个数组中至少有 \(3\cdot\frac n{10}=\frac{3n}{10}\) 个元素满足 $\ge x$。
完全对称地,至少有 $3n/10$ 个元素满足 $\le x$。所以无论目标落在左边还是右边,递归的一侧至多保留 \(n-\frac{3n}{10} =\frac{7n}{10}\) 个元素。考虑末组和取整以后,写成 \(\frac{7n}{10}+O(1)\) 更稳妥。
这里的“排除”不是把元素从数组里物理删除,而是证明它们不可能再进入下一次递归。算法只需保留目标排名所在的那一段。
七、最坏情况线性时间的推导
一轮中位数的中位数选择包含三部分线性工作:
- 扫描并分成五元组;
- 找出各组中位数;
- 用 $x$ 扫描并划分原数组。
除此之外,有两次递归:
- 在中位数数组 $D$ 上递归,规模约为 $n/5$;
- 在原数组的一侧递归,规模至多为 $7n/10+O(1)$。
因此 \(T(n) \le T\left(\left\lceil\frac n5\right\rceil\right) +T\left(\frac{7n}{10}+O(1)\right) +O(n).\) 课堂推导时先忽略取整,把所有线性工作记作 $2n$,得到更容易观察的式子: \(T(n)\le T(n/5)+T(7n/10)+2n.\) 继续采用“先猜再证”。假设所有 $t<n$ 都满足 \(T(t)\le ct.\) 代入: \(\begin{aligned} T(n) &\le c\frac n5+c\frac{7n}{10}+2n\\ &=\left(\frac c5+\frac{7c}{10}+2\right)n\\ &=\left(\frac{9c}{10}+2\right)n. \end{aligned}\) 只要 \(\frac{9c}{10}+2\le c,\) 也就是 $c\ge20$,就能得到 \(T(n)\le cn.\) 严格处理向上取整和末组时,只会多出低阶的常数项。增大基础规模和常数 $c$ 后,归纳仍然可以闭合。因此: \(\boxed{T(n)=O(n)}\) 是中位数的中位数算法的最坏时间上界。读入 $n$ 个元素本身就需要 $\Theta(n)$ 时间,所以在通常的输入模型下,整体复杂度可以写成 \(\boxed{\Theta(n)}.\) 递推式真正起作用的地方是 \(\frac15+\frac7{10}=\frac9{10}<1.\) 两条递归路径合起来,每一层的总规模仍在缩小;线性工作不会逐层累积成平方级。
八、两种选择算法放在一起看
| 方法 | 每轮基准数 | 递归方向 | 平均时间 | 最坏时间 | 主要代价 |
|---|---|---|---|---|---|
| 先排序再取 | 无 | 无 | $O(n\log n)$ | $O(n\log n)$ | 做完了全部排序 |
| 随机快速选择 | 均匀随机元素 | 一侧 | $O(n)$ | $O(n^2)$ | 依赖随机划分 |
| 中位数的中位数 | 递归构造 | 一侧 | $O(n)$ | $O(n)$ | 常数较大,实现更复杂 |
这三种方法并不是简单的“后者一定替代前者”。如果只需要一次选择,随机快速选择通常结构更轻;如果必须给出确定的最坏线性保证,中位数的中位数才是对应的方案;如果数组很小,直接排序反而最清楚。
九、这节课留下的几个判断
第一,选择问题与排序问题的差别不在输入,而在输出要求。只要输出只涉及一个排名,就应该检查是否能在划分后丢掉一侧。
第二,随机算法的线性时间是期望意义下的结论。分析时不能把“平均 $O(n)$”写成“每次都 $O(n)$”,最坏情况仍然要单独说明。
第三,复杂度证明里,线性代价和递归规模必须同时写出。中位数数组的 $T(n/5)$ 不能省略,正是这一步决定了证明是否完整。
最后,三路划分让重复值的处理回到排名本身:先数清楚小于 $x$ 的元素,再看第 $k$ 个位置是否落在等于 $x$ 的区间,剩下的排名才传给右侧。算法看似在“找一个数”,实际一直在维护这个数应有的位置。
十、课后作业解答:随机选择的最坏划分
题目 9.2-4
给定数组
\(A=\{3,2,9,0,7,5,4,8,6,1\},\)
使用 RANDOMIZED-SELECT 查找最小元素。题目要求描述一种会使算法达到最坏情况的划分序列。
解答
查找最小值时,目标排名是 $k=1$。每次划分都选当前活动数组中的最大元素作为基准数,就会让其他所有元素落在它的左侧,而右侧为空。由于基准数是最大值,最小值仍在左侧,算法只能继续在规模少一个元素的左侧数组中查找。
用集合表示当前活动元素(不强调数组内部顺序),一种最坏划分序列如下:
| 当前活动元素 | 选作基准数 | 递归处理的左侧 |
|---|---|---|
| ${0,1,2,3,4,5,6,7,8,9}$ | $9$ | ${0,1,2,3,4,5,6,7,8}$ |
| ${0,1,2,3,4,5,6,7,8}$ | $8$ | ${0,1,2,3,4,5,6,7}$ |
| ${0,1,2,3,4,5,6,7}$ | $7$ | ${0,1,2,3,4,5,6}$ |
| ${0,1,2,3,4,5,6}$ | $6$ | ${0,1,2,3,4,5}$ |
| ${0,1,2,3,4,5}$ | $5$ | ${0,1,2,3,4}$ |
| ${0,1,2,3,4}$ | $4$ | ${0,1,2,3}$ |
| ${0,1,2,3}$ | $3$ | ${0,1,2}$ |
| ${0,1,2}$ | $2$ | ${0,1}$ |
| ${0,1}$ | $1$ | ${0}$ |
在三段划分的记号中,每一轮都是 $L=S\setminus{x}$、$E={x}$、$G=\varnothing$,其中 $x$ 是当前最大元素;算法随后对 $L$ 继续查找第 $1$ 小元素。活动数组的规模因此依次为 $10,9,8,\ldots,2,1$。
每轮划分都要扫描当前活动数组,累计工作量为
\(\Theta(10+9+\cdots+2)=\Theta(10^2).\)
将 $10$ 换成一般规模 $n$,就是
\(\Theta(n+(n-1)+\cdots+2)=\Theta(n^2),\)
这正是 RANDOMIZED-SELECT 的最坏时间复杂度。随机选择只保证这种划分序列不一定经常出现,并不排除它发生。对于这里这条具体序列,若每轮都从当前元素中均匀随机选基准数,其概率为
\(\frac1{10}\cdot\frac1{9}\cdots\frac1{2}=\frac1{10!}.\)
十一、课后作业解答:两个有序数组的中位数
题目
课后作业第 9.3-8 题要求:给定两个长度都为 $n$、且已经按非降序排列的数组 $X[1..n]$ 和 $Y[1..n]$,在 $O(\lg n)$ 时间内求出这两个数组全部 $2n$ 个元素的中位数。
因为总共有 $2n$ 个元素,中位数定义为排好序后第 $n$ 个元素和第 $n+1$ 个元素的平均值。直接合并两个数组需要线性时间,题目要求更快,所以关键是用二分查找确定“前半部分应该从两个数组各取多少个元素”。
1. 用一条分界线把两边分开
假设从 $X$ 的前面取出 $i$ 个元素放入左半部分,那么左半部分还需要从 $Y$ 的前面取出 \(j=n-i\) 个元素。这样左半部分始终恰好有 $n$ 个元素,右半部分也恰好有 $n$ 个元素。
我们只需要在 $i=0,1,\ldots,n$ 中找到正确的位置。为了比较分界线两侧最接近的元素,记:
\[x_L= \begin{cases} -\infty,& i=0,\\ X[i],& i>0, \end{cases} \qquad x_R= \begin{cases} +\infty,& i=n,\\ X[i+1],& i<n, \end{cases}\] \[y_L= \begin{cases} -\infty,& j=0,\\ Y[j],& j>0, \end{cases} \qquad y_R= \begin{cases} +\infty,& j=n,\\ Y[j+1],& j<n. \end{cases}\]其中,$x_L$ 和 $y_L$ 是左半部分中分别来自两个数组的最大候选值,$x_R$ 和 $y_R$ 是右半部分中分别来自两个数组的最小候选值。用无穷大处理边界后,$i=0$ 或 $i=n$ 时不需要另写一套程序。
分界线正确,当且仅当 \(x_L\le y_R \qquad\text{且}\qquad y_L\le x_R.\)
这两个不等式合起来说明:左半部分的每个元素都不大于右半部分的每个元素。于是合并后的第 $n$ 个元素和第 $n+1$ 个元素分别是 \(\text{leftMiddle}=\max(x_L,y_L), \qquad \text{rightMiddle}=\min(x_R,y_R).\)
因此最终中位数为 \(\boxed{ \operatorname{median}(X,Y) = \frac{\max(x_L,y_L)+\min(x_R,y_R)}{2} }.\)
2. 如何二分查找 $i$
先令 $i$ 取区间 $[0,n]$ 的中点,再由 $j=n-i$ 自动确定 $Y$ 的取数个数。
- 如果 $x_L>y_R$,说明从 $X$ 的左半部分取得太多,应该减小 $i$,令
high = i - 1。 - 如果 $y_L>x_R$,说明从 $X$ 的左半部分取得太少,应该增大 $i$,令
low = i + 1。 - 如果两个条件都不成立,就找到了正确分界线。
之所以可以这样移动,是因为 $X$ 和 $Y$ 都已经有序。增大 $i$ 会让 $x_L$、$x_R$ 都不减;同时 $j=n-i$ 减小,会让 $y_L$、$y_R$ 都不增。因此,$x_L>y_R$ 表示 $i$ 已经偏大,$y_L>x_R$ 表示 $i$ 还偏小,错误方向具有单调性,可以用二分查找排除一半候选位置。
3. 伪代码
MedianOfTwoSortedArrays(X, Y, n):
    low  <- 0
    high <- n

    while low <= high:
        i <- floor((low + high) / 2)
        j <- n - i

        if i = 0:
            xL <- -infinity
        else:
            xL <- X[i]

        if i = n:
            xR <- +infinity
        else:
            xR <- X[i + 1]

        if j = 0:
            yL <- -infinity
        else:
            yL <- Y[j]

        if j = n:
            yR <- +infinity
        else:
            yR <- Y[j + 1]

        if xL > yR:
            high <- i - 1
        else if yL > xR:
            low <- i + 1
        else:
            leftMiddle  <- max(xL, yL)
            rightMiddle <- min(xR, yR)
            return (leftMiddle + rightMiddle) / 2
4. 正确性说明
循环中的每个候选位置都满足左半部分共有 $n$ 个元素,因为 $i+j=i+(n-i)=n$。如果出现 $x_L>y_R$,那么当前分界线把 $X[i]$ 放在了左边,却把更小的 $Y[j+1]$ 放在了右边,左边取自 $X$ 的数量过多,正确位置只能在更小的 $i$ 中。对称地,如果 $y_L>x_R$,则应增加 $i$。
当两个不等式同时成立时, \(\max(x_L,y_L)\le \min(x_R,y_R),\) 所以左半部分所有元素都不大于右半部分所有元素。左半部分正好包含合并序列的前 $n$ 个元素,右半部分正好包含后 $n$ 个元素。因此合并序列的第 $n$ 个元素是 $\max(x_L,y_L)$,第 $n+1$ 个元素是 $\min(x_R,y_R)$,算法返回的平均值正是全部 $2n$ 个元素的中位数。
5. 例子
设 \(X=[1,2,3,4], \qquad Y=[5,6,7,8].\)
此时 $n=4$。第一次取 $i=2$,则 $j=4-2=2$,有
\(x_L=2,\quad x_R=3,\quad y_L=6,\quad y_R=7.\)
虽然 $x_L\le y_R$,但 $y_L=6>x_R=3$,说明从 $X$ 取到左半部分的元素太少,于是令 low = 3。下一轮取 $i=3$、$j=1$:
\(x_L=3,\quad x_R=4,\quad y_L=5,\quad y_R=6.\)
仍有 $y_L=5>x_R=4$,所以再令 low = 4。此时取 $i=4$、$j=0$,边界值为
\(x_L=4,\quad x_R=+\infty,\quad y_L=-\infty,\quad y_R=5.\)
两个分界条件都成立,因此
\(\text{leftMiddle}=\max(4,-\infty)=4,
\qquad
\text{rightMiddle}=\min(+\infty,5)=5.\)
最终得到
\(\operatorname{median}(X,Y)=\frac{4+5}{2}=4.5.\)
如果把两个数组完全合并,会得到 \([1,2,3,4,5,6,7,8],\) 其中第 $4$ 个和第 $5$ 个元素正好是 $4$ 和 $5$,与算法结果一致。
6. 复杂度
每次循环只进行常数次比较和取值,候选区间每轮缩小约一半,因此循环次数为 $O(\lg n)$。算法不需要复制或合并数组,额外空间为 $O(1)$: \(\boxed{\text{时间复杂度 }O(\lg n),\qquad \text{额外空间复杂度 }O(1).}\)