· 大模型语言原理 / Scaling Law / 智能软件 / 多团队协作 / MLOps
大模型语言原理 Day2:规模规律、智能软件与多团队协作
RedMoon · 整理于 2026-10-21 · 课堂阅读笔记
一、这节课的两条主线
大模型的能力来自数据、模型、训练和适配;一个智能软件的可用性,还取决于运行环境、业务流程和团队协作。理解这两层目标的关系,才能解释两个常见现象:参数更多的模型未必是给定预算下最好的选择,离线分数更高的模型也未必带来更好的产品。
课件前半部分讨论语言模型、训练与适配、Scaling Law 和涌现能力;后半部分把模型放进语音转写、报税、机器人和聊天服务中。课堂转写进一步展开了推理系统、多团队接口、噪声音频处理和部署监控。两条主线最后汇合到同一个工程问题:怎样在明确目标和资源约束下,让模型能力成为可验证、可维护的系统能力。
二、语言模型的基础与能力来源
1. 从概率模型到三类架构
狭义语言模型为 Token 序列分配概率。自回归形式为:
\[P(x_{1:T})=\prod_{t=1}^{T}P(x_t\mid x_{<t}).\]每一步根据已有上下文预测下一个 Token,再把生成的 Token 接回上下文。序列概率来自模型学到的分布,不能直接当作事实正确率。
广义的语言模型还包括用于理解、表示和条件生成的预训练模型。课件列出三类结构:
| 结构 | 怎样利用上下文 | 例子与用途 |
|---|---|---|
| Encoder-only | 通常双向编码输入 | BERT、RoBERTa;分类、标注、表示学习 |
| Decoder-only | 在因果约束下逐步生成 | GPT 类模型;对话、开放生成、代码 |
| Encoder-Decoder | 编码输入,再条件生成输出 | T5、BART;翻译、摘要等文本转换 |
这些名称描述计算结构和训练使用方式,不构成能力排名。“大”也不是永恒的参数门槛:课件中的模型规模和发展图提供历史背景,实际选型还要比较数据、任务、推理成本和部署条件。
2. 预训练、适配与对齐
预训练用大规模语料构造自监督目标,学习语言规律、知识关联和可迁移表示。典型数据流程是多来源采集、质量过滤、去重、隐私处理、Token 化与数据配比;网页、书籍、代码和科学文本的比例会改变训练分布。高质量不仅指文字流畅,还包括正确性、覆盖度、来源和任务相关性。
适配先回答下游任务是什么、输入输出是什么、有多少标注数据,再选择方法。
| 方法 | 改变什么 | 主要作用 |
|---|---|---|
| 提示设计 | 本次输入的说明、材料、例子和格式要求 | 明确任务与回答约束 |
| 上下文学习 ICL | 本次请求的上下文,不更新参数 | 根据说明或示例完成当前任务 |
| 指令微调 SFT | 用指令—回答样本更新参数 | 学习遵循任务说明与输出习惯 |
| 偏好对齐 | 用偏好或反馈信号优化行为 | 改善帮助性、诚实性、无害性等目标 |
| 检索与工具调用 | 给系统增加外部信息和执行能力 | 获取资料、精确计算、调用受控服务 |
课件把指令微调概括为激发模型已有能力。这个表述适合强调“学会使用能力”,但监督训练同样会更新参数,不能绝对断言微调不会引入任务知识。SFT 与偏好优化也应区分:前者学习示范回答,后者利用回答之间的偏好;经典 RLHF 可以包含奖励模型,DPO 则提供直接从偏好数据优化的路径。[7]
3H 是目标:helpfulness、honesty、harmlessness。它们需要数据和评价支撑,模型经过对齐不意味着每次输出都同时满足三项要求。检索、计算器和外部工具可补充模型能力;模型生成调用意图后,程序仍需校验参数、权限与执行结果。
三、Scaling Law:固定预算应该怎样分配
1. 参数量、数据量与计算量
课件用三个量描述训练规模:
- $N$:模型参数量,具体研究可能采用非嵌入参数口径。
- $D$:训练处理的 Token 数;数据去重规模与实际训练 Token 数需要区分。
- $C$:训练计算量,通常以 FLOPs 衡量,不能直接等同于 GPU 数量或训练天数。
Kaplan 等人的研究发现,在其研究条件下,语言建模损失与模型、数据、计算规模存在近似幂律关系。[1] 单独考察某个受限因素时,可写成:
\[L(N)\propto N^{-\alpha_N},\qquad L(D)\propto D^{-\alpha_D},\qquad L(C)\propto C^{-\alpha_C}.\]它们不是三条脱离条件的保证:研究参数规模时,数据或训练量应足够;固定总预算时,扩大一个因素往往会挤压另一个因素。
课件还把交叉熵分成不可约部分与可约部分。对于固定的真实分布 $P$ 和模型分布 $Q_\theta$,有:
\[H(P,Q_\theta)=H(P)+D_{\mathrm{KL}}(P\Vert Q_\theta).\]前一项是该分布本身的熵,后一项描述模型与真实分布的差距。训练能够改善模型拟合,但不能把固定随机过程本身的不确定性一并消除。经验拟合中的损失下界,是对这种结构的建模,不是已经测出了所有语言的绝对熵。
2. Chinchilla 的预算约束
Hoffmann 等人联合考虑模型与数据,使用如下经验形式:[2]
\[L(N,D)=E+\frac{A}{N^\alpha}+\frac{B}{D^\beta}.\]$E$ 是拟合中的损失下界,两个递减项分别刻画模型容量与训练数据不足带来的损失。在密集 Transformer 的常用粗略估计下:
\[C\approx 6ND.\]这个近似用于训练预算分析,省略了部分注意力、实现及其他开销;不能直接用来计算所有架构的真实账单。
固定 $C$ 后,令 $K=C/6$、$D=K/N$:
\[L(N)=E+AN^{-\alpha}+BK^{-\beta}N^\beta.\]模型太小时,第一项较大;固定预算下把模型扩得过大,会减少可训练的 Token,使后一项变大。令导数为零可得:
\[\alpha A N^{-\alpha}=\beta B D^{-\beta},\]因此:
\[N_{\mathrm{opt}}\propto C^{\frac{\beta}{\alpha+\beta}}, \qquad D_{\mathrm{opt}}\propto C^{\frac{\alpha}{\alpha+\beta}}.\]这里采用原论文式 (4) 的符号对应:参数量的指数使用 $\beta$,数据量的指数使用 $\alpha$。代入课件给出的 $\alpha\approx0.34$、$\beta\approx0.28$,两者约为 $0.45$ 与 $0.55$;不能把分子对调。
| 研究中的分配方向 | 随计算预算增长,参数量怎样增加 | 数据量怎样增加 |
|---|---|---|
| Kaplan 的早期估计 | 更偏向增加参数,常见近似指数约 0.73 | 约 0.27 |
| Chinchilla 的结论 | 参数与数据较均衡地增长 | 数据增长与参数同样重要 |
不同拟合方法会得到略有差异的数值。应记住预算分配思路和适用条件,不把一个指数或固定 Token/参数比当作全部模型的通用配方。
3. 一个只比较预算的例子
假设计算预算为 $5.88\times10^{21}$ FLOPs,按 $C\approx6ND$ 粗算:
| 参数量 $N$ | 可训练 Token 数 $D$ | 近似计算量 |
|---|---|---|
| 3.5B | 280B | $5.88\times10^{21}$ |
| 7B | 140B | $5.88\times10^{21}$ |
| 14B | 70B | $5.88\times10^{21}$ |
三种配置的预算相同,损失和任务表现仍需训练与验证才能比较。
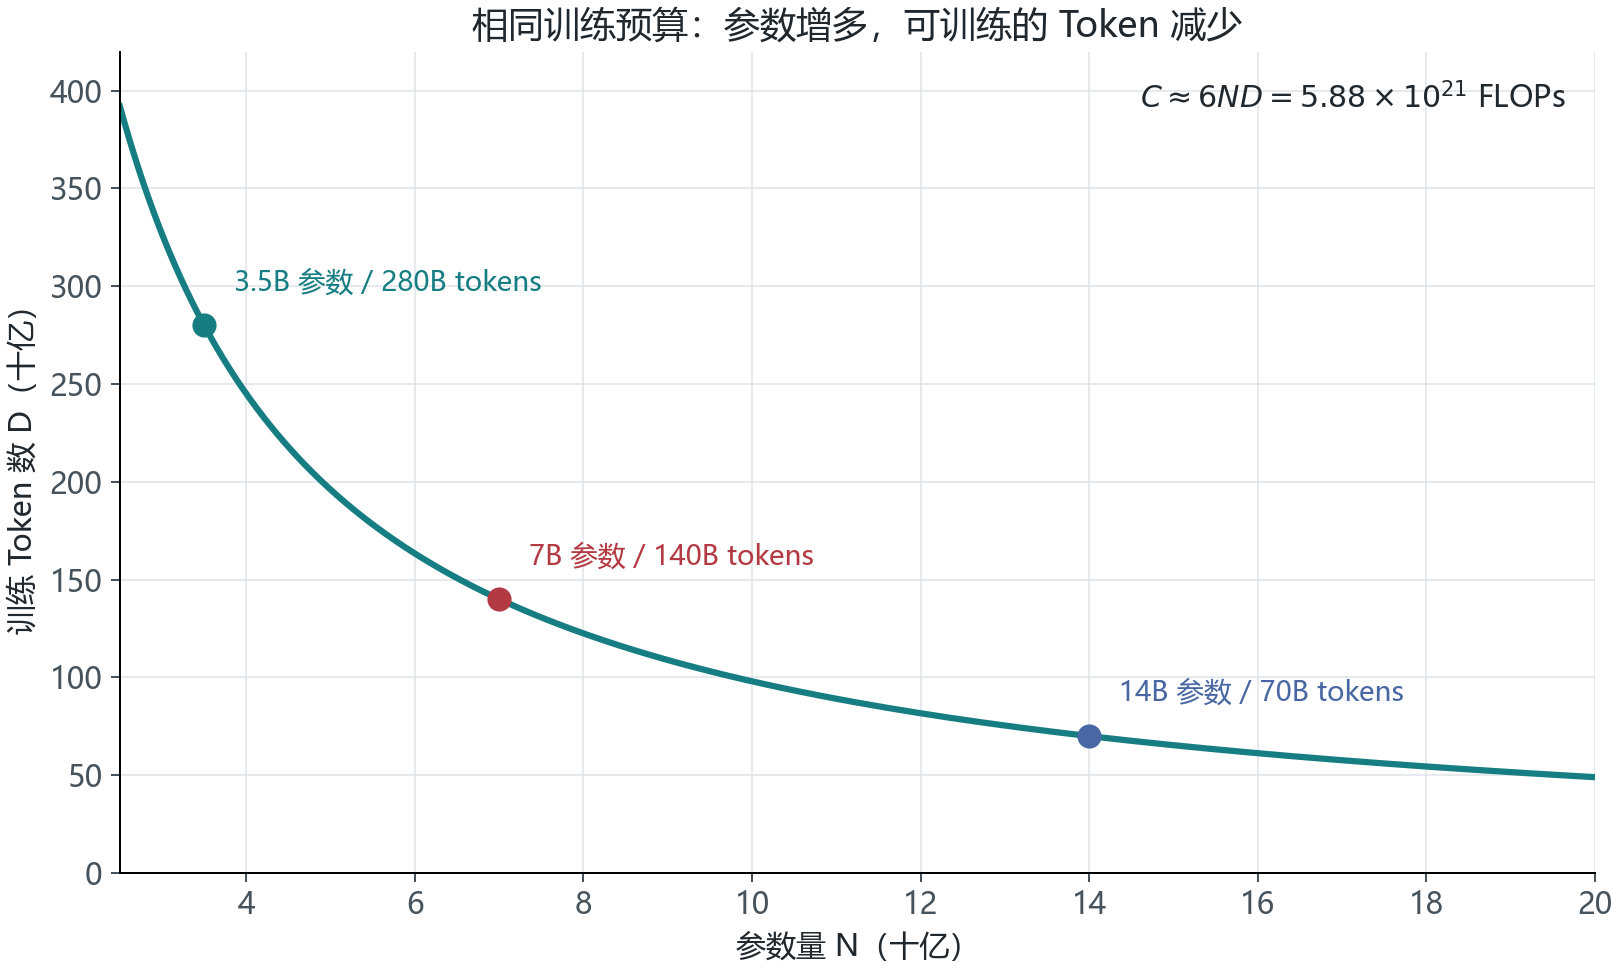
图 1:按近似预算公式计算的示例。图上三点不是实测模型结果,也没有指定哪一点最优。
4. 为什么 loss 下降不等于产品变好
Scaling Law 可用于小规模代理实验、训练预算估算、数据配比选择和异常监控。它通常拟合语言建模损失;用户关心的却可能是代码是否通过测试、医疗任务中的特定错误、响应是否及时,或整个业务是否完成。
从平均 loss 到具体任务,再到系统效用,中间需要任务数据、评分方式和部署环境。小模型外推也需要目标规模附近的实际验证,不能把拟合关系当作无条件的能力保证。
四、涌现、上下文学习与逐步推理
课件介绍了三类代表能力:上下文学习、指令遵从和逐步推理。ICL 在当前上下文中使用说明或示例,不进行梯度更新;GPT-3 的 few-shot 研究展示了这种使用方式。[3] 指令微调则通过训练,让模型更善于处理自然语言描述的任务。
思维链提示通过中间步骤辅助某些多步任务,但文字更长不等于推理更正确。评估需要看答案、实际执行或外部证据,不能仅按解释的完整程度判断。
“涌现”描述特定评测中规模达到一定程度后,能力表现突然明显改善的现象。课件同时讨论了另一种解释:不连续评分可能把平滑变化显示成跃迁。关于涌现的研究与后续反例应结合阅读,不能把某个参数门槛视为统一结论。[4]
例如,假设一个八步任务每一步正确率均为 $p$,并且为说明计算而假设各步独立,那么全部正确的概率为 $p^8$。当单步正确率从 0.80 升到 0.95,整题全对率约从 16.8% 升到 66.3%。用户看到的“能不能完成”变化,可能远大于单步能力变化。这是评分敏感性的教学示例,不是对真实模型独立性的假设或实验结果。
五、智能软件:把模型放回系统
课件将智能软件拆为三部分:AI 解决方案、承载它的系统环境,以及包含 AI 组件的软件上下文。语音识别模型负责“音频到文本”,转写产品则需要完整的工作流。
| 层面 | 语音转写服务中的内容 |
|---|---|
| AI 组件 | 音频预处理、语音识别、必要的说话人或时间段分析 |
| 运行环境 | 计算设备、模型服务、队列、存储、日志与监控 |
| 软件与用户流程 | 上传、账号、付款、进度、回听定位、文本编辑、导出与错误恢复 |
若产品还要持续训练模型,则增加数据标注、训练数据、特征处理、训练流水线和模型监控。课件第 38—40 页从基础转写服务扩展到带训练与纠错界面的系统,说明模型输入输出只是产品中的一段。
例如,“转写文字正确率高”并不能回答大文件上传失败如何恢复、识别错词怎样回听、用户是否能访问别人的音频、任务是否会在服务重启后丢失。这些问题需要软件与系统设计。
六、多团队协作:深度专长与接口理解
智能软件通常需要数据科学家、数据工程师、软件工程师、领域专家,以及设计、运营、安全、业务和项目管理人员。
| 角色 | 主要关注点 | 需要与其他团队约定的内容 |
|---|---|---|
| 数据科学家 | 目标定义、训练、评估、鲁棒性 | 输入分布、模型适用范围、质量指标、失败表现 |
| 数据工程师 | 采集、清洗、标注、数据供给 | 数据格式、来源、质量、版本和可用性 |
| 软件工程师 | 接口、性能、稳定性、发布维护 | 超时、错误语义、容量、回退和权限 |
| 领域专家 | 任务含义、真实场景与错误后果 | 标签定义、关键反例、可接受边界 |
| 设计、运营与安全等 | 用户流程、运行状态、风险控制 | 可解释提示、人工介入、审计与事件处理 |
课件采用 T/π 型能力的说法:既有某个或若干方向的深入专长,也理解相邻领域。协作不要求每个人都能重写所有模块,但需要明白对方接口接收什么、保证什么、可能怎样失败。
噪声音频案例
音频中有噪声,识别结果变差,不能仅凭结果就把问题推给模型团队或前端团队。先要核对端到端约定:
| 问题 | 可以明确的接口约定 |
|---|---|
| 支持什么输入 | 格式、采样率、声道、时长和文件大小 |
| 输入质量差怎么办 | 检测、提示重录、有限预处理或进入特殊流程 |
| 谁验证预处理是否有效 | 在同一批带标注样本上比较原音频、处理后音频和模型输出 |
| 仍然无法可靠识别怎么办 | 标记可疑片段、允许回听修订或交给人工 |
这些是把课堂案例落实为接口的解释。责任应由任务约定、数据和测试结果共同定位;项目管理的作用,是让边界可检查,而非事后裁定谁“应该懂”另一团队的工作。
七、推理系统:延迟、吞吐与积压
推理系统负责模型在目标环境中的实际执行,包括请求调度、批处理、资源管理与结果返回。课堂比较了边缘流式处理与云端并发服务。
1. 边缘端持续输入
摄像头持续产生画面,设备算力、功耗和带宽有限。若输入速率为 $\lambda$、处理能力为 $\mu$,在不丢帧、没有其他瓶颈的简化模型中,$\lambda>\mu$ 时积压会持续增加。
设摄像头输入 30 帧/秒,模型只能处理 25 帧/秒,从空队列开始,60 秒后:
\[Q(60)=(30-25)\times60=300\text{ 帧}.\]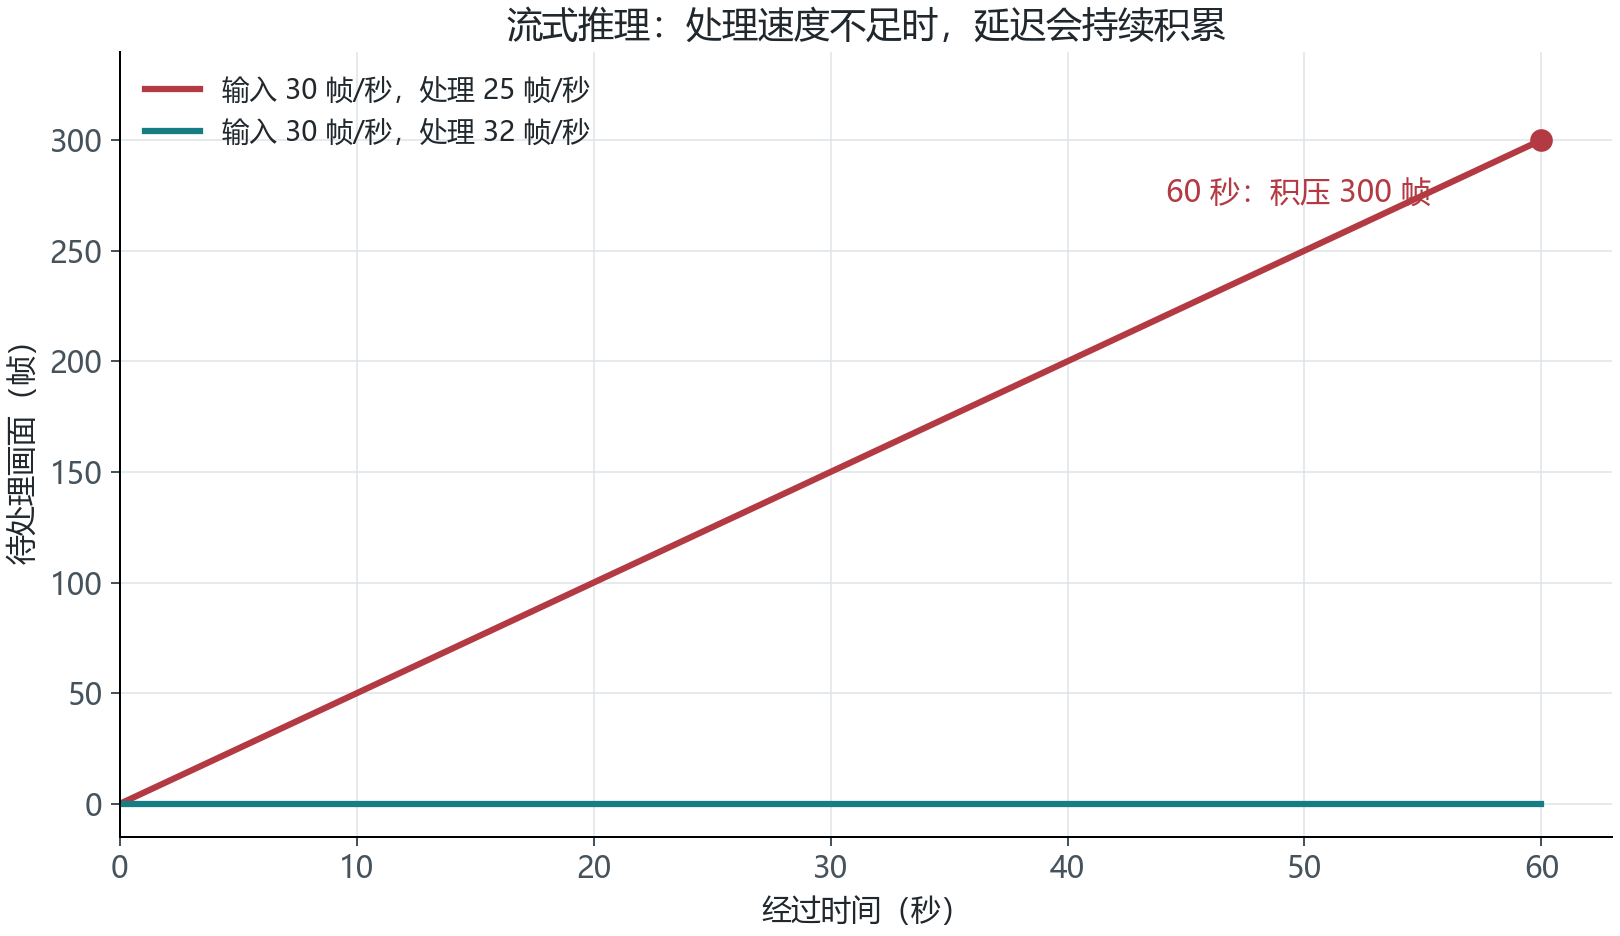
图 2:恒定速率、空队列、无丢帧条件下的计算示例。32 帧/秒的处理能力在该简化例子中不积压,不代表真实系统在突发输入下不会排队。
解决方向包括降低单帧计算、调整采样、批处理或改进硬件;是否允许丢帧取决于任务。更高吞吐还需要结合突发负载、队列容量、最坏延迟和过期数据策略评估。
2. 云端多用户并发
云端关心多用户同时请求时的整体吞吐、排队时间、尾延迟、内存与费用。每个请求的耗时可以拆成:
\[T_{\mathrm{end\text{-}to\text{-}end}} =T_{\mathrm{network}}+T_{\mathrm{queue}} +T_{\mathrm{preprocess}}+T_{\mathrm{inference}}+T_{\mathrm{return}}.\]模型推理变快,如果排队或网络耗时占主导,用户仍可能感觉不到改善。大模型流式服务还需要分别看首次输出等待时间与后续生成速度。平均延迟也不足以描述少数极慢请求,实际服务通常同时观察延迟分布和高分位值。
八、框架、分布式学习与云服务各解决什么
1. 深度学习框架与推理系统
PyTorch、TensorFlow 等框架提供张量计算、自动微分、训练与执行支持,也可以包含编译优化能力。TVM 更侧重模型编译与运行优化。它们与推理服务相关,但不能把所有框架都简化为“只负责编译的工具”。
数值实现需要验证。浮点舍入导致不同执行路径出现小差异,与算子实现或模型逻辑错误,应通过容差、基准输入和任务结果分开判断。程序没有报错只表示没有触发异常机制,不保证模型输出的语义正确。
分布式与异构系统还要处理设备差异、通信、负载和模型放置。硬件数量增加后,若通信或同步成为瓶颈,吞吐不一定同比增长。
2. 联邦学习
联邦学习让数据保留在各参与方,由本地训练产生更新,再进行聚合。经典 FedAvg 可按本地样本数加权聚合模型:[5]
\[w_{t+1}=\sum_{k\in S_t}\frac{n_k}{\sum_{j\in S_t}n_j}\,w_{t+1}^{(k)}.\]$S_t$ 为本轮参与方集合,$n_k$ 为相应本地样本数。它与一台服务器内的普通多卡训练不同,还要面对数据分布不同、通信受限、设备掉线等情况。
“不直接上传原始数据”减少了一类集中收集数据的需求,但更新或梯度仍可能泄露信息;已有研究展示了从梯度恢复训练信息的风险。[6] 是否需要安全聚合、差分隐私等机制,应依据威胁模型和使用条件判断,不能仅凭“只传参数”推出隐私保证。
3. AutoML 与生成式 AI 云服务
AutoML 把部分特征、模型、超参数搜索和部署过程交给自动化工具。生成式 AI 云服务进一步提供模型 API,使应用团队可以接入现有能力。
接入变容易后,应用方仍需定义任务与指标,判断数据可否发送给服务,处理接口变化、额度、延迟、失败和输出质量。买服务还是自己训练或部署,应比较全生命周期成本、能力与控制需求,不能只比较第一次调用是否成功。
九、AI 是辅助组件还是核心能力
课件用报税软件和转写软件比较两种集成方式。
| 维度 | AI 为辅助组件 | AI 为核心能力 |
|---|---|---|
| 例子 | 报税系统增加审计风险提示 | 语音转写服务 |
| 核心任务 | 税额计算等流程可独立存在 | 主要用户价值依赖识别结果 |
| 团队协作 | 明确接口后可相对独立开发 | 模型、交互、资源和流程需要频繁联调 |
| 出错处理 | 撤下提示、解释不确定性或使用原流程 | 回听修订、重新处理、人工支持或限制服务范围 |
| 主要问题 | 附加能力是否值得其成本 | 整体产品是否能容纳模型的不确定性 |
“辅助”不意味着一定低风险:即使只是建议,若用户据此采取高风险行动,也需要相应约束。分类的作用是分析依赖关系与回退方式,而不是按组件大小直接决定安全级别。
十、MLOps:从一次训练到持续交付
传统的模型视角常停在需求、数据、特征、训练和离线评估。系统视角把部署、监控和反馈继续接上:
\[\text{需求}\rightarrow\text{数据与标注}\rightarrow\text{训练与评估} \rightarrow\text{部署}\rightarrow\text{监控}\rightarrow\text{反馈与更新}.\]监控发现新问题后,先判断是数据、模型、服务还是需求变化,再决定是否重新标注、训练或修改外围流程。回流数据的收集与使用仍需满足授权和质量要求;并非所有线上数据都适合直接进入训练集。
| 环节 | 需要留下的可用信息 |
|---|---|
| 需求与评估 | 用户任务、输入范围、成功条件和关键失败类型 |
| 数据与训练 | 数据来源与版本、标注规则、训练配置、评估切分 |
| 部署 | 模型版本、依赖、配置、运行环境、发布与回退条件 |
| 监控 | 输入变化、质量样本、时延、错误、资源和费用 |
| 更新 | 变更内容、回归验证、发布依据与结果 |
模型权重可以版本化,但二进制文件差异不像源码 diff 那样容易解释语义变化,所以版本号还要关联数据、代码、配置和评估。一个“新模型文件”本身不足以说明行为为何改变。
课件引用《Hidden Technical Debt in Machine Learning Systems》说明:模型代码之外还有数据收集、验证、配置、资源、服务和监控等大量支撑工作。[8] 这不是“模型不重要”,而是提醒维护成本来自整个依赖系统;图中的面积也不应直接读作所有项目通用的代码占比。
十一、模型目标与系统目标为什么不同
课件的法律自助聊天案例,起初关注识别话题、引导开放式对话和覆盖边缘问题;模型效果提高后,团队仍可能认为系统无法上线,因为总有没处理好的例外。
重新明确系统目标后,问题可以变为:哪些简单任务可以自助完成,什么时候应转接专业人员,界面怎样让用户理解下一步。若这就是产品目标,模型遇到复杂问题时识别边界并完成转交,可能比继续追求独立回答全部情况更有价值。
这一案例说明目标应先对齐。它不意味着法律内容可以不顾正确性,也不意味着可以把敏感对话任意用于获客;数据用途和用户授权需要独立定义。
| 目标层次 | 例子 |
|---|---|
| 模型目标 | 在指定测试集上提高分类或生成指标 |
| 用户目标 | 完成任务、理解结果、能纠正或继续操作 |
| 系统目标 | 在质量、时延、成本和风险约束下持续提供服务 |
| 组织目标 | 明确谁负责、怎样维护、何时升级与回退 |
“更准确是否值得”需要结合错误后果和改进成本判断。若系统依赖模型自动执行关键动作,就需要更强的验证与约束;若结果由用户浏览、选择和修改,交互设计可能吸收部分误差。置信度阈值也需要经过实际校准,不能把模型自报“很有把握”直接当作可靠概率。
十二、与物理世界连接时的安全边界
机器人或车辆的感知结果会影响物理动作,错误后果与推荐一张不喜欢的图片不同。工程上需要明确允许运行的条件、输入异常处理、危险动作限制、独立检查和可实施的停止或降级方式。
低温度可以减少部分输出随机性,不能保证事实正确或动作安全;try/except 能处理程序异常,不能自动发现语义错误。输出检查必须围绕实际任务定义。
终端用户与专业用户的界面也可不同:专业工具可以暴露更细的参数和输入要求,普通用户更需要易懂提示、受控操作和恢复路径。权限仍由程序验证,不能因为用户“看起来专业”就扩大敏感工具的访问范围。
课件最后把智能软件工程整理为需求、架构设计、质量保障、运行维护,以及贯穿其中的团队流程与责任要求:
| 维度 | 核心问题 |
|---|---|
| 需求 | 系统和模型分别要完成什么,环境假设是什么 |
| 架构 | 模型如何嵌入流程,失败怎样被隔离或接管 |
| 质量保障 | 数据、模型、接口和基础设施怎样共同验证 |
| 运行维护 | 怎样监控、版本化、发布、回滚和持续评估 |
| 责任要求 | 来源与复现、安全、隐私、公平、可解释性及透明度怎样落实 |
十三、复习问题与参考回答
1. 为什么固定计算预算时,参数越多不一定越好?
按 $C\approx6ND$,扩大 $N$ 会挤压可训练的 $D$。需要共同优化容量和训练量,而不是只比较参数数量。
2. Chinchilla 拟合中,$N_{\mathrm{opt}}$ 对 $C$ 的指数为什么使用 $\beta$?
把 $D=C/(6N)$ 代入损失式后求导,得到 $N^{\alpha+\beta}\propto C^\beta$,所以指数为 $\beta/(\alpha+\beta)$。
3. ICL 与指令微调的关键区别是什么?
ICL 改变本次上下文,不做梯度更新;指令微调使用训练样本更新模型参数。二者可以同时存在于同一模型的使用流程。
4. 什么情况会让能力看上去“突然出现”?
任务评分可能要求全部正确或超过门槛,平滑的底层变化会被放大。应同时检查任务、提示、评分方式和具体模型条件。
5. 噪声音频识别失败,怎样定位责任?
核对输入质量约定,比较预处理前后和不同条件下的结果,再依据接口与端到端测试定位。不能只凭输出错误决定由哪一团队负责。
6. 30 帧/秒输入、25 帧/秒处理,为什么离线精度高也可能不可用?
简化条件下每秒积压 5 帧,60 秒积压 300 帧。系统还必须满足及时处理和资源约束。
7. 联邦学习为什么不自动等于隐私保护?
本地原始数据不集中上传,但更新或梯度仍可能泄露信息。需要依据威胁模型选择并验证保护机制。
8. 模型能运行、接口返回 200,为什么还要验证结果?
返回成功说明请求和程序流程完成,不证明内容符合任务、业务或物理约束。语义结果需要相应的检查与回退。
9. MLOps 比完成一次模型训练多了什么?
部署、版本关联、线上监控、回归验证、反馈、发布和回滚,把模型置于可持续维护的系统中。
10. 怎样判断一个边缘问题是否值得继续提高模型精度?
看它是否阻碍真实系统目标、错误后果有多大、现有转交或修正流程能否处理,以及改进的全成本。
参考材料
课堂材料:万成城《大模型与智能软件系统:01 Basic Concepts》(69 页);《智能软件开发流程与多团队协作》课堂转写。基础与适配对应课件第 3—23 页,规模与涌现对应第 24—35 页,系统与协作对应第 37—61 页,目标与工程要求对应第 62—69 页。
- Kaplan et al. Scaling Laws for Neural Language Models, 2020。参数、数据与计算的经验缩放关系。
- Hoffmann et al. Training Compute-Optimal Large Language Models, 2022。联合损失拟合与固定计算量分配,尤其式 (2)—(4)。
- Brown et al. Language Models are Few-Shot Learners, 2020。上下文学习与 few-shot 使用方式。
- Schaeffer et al. Are Emergent Abilities of Large Language Models a Mirage?, 2023。评分方式对能力跃迁观察的影响。
- McMahan et al. Communication-Efficient Learning of Deep Networks from Decentralized Data, 2017。联邦训练与 FedAvg。
- Zhu et al. Deep Leakage from Gradients, 2019。共享梯度的信息泄露风险。
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model, 2023。直接偏好优化。
- Sculley et al. Hidden Technical Debt in Machine Learning Systems, 2015。机器学习系统中的依赖与维护成本。