· 智能计算系统 / 目标检测 / YOLO / 风格迁移 / GAN / 扩散模型
智能计算系统 Day6:目标检测、风格迁移与生成模型
RedMoon · 2026-10-21 · 课堂笔记
上节课介绍了卷积网络怎样提取特征,以及经典视觉架构的演进。本节把这些表示用于两个方向:目标检测需要回答“是什么、在哪里、有几个”;图像生成则要从内容、风格、类别或噪声出发,构造符合目标的图像。前半段围绕检测指标、R-CNN 系列、YOLO 和 SSD,后半段连接风格迁移、GAN、自编码器与扩散模型。
一、分类、检测与分割分别输出什么
分类通常给整张图片一个或多个类别。检测为每个目标输出类别、边界框和分数;分割进一步判断像素归属。语义分割区分类别,实例分割还要区分同一类别中的不同对象。
| 任务 | 典型输出 | 例子 |
|---|---|---|
| 图像分类 | 整图类别或标签集合 | 图片是否包含车辆 |
| 单目标定位 | 类别与一个位置框 | 主要对象的位置 |
| 目标检测 | 多个类别、框与分数 | 每辆车各自的位置 |
| 语义分割 | 每个像素的类别 | 车辆、道路、行人的区域 |
| 实例分割 | 每个对象自己的掩码 | 分开标记相邻的两辆车 |
边界框可以写成左上角与右下角坐标 $(x_1,y_1,x_2,y_2)$,也可以写成中心和宽高 $(x_c,y_c,w,h)$。计算前需统一坐标约定。本文框面积使用连续坐标差值,不额外加一个像素。
课堂用一个房间里同时有多人、多把椅子的照片说明检测的需要。检测与分割是输出粒度不同的任务;“框住对象”不等于已经给出了精确像素轮廓。
二、IoU、Precision、Recall 与 AP 怎样连起来
1. IoU 衡量位置重叠
预测框 $B_p$ 与真实框 $B_g$ 的交并比为:
\[\operatorname{IoU}(B_p,B_g) =\frac{|B_p\cap B_g|}{|B_p\cup B_g|}.\]例如两个边长为 4 的框,分别从 $(0,0)$ 和 $(1,1)$ 开始,交集面积为 $3\times3=9$,并集为 $16+16-9=23$,所以 IoU 为 $9/23\approx0.3913$。IoU 同时反映位置、大小和形状匹配程度。
IoU 达到阈值只是检测匹配的一个条件。标准检测评估还要检查类别,并按协议将预测与真实目标匹配;一个普通真实目标已经被较高分预测匹配后,后面的重复检测通常计为误检。COCO 对 crowd、ignore 等情况另有规则。[1]
2. 查准率与召回率需要配对规则
在固定类别和 IoU 阈值下,匹配正确的预测记为 TP,误检记为 FP,漏掉的真实目标记为 FN:
\[\operatorname{Precision}=\frac{TP}{TP+FP},\qquad \operatorname{Recall}=\frac{TP}{TP+FN}.\]沿课堂的 $K,N,M$ 记号,若 $N$ 是预测数、$K$ 是正确匹配数、$M$ 是真实目标数,则 Precision 为 $K/N$,Recall 为 $K/M$。这些是目标级计数,不是把图片张数直接当分母。
假设某类别有 3 个真实目标,按分数从高到低得到以下五个预测。这里的 TP/FP 已按匹配规则确定,是一组教学数据:
| 排名 | 分数 | 本条结果 | 累计 TP / FP | Precision | Recall |
|---|---|---|---|---|---|
| 1 | 0.95 | TP | 1 / 0 | 1 | 1/3 |
| 2 | 0.90 | FP | 1 / 1 | 1/2 | 1/3 |
| 3 | 0.80 | TP | 2 / 1 | 2/3 | 2/3 |
| 4 | 0.70 | TP | 3 / 1 | 3/4 | 1 |
| 5 | 0.60 | FP | 3 / 2 | 3/5 | 1 |
从第二个预测扩展到第三个,Precision 反而由 $1/2$ 升至 $2/3$。降低分数阈值、纳入更多预测时,Recall 可能提高,也可能保持;Precision 的变化取决于新增预测的 TP/FP 构成。不能仅凭预测数量增加,就认定查准率必然下降。
3. AP 是排序曲线上的量,mAP 还要跨类别或阈值汇总
对预测按分数排序,逐步纳入预测,就得到 Precision–Recall 曲线。AP 按评测协议汇总这条曲线;mAP 再对类别等维度求平均。
若用全点插值积分示范,先取右侧精度包络:
\[p_{\mathrm{interp}}(r)=\max_{\tilde r\ge r}p(\tilde r),\qquad \operatorname{AP}=\int_0^1p_{\mathrm{interp}}(r)\,dr.\]上例在三个召回区间的插值精度分别为 $1,3/4,3/4$,得到:
\[\operatorname{AP} =\frac13\times1+\frac13\times\frac34+\frac13\times\frac34 =\frac56\approx0.8333.\]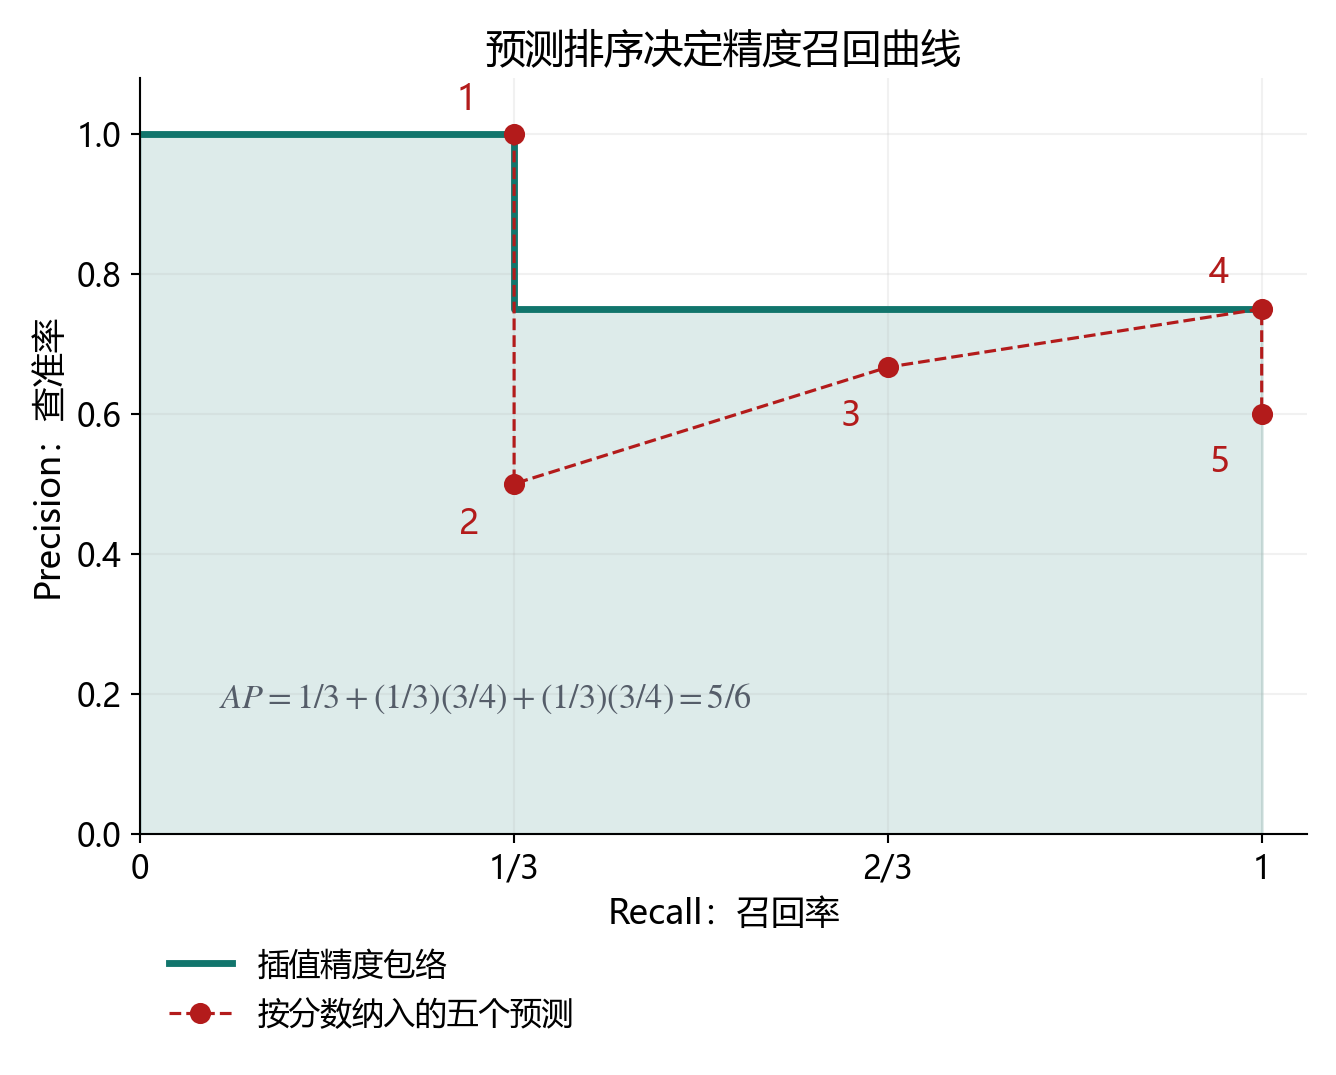
图 1:根据表中五个预测直接计算。散点是逐排名结果,阶梯与阴影表示全点插值积分;图中 AP 不替代具体数据集的官方评测器。
课堂举的 IoU=0.5 是常见口径之一。COCO 的主要 AP 使用 0.50 到 0.95、步长为 0.05 的十个 IoU 阈值,并在 101 个召回位置上采样插值精度,还规定目标面积和每图最大检测数等设置。因此 AP50、AP75 和 COCO 主 AP 表达的定位要求不同,比较结果时必须写明协议。[1]
三、NMS:从重复框中选出代表
同一对象可能被多个位置、尺度的预测覆盖。贪心非极大值抑制(NMS)通常按类别处理:先保留最高分框,再删除与它 IoU 超过抑制阈值的剩余框,继续处理尚未删除的预测。[2][5]
设三个同类框按分数排序:
| 框 | 坐标 $(x_1,y_1,x_2,y_2)$ | 分数 |
|---|---|---|
| A | $(0,0,4,4)$ | 0.95 |
| B | $(0.5,0.5,4.5,4.5)$ | 0.90 |
| C | $(5,0,8,3)$ | 0.85 |
A 与 B 的 IoU 为 $12.25/19.75=49/79\approx0.6203$。若抑制阈值为 0.5,先保留 A,删除 B;C 与 A 不重叠,因此保留,最终输出 A、C。
NMS 的 IoU 阈值控制预测之间是否视为冗余;评测的 IoU 阈值控制预测与真实框是否匹配,两者用途不同。拥挤场景中,相邻的真实对象也可能高度重叠,因此 NMS 阈值需要结合任务调整。
四、R-CNN 系列:先复用特征,再学习候选区域
1. R-CNN:把候选区域送进 CNN
R-CNN 先用 Selective Search 产生约 2000 个候选区域,分别裁剪、缩放,再由 CNN 提取特征。特征用于各类别的线性 SVM 分类,边界框回归进一步校正位置和大小。[2]
Selective Search 根据颜色、纹理、区域大小等关系做层次合并,并收集不同层级的区域框。它是候选生成方法,与后面的分类器分工。
这条路线的主要开销在于:大量重叠候选区域分别运行 CNN,同一片图像内容被重复计算;训练还包含特征提取、分类和框回归等环节。
2. Fast R-CNN:整图卷积,按 RoI 提取固定尺寸表示
Fast R-CNN 先对整图计算共享特征图,再把候选区域映射到特征图。RoI Pooling 将每个不同大小的区域分成固定数量的格子,各格做最大池化,得到固定空间尺寸的特征。后续检测头同时输出类别 Softmax 和框回归偏移。[3]
它减少了候选区域之间的重复卷积,并联合训练分类与回归。外部候选生成仍然存在,所以提速后需要继续看 Selective Search 的耗时。
3. Faster R-CNN:用 RPN 生成候选
Faster R-CNN 让区域提议网络(RPN)与检测器共享卷积特征。RPN 在特征图的每个位置围绕参考框 Anchor,预测目标性与框偏移,再把候选交给 RoI 检测头分类和精修。[4]
原论文常用 3 种尺度、3 种长宽比,每个位置共有 $k=9$ 个 Anchor。若使用前景/背景双类别 Softmax,该位置的分类分支输出 $2k=18$ 个数,框分支输出 $4k=36$ 个偏移量。RPN 预测的是“像不像对象”,后续检测头才判断具体类别。
| 方法 | 候选区域从哪里来 | 主要共享或学习的部分 |
|---|---|---|
| R-CNN | 外部 Selective Search | 各区域使用同一个 CNN,但分别计算 |
| Fast R-CNN | 外部 Selective Search | 整图卷积特征共享,RoI 后做分类与回归 |
| Faster R-CNN | 学习到的 RPN | RPN 与检测器共享特征,候选生成可学习 |
“两阶段”指先产生候选,再对候选做检测,并不按网络数量或输出分支数量划分。Faster R-CNN 原论文讨论了交替训练等共享方案;它能放在统一系统中训练,不代表所有版本都采用完全相同的端到端优化细节。
课堂口述的若干秒数混合了模型、骨干网络和设备,适合用于说明重复计算的代价。原论文的速度结果需要保留输入、骨干、设备、候选生成和后处理范围,不能用混杂的时间直接排列今天的模型性能。[2][3][4]
五、YOLO v1:直接预测网格上的框与类别
原始 YOLO 将检测组织成一次网络前向计算:输入整图,在 $S\times S$ 网格上预测框、置信度和类别。目标中心落在哪个格子,该格子负责预测这个目标。[5]
1. 输出张量怎样数
每个格子预测 $B$ 个框,每框输出 $(x,y,w,h)$ 和置信度,共 $5B$ 个数;该格子另共享 $C$ 个条件类别概率。因此输出为:
\[S\times S\times(5B+C).\]原论文在 PASCAL VOC 上取 $S=7$、$B=2$、$C=20$,输出是 $7\times7\times30$,共 1470 个数、98 个候选框。这里的“两个框共享一组类别概率”是 YOLO v1 的具体设计,不应推广为所有后续版本。
框中心的 $x,y$ 相对于所属网格表示,$w,h$ 相对于整图归一化。v1 直接学习框坐标,不采用后来常见的 Anchor 偏移形式。[5]
2. 置信度中包含什么
原始设计的框置信度为:
\[\operatorname{confidence} =\Pr(\mathrm{Object})\operatorname{IoU}_{\mathrm{pred,truth}}.\]与 $\Pr(\mathrm{Class}_i\mid\mathrm{Object})$ 相乘后,得到类别相关的框分数。这里描述的是训练目标和分数含义;推理时真实框未知,网络输出的是学到的估计,不会现场拿真实框计算 IoU。
原始目标包含位置、尺寸、置信度和类别项,并用权重调节不同项的影响,对宽高使用平方根变换。定位与分类共同受监督,推理后也可以用 NMS 清理重复框。[5]
3. 速度与网格约束的关系
YOLO v1 原论文分别报告标准 YOLO 约 45 FPS、较小的 Fast YOLO 约 155 FPS。这是不同模型在当时实验条件下的结果。较粗网格、每格有限框数及共享类别预测,使 v1 对密集小目标和定位存在约束。[5]
课堂提到多个后续版本,主要用于观察骨干、特征融合和检测头怎样调整。后续版本来自不同研究团队和实现,需各自核对论文与代码;v1 的输出形式、损失和限制不代表整个系列。
六、SSD 与 FPN:怎样利用多尺度特征
SSD 在多个分辨率的特征图上,为不同尺度和长宽比的默认框预测类别与位置偏移。较高分辨率的层保留更多空间细节,较低分辨率的层具有不同的感受野和语义表示,多层预测共同覆盖不同大小的对象。[6]
这些默认框与 Anchor 一样提供参考框,但 SSD 不先生成一批候选、再逐候选送入第二阶段检测头,因此属于单阶段检测。
FPN 则通过自顶向下路径与横向连接,把高层语义传给分辨率较高的特征层,形成各层均可用于预测的特征金字塔。[7]
| 设计 | 主要作用 |
|---|---|
| SSD 的多尺度检测层 | 在多个分辨率直接预测不同大小的框 |
| FPN 的自顶向下与横向融合 | 结合高层语义和较高分辨率的局部细节 |
| 图像金字塔 | 将输入缩放到多个尺度再处理 |
SSD 使用多尺度特征,并不等于采用了后来 FPN 的具体融合结构。FPN 是可嵌入检测器的特征组织方式,可以服务于两阶段或单阶段系统。
七、风格迁移:固定特征网络,优化图像像素
经典神经风格迁移给定内容图 $p$、风格图 $a$,通过预训练 VGG 等网络提取特征,再寻找输出图像 $x$。原方法的关键是:特征网络参数固定,优化变量是图像 $x$。[8]
1. 内容损失保留空间结构
设第 $\ell$ 层的特征为 $F^\ell(x)\in\mathbb R^{C_\ell\times M_\ell}$,其中 $C_\ell$ 为通道数,$M_\ell$ 为展平后的空间位置数。一个内容损失是:
\[\mathcal L_{\mathrm{content}}(x,p) =\frac12\|F^\ell(x)-F^\ell(p)\|_F^2.\]它比较对应位置的特征,推动输出保留内容图在该层编码的结构。
2. Gram 矩阵汇总通道相关性
风格表示使用特征的 Gram 矩阵:
\[G^\ell(x)=F^\ell(x)F^\ell(x)^\mathsf{T},\qquad G^\ell_{ij}(x)=\sum_kF^\ell_{ik}(x)F^\ell_{jk}(x).\]它汇总通道之间的内积关系,没有先减均值,不应直接当作中心化协方差。一个按原论文归一化的单层风格损失为:
\[E_\ell =\frac{\|G^\ell(x)-G^\ell(a)\|_F^2} {4C_\ell^2M_\ell^2}.\]总目标将内容损失与多层风格损失组合:
\[\mathcal L(x)=\alpha\mathcal L_{\mathrm{content}}(x,p) +\beta\sum_\ell w_\ell E_\ell.\]对所有通道同时置换空间位置时,Gram 矩阵保持不变。例如:
\[F=\begin{bmatrix}1&0&2\\0&1&1\end{bmatrix},\qquad FF^\mathsf{T}=\begin{bmatrix}5&2\\2&2\end{bmatrix}.\]将 $F$ 的列改排为第 3、1、2 列,得到同一个 Gram 矩阵,但两组特征按上面的内容损失计算,结果为 4。这说明 Gram 汇总了共现统计,却不能单独约束精确的空间排列;内容损失提供另一类约束。
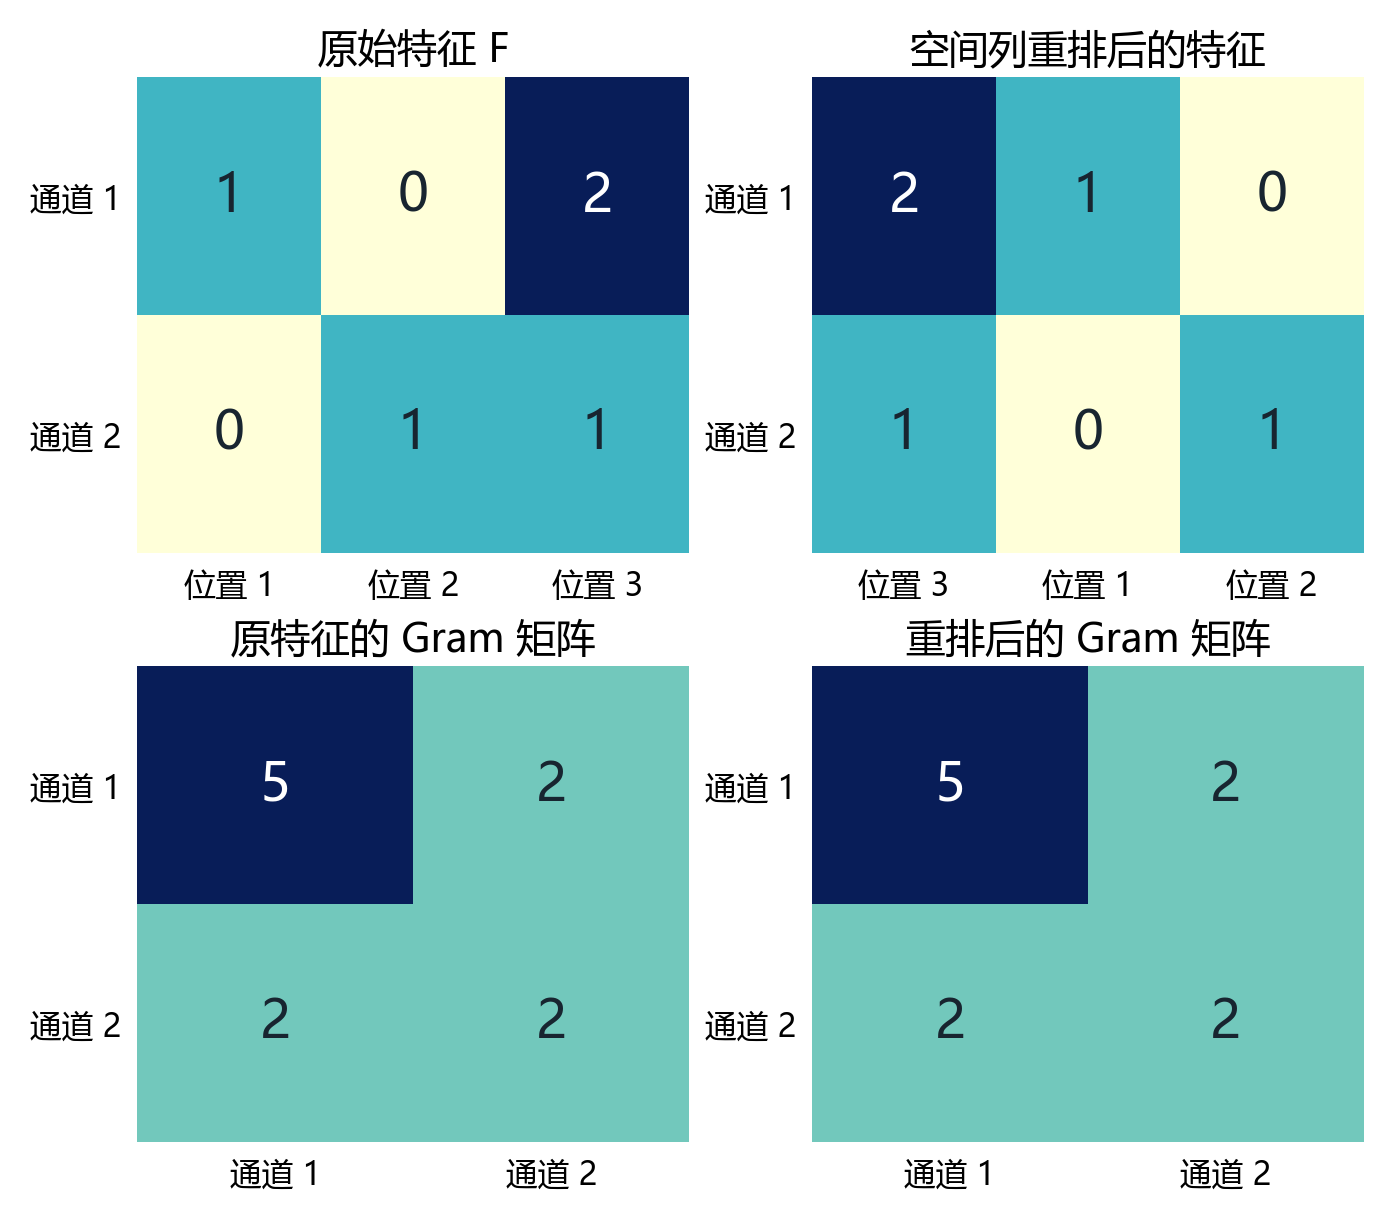
图 2:上排是两组仅列顺序不同的二维特征,下排是各自直接相乘得到的 Gram 矩阵。所有数字来自上面的构造例子。
3. 反向传播走到哪里
由噪声图或内容图初始化 $x$,计算特征和损失,然后沿网络对输入求梯度、更新像素。固定 VGG 权重,并不等于停止通过 VGG 计算输入梯度。官方实现同样将输入图像交给优化器,而将特征模型置为固定状态。[8][15]
随机初值可以产生不同优化轨迹;这样的单图优化,并没有训练出一个可任意采样的通用生成器。这与后面的 GAN 需要区分。
八、GAN:交替训练生成器和判别器
GAN 用生成器 $G$ 将噪声 $z$ 映射为样本,用判别器 $D$ 估计输入来自真实数据的概率。原始极小极大目标为:
\[\min_G\max_D \mathbb E_{x\sim p_{\mathrm{data}}}\log D(x) +\mathbb E_{z\sim p_z}\log\bigl(1-D(G(z))\bigr).\]判别器希望真实样本得高分、生成样本得低分;生成器希望生成样本更像真实数据。[9]
1. 两次更新的梯度职责不同
| 更新对象 | 其他参数 | 需要的梯度路径 |
|---|---|---|
| 判别器 $D$ | 本步不更新 $G$ | 真实与生成样本的判别损失到 $D$ |
| 生成器 $G$ | 本步不更新 $D$ | 从 $D$ 的输出经过其输入,回到 $G$ |
训练判别器时,生成样本通常与生成器计算图分离。训练生成器时,虽然判别器参数固定,仍需保留判别器对输入的梯度,才能把反馈传到生成器。
一种常用的非饱和生成器损失是:
\[\mathcal L_G^{\mathrm{NS}} =-\mathbb E_{z\sim p_z}\log D(G(z)).\]最小化它会提高生成样本的判别分数。在判别器很容易拒绝生成样本的早期,它能改善原始饱和目标的梯度信号。[9]
2. 输出 0.5 是理想平衡的结果
给定生成分布,原始 GAN 理论中的最优判别器为:
\[D^*(x) =\frac{p_{\mathrm{data}}(x)} {p_{\mathrm{data}}(x)+p_g(x)}.\]当两种分布相同,在有概率质量的位置就得到 $D^*(x)=1/2$。这个结论需要分布匹配与判别器最优等条件。生成器每一步训练的任务是改善样本、提高相应目标,不是把所有判别分数硬拉到 0.5。[9]
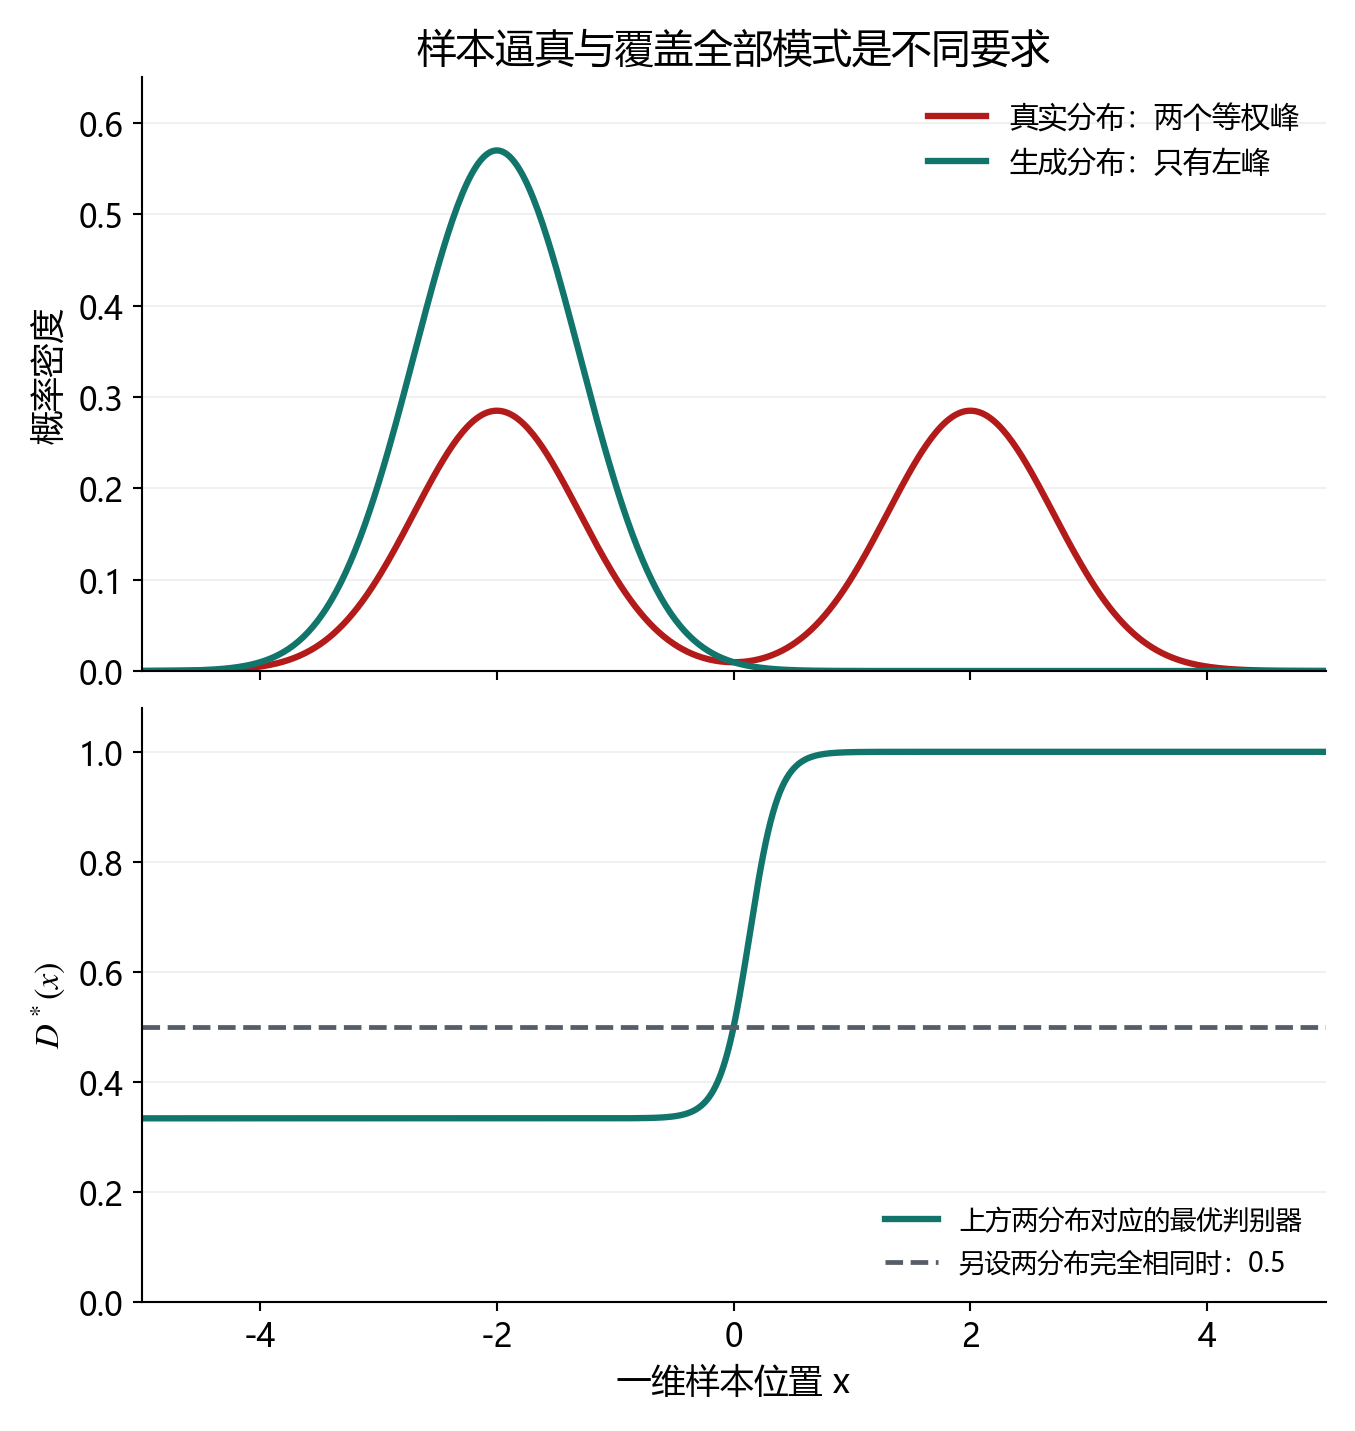
图 3:真实分布构造为两个等权高斯峰,生成分布只保留左峰;下图由密度代入 $D^*$ 直接计算。虚线 0.5 对应另一个条件:生成分布与真实分布完全相同。
3. 模式崩溃与梯度问题
模式崩溃指生成器把不同噪声映射到少数输出模式。少数样本看起来逼真,不能证明数据分布覆盖充分。原始损失的饱和、两网络更新失衡等也会影响训练,非饱和目标与后续 GAN 变体从不同角度处理这些问题。
理论上的理想解与有限网络的实际交替训练需要分别判断;观察判别器分数时,还应结合样本质量、多样性和真实数据覆盖。
九、条件生成:让输入条件参与训练
条件 GAN 把条件 $y$ 同时交给生成器和判别器,写作 $G(z,y)$ 与 $D(x,y)$。条件可以是类别编码、属性或其他表示,判别器需要结合条件判断样本是否符合真实分布。[10]
例如训练手写数字生成时,真实图片和类别标签成对出现;生成器接收噪声与类别,判别器比较“图片在这个类别条件下是否合理”。这样才能学到按指定类别生成。
条件编码的含义来自训练数据与目标,单纯在输入末尾添加几个数,并不会自动获得文本理解或视频生成能力。文本编码可以通过拼接、注意力等方式进入模型;潜空间扩散就使用了交叉注意力等条件机制。[14]
视频还涉及时间一致性、角色和运动关系。课堂的“把文字变成条件”说明了可控生成的基本入口,不能据此推断具体短剧产品使用哪一种底层模型。
十、AE、VAE 与 Flow 怎样组织生成空间
1. 普通自编码器:先编码,再重建
普通自编码器将输入编码为 $z=E(x)$,再解码得到 $\hat x=D(z)$,以重建误差训练。潜变量可以压缩输入,但普通重建目标并不自动保证整个潜空间符合标准高斯,也不保证从任意高斯噪声采样都能解码出合理样本。
2. VAE:为潜变量引入概率模型
VAE 使用近似后验 $q_\phi(z\mid x)$、生成模型 $p_\theta(x\mid z)$ 和先验 $p(z)$。最小化负变分下界时,可以写成:
\[\mathcal L_{\mathrm{VAE}} =-\mathbb E_{q_\phi(z\mid x)}\log p_\theta(x\mid z) +D_{\mathrm{KL}}\bigl(q_\phi(z\mid x)\|p(z)\bigr).\]第一项鼓励重建,第二项约束近似后验与先验的关系。取对角高斯后验时,重参数化为:
\[z=\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon,\qquad \epsilon\sim\mathcal N(0,I).\]这让随机采样中的可学习部分仍能通过梯度训练。生成时从先验采样,再交给解码器;它与只训练确定性重建的普通自编码器有不同目标。[11]
3. Flow:通过可逆变换改变分布
经典归一化流通过一系列可逆变换,把简单分布变成复杂分布,并用变量变换公式计算密度。[12] 它与压缩式自编码器、对抗训练分别使用不同约束。课堂在这一部分主要列出了方法名称,具体 Flow 架构没有展开。
十一、扩散模型:规定加噪,学习反向生成
1. 正向过程把数据逐渐变成噪声
DDPM 的正向加噪过程可以写为:
\[q(x_t\mid x_{t-1}) =\mathcal N\bigl(\sqrt{1-\beta_t}\,x_{t-1},\beta_tI\bigr).\]定义 $\alpha_t=1-\beta_t$、$\bar\alpha_t=\prod_{s=1}^{t}\alpha_s$,就能直接从原始样本构造任意时间步:
\[x_t=\sqrt{\bar\alpha_t}\,x_0 +\sqrt{1-\bar\alpha_t}\,\epsilon,\qquad \epsilon\sim\mathcal N(0,I).\]噪声日程由系统规定。随着 $\bar\alpha_t$ 减小,原信号的系数下降、噪声的系数增加;足够末期的分布接近高斯,通常并非有限步后严格等于纯噪声。[13]
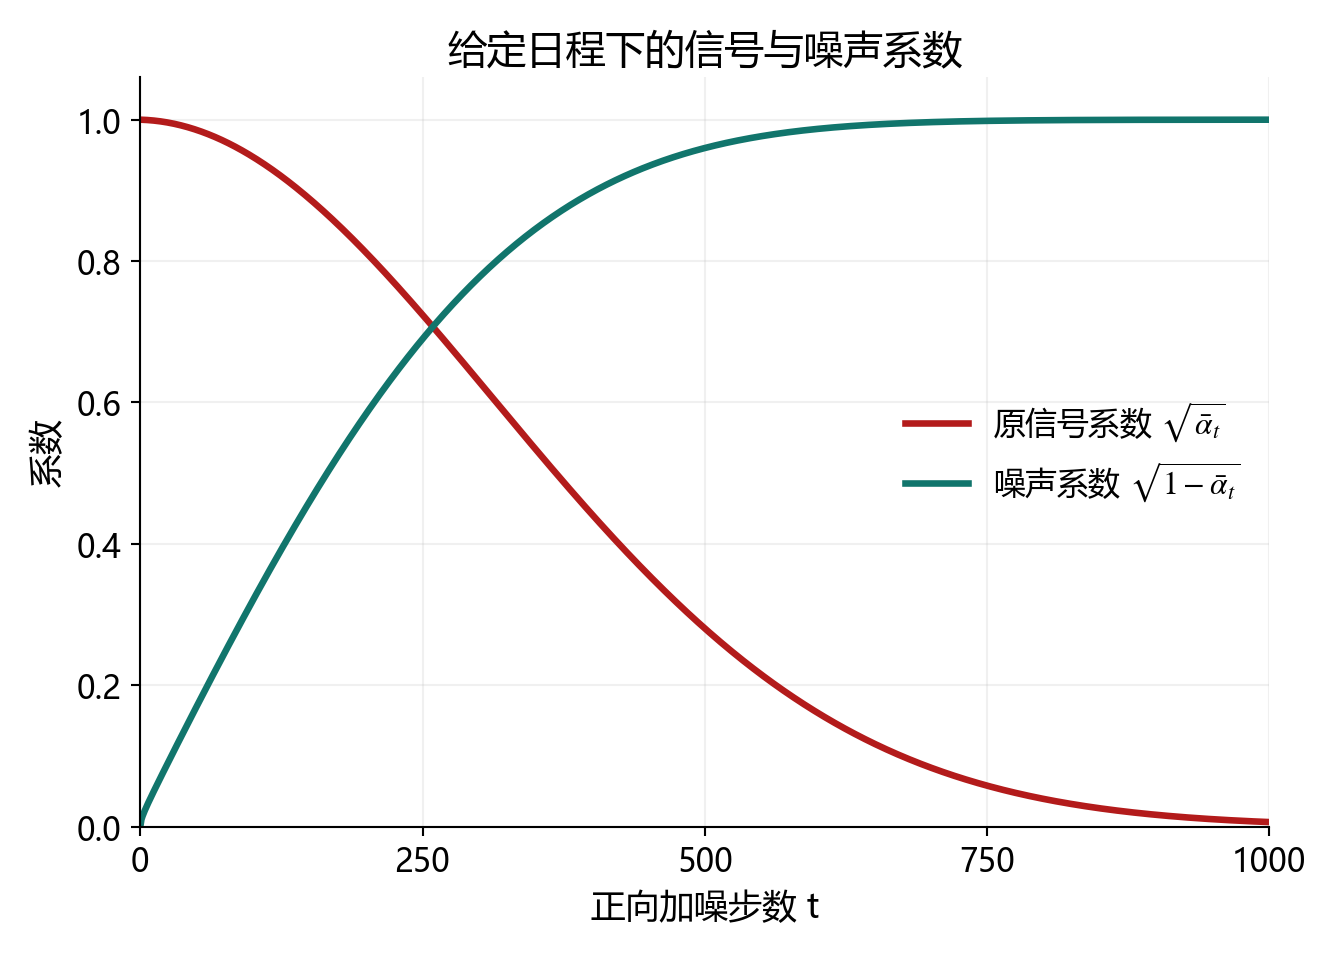
图 4:设 1000 步、$\beta_t$ 从 0.0001 线性增加到 0.02,直接计算两个系数。它们的平方和为 1,系数本身之和不要求为 1;这是一条给定日程,不是训练曲线。
2. 网络学习什么,生成时又做什么
一种常见训练方式让网络预测已加入的噪声:
\[\mathcal L_{\mathrm{simple}} =\mathbb E_{x_0,t,\epsilon} \left\|\epsilon-\epsilon_\theta(x_t,t)\right\|_2^2.\]训练时先取真实样本、采样时间和噪声,构造 $x_t$,所以监督目标 $\epsilon$ 已知。采样时从高斯噪声出发,使用已训练网络和反向更新规则逐步生成。反向步骤可能包含随机项,不能简化成“每步减去任意固定噪声”。[13]
3. 扩散也可以在潜空间进行
像素空间扩散直接处理像素表示,潜空间扩散先用自编码器编码图像,在压缩表示中加噪和去噪,最后解码回图像。LDM 明确把自编码器与扩散结合,以降低计算开销,并通过条件机制支持文本等输入。[14]
因此,“扩散完全不使用压缩、必然没有信息损失”不能作为定义。表示压缩程度、生成质量、采样步数和计算预算,需要结合具体模型考察。
十二、课堂作业与系统成本
本节布置的实践是运行风格迁移代码,观察初始图像怎样随优化变化,并分析内容与风格目标。参考资料中的 PyTorch 官方实现给出了输入图像优化与中间损失记录的代码入口。[15]
阅读和运行时可以保留以下观察:
- 确认预训练特征网络的参数固定,优化器接收的是生成图像。
- 记录初始图、若干中间步和最终图,以及内容、风格和加权总损失。
- 改变内容与风格权重的相对比例,比较结构保留和纹理变化。
- 比较从噪声与内容图初始化的轨迹,固定输入、层选择、预处理和停止条件。
单个损失项会随权重和优化路径变化,应连同加权目标和图片一起观察。比较损失时还需保持归一化与层选择一致,数值大小不能直接替代图像质量判断。
| 方法 | 推理或优化时的主要计算 | 需要重点观察的量 |
|---|---|---|
| 检测网络 | 骨干、预测头、候选处理与后处理 | 延迟、吞吐、显存、AP 及小目标表现 |
| 经典风格迁移 | 对一张图反复前向、反向并更新像素 | 优化次数、分辨率、损失与图像变化 |
| GAN | 训练时交替更新两网络;采样时常用生成器前向 | 样本质量、多样性与训练稳定性 |
| VAE | 编码与解码,或从先验采样后解码 | 重建、潜空间约束和采样质量 |
| 扩散 | 多个反向时间步调用网络,潜空间模型另有编解码 | 采样步数、质量、条件一致性和计算预算 |
目标检测的结构演进不断减少重复计算,生成方法则在单图优化、分布学习和迭代采样之间选择不同路径。网络前向一次、反向更新一次、完成一个样本所需的总工作量,需要分别计算。
参考资料
课堂主线依据《计算机视觉目标检测与生成模型教学》转写,Day6.md 自动摘要用于交叉核对。指标、张量维度和构造数据图为补充推演,模型定义与目标参照以下第一方资料。
- COCO,官方评测实现 cocoeval.py:匹配、IoU 阈值、召回采样和 AP 汇总。
- Girshick 等,Rich feature hierarchies for accurate object detection and semantic segmentation,2013 / CVPR 2014,R-CNN。
- Girshick,Fast R-CNN,ICCV 2015。
- Ren 等,Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks,2015。
- Redmon 等,You Only Look Once: Unified, Real-Time Object Detection,2015 / CVPR 2016。
- Liu 等,SSD: Single Shot MultiBox Detector,2015 / ECCV 2016。
- Lin 等,Feature Pyramid Networks for Object Detection,2016 / CVPR 2017。
- Gatys、Ecker、Bethge,A Neural Algorithm of Artistic Style,2015。
- Goodfellow 等,Generative Adversarial Nets,2014,第 3、4 节。
- Mirza、Osindero,Conditional Generative Adversarial Nets,2014。
- Kingma、Welling,Auto-Encoding Variational Bayes,2013 / ICLR 2014。
- Rezende、Mohamed,Variational Inference with Normalizing Flows,ICML 2015。
- Ho、Jain、Abbeel,Denoising Diffusion Probabilistic Models,2020,第 2、3 节。
- Rombach 等,High-Resolution Image Synthesis with Latent Diffusion Models,2021 / CVPR 2022。
- PyTorch,Neural Transfer Using PyTorch:固定特征网络、Gram 矩阵与输入图像优化的实现。