· 人工智能导论 / 深度学习 / Attention / 自监督学习 / AlphaGo
人工智能导论 Day6:深度网络、注意力与自监督学习
RedMoon · 2026-10-20 · 课堂笔记
上节课介绍了逻辑回归、SVM、决策树、聚类与降维。本节继续追问两个问题:当输入变成图像、语言和关系网络,怎样让模型自己学习有用的表示?当大量数据没有人工标签,训练目标又从哪里来?开场的 AlphaGo 分享把学习与搜索接了起来,后面的深度网络、注意力和自监督学习,则从模型结构与监督信号两方面回答这两个问题。
一、AlphaGo:网络判断、搜索推演与自我对弈
1. 先分清 AlphaGo Zero 与 AlphaZero
AlphaGo 系列并非同一个固定模型。早期 AlphaGo 使用人类棋谱进行监督学习,再结合强化学习和搜索;AlphaGo Zero 从随机初始化的网络出发,通过自我对弈学习围棋。AlphaZero 把相近的学习与搜索框架用于围棋、国际象棋和将棋,针对各棋种分别训练。[1][2]
| 名称 | 本节关注的区别 |
|---|---|
| AlphaGo | 人类棋谱、策略与价值估计、强化学习及搜索的结合 |
| AlphaGo Zero | 在给定围棋规则下,自我对弈生成训练数据 |
| AlphaZero | 同一套主要算法用于多个棋种,各自训练模型 |
课堂提到的“三天后 100∶0”,对应 AlphaGo Zero 对战此前击败李世石的 AlphaGo 版本,不能把对手替换为任意后来版本。[1] 名称中的 Zero 指训练不依赖人类对局数据;它与“在未见任务上直接测试”的零样本学习是两个概念。合法动作、胜负规则和搜索过程仍由系统提供。
2. 策略概率、局面价值与搜索分布
策略价值网络可写为:
\[(p,v)=f_\theta(s).\]输入 $s$ 是局面;$p(a\mid s)$ 表示网络对各合法走法的偏好;$v(s)$ 估计当前玩家视角下的对局结果。策略给某一步较高概率,表达的是“优先考虑这一步”,不能直接读成“这一步的最终胜率”。
蒙特卡洛树搜索(MCTS)在落子前继续推演。它综合已探索走法的价值与探索奖励选择分支,到达新局面后调用网络评估,再沿搜索路径更新访问次数和价值统计。在双人零和棋局中,回传还需保持玩家视角一致:对一方有利的结果,对另一方不利。
重复搜索后,根节点的访问次数形成新的动作分布 $\pi$。网络输出 $p$ 是搜索的先验,搜索得到的 $\pi$ 又成为网络训练的目标。推理时增加搜索,可以在固定网络参数下改进当前决策;训练则通过对弈数据改变参数。[1][2]
3. 一盘棋怎样变成训练样本
自我对弈保存局面、搜索分布及最终结果 $(s,\pi,z)$。从对应玩家视角记胜为 $+1$、负为 $-1$,允许和棋的任务还可记为 $0$。一个典型的策略价值训练目标是:
\[\mathcal L(\theta) =(z-v)^2-\sum_a\pi(a\mid s)\log p(a\mid s) +c\|\theta\|_2^2.\]价值项学习实际对局结果,策略项学习搜索改进后的走法偏好,最后一项约束权重规模。网络帮助搜索生成更好的行动数据,数据再改善网络,形成持续迭代的闭环。自我对弈省去了人类棋谱标注,但训练仍需要大量对局与搜索计算。
二、从人工特征到可学习的表示
传统视觉流程往往先提取颜色直方图、HOG、SIFT 等特征,再训练分类器。这样的特征规定了模型能看到什么:颜色直方图保留颜色统计,却会丢失大量空间排列信息。深度学习把特征提取也放进可训练函数:
\[\hat y=g_\phi\bigl(f_\theta(x)\bigr).\]$f_\theta$ 将原始输入变成表示,$g_\phi$ 根据表示完成预测。端到端训练用最终任务的损失共同调整这两部分,使表示朝着任务需要的方向变化。[3]
高维输入的困难既包括计算开销,也包括如何利用数据结构。例如一张 $224\times224$ 的 RGB 图像包含 $150{,}528$ 个通道数值;$4000\times3000$ 的 RGB 图像则包含 $36{,}000{,}000$ 个。课堂用“上亿数据”强调规模,具体维度仍取决于分辨率、通道数,以及统计的是单帧、视频还是文件字节数。
SVM 等传统方法也能处理高维数据。选择模型时应同时看样本量、特征、结构和计算预算,不能按维度划出“传统方法必然失效”的界线。深度网络的特点是能将表示与预测共同学习,并用结构约束控制连接方式。
深度为什么有用
多层网络通过函数复合建立层级表示:
\[h^{(0)}=x,\qquad h^{(\ell)}=\sigma_\ell\bigl(W_\ell h^{(\ell-1)}+b_\ell\bigr).\]浅层可以组合简单模式,后续层再组合已有表示。万能近似定理说明,在适当激活函数与定义域条件下,足够宽的网络可以逼近相应函数;它讨论的是表示能力,不保证训练能找到参数,也不保证测试时泛化良好。某些函数用更深的网络能以较少单元表示,这构成增加深度的理由,但深度与宽度仍需配合任务选择。[3]
三、非线性激活怎样改变网络能力
1. 加权求和、偏置和激活
人工神经元的常见形式是:
\[z=w^\mathsf{T}x+b,\qquad h=\sigma(z).\]权重改变不同输入的影响,偏置移动响应位置,激活函数提供非线性。感知机通常使用阈值判定;现代网络常用 ReLU、Sigmoid 等可配合梯度训练的激活函数:
\[\operatorname{ReLU}(z)=\max(0,z),\qquad \operatorname{sigmoid}(z)=\frac{1}{1+e^{-z}}.\]生物神经元是设计直觉的来源,以上表达式是人工计算模型。
2. 去掉非线性,多层仿射变换仍可合并
若两层之间没有非线性:
\[W_2(W_1x+b_1)+b_2 =(W_2W_1)x+(W_2b_1+b_2).\]合并后仍是一个仿射变换。增加这样的层数会改变参数化方式,却不会自动得到弯曲的非线性决策边界。[3]
异或(XOR)是最直接的例子:两个二进制输入相同输出 0,不同输出 1。单个线性阈值单元无法将平面上的两类对角点分开。加入隐藏单元后,可以显式构造:
\[h_1=\operatorname{ReLU}(x_1+x_2),\qquad h_2=\operatorname{ReLU}(x_1+x_2-1),\qquad \hat y=h_1-2h_2.\]| $x_1$ | $x_2$ | $h_1$ | $h_2$ | $\hat y$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 2 | 1 | 0 |
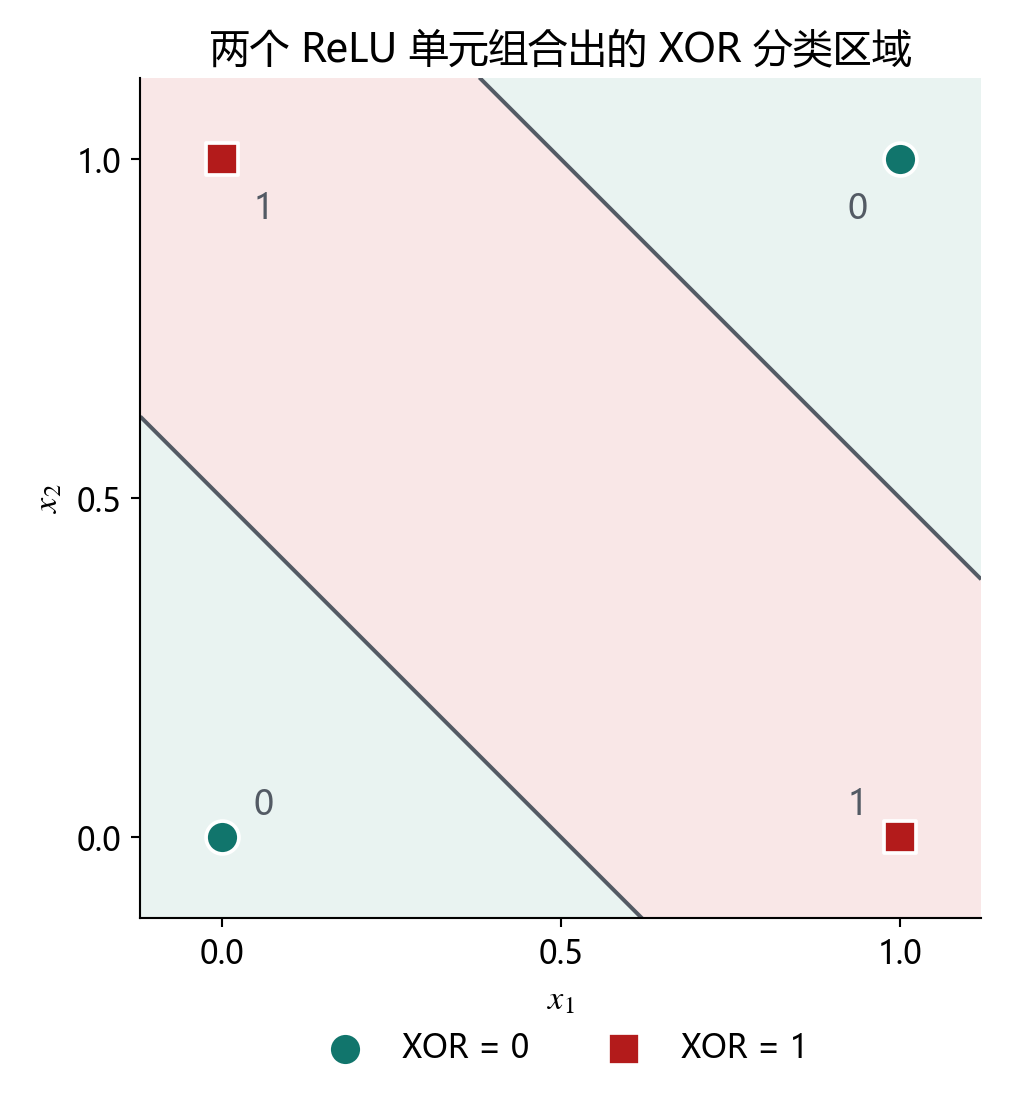
图 1:根据上式直接计算,背景以 $\hat y>0.5$ 划分类别,四个点是 XOR 真值。权重由算式给定,用于展示非线性组合的表达能力。
四、反向传播计算梯度,优化器更新参数
反向传播(BP)沿计算图应用链式法则,复用前向计算保存的中间量和后向已有梯度。它回答“损失对每个参数怎样变化”;梯度下降等优化器再用梯度调整参数。[3]
以两层标量网络为例:
\[h=\operatorname{ReLU}(w_1x),\qquad \hat y=w_2h,\qquad \mathcal L=\frac12(\hat y-y)^2.\]当 $w_1x>0$ 时:
\[\frac{\partial\mathcal L}{\partial w_2}=(\hat y-y)h,\qquad \frac{\partial\mathcal L}{\partial w_1}=(\hat y-y)w_2x.\]取 $x=y=1$、$w_1=1$、$w_2=0.5$,得到预测 $0.5$、损失 $0.125$;损失对 $w_1$、$w_2$ 的梯度分别为 $-0.25$ 和 $-0.5$。采用学习率 $\eta=0.1$ 的梯度下降:
\[w\leftarrow w-\eta\nabla_w\mathcal L,\]更新后 $w_1=1.025$、$w_2=0.55$,预测为 $0.56375$,损失约为 $0.09516$。这是一组用于解释更新方向的手算参数,下降来自沿负梯度移动。
BP 提高了求梯度的效率;一个层包含多少参数,由层的连接结构决定。后面的卷积、循环和图网络,正是对连接方式施加不同约束。
五、CNN:在空间位置复用局部计算
卷积神经网络引入两种约束:一个输出先连接局部邻域,同一组卷积核再用于多个位置。标准二维卷积含偏置的参数量为:
\[N_{\mathrm{param}} =k_hk_wC_{\mathrm{in}}C_{\mathrm{out}}+C_{\mathrm{out}}.\]例如 RGB 输入、$3\times3$ 核、64 个输出通道,需要 $3\times3\times3\times64+64=1792$ 个参数。输入空间变大时,这组共享参数不随位置数量增加;但要计算的窗口与输出激活仍会增加。[4]
以 $224\times224\times3$ 输入为例,全连接到 100 个单元需 $15{,}052{,}900$ 个参数。上述卷积若步长为 1、填充为 1,输出为 $224\times224\times64$。两种层的输出形式不同:全连接直接汇总成向量,卷积保留空间网格供后续处理。
1. 平移等变与平移不变
共享卷积核让同一种局部模式在不同位置使用同一套检测规则。理想的步长为 1 的卷积满足平移等变:输入平移后,输出特征也相应平移,写作 $f(Tx)=T f(x)$。平移不变则是 $f(Tx)=f(x)$,要求输出保持不变。边界填充、步长和下采样会影响实际等变关系。[4]
池化或全局汇总可以减弱部分位置变化对分类输出的影响,但不能据此认定整个 CNN 对任何平移都严格不变。
2. 局部信息怎样变成整体判断
常见分类网络交替使用卷积、激活和下采样,逐层扩大感受野,最后通过全连接层或全局平均池化等方式汇总。池化通常没有可训练权重;卷积是否缩小特征图由步长、填充等决定;展平只改变张量形状,不负责学习新的特征。
六、RNN:共享时间更新规则,用隐藏状态保存历史
循环神经网络用同一套参数逐步处理序列:
\[h_t=\phi(W_xx_t+W_hh_{t-1}+b_h),\qquad \hat y_t=g(W_yh_t+b_y).\]$x_t$ 是当前输入,$h_{t-1}$ 汇总此前历史,$h_t$ 是更新后的隐藏状态。共享的是参数;同一段序列中的隐藏状态随输入不断改变。[5]
课堂借助马尔可夫链解释递推。这里“一步更新只直接读取前一隐藏状态”,不等于模型只能使用前一个原始输入。因为 $h_{t-1}$ 又由更早状态递推而来,$h_t$ 可以间接依赖整个前缀。真正的问题是有限状态怎样保存有用信息,以及长时间跨度的依赖能否有效学到。
长序列为什么难训练
跨时间反传会乘上多个状态更新的雅可比:
\[\frac{\partial h_t}{\partial h_{t-k}} =J_tJ_{t-1}\cdots J_{t-k+1},\qquad J_j=\frac{\partial h_j}{\partial h_{j-1}}.\]这些因子包含循环权重和激活导数。用标量作直觉例子,连续 10 个因子均为 $0.5$ 时乘积约为 $0.000977$;均为 $1.5$ 时约为 $57.67$。这说明梯度可能迅速衰减或放大。真实网络还受矩阵方向、激活与状态轨迹影响。[5]
注意力为远处位置提供了更直接的信息通路,避免所有关系都必须经由逐步递推传到目标位置。
七、Attention:按内容计算信息的汇聚权重
1. Query、Key、Value 各负责什么
缩放点积注意力可写为:
\[A=\operatorname{softmax}\left(\frac{QK^\mathsf{T}}{\sqrt{d_k}}+M\right), \qquad O=AV.\]每一行 Query 与各行 Key 比较得到分数,按行归一化为权重,再对对应 Value 加权求和。$M$ 是可选掩码,规定哪些连接允许出现;$d_k$ 是 Query 与 Key 的维度。[6]
自注意力中的三者来自同一输入序列,但使用各自的投影:
\[Q=XW_Q,\qquad K=XW_K,\qquad V=XW_V.\]因此“都来自 $X$”不表示 $Q=K=V$。交叉注意力则可让 Query 来自一段表示,Key 和 Value 来自另一段。
Softmax 给出连续权重。对于没有被屏蔽、分数有限的项,权重通常处于 0 和 1 之间,所有候选的权重之和为 1;它不会自动执行“强关系变 1、弱关系变 0”的硬分类。
2. 算一行注意力
取 $q=[1,0]$,三个 Key 分别为 $[1,0]$、$[0,1]$、$[1,1]$。按 $\sqrt2$ 缩放后的分数为 $[0.7071,0,0.7071]$,Softmax 约为 $[0.4011,0.1978,0.4011]$。
若 Value 分别为 $[1,0]$、$[0,2]$、$[3,1]$,这行注意力的输出约为 $[1.6044,0.7967]$。输出是按相关程度组合后的新表示。
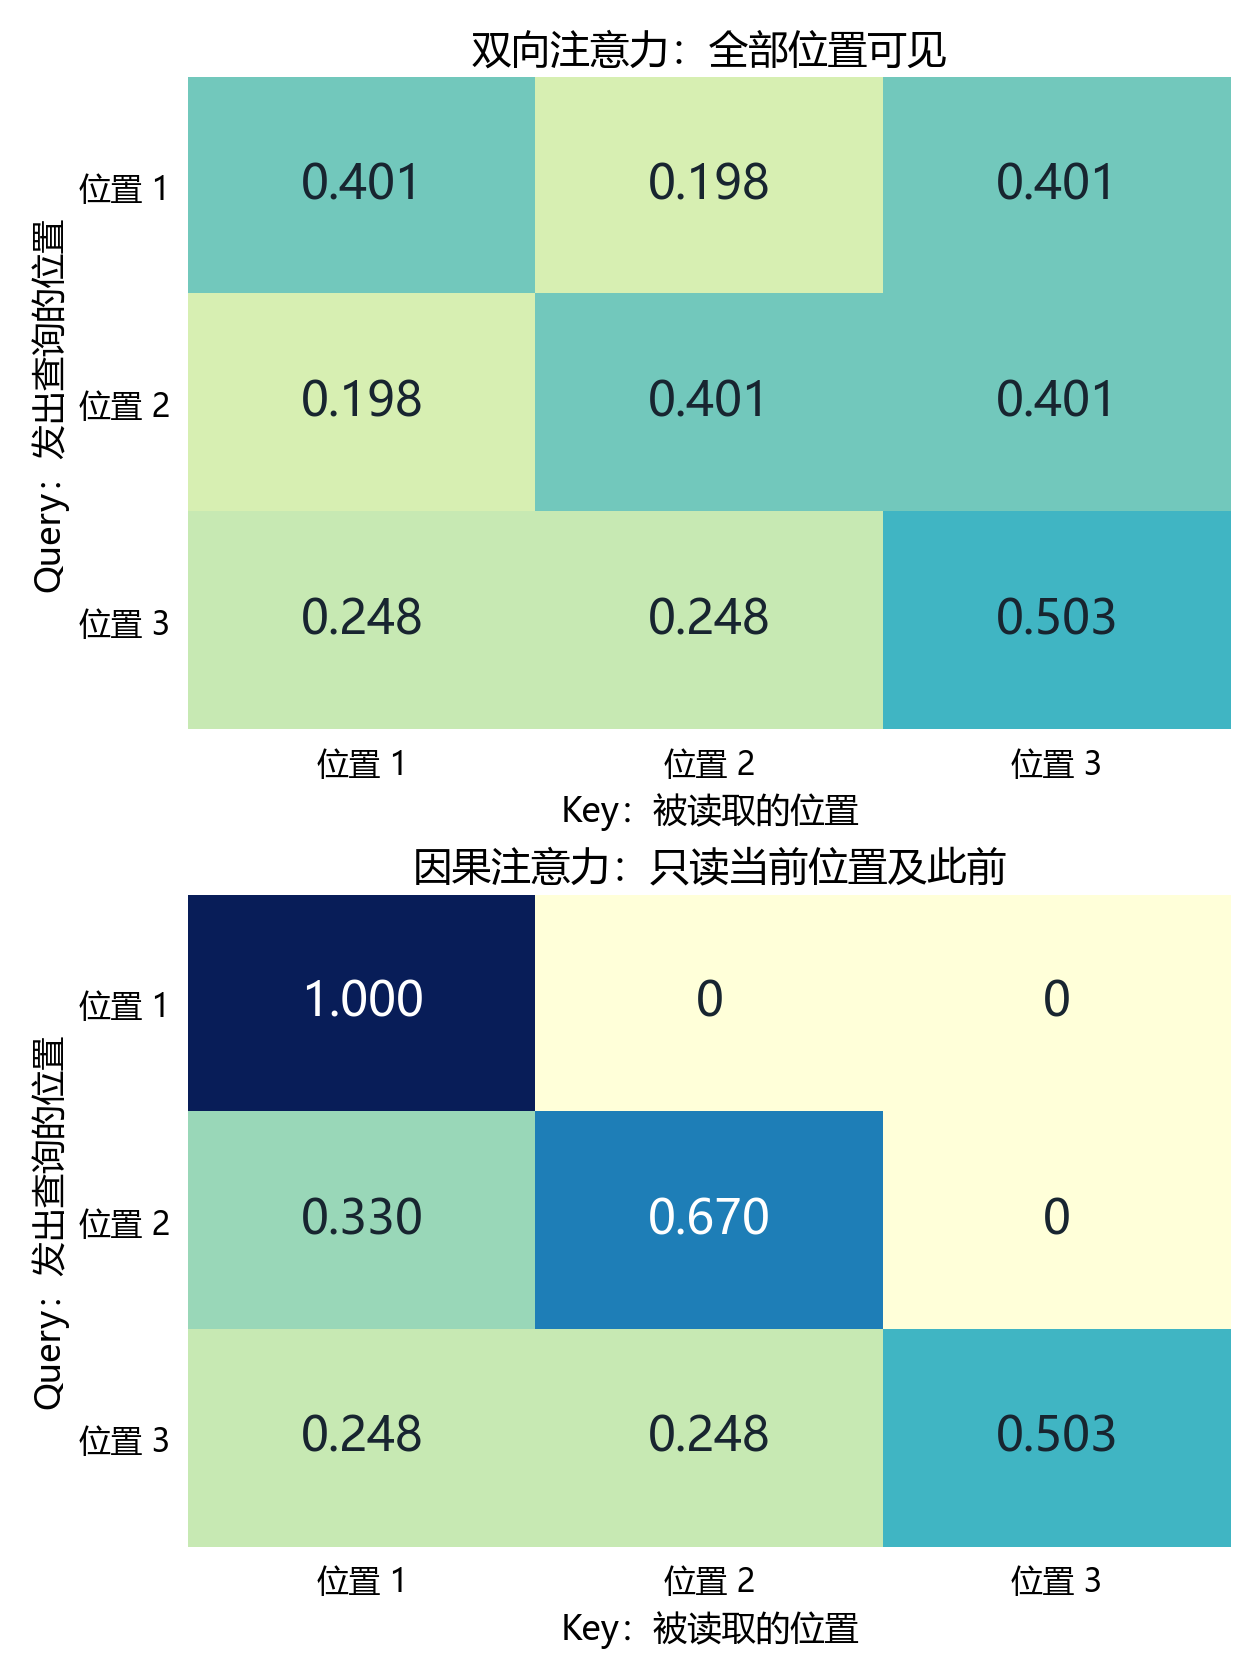
图 2:构造三个位置的 Query 和 Key,直接计算注意力矩阵。行表示发出查询的位置,列表示被读取的位置;因果掩码屏蔽未来位置,图中的 0 来自掩码,其他数字来自 Softmax。
3. 长距离联系与顺序信息
不加局部限制的自注意力允许任意两个可见位置直接交互。自回归生成仍需因果掩码,让当前位置的预测只使用允许的前缀;位置编码等机制提供顺序信息。完整 Transformer 还包括前馈子层、残差连接和归一化。[6]
朴素全注意力有 $n\times n$ 的位置配对;这部分计算约为 $O(n^2d)$。投影层还有其他开销,具体实现也可能避免显式保存整个矩阵。关系连得更直接,与计算更便宜,是需要分别判断的两件事。
八、GNN:沿关系图聚合邻居信息
图像通常有规则网格,文本有序列顺序;社交关系、分子连接、用户与物品交互则天然形成图。图神经网络将节点、边和邻接关系作为输入,通过消息传递更新表示。[7]
一个常见写法是:
\[m_v^{(\ell)} =\sum_{u\in\mathcal N(v)} \psi_\ell\bigl(h_v^{(\ell)},h_u^{(\ell)},e_{uv}\bigr), \qquad h_v^{(\ell+1)} =\phi_\ell\bigl(h_v^{(\ell)},m_v^{(\ell)}\bigr).\]$\psi$ 根据邻居和边生成消息,聚合函数合并消息,$\phi$ 更新节点状态。求和、均值等聚合方式使结果不依赖邻居列举的先后顺序。多层局部消息传递让节点逐步接触更远邻居,但能保留哪些信息仍取决于具体结构。
CNN、RNN 和 GNN 都把数据关系写进模型:分别围绕空间邻域、时间递推和图邻接关系组织计算。注意力则依据表示计算可见位置之间的内容相关权重。它们提供不同的归纳偏置,也可以在一个系统中组合。
九、自监督学习:从原始数据构造预测目标
前面几节讨论怎样组织计算,接下来转向怎样构造训练信号。自监督学习利用样本自身的结构生成输入和目标,例如用文本前缀预测后续 token,用图像可见部分预测遮挡部分,或比较同一样本的不同增强视图。[8][9][10]
| 方法 | 模型能看到什么 | 需要预测或匹配什么 |
|---|---|---|
| 自回归语言建模 | 当前位置之前的 token | 下一个 token |
| 掩码语言建模 | 被扰动文本及其上下文 | 被选中位置的原 token |
| 掩码图像建模 | 可见图像块 | 遮挡区域的像素或其他目标表示 |
| 对比学习 | 样本的多个增强视图及其他候选 | 哪些表示应更接近 |
这里仍有监督信号,只是目标由数据构造,减少了逐条人工标注的需求。任务设计决定模型必须利用哪些关系,数据中的偏差也会进入训练过程。
预训练与有监督微调
预训练先在大规模数据和较通用的目标上学习参数,微调再用任务数据调整模型。BERT 就用预训练参数初始化不同的下游模型,再以标注样本训练相应任务。[8]
课堂用“先学通识,再学职业技能”解释这个过程。落实到模型上,要看预训练目标、下游数据、可更新参数和评测任务。预训练加有监督微调是一种常见路径;具体系统还可能增加偏好优化、强化学习等阶段,不能把两个步骤当作所有模型的完整训练配方。
十、自回归与掩码重建:预测时能看见什么
1. 自回归:按条件概率分解序列
自回归语言模型将序列概率分解为:
\[p_\theta(x_{1:T}) =\prod_{t=1}^{T}p_\theta(x_t\mid x_{<t}),\qquad \mathcal L_{\mathrm{AR}} =-\sum_{t=1}^{T}\log p_\theta(x_t\mid x_{<t}).\]训练样本本身就提供目标 token。输入通常整体右移对齐预测目标,并用因果掩码防止未来信息泄露。在 Transformer 训练中,可以同时计算多个位置的损失;常见自回归推理则根据已知前缀逐个生成新 token。[6]
因此课堂“上一行代码预测下一行”的例子,应理解为根据代码前缀预测后续内容。模型的基本预测单位取决于 tokenizer,通常不是固定的一整行代码。
2. 掩码语言建模:用上下文恢复原内容
掩码语言模型选择部分位置作为预测目标,利用可见上下文恢复原 token。原始 BERT 随机选中 15% 的位置,其中 80% 替换成 [MASK]、10% 换成随机 token、10% 保持原样;损失针对这些被选中的目标位置计算。[8]
“遮住一部分再恢复”是目标构造方式,不能直接等同于“模型看不到任何右侧上下文”。BERT 的双向上下文与自回归模型的因果前缀,提供了不同的信息条件。
3. MAE:用可见图像块重建遮挡区域
掩码自编码器(MAE)将图像切成块,随机遮掉较大比例,编码器处理可见块,轻量解码器结合表示和掩码 token 重建图像。原论文常用 75% 的遮挡率;重建损失在遮挡块上计算,推动可见部分携带预测缺失区域所需的信息。[9]
自编码器是一类重建式框架,掩码自编码器在此基础上构造缺失输入的任务。它与自回归分解的差异,主要在输入可见性、目标位置及模型组织方式。重建与对比任务也应区分:重建要恢复目标内容,对比学习直接约束表示之间的关系。
十一、对比学习:学习哪些变化应保留语义
1. 正负样本关系由任务定义
同一张图片经过裁剪、颜色扰动等增强,可以得到两个正样本视图。模型被要求在这些变化后仍保留相关信息;其他样本通常提供负样本。增强必须符合任务,例如数字识别中随意旋转可能改变数字含义。[10][11]
表示接近,指编码后的向量相似,不要求像素逐点接近。同一对象姿态改变可能带来很大像素差异,编码器需要保留有助于任务的关系。
同一类别的两张不同图片,在实例级对比任务中也可能被当作负样本。因此“正样本就是同类、负样本就是异类”只适用于特定构造,不能直接套给所有自监督对比方法。
2. InfoNCE:在一组候选中辨认正样本
设 $q$ 为查询表示,$k^+$ 为正样本表示,$k_j^-$ 为负样本表示,$\operatorname{sim}$ 为相似度,温度 $\tau>0$。常用的对比目标可写为:
\[\mathcal L_q =-\log \frac{\exp\bigl(\operatorname{sim}(q,k^+)/\tau\bigr)} {\exp\bigl(\operatorname{sim}(q,k^+)/\tau\bigr) +\sum_{j=1}^{K}\exp\bigl(\operatorname{sim}(q,k_j^-)/\tau\bigr)}.\]分母包含正样本和全部负样本。降低损失,要求正样本相对其他候选具有更高分数。CPC 使用这种对比预测思路;SimCLR 则研究了数据增强、非线性投影和对比训练如何影响学到的视觉表示。[10][11]
取相似度 $[0.8,0.4,0.1]$,第一项是正样本。$\tau=1$ 时,正样本归一化概率约为 $0.4615$,损失约为 $0.7733$;$\tau=0.2$ 时,约为 $0.8580$ 和 $0.1532$。温度越低,同一组分数的分布越尖锐;如果错误候选分数最高,它也会更尖锐地集中到错误候选上。
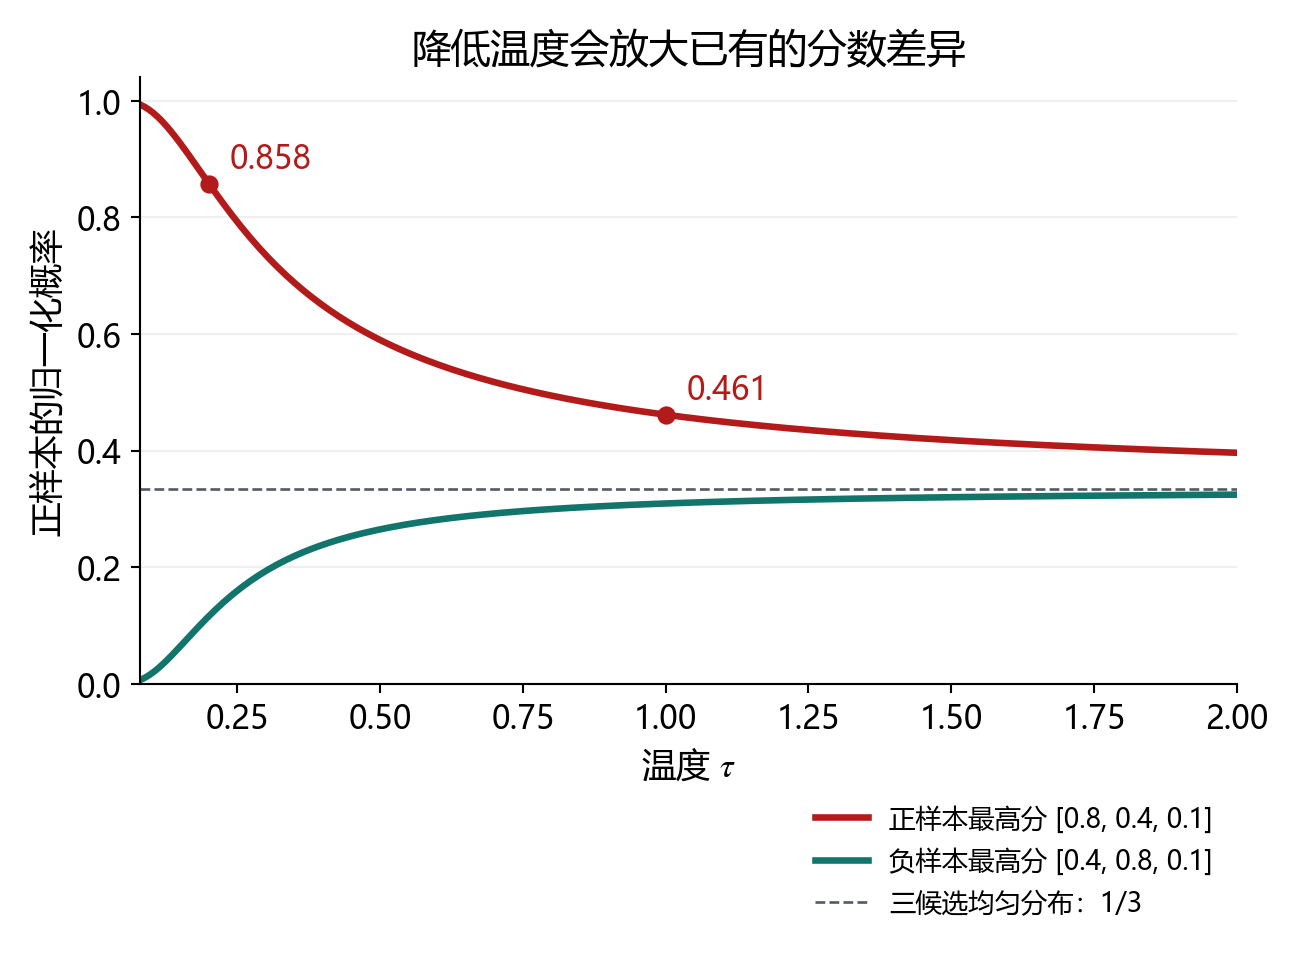
图 3:直接计算两组固定分数的 Softmax。红线对应正样本最高分,蓝线对应负样本最高分;曲线展示温度的数学作用,不是训练准确率。
较小温度会改变梯度尺度以及困难负样本的影响,实际选择还需结合表示归一化、负样本与训练稳定性。它没有“越小越好”的普遍结论。
3. 教师学生结构与对比目标分别看
教师学生描述的是目标如何在两个模型之间传递。教师可以产生软标签或目标表示,让学生匹配;教师可能来自监督训练,也可能由学生参数的移动平均等方式更新。DINO 就把无标签自蒸馏用于视觉表示学习。[12]
教师学生结构可以与掩码任务或其他目标组合。判断是否属于显式对比学习,应检查有没有正负候选及相应损失;两个网络分别叫 teacher 和 student,并不能单独决定训练目标。
十二、把模型结构与学习目标放在两个维度上
| 维度 | 本节概念 | 决定的问题 |
|---|---|---|
| 表示与连接 | MLP、CNN、RNN、GNN、Attention | 输入之间通过什么路径交换信息 |
| 学习目标 | 分类、回归、自回归、重建、对比 | 哪种预测错误或表示关系要被优化 |
| 优化机制 | 反向传播、梯度下降 | 怎样求梯度并调整参数 |
| 训练组织 | 预训练、微调、自我对弈 | 数据怎样产生、参数怎样接续学习 |
| 决策过程 | 网络直接预测、结合搜索 | 固定参数后怎样选择当前动作 |
同一种 Transformer 可以用于自回归预测、掩码建模或对比表示学习,同一种对比目标也可以搭配 CNN 或 Transformer。AlphaGo 则展示了另一种组合:网络学习策略与价值,搜索利用这些判断生成更强的行动目标。读一个新模型时,把连接结构、目标、数据和决策过程分别辨认清楚,才能解释它具体学到了什么、计算花在了哪里。
参考资料
课堂主线依据《深度学习核心算法与前沿模型综述》转写,Day6.md 摘要用于交叉核对。XOR、标量梯度、注意力权重和温度曲线为补充推演;以下资料用于核对标准定义、训练目标与模型区别。
- Silver 等,AlphaGo Zero: Starting from scratch,Google DeepMind,2017;Mastering the game of Go without human knowledge,Nature,2017。
- Silver 等,AlphaZero: Shedding new light on chess, shogi, and Go,Google DeepMind,2018;A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play,Science,2018。
- Goodfellow、Bengio、Courville,Deep Learning,第 6 章:Deep Feedforward Networks,2016。
- 同上,第 9 章:Convolutional Networks:稀疏连接、参数共享和平移等变。
- 同上,第 10 章:Sequence Modeling: Recurrent and Recursive Nets:隐藏状态、时间共享及长距离依赖。
- Vaswani 等,Attention Is All You Need,2017,第 3.2、3.5 节及第 4 节。
- Gilmer 等,Neural Message Passing for Quantum Chemistry,ICML,2017。
- Devlin 等,BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,2018 / NAACL,2019,第 3 节。
- He 等,Masked Autoencoders Are Scalable Vision Learners,2021 / CVPR,2022。
- van den Oord、Li、Vinyals,Representation Learning with Contrastive Predictive Coding,2018。
- Chen 等,A Simple Framework for Contrastive Learning of Visual Representations,ICML,2020。
- Caron 等,Emerging Properties in Self-Supervised Vision Transformers,2021。