· 智能计算系统 / CNN / 卷积 / ResNet / Vision Transformer
智能计算系统 Day5:卷积网络的计算机制与视觉模型演进
上节课讨论了参数怎样通过反向传播被训练出来。本节把问题推进到网络结构:图像有大量像素,怎样保留空间关系,同时控制参数、运算与内存开销?课堂从全连接层的规模讲起,依次引出局部连接、权重共享、池化与感受野,再回顾 AlexNet、VGG、Inception、ResNet,最后衔接 Transformer 与视觉模型的架构变化。
一、数据结构怎样影响网络结构
图像通常写成高、宽、通道三个维度,例如 $32\times32\times3$ 的 RGB 图像。相邻像素之间存在空间关系,同一边缘或纹理也可能出现在不同位置。卷积网络把这两点写进连接方式:优先处理局部邻域,并把同一组检测规则复用到多个位置。[1]
语言、语音等序列数据还包含顺序与上下文依赖。循环网络通过状态传递组织历史信息,Transformer 则通过注意力建立位置之间的联系。本节主要讲二维图像;循环网络只是课程衔接内容,没有在本次材料中展开推导。[9]
“空间”与“序列”是组织数据的两个角度。视频同时具有空间维度和时间维度;图像也可以切成 patch 后变成序列。网络的选择取决于希望保留哪些关系,以及愿意付出多少计算成本。[10]
二、全连接层为什么容易出现参数膨胀
把图像展平后送入全连接层,输入维度为 $d_{\mathrm{in}}=HWC$。若该层输出 $M$ 个神经元,含偏置的参数量为:
\[N_{\mathrm{FC}}=HWC\,M+M.\]课堂用 $32\times32\times3$ 图像和 100 个隐藏单元举例。展平后的向量长 3072,第一层有 $3072\times100=307{,}200$ 个权重,再加 100 个偏置。这已经超过 30 万个参数。
输入尺寸扩大时,先固定输出宽度,再计算规模,才能避免混用不同例子的数字:
| 输入图像 | 展平长度 | 输出宽度 | 权重数,不含偏置 |
|---|---|---|---|
| $32\times32\times3$ | 3072 | 100 | 307,200 |
| $1024\times1024\times3$ | 3,145,728 | 100 | 314,572,800 |
| $1024\times1024\times3$ | 3,145,728 | 1000 | 3,145,728,000 |
第二行约 3.15 亿,第三行约 31.46 亿。若按 FP32 每个权重 4 字节计算,两者的权重存储分别约为 1.26 GB 和 12.58 GB,采用十进制 GB;训练还需要梯度、优化器状态和中间激活。
全连接层为每个输入位置单独学习权重。图像平移后,原来的局部结构会落到新的输入索引上,网络需要从数据中学习这种位置变化。卷积通过局部连接与共享权重提供更直接的空间约束。[1]
三、卷积的两条核心规则
1. 局部连接:每次看一个邻域
一个 $3\times3$ 卷积核先处理一个局部窗口,得到一个输出值;随后窗口移动,继续处理下一处。单层直接覆盖的空间范围有限,多层网络再逐步组合这些局部信息。[1]
课堂用生物视觉的局部感受野解释设计直觉。技术定义仍落在网络连接上:某个输出单元能够依赖哪些输入位置,决定了它的感受野。
2. 权重共享:同一组参数反复使用
同一个卷积核在不同空间位置使用同一组权重。设卷积核大小为 $k_h\times k_w$,输入通道为 $C_{\mathrm{in}}$,输出通道为 $C_{\mathrm{out}}$,标准卷积含偏置的参数量为:
\[N_{\mathrm{conv}} =k_hk_wC_{\mathrm{in}}C_{\mathrm{out}}+C_{\mathrm{out}}.\]它与图像高宽无关,但与输入、输出通道都有关。[1]
| 卷积设置 | 权重数 | 偏置数 | 参数总数 |
|---|---|---|---|
| 灰度输入,$3\times3$,1 个输出通道 | 9 | 1 | 10 |
| 灰度输入,$3\times3$,64 个输出通道 | 576 | 64 | 640 |
| RGB 输入,$3\times3$,64 个输出通道 | 1728 | 64 | 1792 |
| 64 通道输入,$3\times3$,128 个输出通道 | 73,728 | 128 | 73,856 |
课堂“500 多个参数”的例子对应单输入通道、64 个输出通道的 576 个权重;处理 RGB 时还要乘以 3。把输入通道写清楚,才能用同一公式比较不同网络。
3. 参数少,仍需在许多位置执行运算
忽略偏置与激活,标准卷积的乘加次数约为:
\[\mathrm{MACs} =H_{\mathrm{out}}W_{\mathrm{out}}k_hk_wC_{\mathrm{in}}C_{\mathrm{out}}.\]这里一次 MAC 指一次乘法及其累加。相同的 RGB 到 64 通道 $3\times3$ 卷积,若保持输入高宽,处理 $32\times32$ 图像约需 177 万次乘加,处理 $1024\times1024$ 图像约需 18.12 亿次乘加。权重仍是 1728 个,输出激活数量却从 65,536 增加到 67,108,864。
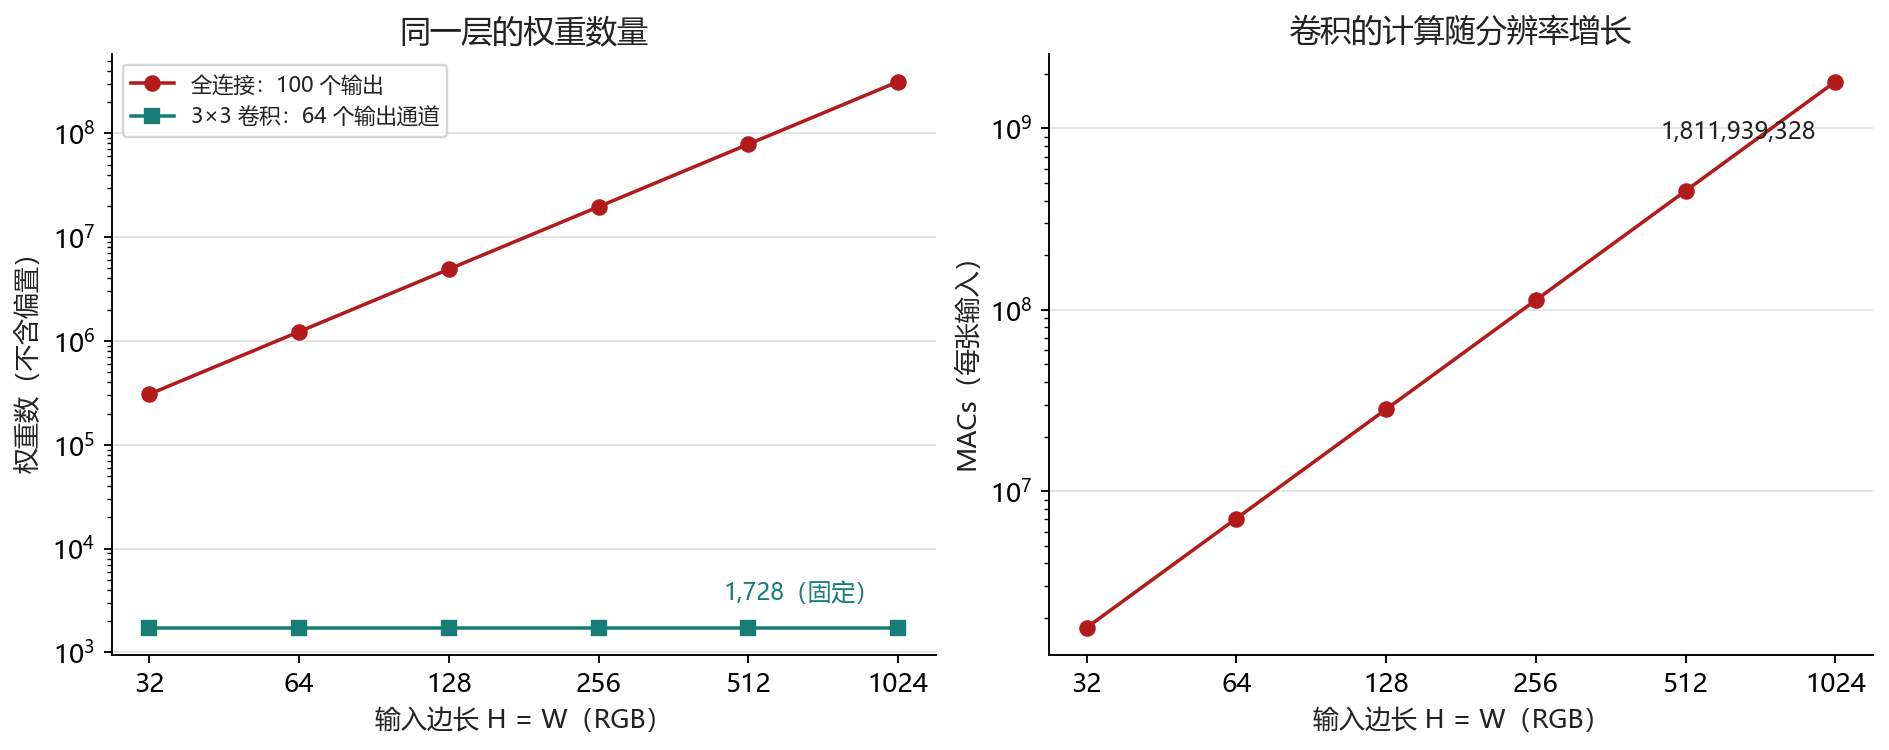
图 1:按公式计算的教学数据。左图固定 RGB 输入、全连接输出宽度 100、卷积输出通道 64;右图为步长 1、填充 1 的标准卷积。参数复用控制权重存储,空间分辨率仍决定大量计算和激活存储。
四、一次卷积究竟算了什么
1. 单通道:对应相乘,再求和
取一个教学窗口及卷积核:
\[X= \begin{bmatrix} 1&2&3\\ 4&5&6\\ 7&8&9 \end{bmatrix}, \qquad K= \begin{bmatrix} 1&0&-1\\ 1&0&-1\\ 1&0&-1 \end{bmatrix}.\]不加偏置时,这个位置的输出为:
\[y=(1-3)+(4-6)+(7-9)=-6.\]该核比较窗口左侧与右侧的数值。处在均匀区域时输出为零,跨过亮度变化边界时产生响应,因而可以检测某一方向的边缘。
深度学习框架通常实现不翻转卷积核的互相关,并沿用“卷积”的名称。阅读实现时,按实际的对应位置相乘即可。[1]
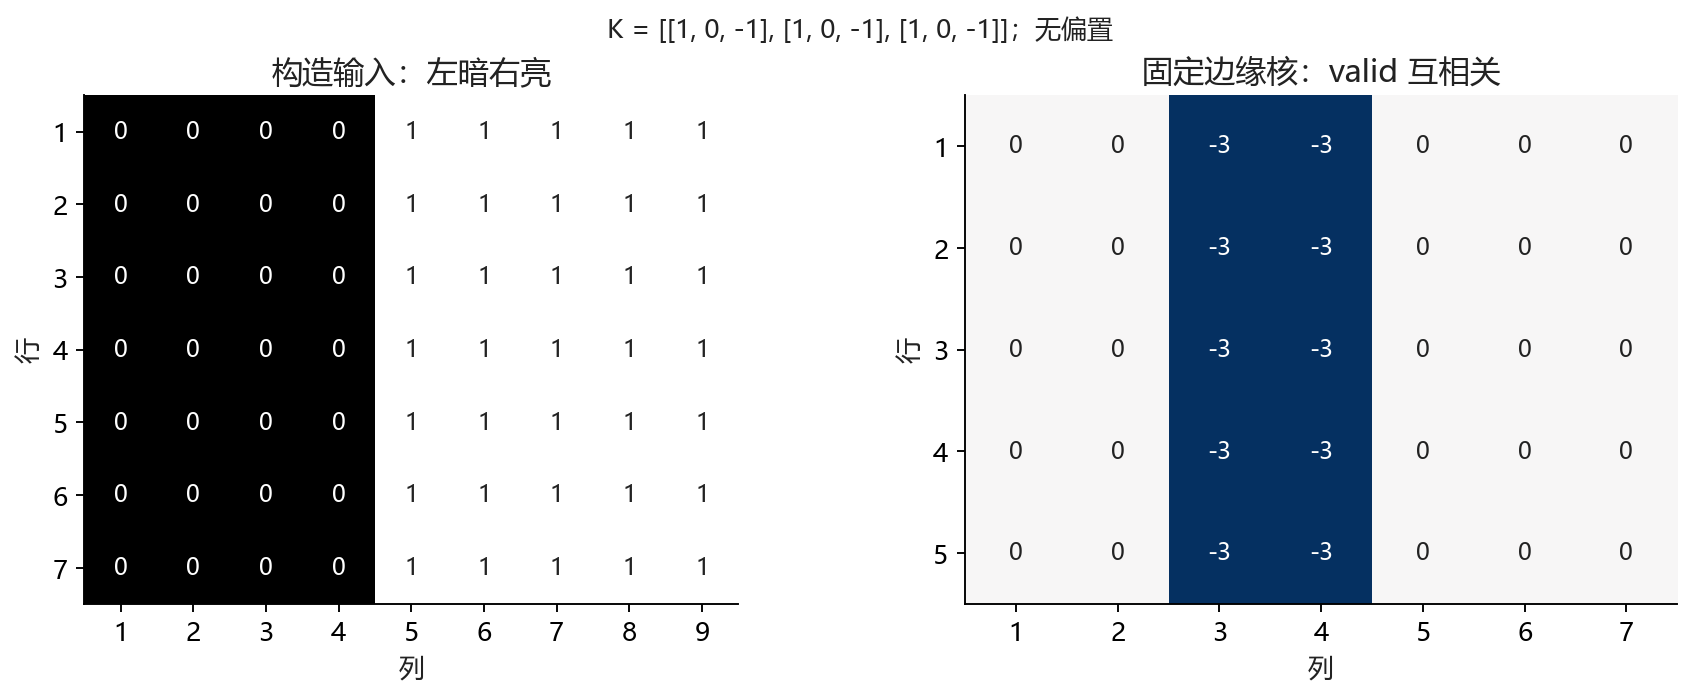
图 2:左侧为构造的 0/1 阶跃图像,右侧为上述固定卷积核的 valid 输出。响应集中在亮度改变处;它演示局部算子的行为,不是训练后的模型可视化。
2. 多通道:对所有输入通道的局部结果求和
RGB 输入包含三个通道,一个标准输出滤波器的权重形状是 $3\times3\times3$。每个输入通道分别做局部加权求和,三个结果相加,再加这个输出通道的偏置,得到一个输出位置。[1]
对步长 1、无填充的情形,可以写成:
\[Y_{o,i,j} =b_o+ \sum_{c=1}^{C_{\mathrm{in}}} \sum_{u=0}^{k_h-1} \sum_{v=0}^{k_w-1} K_{o,c,u,v}X_{c,i+u,j+v}.\]64 个输出通道意味着 64 组这样的滤波器,每组都能组合所有输入通道。各组权重在训练中学习不同的响应模式;“一个输出通道只看一个输入通道”属于 depthwise 等受约束的连接方式。
3. 卷积核可以学出来
边缘核是便于解释的固定例子。真实 CNN 通常随机初始化卷积核,再通过损失与反向传播更新。浅层容易呈现边缘、方向或纹理响应,后续层组合更复杂的特征;具体表示随任务与训练结果而变化。[2]
课堂提到观察网络各层的可视化。浅层核权重可以直接展示,深层特征图则展示输入经过网络后的响应;两者是不同对象,读图时应确认画的是权重还是激活。
五、Padding、Stride 与输出尺寸
设输入尺寸为 $H\times W$,方形卷积核大小为 $k$,每边填充为 $p$,步长为 $s$,膨胀率为 $d$。输出高为:
\[H_{\mathrm{out}} =\left\lfloor \frac{H+2p-d(k-1)-1}{s}+1 \right\rfloor.\]输出宽同理。普通卷积取 $d=1$。[1]
| 输入 | 核 | 填充 | 步长 | 输出 |
|---|---|---|---|---|
| $32\times32$ | $3\times3$ | 0 | 1 | $30\times30$ |
| $32\times32$ | $3\times3$ | 1 | 1 | $32\times32$ |
| $32\times32$ | $3\times3$ | 1 | 2 | $16\times16$ |
| $32\times32$ | $5\times5$ | 2 | 1 | $32\times32$ |
Padding 让边界附近也能形成窗口,并控制输出尺寸。补零是常见方式,也可采用反射等边界处理。Stride 决定窗口每次移动多远;步长 2 常用于空间下采样。[1]
因此,卷积是否缩小图像,要结合核、填充与步长判断。$3\times3$ 卷积配填充 1、步长 1,会保持空间尺寸。
六、池化与感受野:从局部走向整体
1. 池化怎样缩小特征图
对窗口
\[\begin{bmatrix} 1&3\\ 2&4 \end{bmatrix},\]最大池化输出 4,平均池化输出 2.5。$2\times2$、步长 2 的池化通常把高宽各减半,通道数保持不变;空间位置数变成原来的四分之一。[3]
普通最大池化没有可训练权重。它缩减激活数量与后续处理规模,也保留一定的局部强响应。下采样会压缩空间细节,所以使用次数与任务需要有关:分类更重视整体类别,定位与分割还需要保留或恢复位置信息。
2. 多层网络怎样扩大感受野
相邻层的窗口不断组合前一层的局部结果。两个步长 1 的 $3\times3$ 卷积,理论感受野是 $5\times5$;三个这样的卷积是 $7\times7$。中间若有下采样,后续窗口在原图上覆盖的范围会增长得更快。
令 $r_l$ 为第 $l$ 层单个位置的理论感受野边长,$j_l$ 为相邻输出位置在原输入上的间隔,取 $r_0=j_0=1$。普通卷积或池化满足:
\[r_l=r_{l-1}+(k_l-1)j_{l-1}, \qquad j_l=j_{l-1}s_l.\]以下按递推式给出一组教学网络的结果:
| 操作 | 核 / 步长 | 输出空间尺寸 | 理论感受野边长 | 原图间隔 |
|---|---|---|---|---|
| 输入 | — | $32\times32$ | 1 | 1 |
| 卷积 1,填充 1 | 3 / 1 | $32\times32$ | 3 | 1 |
| 池化 1 | 2 / 2 | $16\times16$ | 4 | 2 |
| 卷积 2,填充 1 | 3 / 1 | $16\times16$ | 8 | 2 |
| 池化 2 | 2 / 2 | $8\times8$ | 10 | 4 |
| 卷积 3,填充 1 | 3 / 1 | $8\times8$ | 18 | 4 |
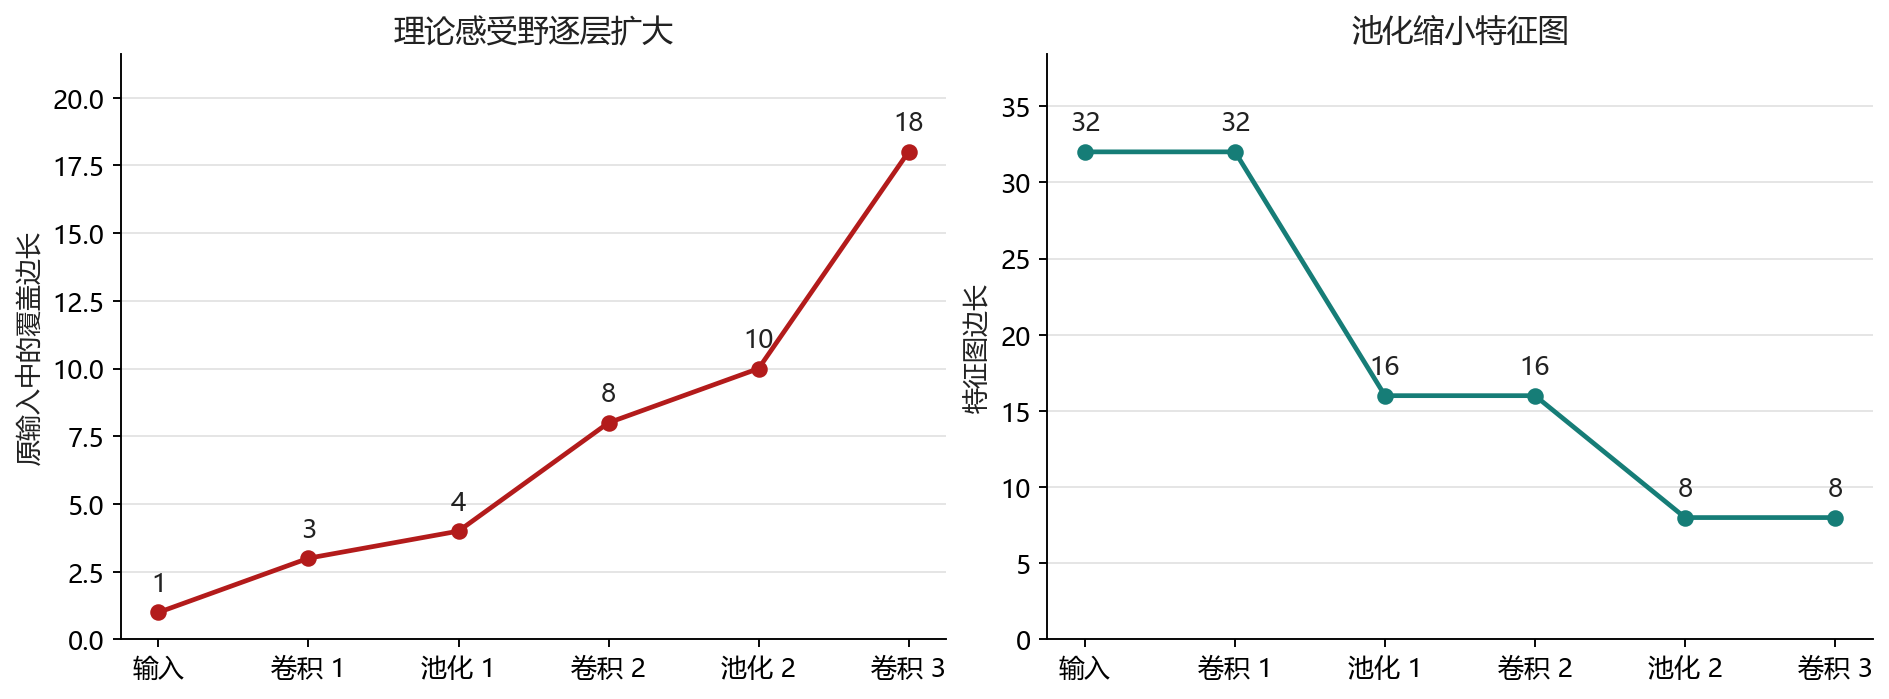
图 3:由上表递推得到。特征图变小的同时,一个输出位置能够依赖更大的输入区域;理论感受野描述连接范围,实际各位置贡献还取决于权重、激活及输入。边界附近的部分范围会落在填充值上。
3. 怎么把特征变成整张图的类别
经典分类器把末端 $H’\times W’\times C’$ 特征展平,再接全连接层。例如 $8\times8\times64$ 展平后长度是 4096;它是由前面输出尺寸决定的,不是所有 CNN 的固定宽度。
连接到 4096 个输出时,仅权重就有 $4096^2=16{,}777{,}216$ 个。因而 CNN 的全连接尾部也可能占据大量参数。
另一种做法是全局平均池化:对每个通道的所有空间位置求平均,得到 $C’$ 维向量,再接分类器。若 64 通道映射到 10 类,这个分类层含偏置只需 $64\times10+10=650$ 个参数。ResNet 的标准分类架构采用全局平均池化接分类层。[6]
七、可分离卷积:怎样进一步控制成本
课堂提到“分离卷积”,但转写没有给出足够清晰的张量分解。这里补充两类常见做法,避免把它们混为一种。
1. 深度可分离卷积
MobileNet 中的 depthwise separable convolution 拆成两步:depthwise 卷积分别处理各输入通道;随后用 $1\times1$ pointwise 卷积混合通道,生成所需输出通道。[7]
忽略偏置,标准卷积与该分解的权重数分别为:
\[N_{\mathrm{standard}}=k^2C_{\mathrm{in}}C_{\mathrm{out}},\] \[N_{\mathrm{separable}}=k^2C_{\mathrm{in}}+ C_{\mathrm{in}}C_{\mathrm{out}}.\]对应比例为:
\[\frac{N_{\mathrm{separable}}}{N_{\mathrm{standard}}} =\frac{1}{C_{\mathrm{out}}}+\frac{1}{k^2}.\]取 $k=3$、$C_{\mathrm{in}}=64$、$C_{\mathrm{out}}=128$,标准卷积有 73,728 个权重,分解后为 $576+8192=8768$ 个,约为原来的 11.9%。它施加了不同的连接约束,适合在精度和资源之间选择工作点。[7]
2. 空间方向上的分解
把 $k\times k$ 运算拆成 $k\times1$ 与 $1\times k$,是另一种空间分解思路。在单通道、可分离核的简化情形下,$3\times3$ 的 9 个系数可以由两个长度 3 的核表示。但真实多通道网络的参数还取决于中间通道数,不能直接把每个 $3\times3$ 层都算成“9 减到 6”。
这些分解改变了计算组织。实际延迟还与访存、算子实现和硬件利用率有关,应同时观察参数量、乘加次数和实测运行时间。
八、CNN 怎样训练,初始化为什么重要
训练链条延续上节课:前向传播计算类别得分,分类损失衡量预测与标签的差距,反向传播计算梯度,优化器更新卷积核与分类层参数。
共享权重会在许多位置参与前向计算。它的梯度需要累加所有使用位置的贡献;每个位置没有独立更新的一套卷积核。[1]
课堂用“从山坡起点向下走”的类比讲初始化。初始化更直接的作用,是打破同层单元的对称性,并控制层间信号与梯度尺度。均匀分布与正态分布都可使用,关键在于与输入输出宽度、激活函数相匹配的方差。[8]
| 初始化 | 常见尺度,零均值 | 适用考虑 |
|---|---|---|
| Xavier / Glorot | $\operatorname{Var}(W)\approx2/(\mathrm{fan_in}+\mathrm{fan_out})$ | 协调前向和反向的尺度,常用于 tanh 等设置 |
| He,ReLU、fan-in 形式 | $\operatorname{Var}(W)\approx2/\mathrm{fan_in}$ | 补偿 ReLU 截断带来的尺度变化 |
对标准卷积,$\mathrm{fan_in}=k_hk_wC_{\mathrm{in}}$。若 $3\times3$、64 输入通道使用上述 He 形式,则方差为 $2/576$,标准差约 0.0589。[8]
初始化、学习率和梯度裁剪解决的是不同问题:初始化设置起始尺度,学习率控制更新幅度,裁剪限制异常大梯度。选择某种随机分布并不能保证找到全局最优解。
九、经典视觉网络分别改变了什么
1. AlexNet:让深层 CNN 在大规模识别中发挥作用
2012 年的 AlexNet 包含 5 个卷积层和 3 个全连接层,共 8 个带权重层。它结合 ReLU、数据增强、Dropout 与 GPU 训练,推动了大规模图像识别。[2]
课堂描述的“双通道”更准确地对应双 GPU 分工及部分受限制的跨组连接。它与两个颜色输入通道、两个方向的循环状态是不同概念。
局部响应归一化 LRN 是论文中的另一项设计:按邻近通道的响应归一化,形成一定竞争作用。它与后来按批次统计量进行归一化的 Batch Normalization 不是同一种操作。[2]
2. VGG:用规整的小卷积核加深网络
VGG 系统研究了堆叠 $3\times3$ 卷积与增加深度,形成常见的 16 层、19 层配置。[4]
若输入、输出和中间通道都为 $C$,忽略偏置,一个 $7\times7$ 卷积需要 $49C^2$ 个权重;三个 $3\times3$ 卷积需要 $27C^2$ 个,且在步长 1 时同样获得 $7\times7$ 的理论感受野。中间加入激活还会增加非线性变换。
这种比较建立在通道数相同的条件上。多个小卷积提高表达组合能力,但它们与一个大核的具体映射并不完全等价。
3. GoogLeNet / Inception:多分支与通道降维
Inception 让不同大小的卷积和池化分支并行处理输入,然后沿通道维拼接结果。$1\times1$ 卷积可以先压缩通道,再执行较贵的空间卷积。2014 年的 GoogLeNet 是这一设计的具体网络。[5]
例如 192 输入通道到 32 输出通道的 $5\times5$ 层,不含偏置需要 $25\times192\times32=153{,}600$ 个权重。先用 $1\times1$ 把 192 通道降到 16,再接 $5\times5$,需要 $192\times16+25\times16\times32=15{,}872$ 个权重。这个教学算例说明通道瓶颈怎样改变成本。
分支拼接要求空间尺寸相容;拼接后的通道数是各分支通道数之和。它与 ResNet 的逐元素相加有不同的形状规则。
4. ResNet:让新增层学习相对输入的变化
2015 年的 ResNet 针对深层网络的优化退化:普通网络加深后,连训练误差也可能升高。论文将所需映射 $H(x)$ 改写为残差 $F(x)=H(x)-x$,通过捷径得到:
\[y=F(x)+x.\]若新增部分接近恒等映射,残差分支接近零即可。输入与输出形状不同的块可以采用投影捷径,例如 $1\times1$ 卷积调整通道与尺寸。[6]
对形状一致、加法之前的映射,梯度关系为:
\[\frac{\partial L}{\partial x} =\left(I+J_F(x)\right)^\mathsf{T} \frac{\partial L}{\partial y},\]其中 $J_F$ 是残差分支的雅可比矩阵,$I$ 是恒等路径。它为信息与梯度提供直接路径,改变了深层网络的优化条件。原始 ResNet 块还会在加法后使用激活,完整梯度需要计入该激活。
因此,残差连接的核心是学习目标与连接方式的改变。课堂“抵消误差”的说法可以作为直觉,数学上并不是把每层误差机械减掉;它也没有保证任意深度都能无条件训练成功。[6]
5. 读模型成绩,要先认清指标
Top-1 错误率统计最高分预测是否正确;Top-5 错误率统计真值是否进入前五个候选。分类模型的集成、单模型、验证集和测试集结果还应分别标注。
| 论文报告 | 数据与设置 | Top-5 错误率 |
|---|---|---|
| AlexNet 2012 竞赛结果 | ILSVRC-2012 测试集,7 网络集成,部分预训练 | 15.3% |
| 同年第二名 | 同一竞赛测试集,其他方法组合 | 26.2% |
| ResNet 2015 竞赛结果 | ImageNet 测试集,残差网络集成 | 3.57% |
这些数值分别来自原始论文。[2][6] 3.57% 的结论限定在相应图像分类基准与协议内;“低于某个人类参照错误率”也要保留这个范围,不能直接写成全面视觉理解超过人类。
十、Transformer、ViT 与 MLP-Mixer 怎样接上这条主线
1. Transformer:用注意力组织序列依赖
Transformer 原论文发表于 2017 年,主要任务是机器翻译,使用 Encoder–Decoder 结构。课堂中的“2018 年”按原论文时间校正。[9]
其缩放点积注意力写作:
\[\operatorname{Attention}(Q,K,V) =\operatorname{softmax} \left(\frac{QK^\mathsf{T}}{\sqrt{d_k}}\right)V.\]它按照内容生成位置之间的加权关系,允许远处位置直接交换信息。完整注意力对长度为 $N$ 的序列产生 $N\times N$ 的注意力关系,因此序列长度也是计算与内存的重要变量。[9]
2. ViT:把图像变成 patch 序列
ViT 在 2020 年公开预印本、2021 年发表于 ICLR。它将图像切成固定大小 patch,将每块展平后投影成 token,加入位置信息,送入 Transformer Encoder。[10]
例如 $224\times224$ 图像使用 $16\times16$ patch 时,patch 数为:
\[N=\frac{224}{16}\times\frac{224}{16}=196.\]RGB patch 的展平长度为 $16\times16\times3=768$。标准 ViT 再加入一个分类 token 时,序列长度为 197。
它保持“每块局部投影”的输入步骤,同时让注意力在 token 之间建立关系。原论文强调了大规模预训练的作用,以及它相较 CNN 更少的视觉归纳偏置;位置编码、patch 划分等仍在规定模型怎样接收图像。[10]
3. MLP-Mixer:交换信息还可以用 MLP
课堂最后提到视觉 MLP 路线。2021 年的 MLP-Mixer 也把图像组织为 patch 表示,通过 token-mixing MLP 在空间位置之间混合信息,通过 channel-mixing MLP 在通道之间混合信息。[11]
| 模型路线 | 空间信息怎样交换 | 主要结构约束 |
|---|---|---|
| CNN | 局部窗口逐层组合 | 局部连接、共享权重 |
| ViT | patch token 之间的内容相关注意力 | patch 投影、位置信息及注意力规则 |
| MLP-Mixer | token 维与通道维的 MLP 交替混合 | 按两类维度分别处理 |
这三条路线说明:数据可以用不同方式组织,信息交换机制可以变化。课堂所说的架构统一,适合理解为 Transformer 为多类数据提供共同的处理框架;具体模型仍需依据数据规模、任务与设备预算选择。
十一、从网络结构回到智能计算系统
课堂不断把模型与硬件放在一起讨论。GPU 加速并非始于 2018 年,AlexNet 在 2012 年已经采用 GPU 训练;后续算力、数据与软件栈的发展,又扩大了可训练模型的规模。[2][9]
评估一个结构时,至少同时看三个量:
| 量 | 决定什么 | 本节例子 |
|---|---|---|
| 参数量 | 权重存储与参数更新规模 | 共享卷积核控制第一层权重数量 |
| 运算量 | 每次输入需要执行多少算术 | 高分辨率卷积仍要处理大量位置 |
| 激活与数据移动 | 中间表示占用、读写与带宽压力 | 64 通道的高分辨率输出可能很大 |
局部连接、通道瓶颈、下采样与算子分解,都能改变这三个量之间的关系。增加深度、宽度或全局交互,则为表达能力引入不同的成本。
课堂用经典模型说明结构创新与反复实验的关系:一个简洁的连接改变,可以产生显著效果;它的价值需要由明确任务、可比较设置和实验结果支持。理解每个模型解决的具体问题,比记住层数、模型名或“更深就更好”更有用。
参考资料
课堂主线依据《深度学习卷积网络与模型演进》转写,自动摘要用于交叉核对。参数量、输出尺寸、感受野递推、示例图和残差梯度为补充推演;模型年份、结果范围及标准定义参照以下原始论文与官方文档。
- PyTorch,Conv2d 官方文档:多通道互相关、groups、权重形状与输出尺寸。
- Krizhevsky、Sutskever、Hinton,ImageNet Classification with Deep Convolutional Neural Networks,2012:结构、GPU、LRN、Dropout 与竞赛结果。
- PyTorch,MaxPool2d 官方文档:窗口、步长与尺寸规则。
- Simonyan、Zisserman,Very Deep Convolutional Networks for Large-Scale Image Recognition,2014 / ICLR 2015。
- Szegedy 等,Going Deeper with Convolutions,2014 / CVPR 2015。
- He、Zhang、Ren、Sun,Deep Residual Learning for Image Recognition,2015 / CVPR 2016。
- Howard 等,MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications,2017。
- Glorot、Bengio,Understanding the difficulty of training deep feedforward neural networks,2010;He 等,Delving Deep into Rectifiers,2015。
- Vaswani 等,Attention Is All You Need,2017。
- Dosovitskiy 等,An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,2020 / ICLR 2021。
- Tolstikhin 等,MLP-Mixer: An all-MLP Architecture for Vision,2021。