· 算法设计与分析 / 分治法 / 主定理 / 最大子数组 / Karatsuba
算法设计与分析 Day3:分治思想、主定理与经典算法
RedMoon · 2026-10-08 · 课堂阅读笔记
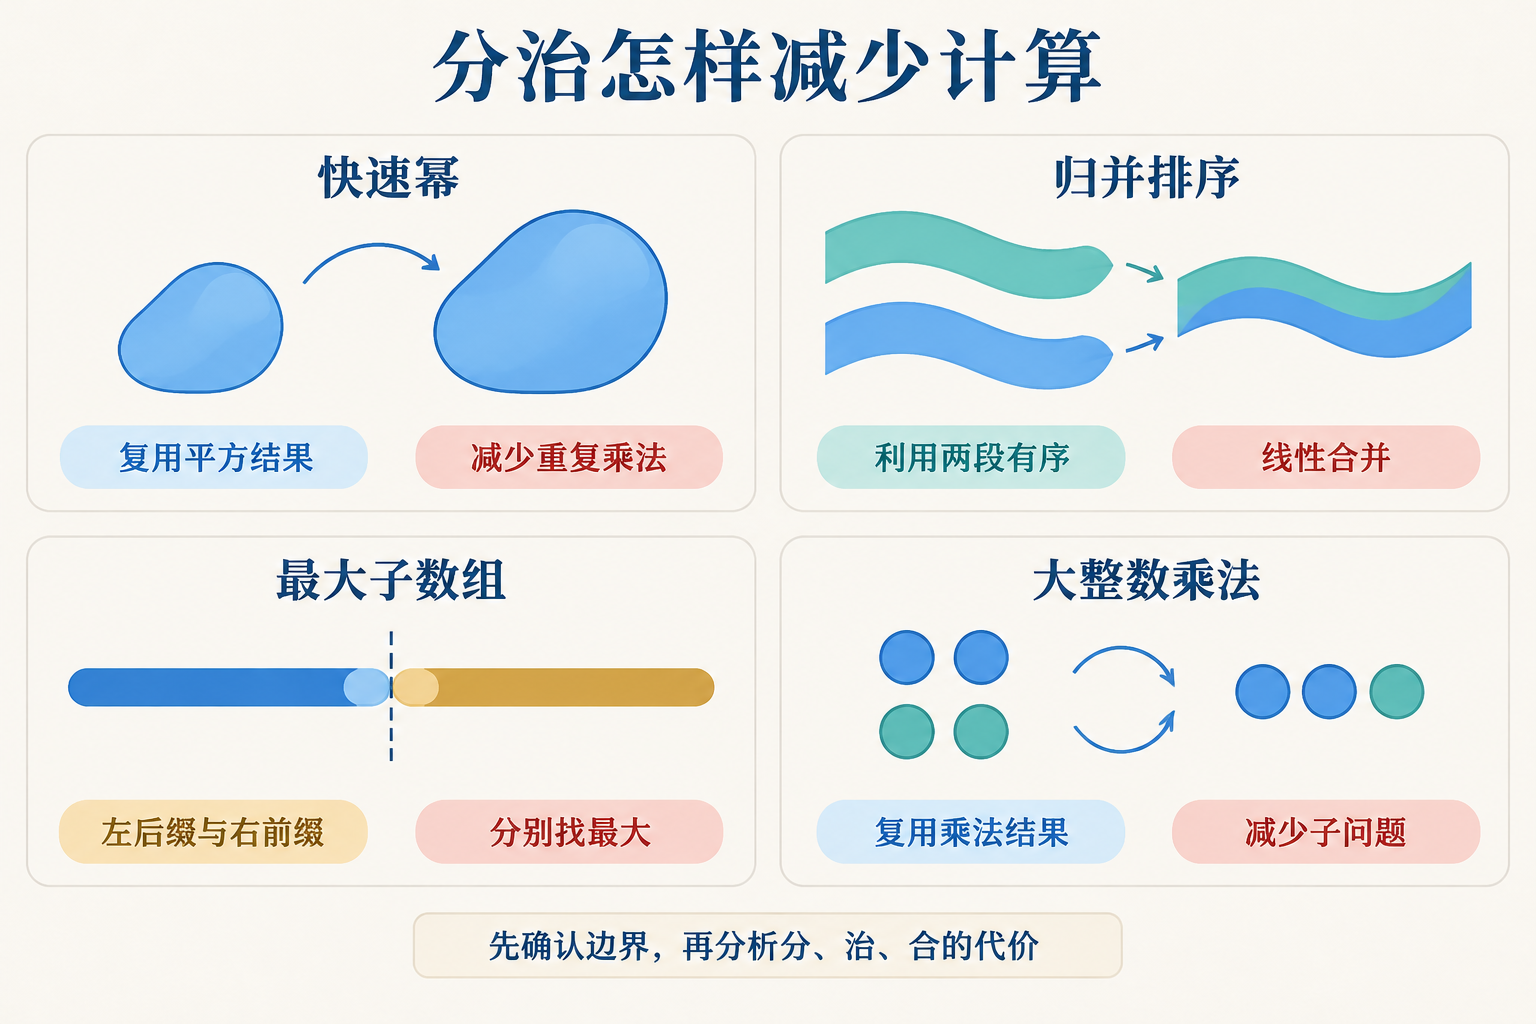
把一个问题切成两半,还不足以让算法变快。切开以后要解多少个子问题、能复用什么结果、最后怎样把答案合起来,才决定这次分治有没有节省计算。
本节课从快速幂开始,借归并排序推导递归代价,再用最大子数组和大整数乘法说明两种不同的优化:一次利用左右选择的独立性,一次利用代数关系减少递归乘法。主定理把这些算法放进同一个分析框架。文末整理课件中的七个递推式和两数之和作业。
一、先区分问题、算法与分析
“排序”是问题,“归并排序”是解决它的一种算法,“最坏时间为 $\Theta(n\lg n)$”是对算法的分析。先写清输入和输出,再设计过程,最后证明正确性并计算代价,这三步各有任务。
本文约定 $\lg n=\log_2 n$;数组伪代码使用 1-based 下标,区间 $A[l..r]$ 包含两端。分析等规模递归时,先假设 $n$ 是所需底数的整数幂;在子问题严格缩小、最终到达常数规模边界的前提下,普通取整不改变本文各例的渐近阶。
本次课件先回顾了选择排序:每轮扫描尚未确定的前缀,找到最大元素,放到前缀的最右端。循环开始时,后缀已经有序且包含原数组中最大的若干元素。每轮比较次数依次为 $n-1,n-2,\ldots,1$,总共:
\[\sum_{i=1}^{n-1}i=\frac{n(n-1)}2=\Theta(n^2).\]已有顺序不会消除这些扫描,因此最好、最坏情况均为 $\Theta(n^2)$。这个回顾也说明:要改进算法,就要找出原过程里能够省掉的工作。
二、快速幂:算一次,再复用
1. 从连续相乘到平方
计算 $x^N$,其中 $N$ 是非负整数。连续乘 $N$ 次需要线性数量的乘法。若先算出 $x^4$,求 $x^8$ 时只需把已有结果平方,无须重新乘出另外四个 $x$。
令 $h=x^{\lfloor N/2\rfloor}$,则:
\[x^N= \begin{cases} 1,&N=0,\\ h^2,&N>0\text{ 且 }N\text{ 为偶数},\\ xh^2,&N\text{ 为奇数}. \end{cases}\]递归实现应把 $h$ 存下来,再使用两次。若写成两个相同的递归调用,就重新引入了重复计算:正确复用对应 $T(N)=T(\lfloor N/2\rfloor)+\Theta(1)$,两个调用则对应 $T(N)=2T(N/2)+\Theta(1)$。
在一次乘法按常数代价计的模型下,前者需要 $\Theta(\log N)$ 次乘法,后者在 $N$ 为 2 的幂时需要 $\Theta(N)$ 次。这里的规模是指数 $N$;若计算任意精度的大整数,还要另计乘数位数增长带来的代价。
2. 二进制写法
指数可以展开为:
\[N=\sum_{k=0}^{m-1}b_k2^k,\qquad b_k\in\{0,1\}.\]因此:
\[x^N=\prod_{k:b_k=1}x^{2^k}.\]例如 $13=(1101)_2=8+4+1$,所以 $x^{13}=x^8x^4x$。连续平方得到 $x,x^2,x^4,x^8$,只把对应二进制位为 1 的项乘进答案。
FAST-POWER(x, N)                  // N 为非负整数
    result = 1
    base = x
    while N > 0
        if N mod 2 == 1
            result = result * base
        base = base * base
        N = floor(N / 2)
    return result
循环不变量是 $\text{result}\cdot\text{base}^{N}=x^{N_0}$,其中 $N_0$ 是原始指数。若当前 $N$ 为奇数,先拿出一个 base;随后平方 base 并把剩余指数减半,等式继续成立。终止时 $N=0$,result 就是所求结果。迭代版使用 $O(1)$ 个辅助变量;递归版有 $O(\log N)$ 的调用栈。
课件的 Pow(x, n) 题还包含负指数。对整数 $n<0$ 且 $x\neq0$,先把底数改为 $1/x$,再计算指数 $-n$。在固定宽度整数语言里,需要先将指数提升到更宽类型,再取负,避免最小负整数溢出。
三、分治框架:边界、分、治、合
一个分治算法需要明确四件事:
| 环节 | 要写清楚的内容 | 归并排序中的做法 |
|---|---|---|
| 边界 | 哪些规模可以直接返回 | 空数组或单元素数组已经有序 |
| 分 | 子问题是什么,规模是否严格减小 | 从中间分为两段 |
| 治 | 子调用保证返回什么 | 两段各自的有序结果 |
| 合 | 怎样由子结果得到完整答案 | 用双指针合并 |
子调用的输出约定很重要。若只知道“左边算完了”,却没说明算出了什么,合并阶段就无法据此设计。
1. 归并排序为什么可以线性合并
两段数组分别有序时,剩余元素中的最小值一定在两个当前头部中。每次比较这两个头部,取较小者,再移动对应指针,就能按顺序输出所有元素。每个元素只被输出一次,合并长度总计为 $n$ 的两段需要 $\Theta(n)$ 时间。
只用下标界定左右区间,划分可以是 $\Theta(1)$;若语言的切片会复制数组,划分会花 $\Theta(n)$。两种实现的本层非递归总代价仍为 $\Theta(n)$,所以都有:
\[T(n)=2T(n/2)+\Theta(n),\qquad T(1)=\Theta(1).\]课件将合并代价简写为 $2n$,对应的展开是:
\[\begin{aligned} T(n)&=2T(n/2)+2n\\ &=4T(n/4)+4n\\ &=2^kT(n/2^k)+2nk. \end{aligned}\]当 $k=\lg n$ 时,有 $n$ 个常数规模子问题,加上 $\lg n$ 层、每层 $2n$ 的工作,总时间为 $\Theta(n\lg n)$。
2. 分和合的代价要一起计算
归并排序把工作主要放在合并阶段。快速排序则把工作主要放在划分阶段:围绕枢轴分组,再递归排序;常见的原地实现不需要另做线性归并。
递推式中的 $f(n)$ 包括当前调用的边界判断、划分、合并及其他非递归工作。能否改进,应比较完整递推式与原算法,而不能直接套用“分和合都必须低于线性”的规则。
例如,在 $T(n)=2T(n/2)+\Theta(n^p)$ 中,如果 $1<p<2$,结果是 $\Theta(n^p)$,仍然优于平方级;如果本层代价已经是 $\Theta(n^2)$,总时间也会是 $\Theta(n^2)$,就无法用这套分治超过平方级基线。
四、递归树:每一层到底花多少
考虑一般形式:
\[T(n)=aT(n/b)+f(n),\qquad a\geq1,\ b>1.\]这里 $a$ 表示实际求解的子问题数量,$b$ 表示每个子问题的规模缩小倍数。第 $i$ 层有 $a^i$ 个子问题,每个规模为 $n/b^i$,该层的非递归总代价为:
\[C_i=a^if(n/b^i).\]若 $n=b^h$,直到规模 1 的深度是 $h=\log_b n$,叶子数量为:
\[a^h=n^{\log_b a}.\]把叶子代价与内部各层代价相加:
\[T(n)=\Theta\!\left(n^{\log_b a}\right) +\sum_{i=0}^{h-1}a^if(n/b^i).\]当 $f(n)=cn^p$ 时,上式中的第 $i$ 层为:
\[C_i=cn^p\left(\frac{a}{b^p}\right)^i.\]于是出现三种形态:$a/b^p>1$ 时向叶子方向递增;$a/b^p=1$ 时各层同阶;$a/b^p<1$ 时向下递减。这正是主定理三种情况的直觉来源。
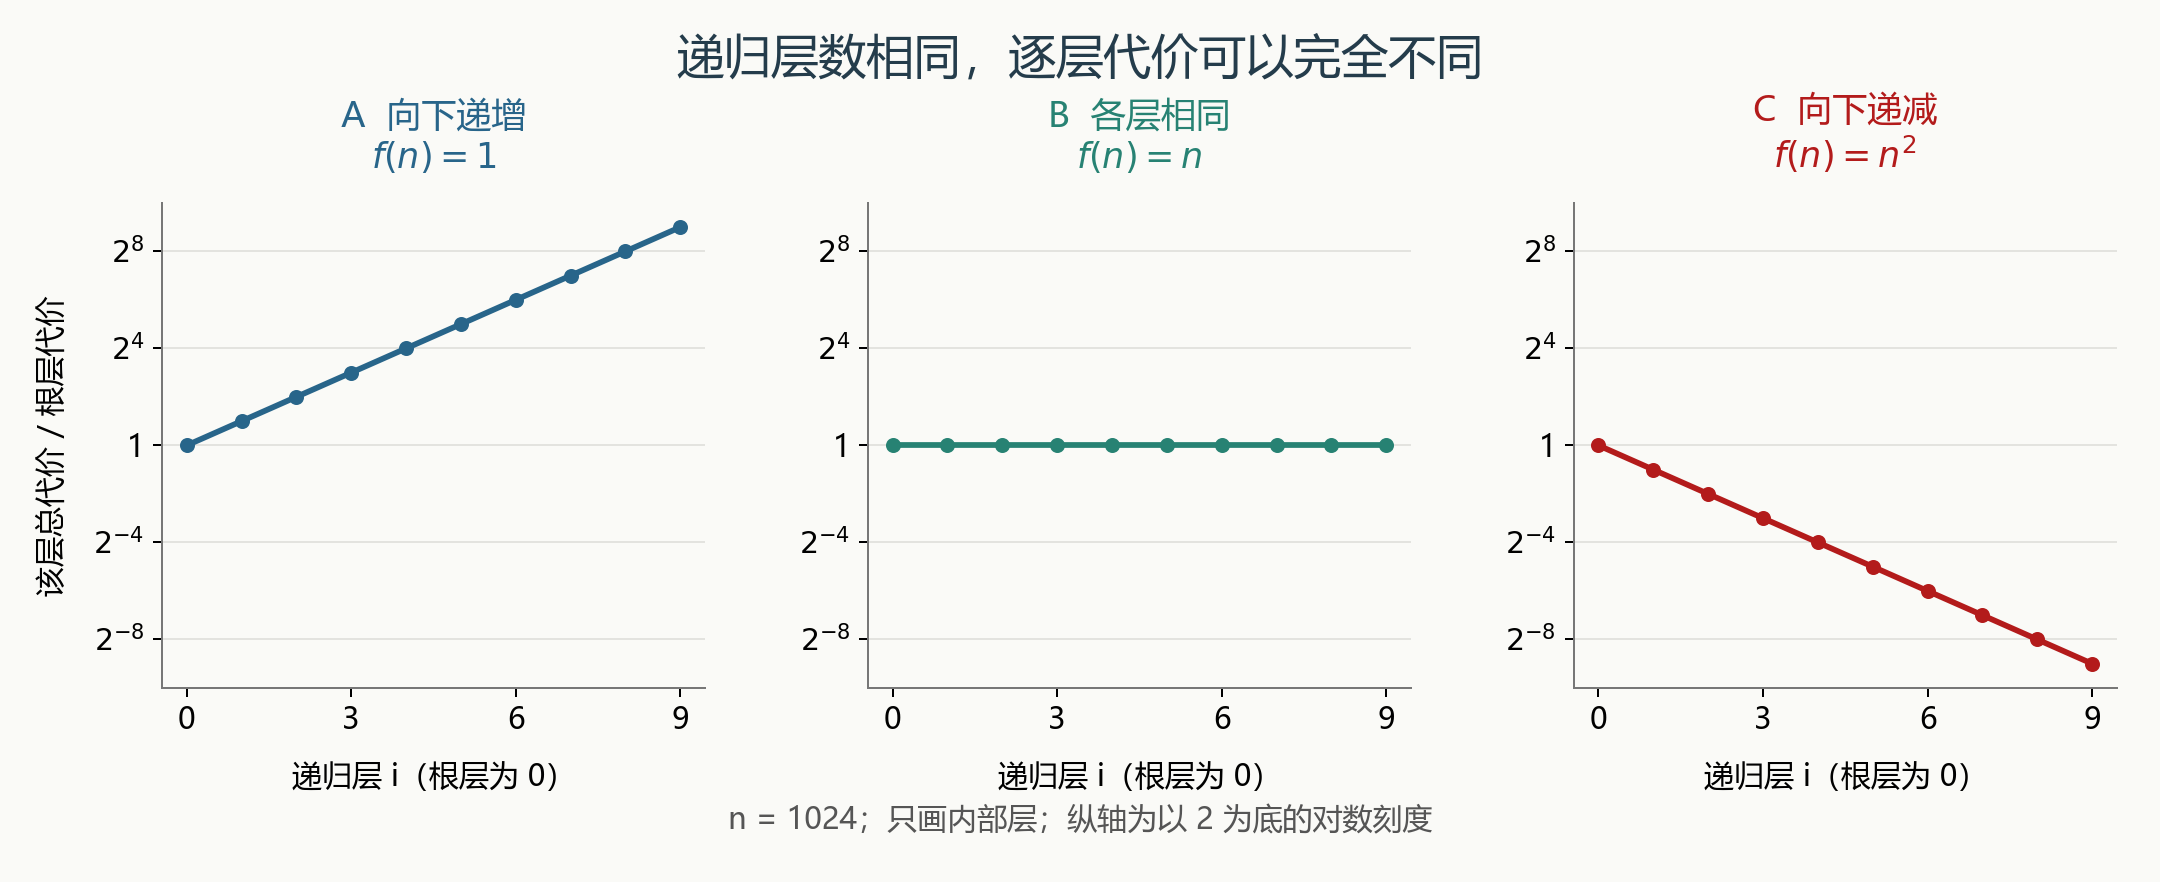
图中固定 $a=b=2$、$n=1024$,画出 10 个内部层相对于根层的代价;叶子代价在总复杂度里另行计入。三条曲线分别取 $f(n)=1,n,n^2$,不是运行时间实测。
递归深度为 $\Theta(\log n)$,并不自动意味着总时间是 $\Theta(n\log n)$。要乘上层数,先确认每层工作量确实同阶。
五、主定理:比较 $f(n)$ 与 $n^{\log_b a}$
对递推式 $T(n)=aT(n/b)+f(n)$,假设 $a\geq1$、$b>1$ 为常数,$f(n)$ 最终非负,常数规模的代价为正常数。令:
\[d=\log_b a.\]1. 情况一:叶子一侧主导
若存在固定常数 $\varepsilon>0$,使得:
\[f(n)=O(n^{d-\varepsilon}),\]则:
\[T(n)=\Theta(n^d).\]这里要求相差一个多项式因子。例如 $f(n)=n/\lg n$ 虽然比 $n$ 小,却不能写成 $O(n^{1-\varepsilon})$。不能把“更小”直接替代这个条件。
2. 情况二:各层工作同阶
若:
\[f(n)=\Theta(n^d),\]则:
\[T(n)=\Theta(n^d\log n).\]归并排序中 $a=b=2$,所以 $d=1$;每层都是线性工作,累计得到 $\Theta(n\log n)$。
3. 情况三:根层一侧主导
若存在固定常数 $\varepsilon>0$,使得:
\[f(n)=\Omega(n^{d+\varepsilon}),\]并且对所有充分大的 $n$,存在固定常数 $0<c<1$ 满足正则条件:
\[af(n/b)\leq cf(n),\]则:
\[T(n)=\Theta(f(n)).\]正则条件保证下一层的非递归总代价至多是本层的一个固定比例,于是内部层之和可以由递减等比级数控制。对 $f(n)=n^p$,检查它就得到 $a/b^p<1$。
课件中部分简化页只列出增长级别,完整表述在后面的主定理页补上了正则条件;使用第三种情况时,应保留这个条件。
4. 先确认形式,再套定理
| 递推式 | 参数与条件 | 结果 |
|---|---|---|
| $T(n)=T(n/2)+\Theta(1)$ | $a=1,b=2,d=0$,情况二 | $\Theta(\log n)$ |
| $T(n)=2T(n/2)+\Theta(n)$ | $d=1$,情况二 | $\Theta(n\log n)$ |
| $T(n)=3T(n/2)+\Theta(n)$ | $d=\log_2 3>1$,情况一 | $\Theta(n^{\log_2 3})$ |
| $T(n)=2T(n/2)+n^2$ | $d=1$,情况三;比例 $1/2$ | $\Theta(n^2)$ |
| $T(n)=T(n-2)+n^2$ | 每次减去常数,需展开求和 | $\Theta(n^3)$ |
基础三情况也没有覆盖所有按比例缩小的递推式。例如 $T(n)=2T(n/2)+n\lg n$,其 $f(n)$ 比 $n$ 多一个对数因子,达不到情况三要求的多项式差距。用递归树直接计算即可:第 $i$ 层为 $n(\lg n-i)$,总和为 $\Theta(n\lg^2n)$。
六、最大子数组:把跨中点的选择拆开
1. 问题与朴素算法
给定含正数、负数的非空数组,求一个和最大的非空连续子数组:
\[\max_{1\leq i\leq j\leq n}\sum_{k=i}^{j}A[k].\]子数组要求连续,不能跳过中间的负数。非空条件也意味着:全负数组的答案是最大的那个元素,例如 [-5, -2, -7] 的最大和为 $-2$。
一共有 $n(n+1)/2$ 个候选区间。若每次枚举两端后重新求和,总工作为 $\Theta(n^3)$。固定左端 $i$,右端每移动一步就在已有和上加一个新元素,便能把总工作降到 $\Theta(n^2)$。预先计算前缀和也能让每个区间求和为 $O(1)$,但枚举全部区间仍是平方级。
2. 分治需要覆盖三种位置
在 $m=\lfloor(l+r)/2\rfloor$ 处分开 $A[l..r]$。任意非空子数组恰好属于以下一类:
- 完全位于左半段 $A[l..m]$。
- 完全位于右半段 $A[m+1..r]$。
- 同时经过两半段,包含 $A[m]$ 与 $A[m+1]$。
前两类由递归调用得到。第三类如果继续枚举左右端点,仍有平方数量的组合,合并就太贵了。
3. 左后缀最大值+右前缀最大值
跨中点区间必然是“左半段的一个非空后缀+右半段的一个非空前缀”。定义:
\[L^*=\max_{l\leq i\leq m}\sum_{k=i}^{m}A[k],\qquad R^*=\max_{m+1\leq j\leq r}\sum_{k=m+1}^{j}A[k].\]左端选择与右端选择之间没有额外约束,区间和又是相加,所以:
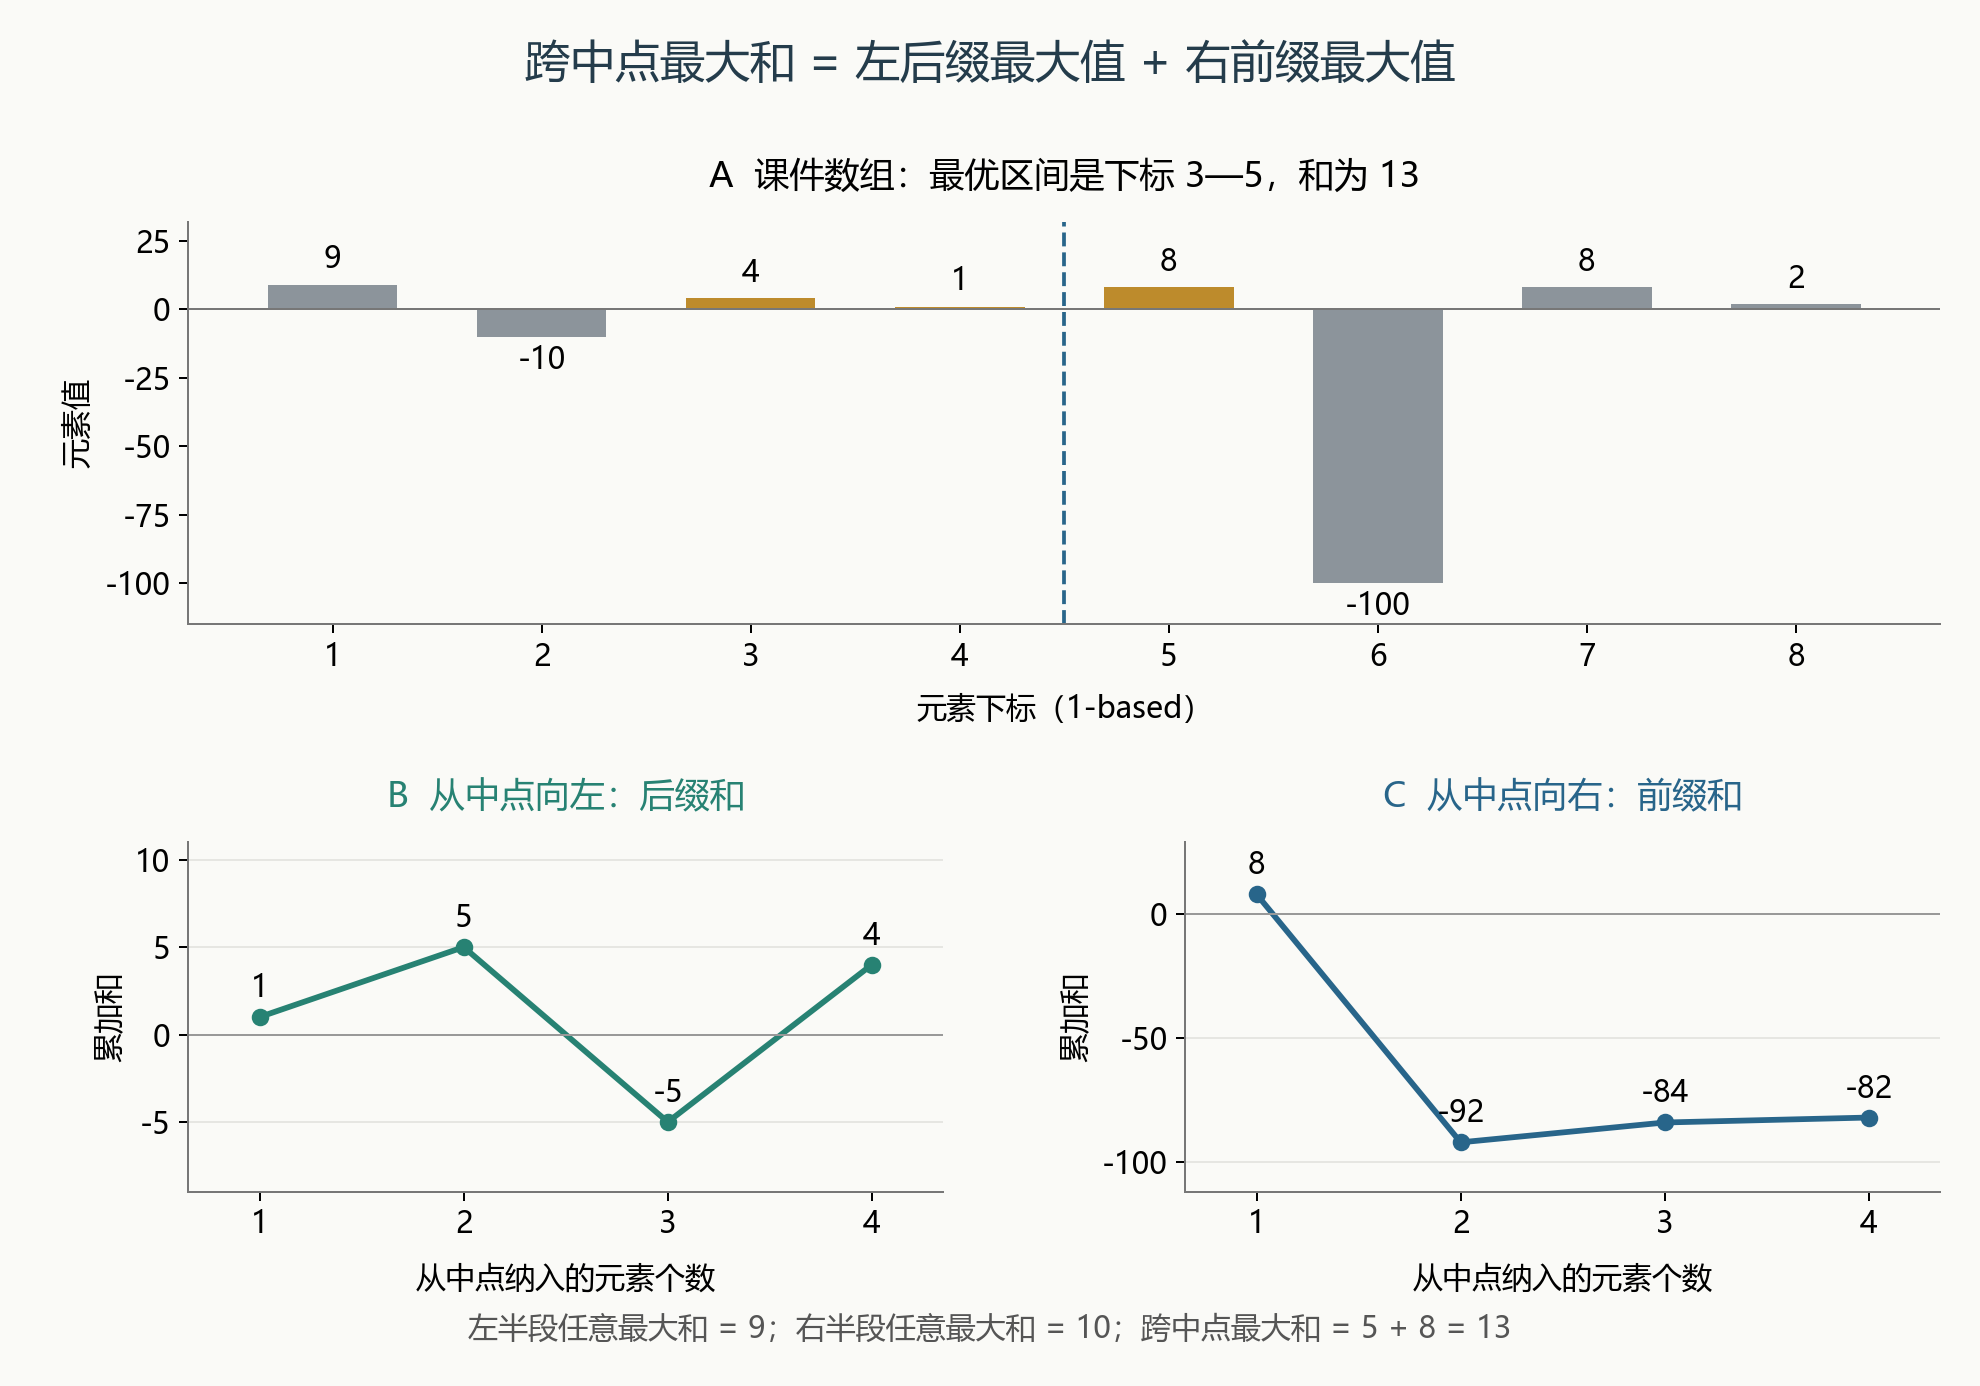
\[\max_{i\leq m<j} \left(\sum_{k=i}^{m}A[k]+\sum_{k=m+1}^{j}A[k]\right) =L^*+R^*.\]从中点分别向左、向右扫描一次,就能找出这两个值,代价为 $\Theta(r-l+1)$。左边这里要找的是固定右端的最大后缀;右边要找的是固定左端的最大前缀,两者都不等同于各自半段的任意最大子数组。
课件的例子是:
[9, -10, 4, 1 | 8, -100, 8, 2]
左半段的最大子数组是 [9],和为 9;右半段的是 [8, 2],和为 10,它们并不相邻。跨中点时,左侧候选后缀和依次为 $1,5,-5,4$,最大值是 [4, 1] 的 5;右侧候选前缀和依次为 $8,-92,-84,-82$,最大值是 [8] 的 8。因此跨中点区间 [4, 1, 8] 的和为 13,超过左右两类的答案。
4. 完整伪代码
子调用返回 (最大和, 左端点, 右端点)。输入要求 $1\leq l\leq r\leq n$。
MAX-SUBARRAY(A, l, r)
    if l == r
        return (A[l], l, r)

    m = floor((l + r) / 2)
    left = MAX-SUBARRAY(A, l, m)
    right = MAX-SUBARRAY(A, m + 1, r)

    running = 0
    leftBest = -infinity
    for i = m downto l
        running = running + A[i]
        if running > leftBest
            leftBest = running
            bestL = i

    running = 0
    rightBest = -infinity
    for j = m + 1 to r
        running = running + A[j]
        if running > rightBest
            rightBest = running
            bestR = j

    cross = (leftBest + rightBest, bestL, bestR)
    return one of left, right, cross with the largest sum
running 从 0 开始是为了累加;leftBest 和 rightBest 从负无穷开始,是为了保证取到至少一个元素。不能把最大值也初始化为 0,否则全负输入会错误地允许空区间。多个区间同为最大值时,返回其中任意一个都符合本题要求。
正确性可按区间长度归纳:单元素边界直接正确;假设左右递归结果正确,三类划分覆盖全部候选,两个扫描又求出了第三类中的最大值,最后取三者最大就得到整个区间的答案。每次子区间严格缩短,递归会终止。
两个半规模递归加上线性扫描,得到:
\[T(n)=2T(n/2)+\Theta(n)=\Theta(n\log n).\]按下标传递区间而不复制数组时,除输入和返回结果外,递归栈额外空间为 $O(\log n)$。
5. 补充:返回更多信息,可以降低合并成本
课堂版本在每次合并时重新扫描。若每个区间改为返回四个值:总和 $S$、最大非空前缀和 $P$、最大非空后缀和 $Q$、最大非空子数组和 $M$,左右结果可按以下关系合并:
\[\begin{aligned} S&=S_L+S_R,\\ P&=\max(P_L,S_L+P_R),\\ Q&=\max(Q_R,S_R+Q_L),\\ M&=\max(M_L,M_R,Q_L+P_R). \end{aligned}\]单元素时四个值都等于该元素。每次合并只做常数次运算,递推式变为 $2T(n/2)+\Theta(1)$,总时间降到 $\Theta(n)$。这段是对课堂方法的补充;它说明子问题的返回信息会直接影响合并成本。Kadane 算法也能在线性时间内解决本问题,课堂的 $\Theta(n\log n)$ 版本主要用来说明分治。
七、二分查找:划成两边,只递归一边
有序数组中,比较目标与中间元素以后,只需继续检查仍可能包含目标的那一半。因此实际求解的子问题数量是 1:
\[T(n)=T(n/2)+\Theta(1)=\Theta(\log n)\]这里给的是最坏情况;若第一次就命中中点,可以常数时间结束。迭代实现的额外空间为 $O(1)$,递归实现的调用栈为 $O(\log n)$。
这也解释了 $a$ 的含义:它计数的是实际递归求解的子问题,数组看起来有两半,并不意味着 $a=2$。有序性让算法能够排除整段候选;对需要完整检查所有输入的排序问题,线性读取下界仍然存在。
八、Karatsuba 乘法:四次子乘法变三次
1. 规模是位数
给定两个 $n$ 位大整数,朴素竖式乘法需要平方数量的单位位乘法,时间为 $\Theta(n^2)$。这里 $n$ 表示数字的位数,十进制或二进制等固定进制不改变下述渐近指数。
以偶数位数、十进制为例,令 $q=10^{n/2}$,把两数写成:
\[A=Xq+Y,\qquad B=Pq+Q.\]展开得到:
\[AB=XPq^2+(XQ+YP)q+YQ.\]直接分别计算 $XP,XQ,YP,YQ$,有四个半规模乘法:
\[T(n)=4T(n/2)+\Theta(n)=\Theta(n^2).\]仅做高低位划分,复杂度还没有降低。
2. 用已有结果求交叉项
利用:
\[(X+Y)(P+Q)=XP+XQ+YP+YQ,\]只计算三个乘积:
\[z_2=XP,\qquad z_0=YQ,\qquad z_1=(X+Y)(P+Q).\]于是:
\[AB=z_2q^2+(z_1-z_2-z_0)q+z_0.\]相加、相减、进位和移位在当前层需要线性位操作。高低位相加可能多出一位;严格的位数递推需处理这一常数规模偏差,仍得到标准 Karatsuba 的渐近界:
\[T(n)=3T(n/2)+\Theta(n) =\Theta\!\left(n^{\log_2 3}\right) \approx\Theta(n^{1.585}).\]这里将递归乘法数量从 4 降到 3,代价是增加一些线性加减法。算法通常也在位数较小时直接使用普通乘法。
3. 一个完整算例
取 $A=1234$、$B=5678$,则 $q=100$,$X=12,Y=34,P=56,Q=78$:
\[\begin{aligned} z_2&=12\times56=672,\\ z_0&=34\times78=2652,\\ z_1&=(12+34)(56+78)=46\times134=6164,\\ z_1-z_2-z_0&=2840. \end{aligned}\]合并得到:
\[1234\times5678 =672\times10000+2840\times100+2652 =7006652.\]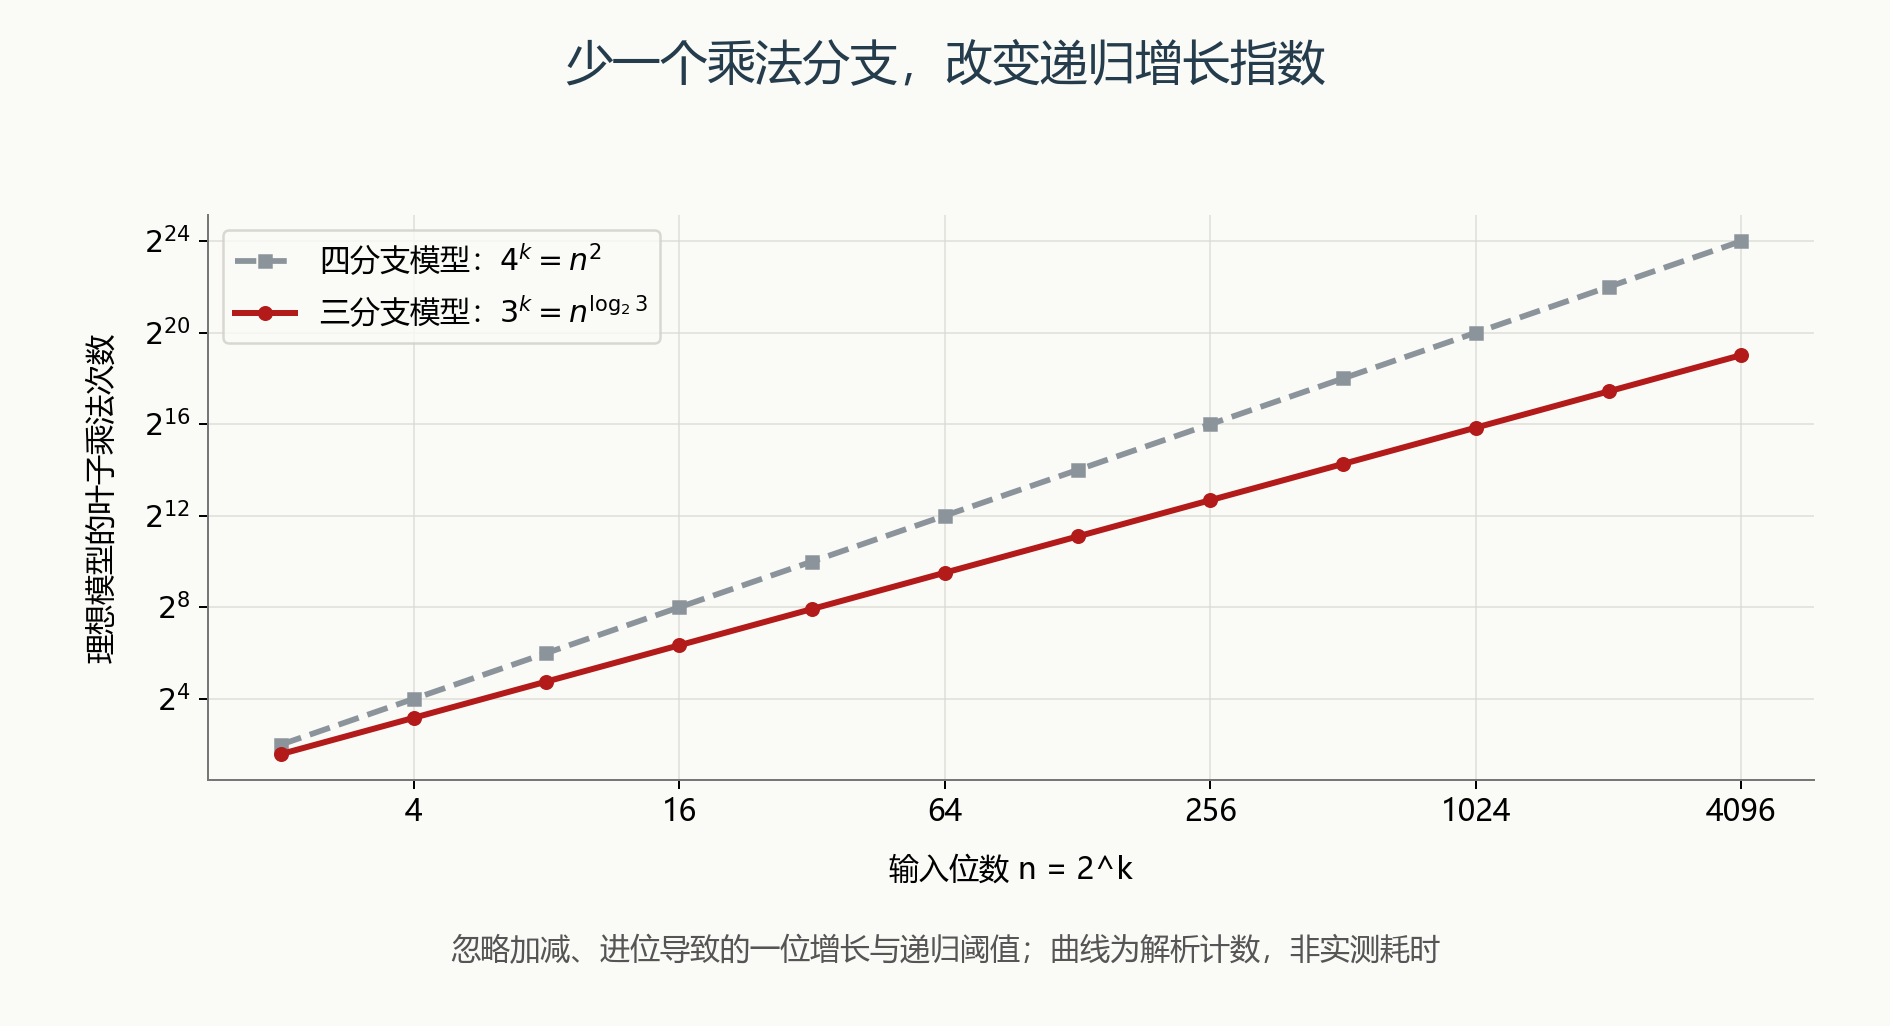
图中忽略加减法、进位导致的一位增长和小规模阈值,只比较 $n=2^k$ 时的理想叶子数量 $4^k$ 与 $3^k$,用于展示指数变化。实际运行时间还受实现、常数与阈值影响。
九、课后作业 4-1:七个递推式
题目要求给出尽可能紧的渐近上界和下界,并解释理由。按题设,$n\leq2$ 时 $T(n)=\Theta(1)$,所以用 $\Theta$ 同时表达同阶的上界和下界。
| 小题 | 递推式 | 紧确渐近界 | 方法 |
|---|---|---|---|
| a | $2T(n/2)+n^4$ | $\Theta(n^4)$ | 情况三 |
| b | $T(7n/10)+n$ | $\Theta(n)$ | 递减等比求和 |
| c | $16T(n/4)+n^2$ | $\Theta(n^2\log n)$ | 情况二 |
| d | $7T(n/3)+n^2$ | $\Theta(n^2)$ | 情况三 |
| e | $7T(n/2)+n^2$ | $\Theta(n^{\log_2 7})$ | 情况一 |
| f | $2T(n/4)+\sqrt n$ | $\Theta(\sqrt n\log n)$ | 情况二 |
| g | $T(n-2)+n^2$ | $\Theta(n^3)$ | 平方和,上下界 |
a. $T(n)=2T(n/2)+n^4$
$a=2,b=2$,基准为 $n$。$n^4$ 比基准多一个多项式因子,且:
\[2f(n/2)=2(n/2)^4=\frac18n^4.\]取 $c=1/8$ 即满足正则条件,情况三给出 $\Theta(n^4)$。递归树第 $i$ 层是 $n^4(1/8)^i$,内部层求和同阶于根层。
b. $T(n)=T(7n/10)+n$
每次保留 $7/10$ 的规模。整数规模的实现取 $\lfloor7n/10\rfloor$,配合 $n\leq2$ 的基例保证终止;若取上整,需把基例扩至 $n\leq3$。先忽略取整展开到常数规模,设深度为 $h=\Theta(\log n)$:
\[T(n)=\Theta(1)+n\sum_{i=0}^{h-1}(7/10)^i =\Theta(1)+\frac{10n}{3}\bigl(1-(7/10)^h\bigr).\]等比求和给出 $O(n)$,根层已有 $n$ 的代价给出 $\Omega(n)$,所以 $T(n)=\Theta(n)$。也可以把它写成 $a=1,b=10/7$ 的主定理形式;$b$ 可以是大于 1 的非整数。
c. $T(n)=16T(n/4)+n^2$
$\log_4 16=2$,与 $f(n)=n^2$ 同阶,情况二给出 $\Theta(n^2\log n)$。第 $i$ 层为 $16^i(n/4^i)^2=n^2$,共有对数数量的层。
d. $T(n)=7T(n/3)+n^2$
由于 $7<3^2$,有 $\log_3 7<2$。正则条件为:
\[7f(n/3)=\frac79n^2.\]取 $c=7/9<1$,情况三给出 $\Theta(n^2)$。第 $i$ 层代价 $n^2(7/9)^i$ 按比例递减。
e. $T(n)=7T(n/2)+n^2$
由于 $7>2^2$,有 $\log_2 7>2$。取 $\varepsilon=\log_2 7-2>0$,满足情况一,得到 $\Theta(n^{\log_2 7})$。第 $i$ 层为 $n^2(7/4)^i$,向叶子方向递增。
f. $T(n)=2T(n/4)+\sqrt n$
$\log_4 2=1/2$,所以基准 $n^{\log_4 2}=\sqrt n$,情况二给出 $\Theta(\sqrt n\log n)$。每层都有 $2^i\sqrt{n/4^i}=\sqrt n$ 的工作。
g. $T(n)=T(n-2)+n^2$
规模按减法变化,直接展开:
\[T(n)=n^2+(n-2)^2+(n-4)^2+\cdots+\Theta(1).\]上界:共有 $O(n)$ 项,每项不超过 $n^2$,因此 $T(n)=O(n^3)$。下界:前 $\lfloor n/4\rfloor$ 项都至少为 $(n/2)^2$,因此 $T(n)=\Omega(n^3)$。合起来得到 $\Theta(n^3)$。
若 $n=2m$,题设下可以进一步写为:
\[T(2m)=T(2)+4\sum_{j=2}^{m}j^2 =T(2)+\frac{2m(m+1)(2m+1)}3-4.\]最高次项是 $n^3/6$。奇数规模同样为立方级。
十、课后作业 2.3-7:两数之和
给定包含 $n$ 个整数的集合 $S$ 与整数 $x$,判断是否存在两个不同元素,其和恰好为 $x$。要求设计一个 $\Theta(n\lg n)$ 时间的算法。
1. 归并排序+双指针
先把元素排为非降序数组,再维护最左指针 $i$ 与最右指针 $j$。每次比较 $A[i]+A[j]$ 与 $x$:和太小就右移 $i$,和太大就左移 $j$。
TWO-SUM(S, x)
    A = MERGE-SORT(array containing all elements of S)
    i = 1
    j = length(A)
    while i < j
        s = A[i] + A[j]
        if s == x
            return TRUE
        if s < x
            i = i + 1
        else
            j = j - 1
    return FALSE
$i<j$ 保证取的是不同位置;输入不足两个元素时直接返回 FALSE。若将问题扩展为允许重复值的数组,两个不同位置上的相等数可以配对,而同一个位置不能使用两次。
例如排序后为 [-4, -1, 2, 5, 9],目标为 7:先看 $-4+9=5$,排除 $-4$;再看 $-1+9=8$,排除 9;随后 $-1+5=4$,排除 $-1$;最后 $2+5=7$,找到答案。
2. 为什么移动指针不会遗漏答案
循环不变量:每轮开始时,如果原输入中存在满足条件的一对元素,则当前区间 $A[i..j]$ 中仍有一对。
若 $A[i]+A[j]<x$,对所有 $i<k\leq j$ 都有:
\[A[i]+A[k]\leq A[i]+A[j]<x.\]因此当前左端元素不可能参与答案,可以排除。若 $A[i]+A[j]>x$,对所有 $i\leq k<j$ 都有:
\[A[k]+A[j]\geq A[i]+A[j]>x.\]因此当前右端元素不可能参与答案。每次排除都保留了可能的解;区间最终不足两个元素时,若仍未找到,就确实不存在答案。
3. 复杂度
标准归并排序为 $\Theta(n\lg n)$,双指针扫描至多移动 $O(n)$ 次,因此总时间为 $\Theta(n\lg n)$。排序的辅助空间为 $O(n)$,扫描本身额外空间为 $O(1)$。
哈希表能给出常见的期望线性解法,本题要求的确定性排序方案则直接利用了本节课的有序性与归并排序。
参考资料
- 本次课程课件《分治思想(Divide and Conquer)》:选择排序回顾、快速幂题目、递归代价推导、主定理、最大子数组、大整数乘法与课后作业。
- 本次课堂讲授记录:快速幂的二进制解释、分治的分与合、跨中点选择的独立性,以及复用三个乘法结果的代数推导。
- 本次课后作业解答与校验文档:4-1 七个递推式、2.3-7 两数之和的推导与正确性证明。
- Introduction to Algorithms:课件引用的主定理、递推式与两数之和练习。