· 强化学习 / PPO / Actor-Critic / GAE
Day5 · PPO:从概率比到训练闭环
这一天解决的问题
Day4 把整局回报、Critic 和 GAE 接到了策略更新上。Day5 继续追问:已经采到的一批经历,怎样用来训练多轮?训练期间策略不断变化,又怎样知道它离采样时的策略有多远?
PPO-Clip 保留 Actor、Critic 和优势估计,增加了新旧动作概率比与裁剪目标。完整流程是:用当前策略采样一批经历,固定这批数据的参照和目标,进行有限轮更新,然后用更新后的策略重新采样。
本篇沿用两状态路线,把公式、代码中的变量和实际训练结果放在一起说明。这里的“旧”始终指产生当前批次经历的策略。
1. 环境和网络:保留已经熟悉的部分
起点 $s_0$ 有两种动作。动作 0 先到中间状态 $s_1$,奖励为 0;从 $s_1$ 再走一步,得到奖励 2 并真正终止。动作 1 直接得到奖励 1 并终止。
| 起点选择 | 奖励序列 | $\gamma=0.9$ 时的起点折扣回报 |
|---|---|---|
| 动作 0,长路线 | $[0,2]$ | $1.8$ |
| 动作 1,短路线 | $[1]$ | $1.0$ |
如果起点选择长路线的概率为 $p$,当前策略的精确期望回报是:
\[J(\pi)=V^\pi(s_0)=1.8p+1.0(1-p)=1+0.8p.\]起点概率各为 $0.5$ 时,真实平均价值为 $1.4$。这是由环境和策略计算出的期望,和未训练 Critic 的输出是两个对象。
状态用 one-hot 表示:$s_0$ 是 [1,0],$s_1$ 是 [0,1]。本次使用两个独立线性分支,便于区分梯度:
import torch
from torch import nn
from torch.distributions import Categorical

class ActorCritic(nn.Module):
    def __init__(self):
        super().__init__()
        self.actor = nn.Linear(2, 2, bias=False)
        self.critic = nn.Linear(2, 1, bias=False)
        nn.init.zeros_(self.actor.weight)
        nn.init.zeros_(self.critic.weight)

    def forward(self, states):
        logits = self.actor(states)
        values = self.critic(states).squeeze(-1)
        return logits, values
输入 states 为 [B,2],Actor 输出 logits 为 [B,2],Critic 输出 values 为 [B]。B 是转移样本数。squeeze(-1) 只删除价值输出末尾的单值维度,即使只有一条样本,也保留批次维度。
零初始化使初始动作概率为 [0.5,0.5],初始 Critic 预测为 0。它后面才通过真实经历学习价值。
2. rollout:先用同一份策略收集经历
rollout 是智能体实际与环境交互得到的经历。当前练习每批采集 32 个完整回合;一个回合有一步或两步,所以一批包含 32 至 64 条转移。
采样批次内部不执行 optimizer.step()。这样,同一批保存的旧概率来自同一份网络参数。
一条经历需要保存的不只是奖励:
| 字段 | 含义与用途 |
|---|---|
states、actions |
当时的状态,以及真正执行的动作 |
rewards |
环境给出的即时奖励 |
old_log_probs |
采样策略对实际动作的对数概率 |
old_values、next_values |
采样时对当前状态和真实下一状态的价值预测 |
terminated |
是否真正终止,决定是否 bootstrap |
episode_ends |
是否结束本回合并重置,决定 GAE 是否跨边界递推 |
time_weights |
该样本在原回合中的时间权重 $\gamma^t$ |
下面摘取采样阶段保存快照的逻辑。state_tensor 是当前状态,action_tensor 是本次抽到的动作,fields 是按时间顺序追加的经历容器:
# 位于 @torch.no_grad() 修饰的采样函数中。
logits, value = model(state_tensor)
dist = Categorical(logits=logits)
action_tensor = dist.sample()
action = int(action_tensor.item())
next_state, reward, terminated, _ = env.step(action)

fields["states"].append(state_tensor.squeeze(0))
fields["actions"].append(action)
fields["rewards"].append(reward)
fields["old_log_probs"].append(dist.log_prob(action_tensor).item())
fields["old_values"].append(value.item())
这里可以使用 .item() 保存旧概率,因为 PPO 后面会重新前向计算有梯度的当前概率。Day4 的直接 REINFORCE 实现保留采样时的 log_prob 计算图;当前 PPO 实现保留的是数值快照,训练图在优化阶段建立。
真实下一状态的价值也在这时保存。真正终止的转移令 next_value=0;本环境没有外部截断。如果换成有时间上限的环境,截断处需要使用最后真实观测,而不是 reset() 后的新起点。
3. GAE 和价值目标:在更新前算好
用采样时的价值快照计算 TD 误差:
\[\delta_t=r_t+\gamma(1-d_t)V_{\mathrm{old}}(s_{t+1}) -V_{\mathrm{old}}(s_t),\]再从后往前计算 GAE:
\[\hat A_t=\delta_t+\gamma\lambda(1-e_t)\hat A_{t+1}.\]$d_t$ 表示真正终止,$e_t$ 表示本回合结束并准备重置。外部截断后重置时,$d_t=0$、$e_t=1$:保留最后状态的价值预测,但不把下一回合的误差接进来。
对应的反向递推代码如下。输入都是按经历先后排列的一维张量;两个结束标记使用布尔类型,~ 将真假取反:
@torch.no_grad()
def compute_gae(rewards, old_values, next_values,
                terminated, episode_ends, gamma=0.9, lam=0.95):
    bootstrap_mask = (~terminated).to(rewards.dtype)
    trace_mask = (~episode_ends).to(rewards.dtype)
    deltas = rewards + gamma * bootstrap_mask * next_values - old_values
    advantages = torch.zeros_like(rewards)
    gae = rewards.new_zeros(())
    for t in reversed(range(len(rewards))):
        gae = deltas[t] + gamma * lam * trace_mask[t] * gae
        advantages[t] = gae
    return advantages
bootstrap_mask 决定是否补下一状态价值,trace_mask 决定是否接上后一条经历的优势。gae 暂存已经算好的后缀优势,从末尾的 0 开始;这不会清零已进入 deltas 的下一状态价值。经过一个回合边界时,递推只保留该步自己的 TD 误差。
本次准备批次的关键代码是:
@torch.no_grad()
def prepare_batch(batch):
    raw = compute_gae(
        batch["rewards"], batch["old_values"], batch["next_values"],
        batch["terminated"], batch["episode_ends"],
    )
    batch["raw_advantages"] = raw
    batch["targets"] = (batch["old_values"] + raw).clone()

    weights = raw.clone()
    if normalize_advantage:
        weights = (
            weights - weights.mean()
        ) / (weights.std(unbiased=False) + 1e-8)
    batch["actor_weights"] = weights
    return batch
compute_gae 使用前述递推,输入均为按时间排列的一维张量。raw_advantages 是原始 GAE;targets 是回报尺度上的价值目标;actor_weights 是交给 Actor 的评分,本次关闭标准化,和原始 GAE 相同。
目标和权重在进入多轮优化前准备一次。同一批训练期间,当前价值预测可以变化,这些固定目标不跟着变化。
3.1 初始目标为什么是 1.71
长路线的真实奖励为 [0,2]。初始 Critic 两个状态都预测 0,$\gamma=0.9$、$\lambda=0.95$,所以:
初始价值为 0,因而这条样本的起点 Critic 目标也为 $1.71$。完整回报仍是 $1.8$。两者不同,是因为当前采用包含旧价值预测的 lambda 目标,而不是直接把完整回报作为目标。
3.2 固定目标怎样被拟合
另设一个便于手算的例子:采样时旧价值为 $1.4$,原始 GAE 为 $0.4$,则本批目标为 $1.8$。
假设更新中当前预测已经变为 $1.7$,正确平方误差是:
\[(1.7-1.8)^2=0.01.\]如果错误地用新预测再加旧 GAE,目标会变成 $2.1$,误差仍是 $0.16$。这样每轮都要求预测再提高 $0.4$,目标不断移动,无法表达“逐渐拟合本批回报估计”。
旧价值与旧 GAE 属于同一份采样参照。下一批重新采样后,才重新构造它们。
4. 概率比:比较同一个状态下的同一个动作
用 $\rho_t$ 表示概率比,避免与环境奖励 $r_t$ 混淆:
\[\rho_t(\theta) =\frac{\pi_\theta(a_t\mid s_t)} {\pi_{\mathrm{old}}(a_t\mid s_t)} =\exp\left( \log\pi_\theta(a_t\mid s_t) -\log\pi_{\mathrm{old}}(a_t\mid s_t) \right).\]分子是当前网络给原动作的概率,分母是采样时保存的概率。状态和实际动作都不变;更新时不重新采一个动作替换原动作。
logits, values = model(batch["states"])
dist = Categorical(logits=logits)
new_log_probs = dist.log_prob(batch["actions"])
log_ratio = new_log_probs - batch["old_log_probs"]
ratio = log_ratio.exp()
假设采样概率为 $0.5$,第一轮更新后为 $0.6$,第二轮后为 $0.7$。相对本批采样策略的比值是 $0.7/0.5=1.4$,分母仍为 $0.5$。若每轮刷新分母,就把累计变化隐藏了。
第一次优化前,新旧网络参数相同,所以 $\rho_t=1$。但分母是常量,分子由当前网络产生并保留梯度,数值为 1 不妨碍反向传播。以二动作初始概率各为 $0.5$、固定优势 $0.4$ 的例子看,Actor loss 对所选动作 logit 的梯度为 $-0.2$,可以推动该动作概率提高。
保存 old_log_probs 就足够计算比值,不必一直保留第二套旧网络。
5. PPO-Clip:限制继续奖励过大的有利变化
PPO-Clip 最大化的单样本目标为:
\[S_t(\theta)= \min\left( \rho_t A_t,\; \operatorname{clip}(\rho_t,1-\epsilon,1+\epsilon)A_t \right).\]这里 $A_t$ 是本批固定的 Actor 权重。若开启优势标准化,公式里的符号指标准化后的权重。环境奖励和 Actor 权重需要分别看。
取 $\epsilon=0.2$,比值参考区间为 $[0.8,1.2]$。四个分支可以直接算出来:
| 固定 $A_t$ | $\rho_t$ | 未裁剪项 $\rho_tA_t$ | 裁剪项 | 最终 $S_t$ |
|---|---|---|---|---|
| $+0.4$ | $1.4$ | $0.56$ | $0.48$ | $0.48$ |
| $+0.4$ | $0.6$ | $0.24$ | $0.32$ | $0.24$ |
| $-0.4$ | $0.6$ | $-0.24$ | $-0.32$ | $-0.32$ |
| $-0.4$ | $1.4$ | $-0.56$ | $-0.48$ | $-0.56$ |
正优势鼓励提高实际动作概率。比值超过上界后,这条样本进入平台,不再通过该策略项奖励继续提高。负优势鼓励降低实际动作概率;比值低于下界后,进入对应平台。
若概率正朝与评分相反的方向变化,未裁剪项仍保留纠偏信号。例如正优势但 $\rho=0.6$,目标为 $0.24$,仍随比值变化。这解释了为什么必须取 minimum,不能只写 ratio.clamp(...) * A。
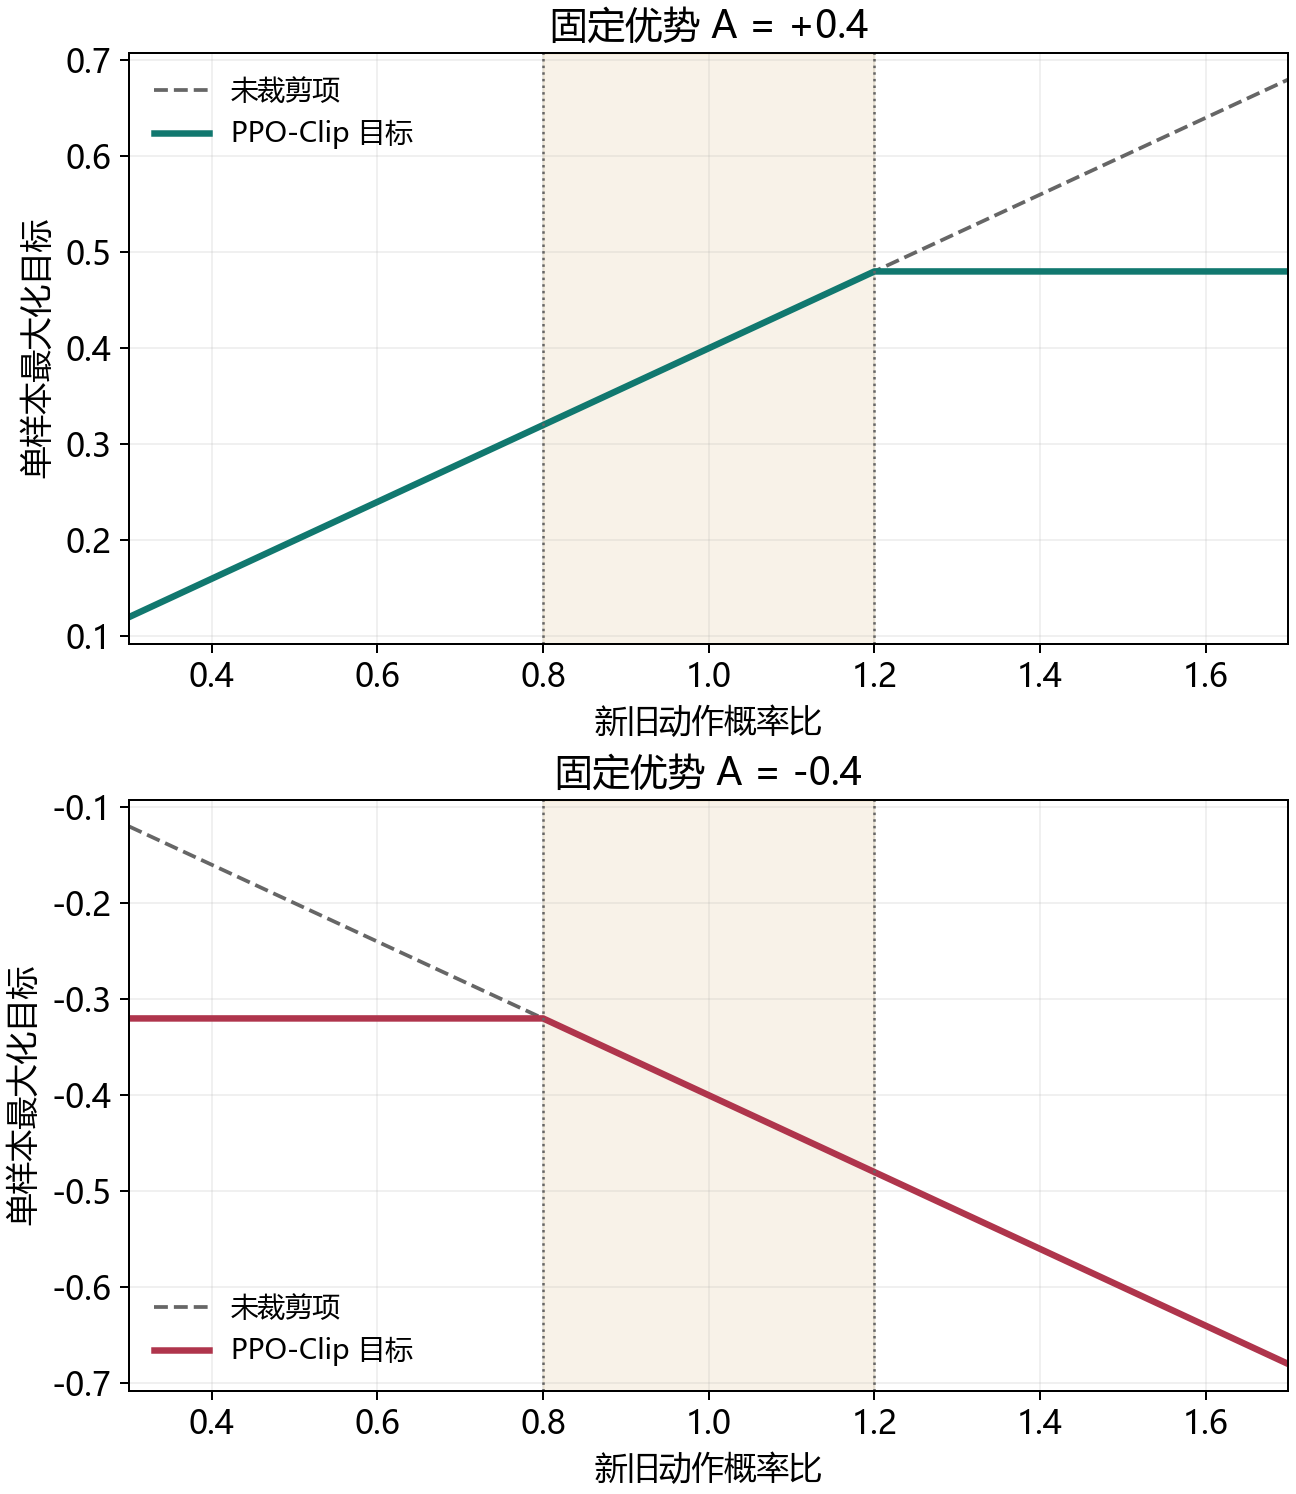
图中画的是需要最大化的 $S_t$;代码最小化 Actor loss,因此会在前面加负号。阴影是比值参考区间,平台位置随优势符号改变。[1][2]
裁剪发生在目标函数里,不会把网络真实输出概率强行锁住。这条样本进入平台后,其他样本、熵项和优化器状态仍可能改变参数。它是一种限制更新激励的机制,不是概率的硬约束。
6. 联合损失:当前预测有梯度,旧参照保持固定
当前练习的三个损失部分为:
\[L_{\mathrm{actor}} =-\frac{1}{B}\sum_{i=1}^{B}w_iS_i(\theta),\] \[L_{\mathrm{critic}} =\frac{1}{B}\sum_{i=1}^{B}(V_\phi(s_i)-y_i)^2,\] \[L_{\mathrm{total}} =L_{\mathrm{actor}} +c_vL_{\mathrm{critic}} -c_h\overline H.\]$i$ 表示批次里的第几条样本,不是回合内时间。$w_i$ 是该样本保存的时间权重,$y_i$ 是固定价值目标,$\overline H$ 是当前批次状态上的平均动作分布熵。当前配置为 $c_v=0.5$、$c_h=0.01$,clip_eps=0.2。
logits, values = model(batch["states"])
dist = Categorical(logits=logits)
new_log_probs = dist.log_prob(batch["actions"])
ratio = (new_log_probs - batch["old_log_probs"]).exp()

raw = ratio * batch["actor_weights"]
clipped = ratio.clamp(1 - clip_eps, 1 + clip_eps) * batch["actor_weights"]
actor_loss = -(
    batch["time_weights"] * torch.minimum(raw, clipped)
).mean()

assert values.shape == batch["targets"].shape
critic_loss = (values - batch["targets"]).square().mean()
entropy = dist.entropy().mean()
loss = actor_loss + critic_coef * critic_loss - entropy_coef * entropy
熵项前面取负号,因为最小化损失时希望奖励一定的动作分布多样性。系数控制它与策略目标的权衡,不是要求概率永远均匀。
当前价值与目标均为 [B],逐样本相减。如果预测为 [B,1]、目标为 [B],广播会产生 [B,B],把不同样本交叉比较。形状检查保护的正是这个对应关系。
| 本批优化中固定 | 每轮重新计算 |
|---|---|
| 保存状态与实际动作 | 当前网络的动作 logits |
| 旧对数概率 | 当前网络对原动作的 new_log_probs |
| 原始 GAE、Actor 权重 | 当前价值预测 values |
| 价值目标、时间权重 | 熵、损失、概率比与近似 KL |
本次沿用 Day4 对回合起点折扣目标的时间权重 $w_i=\gamma^{t_i}$,其中 $t_i$ 是这条样本在原回合中的时间,从 0 开始。常见 PPO 实现直接按 rollout 样本求均值,不额外乘这个外层折扣。本篇的结果对应当前加权方式;代码摘录中的 time_weights 保持与项目一致。
Actor 权重和目标已经在无梯度阶段算好,当前 values 与 new_log_probs 必须保留计算图。两个网络分支独立,Critic 通过自己的平方误差学习;Actor 的固定评分不会反向训练 Critic。
7. 一批多轮:重复前向,有限更新
epoch 是优化本批数据的一轮。它和“走完一个环境回合”是不同单位。
for epoch in range(update_epochs):
    loss, metrics = compute_losses(model, batch)  # 每轮建立新计算图
    if metrics["approx_kl"] > target_kl:
        break

    optimizer.zero_grad()
    loss.backward()
    nn.utils.clip_grad_norm_(model.parameters(), max_grad_norm)
    optimizer.step()
compute_losses 每轮重新执行上一节的前向与损失计算;批次里的旧概率、评分和目标仍固定。每轮 backward() 使用的是新图,不重复反传已经用过的图。
这里 update_epochs=4 是本批最多更新次数,target_kl=0.02 是提前停止参考,max_grad_norm=0.5 是梯度范数上限。metrics 保存当前损失、熵和变化指标;optimizer 是负责修改参数的 Adam 优化器。
这里有两种裁剪:
| 机制 | 作用位置 |
|---|---|
| PPO 概率比裁剪 | 策略代理目标,改变部分样本的更新激励 |
clip_grad_norm_ |
已计算出的参数梯度,限制整体梯度范数 |
近似 KL 超过参考阈值时,停止本批接下来的更新,外层训练仍会重新采样。检查发生在更新前;一次参数更新后仍可能越过阈值,因此阈值是停止参考,不是严格上界。[2][3]
外层循环把整个过程接起来:
for update in range(num_updates):
    batch, sampled_returns, trajectories = collect_batch(model)
    prepare_batch(batch)  # 本批优化前准备一次固定目标
    epoch_logs, metrics, stopped = update_batch(model, optimizer, batch)
把 optimizer.step() 移到每采一条转移后,会使一批经历来自不断变化的策略,不再是当前实现的“固定策略采一批,再优化本批”流程。
8. 实际训练:三个计数不要混在一起
本次重跑使用 Python 3.13.5、PyTorch 2.11.0+cpu。Actor 和 Critic 从零权重开始;优化器为 Adam,训练种子为 7。
| 配置 | 当前值 |
|---|---|
| $\gamma$ / GAE $\lambda$ | $0.9$ / $0.95$ |
| 每批完整回合数 | 32 |
| 外层采样批次数 | 80 |
| 每批最多优化轮数 | 4 |
| 学习率 | $0.03$ |
| 概率比裁剪幅度 | $0.2$ |
| Critic / 熵系数 | $0.5$ / $0.01$ |
| 梯度范数上限 / KL 参考阈值 | $0.5$ / $0.02$ |
| 优势标准化 | 关闭 |
当前实现使用全批更新。每个 epoch 对这一批全部转移前向一次、更新一次,没有再拆成 mini-batch。
| 实际计数 | 含义 | 结果 |
|---|---|---|
| 环境回合数 | 完整走到终点的次数 | 2560 |
| 环境步数 | 实际执行的转移数 | 4997 |
| 参数更新次数 | 实际执行 optimizer.step() 的次数 |
320 |
回合数为 $80\times32=2560$。每局长短不同,所以环境步数是实际统计出的 $4997$;本次没有触发提前停止,每批执行 4 次更新,共 $320$ 次。
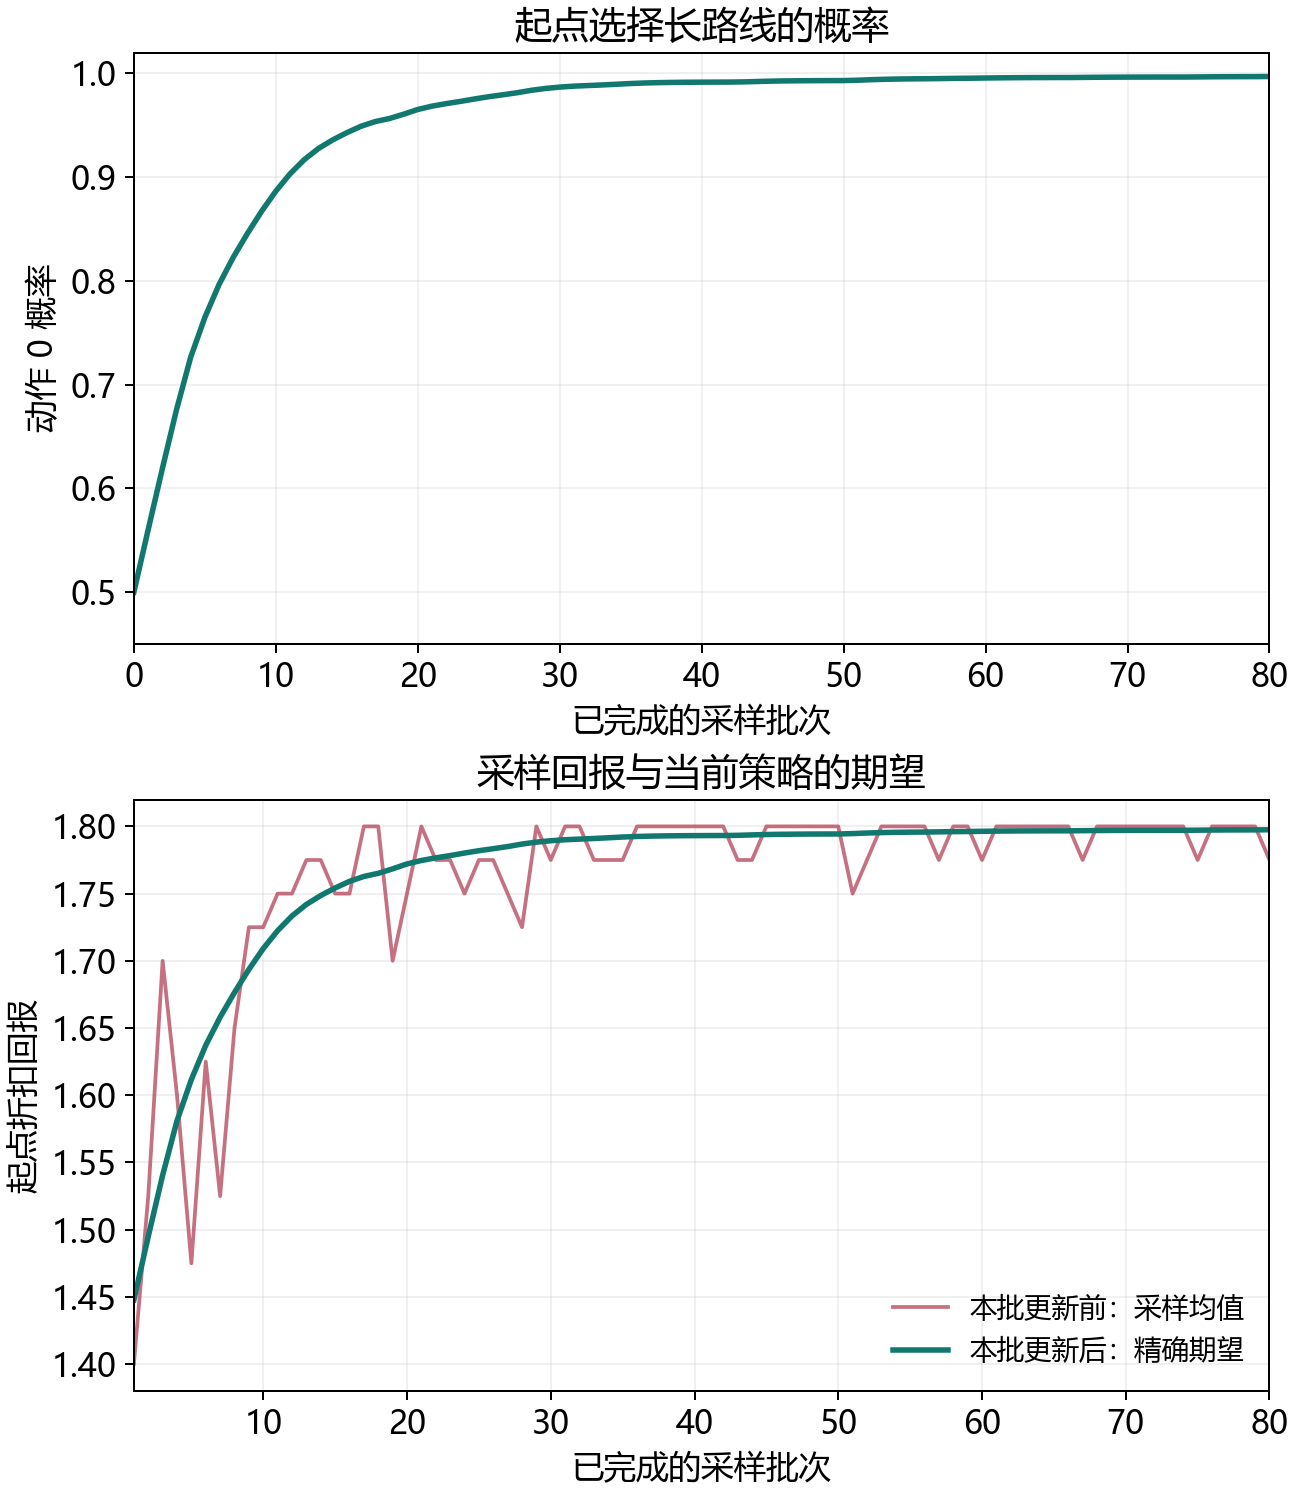
上图的概率包含初始点 $p=0.5$。下图的两条回报线对应不同时间:采样均值来自本批更新前走过的路线,精确期望来自本批更新后的策略。它们不要求每个批次都相等。
| 训练与评估输出 | 结果 |
|---|---|
| 起点长路线概率 | $0.5000\rightarrow0.9968709$ |
| 最终精确期望折扣回报 | $1.7974967$ |
| Critic 的 $V(s_0)$ | $1.7946117$ |
| Critic 的 $V(s_1)$ | $1.9999998$ |
| 冻结采样评估的长路线数 | $500/500$ |
| 冻结采样评估均值 | $1.8$ |
冻结评估使用独立种子 2026,整个过程不更新参数。采样仍按动作概率抽取;贪心评估则取最大概率动作。
状态 s0:动作 0,奖励 0 -> 状态 s1
状态 s1:动作 0,奖励 2 -> 真正终止
起点折扣回报:0 + 0.9 × 2 = 1.8
有限采样的 500 局全部走长路线,和真实长路线概率约 $0.9969$ 可以同时成立。精确期望为 $1.7975$,采样均值为 $1.8$;前者按整个动作分布计算,后者来自这次实际抽到的路线。
两条路线都能到终点,所以评价当前策略时同时看起点长路线概率与回报,不能只看终点成功率。
9. 指标分别回答什么问题
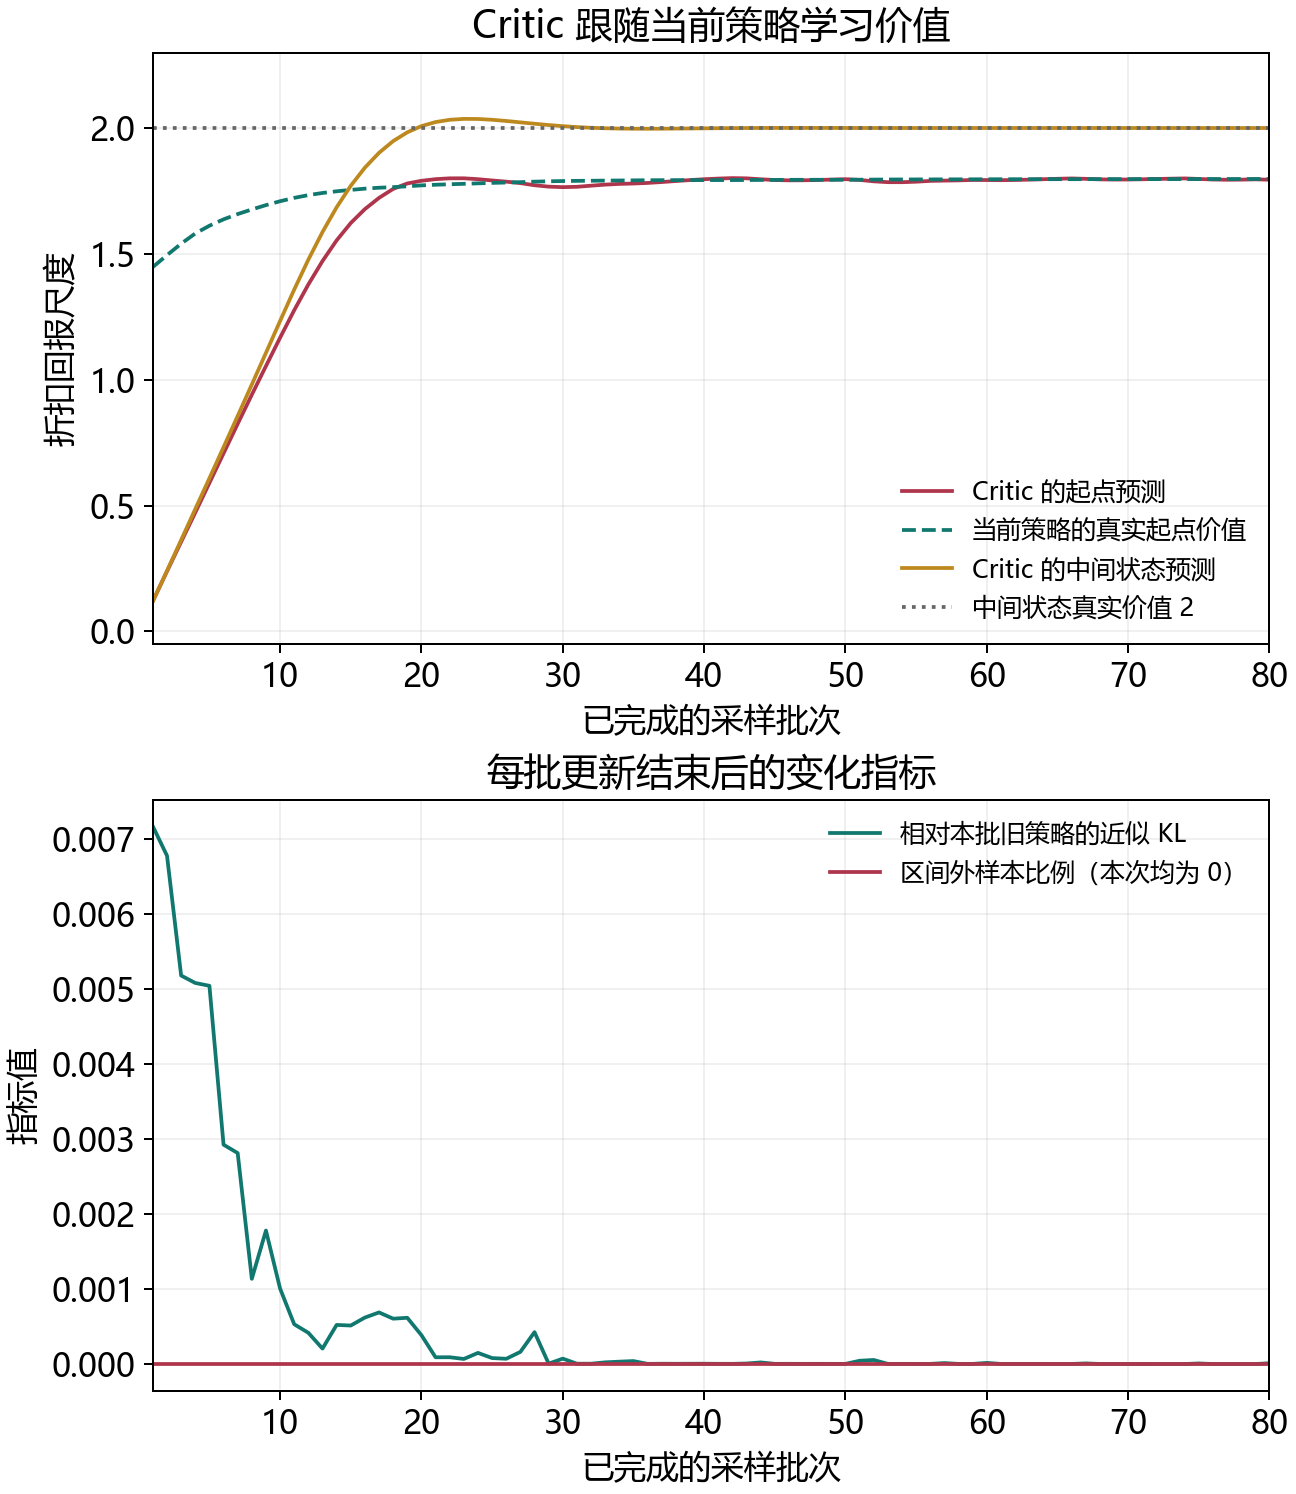
图中的真实起点价值随策略概率变化,中间状态的真实价值始终为 2。Critic 的任务是跟随当前策略估计价值,而不是记住曾经出现过的最高回报。
9.1 熵:动作分布有多确定
\[H(\pi(\cdot\mid s))=-\sum_a\pi(a\mid s)\log\pi(a\mid s).\]两动作 [0.5,0.5] 的熵约为 $0.6931$;[0.99,0.01] 与 [0.01,0.99] 的熵都约为 $0.0560$。但在当前环境中,它们的起点期望分别为 $1.792$ 和 $1.008$。
低熵表示动作选择较确定,好坏要看确定地选择了哪条路线。本实现记录的是批次访问状态上的平均熵,和只对起点计算的熵也要区分。
9.2 近似 KL:相对本批旧策略改变了多少
当前实现对保存的状态动作样本计算:
log_ratio = new_log_probs - old_log_probs
ratio = log_ratio.exp()
approx_kl = ((ratio - 1) - log_ratio).mean().item()
这是 rollout 上的估计,不是枚举所有状态得到的精确 KL。[3]
同一演示批次四轮的更新前 KL 约为 $0$、$0.00045$、$0.00180$、$0.00404$;第四次更新后约为 $0.00717$。新的 rollout 会建立新的旧策略参照。
因此,后期每批 KL 很小,和策略相对最初 [0.5,0.5] 已经明显变化并不矛盾。前者看单批偏移,后者看整个训练过程。
9.3 clip fraction:比值在区间外的样本比例
clip_fraction = (
    (ratio - 1).abs() > clip_eps
).float().mean().item()
它统计有多少样本的比值越过参考区间,不等于“多少样本的策略梯度为零”。例如正优势、$\rho=0.6$ 的样本在区间外,仍保留纠偏梯度;判断平台还要结合优势符号。
本次默认训练各批更新结束后的 clip fraction 都为 0,同批演示的四轮也没有进入裁剪区间。策略仍从 $0.5$ 更新到约 $0.9969$。这组曲线展示完整训练闭环,裁剪分支的行为由第 5 节四个数值及梯度例子单独核对;这里没有设置“裁剪版对未裁剪版”的性能对照。
9.4 两种 loss:优化目标和任务成绩分开看
Actor loss 是当前批次的策略代理损失。批次换了,旧策略和评分也换了,不宜拿不同批次的绝对值直接给策略排名。
Critic loss 衡量当前预测与本批固定价值目标的距离。小误差说明贴近这批目标;目标本身也含估计,所以评估仍需要任务回报,或者像本环境这样能够计算的真实策略价值。
假设策略几乎总走短路线,且本批更新很小,它可以同时具有低熵、小 KL 和低回报。先看起点动作 0 概率,再看完整轨迹,就能定位它是否集中选择了较低回报路线。
10. 为什么有限复用后还要重新采样
PPO 属于 on-policy 方法,同一批数据可以进行有限多轮优化,随后用近期策略收集新经历。[1][2]
概率比重加权的是已有状态下已有动作的概率。它不会生成旧数据中没有出现的路线,也不会自动把任意历史数据的全部状态访问分布改成当前分布。
另设一个数据覆盖例子:旧策略选择长路线的概率为 $0.01$,当前策略为 $0.80$。对起点动作 0,概率比为:
\[\rho=\frac{0.80}{0.01}=80.\]各采 100 局时,旧策略平均约产生 1 局长路线,当前策略平均约产生 80 局。这里是概率期望,不是训练计数。旧经历可能真实,但对当前常走路线的覆盖已经不足;给已有样本大权重,也补不出缺少的经历。
这也是外层循环继续调用 collect_batch(model) 的原因:观察更新后策略真正产生的路线,用新的采样参照构造下一批训练目标。
| 方法 | 当前学习涉及的数据使用方式 |
|---|---|
| DQN / Q-learning | off-policy;可复用旧转移,用下一状态的最大动作价值构造目标 |
| PPO-Clip | on-policy;使用近期策略采样,固定本批参照、有限优化,再重新采样 |
Day2 的 DQN 练习覆盖单次更新,这里借回放概念说明数据使用方式的差别。标准 PPO 的多轮优化围绕近期采到的批次进行。
当前闭环中,数据和参照的生命周期由外层采样与内层优化共同确定:状态和动作来自真实交互,旧概率与旧价值在采样时保存,GAE 和目标在更新前固定,当前网络每轮重新前向,有限更新后再收集新经历。
参考与继续阅读
- Schulman 等:Proximal Policy Optimization Algorithms,2017。
- OpenAI Spinning Up:PPO,概率比、裁剪目标、有限更新与 KL 停止。
- Stable-Baselines3 官方实现:PPO 与 RolloutBuffer,用于核对固定旧概率、GAE-return 和监测指标。
- PyTorch:概率分布 与 no_grad,对应动作采样、实际动作的对数概率和梯度模式。
上一篇:Day4 · 从 REINFORCE 到 GAE;系列入口:强化学习。