· 智能计算系统 / 反向传播 / 激活函数 / 过拟合
智能计算系统 Day4:多层神经网络的训练与优化
上节课把线性模型、感知机、隐藏层和反向传播的框架搭了起来。这节课只讲一件事:那几十个参数究竟怎样被训练出来。课堂用一个三输入、四层、29 个参数的小网络走完了正向传播、损失计算、反向传播和参数更新的全过程,再把视野拉到激活函数选择、损失函数选择、过拟合与正则化,最后落到大模型时代的训练数据构建。
一、为什么要谈“训练”
真实场景的数据规模与教学例子相差多个数量级。一个 $2000\times2000$ 的 RGB 图像有 400 万像素、1200 万个通道数值;按每秒 72 帧计算,一秒钟就要处理约 $8.6\times10^8$ 个通道数值。课堂用这个数量级说明真实数据是海量的,而教学为了能手工推演,会把输入压缩到三个。
参数规模同样悬殊。课堂的运行例子是一个三输入、四层、共 29 个参数的神经网络——教师特意强调,即使是这样一个小到“很不像样”的网络,也已经能演示训练的全部环节。29 个参数在初始化时通常取零或取自正态分布的随机数,训练就是把这 29 个数字调到具有智能化。
参数计数方法本身比这个具体数字更值得掌握。一个全连接层有 $d_{\mathrm{in}}$ 个输入、$d_{\mathrm{out}}$ 个输出时:
\[N_{\mathrm{params}}=d_{\mathrm{in}}d_{\mathrm{out}}+d_{\mathrm{out}}.\]以一个三输入、两个宽度为 2 的隐层、2 输出的网络为例:
| 层 | 权重形状 | 权重数 | 偏置数 | 小计 |
|---|---|---|---|---|
| 输入到隐层 1 | $2\times3$ | 6 | 2 | 8 |
| 隐层 1 到隐层 2 | $2\times2$ | 4 | 2 | 6 |
| 隐层 2 到输出 | $2\times2$ | 4 | 2 | 6 |
| 合计 | 14 | 6 | 20 |
转写中教师给出的分层计数是“8、8、12”,加起来为 29。这组数字不能唯一确定各层宽度——例如三输入、宽度依次为 2 与 3、三输出可得 $8+9+12=29$,而转写另处提到的“H1、H2、H3 三个隐单元、Y1、Y2 两个输出”又会得到别的总数。因此 29 按课堂口述保留,逐项核对时以上表这类完整说明为准。
训练目标写成一句话:调整参数,使模型的估计输出 $\hat y$ 逼近数据给出的真值 $y$。$\hat y$ 是算出来的,$y$ 是数据给的,两者的差距由损失函数 $L$ 衡量,训练就是让 $L$ 变小。
二、正向传播、损失与反向传播
一次训练迭代包含四步:
- 正向传播:给一个输入 $x$,逐层计算隐藏表示,从低级特征逐步提取为高层抽象特征,最后输出 $\hat y$。
- 计算损失:把 $\hat y$ 与 $y$ 相比较,得到一个标量损失。
- 反向传播:沿计算依赖的反方向应用链式法则,求出每个参数的梯度。
- 参数更新:用梯度下降一类的方法调整 $W$ 和 $b$,使损失变小。
第一轮之后参数得到更新,网络进入下一轮正向传播,如此反复。课堂提到,实际训练一个网络通常至少需要上百个 epoch,很多时候要上千轮迭代。
1. Transformer 中的 FFN 对应哪一部分
课堂用 Transformer 里的 FFN 说明“两层全连接层”的常见形态。FFN 一般由两个全连接层组成,中间加非线性变换,作用是把每个位置上的表示做一次全局性的特征变换。在 Encoder-Decoder 结构里,它承担的是特征整合角色。这部分与本节的小网络是同一类计算,只是规模和数据形态不同。
2. 为什么误差必须逐层往回送
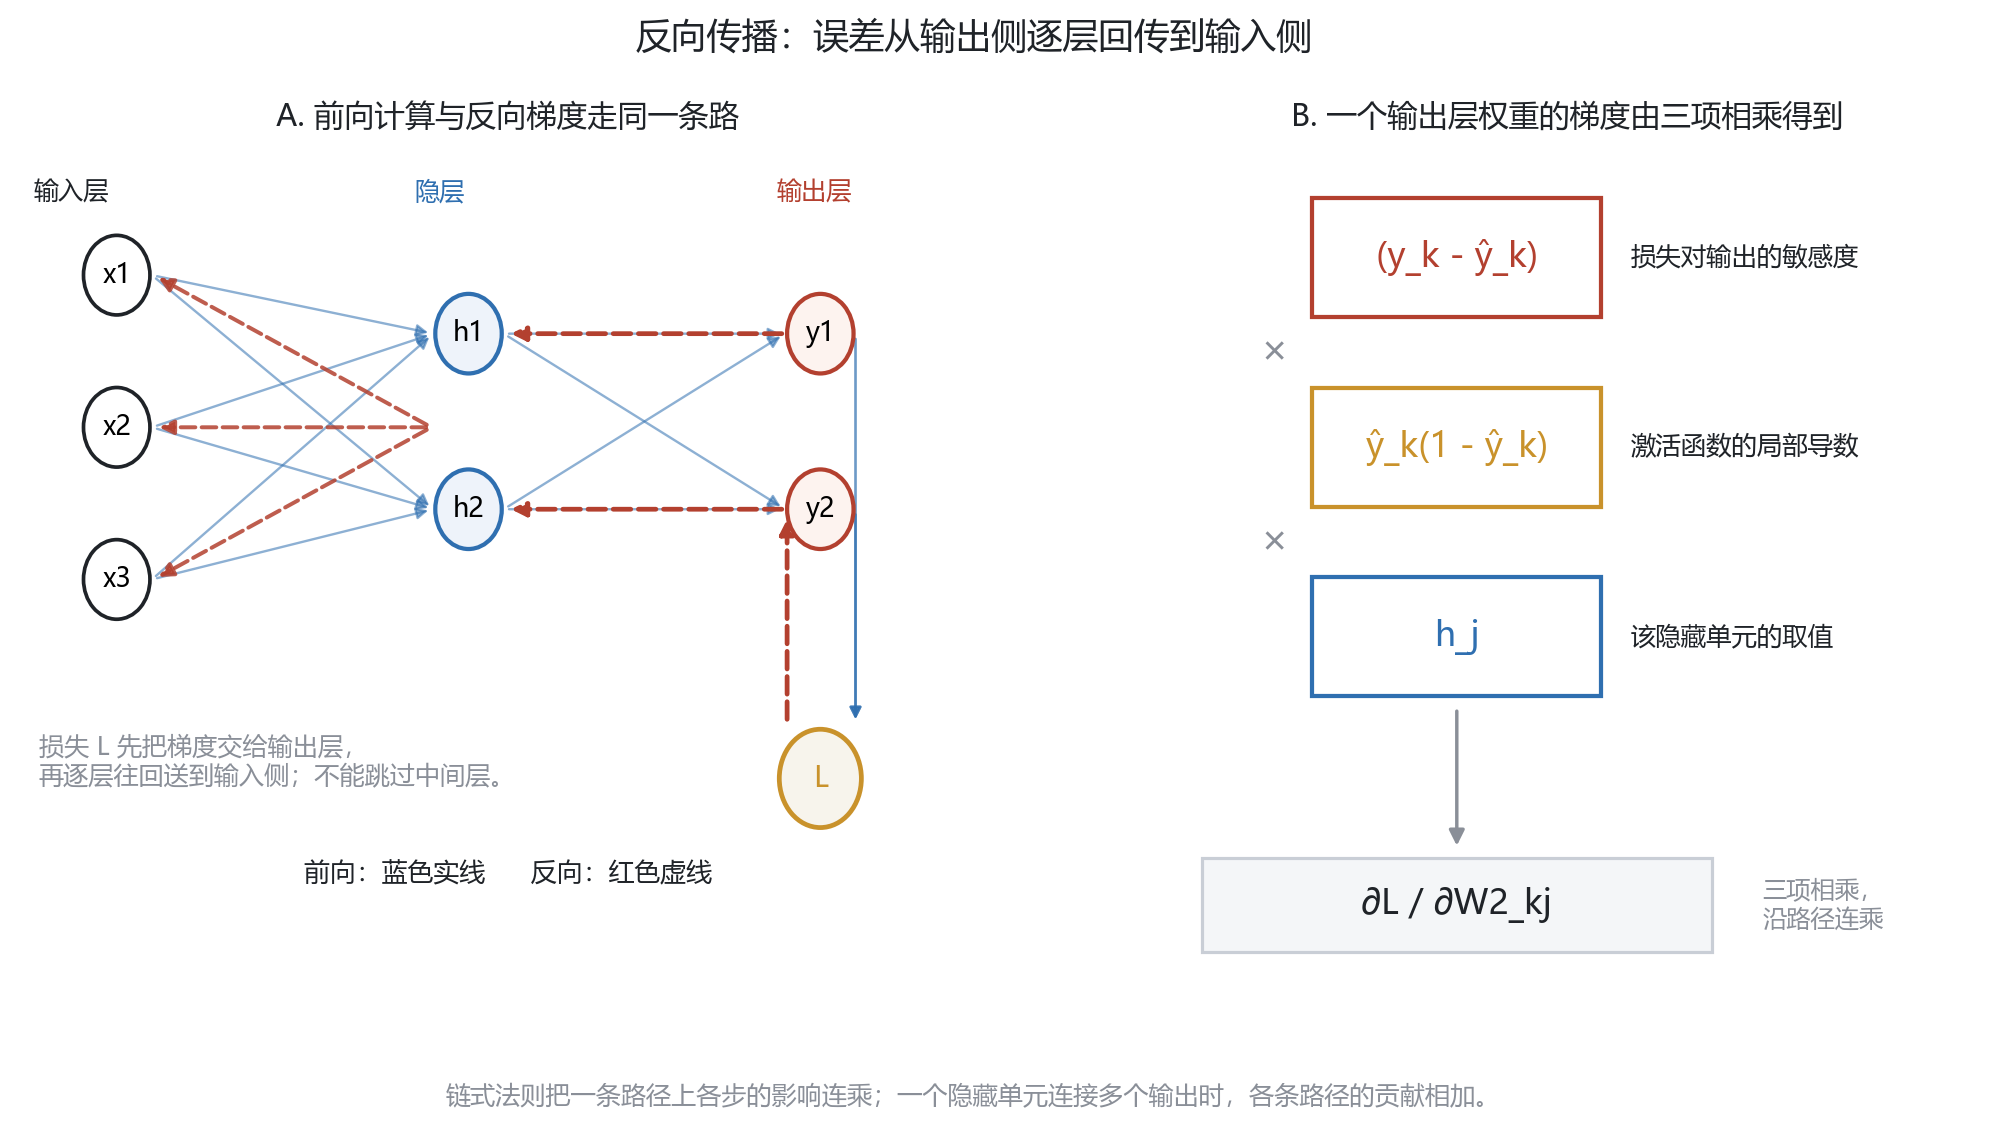
修改倒数第一层的权重没有障碍:它直接与损失相连。修改倒数第二层时,梯度必须先经过倒数第一层才能到达,因此不能跳过中间层,只能一层一层往前传。这就是反向传播“逐层”的含义,也是它必须借用链式法则的原因。
3. 链式法则:一条路与多条路
最简单的情形是一条路。若 $z$ 经函数 $h$ 依赖于 $y$,$y$ 又经函数 $g$ 依赖于 $x$,则:
\[\frac{dz}{dx}=\frac{dz}{dy}\cdot\frac{dy}{dx}.\]课堂把 $y$ 比作隐藏态:从输入 $x$ 到最终损失要经过它,所以要把两段导数连乘。
更常见的是多条路汇合。若 $z$ 同时是 $x$ 和 $y$ 的函数,而 $x$ 与 $y$ 又都依赖于同一个 $s$:
\[\frac{dz}{ds} =\frac{\partial z}{\partial x}\frac{dx}{ds} +\frac{\partial z}{\partial y}\frac{dy}{ds}.\]两条路的贡献相加。课堂上教师特意点出,这种多路并联的情形高中数学不讲,但做法只是把各条路分别算完再求和。一个隐藏单元连接多个输出单元时,梯度正是这样累加起来的。
4. 一个输出层权重的完整分解
以 $h=\sigma(W_1x+b_1)$、$\hat y_k=\sigma(z^{(2)}k)$、$z^{(2)}_k=\sum_j W2{kj}h_j+b2_k$、$L=\frac12\sum_k(\hat y_k-y_k)^2$ 为例:
\[\frac{\partial L}{\partial W2_{kj}} =\underbrace{(\hat y_k-y_k)}_{\text{损失对输出的敏感度}} \underbrace{\hat y_k(1-\hat y_k)}_{\text{激活函数的局部导数}} \underbrace{h_j}_{\text{该隐藏单元的取值}}.\]三项分别回答三个问题:输出差多少、激活函数在这一点放大或缩小多少、这个隐藏单元贡献了多少。沿路径连乘,就得到该权重对最终损失的影响。继续往输入侧走:
\[\frac{\partial L}{\partial h_j} =\sum_k\frac{\partial L}{\partial z^{(2)}_k}W2_{kj},\] \[\frac{\partial L}{\partial z^{(1)}_j} =\frac{\partial L}{\partial h_j}\,h_j(1-h_j), \qquad \frac{\partial L}{\partial W1_{ji}} =\frac{\partial L}{\partial z^{(1)}_j}\,x_i.\]更新规则为 $W\leftarrow W-\eta\,\partial L/\partial W$。BP 负责算梯度,优化器决定怎样使用梯度,两者不是同一件事。
三、批次、迭代与轮次
真实训练集有几千到几十万张图像,不可能一次性全部送入。课堂的做法是每次随机取 100 张训练一遍,再取下一批。
| 概念 | 含义 |
|---|---|
| batch size | 一次参数更新使用的样本数,课堂例中为 100 |
| iteration(迭代) | 用一个 batch 的数据对模型做一次参数更新 |
| epoch(轮次) | 把整个训练集完整过一遍 |
若训练集共有 $N$ 个样本、批量大小为 $B$,一个 epoch 包含约 $N/B$ 次 iteration。小批量方法既能减少单次更新需要处理的数据,又能利用矩阵运算并行处理多个样本;批量大小影响内存、吞吐和梯度噪声,需要结合任务与设备选择。
四、激活函数:把直线掰弯的几种方式
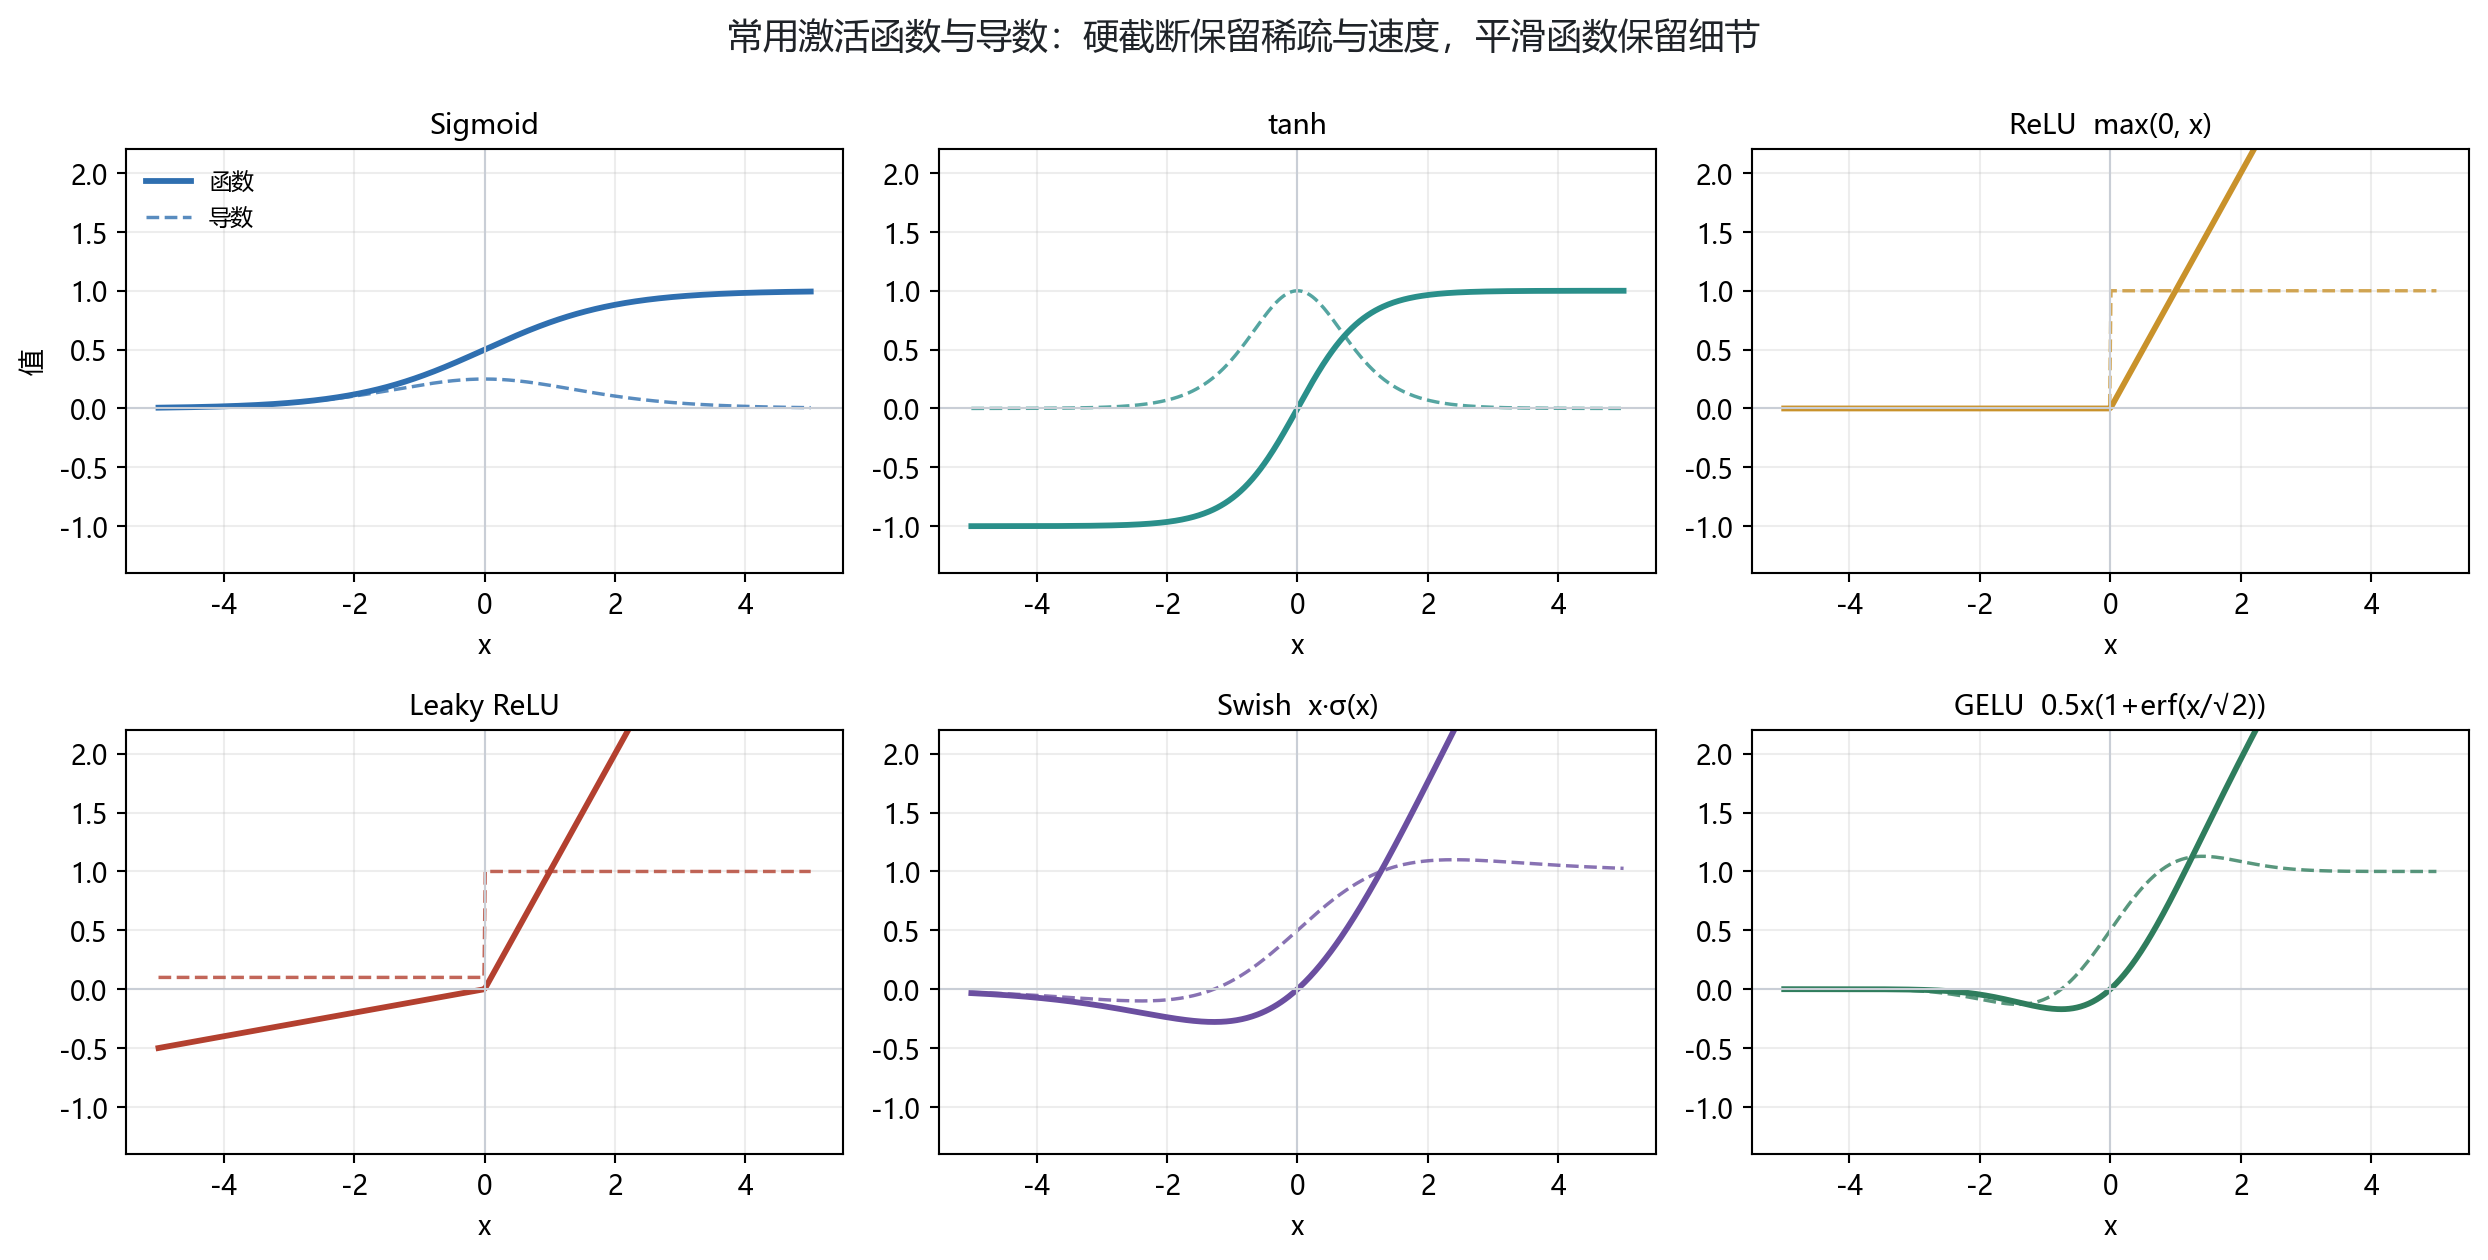
纯线性层堆叠多少次仍是一次仿射变换,无法分开 XOR 那类问题。激活函数的作用就是把决策边界“掰弯”,而且要多掰几次。课堂依次点评了几种常用选择。
1. Sigmoid
\[\sigma(z)=\frac{1}{1+e^{-z}},\qquad \sigma'(z)=\sigma(z)(1-\sigma(z)).\]优点是把任何实数压到 $(0,1)$,收敛较快,网络更可控。缺点在课堂被讲得很具体:输入绝对值较大时输出几乎不再变化,导数趋零,梯度被截断;输出不是零均值,会使后层的偏置变大;指数与除法运算开销大。若大量输入落在饱和区,这些单元对梯度的贡献接近于零,等于被丢弃。
2. Tanh
\[\tanh(x)=2\sigma(2x)-1.\]把输出范围拉到 $[-1,1]$,实现零均值,缓解了 Sigmoid 的非零均值问题。但饱和区同样会杀死梯度,且指数加减配合除法的计算量更大。课堂的对照很直接:ReLU 连乘加都不做,只做一个比较,这正是网络能够堆到极深的原因之一。
3. ReLU
\[\operatorname{ReLU}(z)=\max(0,z).\]正半轴导数恒为 1,不饱和,计算只是一个比较,因此成为使用最多的激活函数。问题在负半轴:导数为 0,若某单元因学习率过大在反向传播后长期只收到负输入,它就再也不会被激活,称为神经元死亡。输出也没有上界。
4. Leaky ReLU 与 ELU
Leaky ReLU 在负半轴给一个小斜率,使负输入仍有梯度,单元不会死。ELU 在负半轴用指数饱和,输出更接近零均值,对噪声更稳健,计算略复杂。两者都是对 ReLU 负半轴的修补。
5. Swish 与 GELU:大模型为什么偏好平滑
\[\operatorname{Swish}(x)=x\,\sigma(x), \qquad \operatorname{GELU}(x)=0.5x\left(1+\operatorname{erf}\frac{x}{\sqrt2}\right).\]两者都是平滑函数,负半轴不为零,梯度连续。课堂给出的选型理由值得单独记:分类任务追求效率,ReLU 把负半轴直接置零,理论上稀疏后可以跳过部分计算;生成任务强调保留细节,硬截断会把信息直接扔掉,对生成质量不利,因此更偏向 Swish 这类平滑函数。实际网络中常把两者结合使用。置零能否真正减少运算量,还取决于算子与硬件是否支持稀疏计算,这一点在上节课已经单独区分过。
五、损失函数:MSE 与交叉熵的分工
1. MSE 与它的统计假设
均方误差把预测与真值相减后平方:
\[L=\frac12(\hat y-y)^2.\]课堂说明,使用平方损失隐含“误差服从高斯分布”的假设;这一条在上节课已经从最大似然的角度推过。MSE 适合回归任务。
2. Sigmoid 配 MSE 的问题
若输出层用 Sigmoid、损失用 MSE,输出层的梯度为:
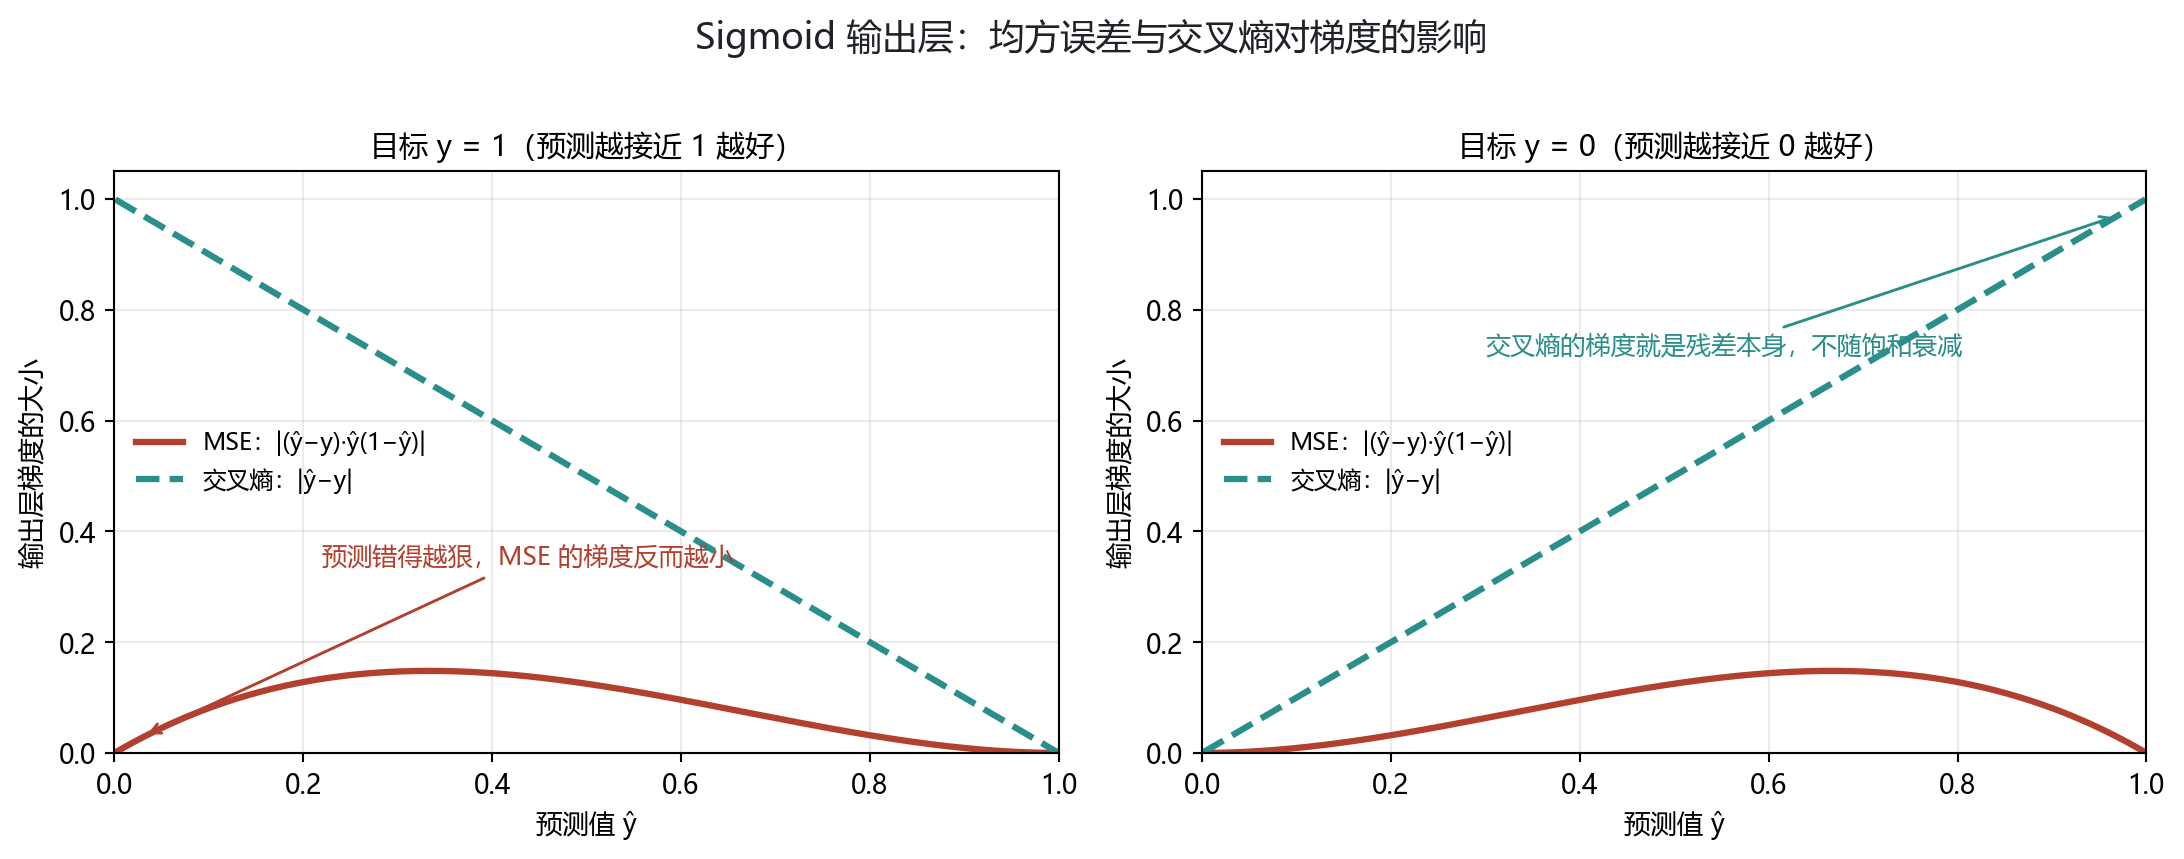
\[\frac{\partial L}{\partial z}=(\hat y-y)\,\hat y(1-\hat y).\]后一项正是 Sigmoid 的局部导数。当 $\hat y$ 接近 0 或 1 时它趋近于零,梯度随之消失——预测错得越极端,回传的梯度反而越小,参数更新缓慢。这正是课堂指出的“输出接近饱和时出现梯度消失”。
3. 交叉熵怎样把饱和项消掉
二分类交叉熵写作:
\[L=-\bigl[y\ln\hat y+(1-y)\ln(1-\hat y)\bigr].\]对 $z$ 求导时,对数项产生的 $1/[\hat y(1-\hat y)]$ 与 Sigmoid 的局部导数恰好抵消:
\[\frac{\partial L}{\partial z}=\hat y-y.\]梯度就是残差本身,不再带有饱和因子。多分类情形下配合 Softmax 有同样干净的形式:
\[L=-\sum_{k=1}^{K}y_k\ln p_k, \qquad \frac{\partial L}{\partial z_k}=p_k-y_k.\]课堂的结论是:交叉熵损失消掉了那个“很讨厌的” Sigmoid 导数项,因此最后一层的梯度不会消失,参数更新更快。这也是分类任务普遍采用交叉熵的原因。
六、过拟合、欠拟合与正则化
1. 两种失效
课堂用三类拟合结果对照:
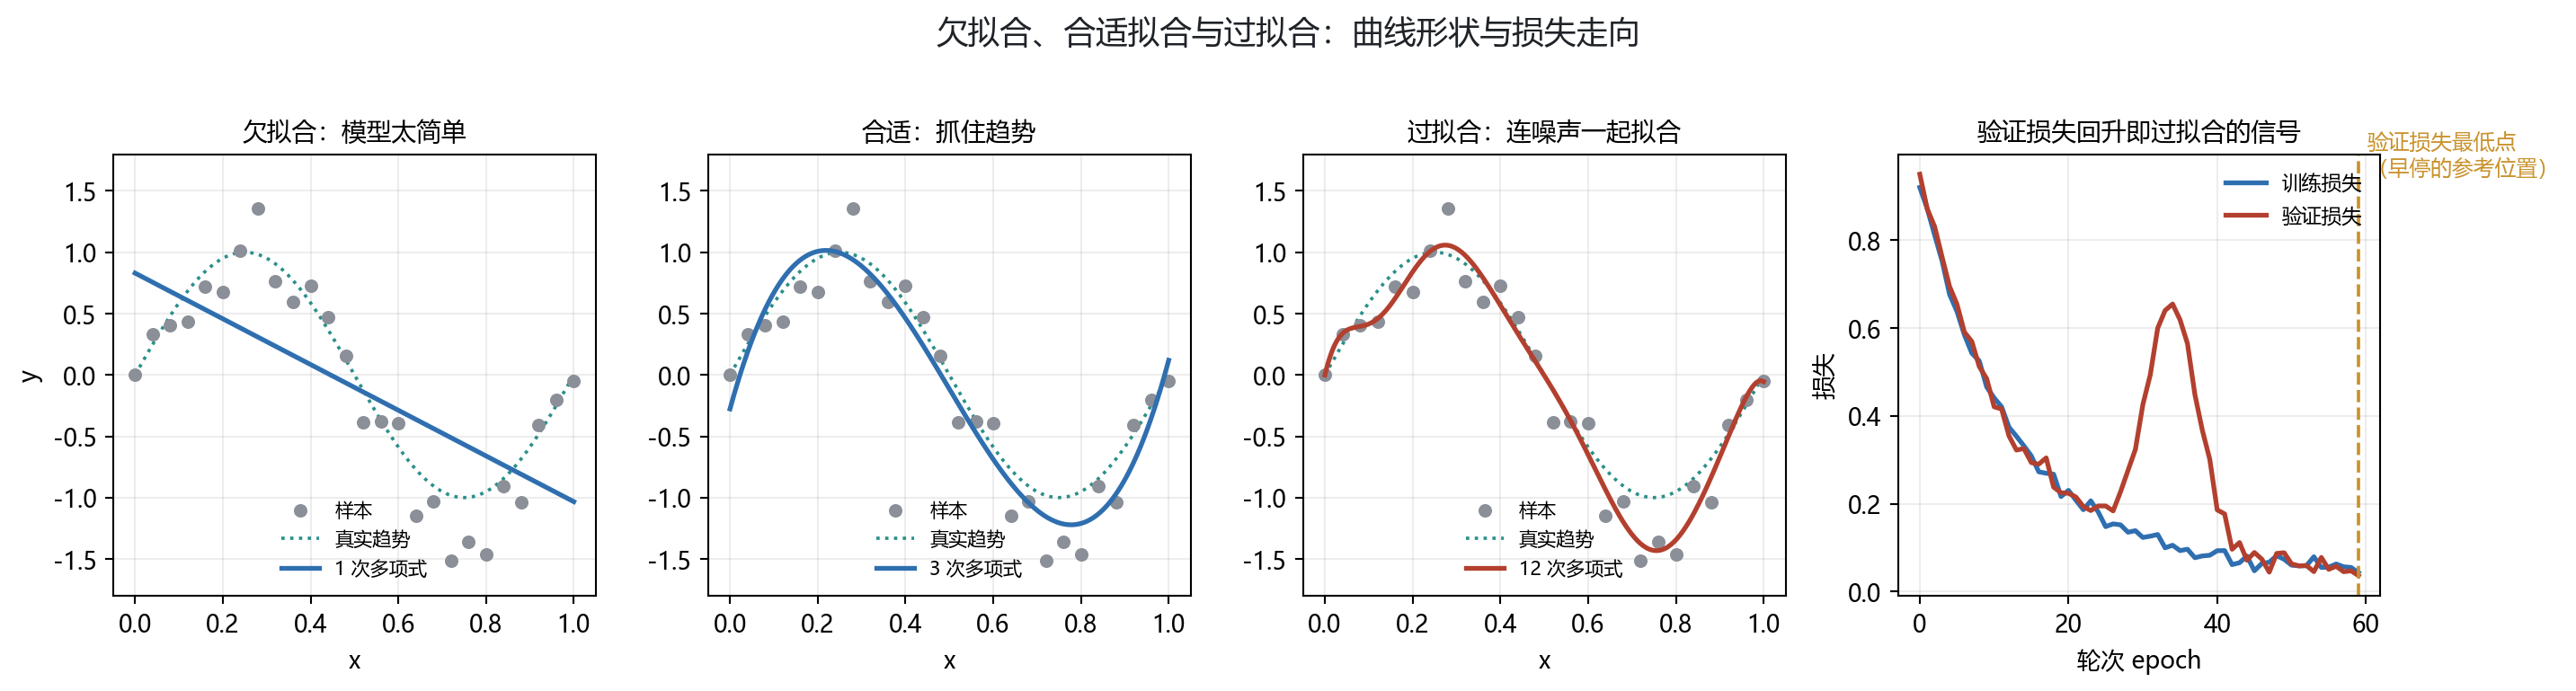
- 欠拟合:模型本身 capacity 不足,数据再多也合不出应有的效果,训练集上误差就高。
- 合适拟合:抓住数据背后的趋势与概率密度,而不是逐点重合。
- 过拟合:网络很强、数据量太少,加上采样本身相对真实分布有偏差,模型把少量样本里的噪声当成了规律。在小样本上拟合得很好,对样本所代表的整体反而不好。
过拟合的判断不能只看训练损失。课堂强调神经网络的数据有一个分布假设:拟合出的曲线应当反映数据集背后的概率密度,采样偏差会让“拟合得好”与“真的准”脱钩。
2. 正则化手段
| 手段 | 做法 | 作用 |
|---|---|---|
| L2 正则化 | 在损失上加权重平方和惩罚 | 使权重平滑,抑制剧烈弯曲的边界 |
| L1 正则化 | 在损失上加权重绝对值惩罚 | 促进稀疏,可把大量权重压到零 |
| 稀疏化 | 强制约九成权重为零 | 去掉冗余连接与神经元,降低计算量 |
| Dropout | 训练时随机删除隐藏单元 | 打破单元间的共适应,常见保留率为 0.8 或 0.5 |
| 早停 | 验证损失不再下降时停止 | 避免在验证集表现变差后继续训练 |
| 数据增强 | 对样本做变换扩充多样性 | 缓解小样本偏差 |
| Batch Normalization | 规范化每层输入 | 稳定分布、加速收敛,允许更高学习率 |
Dropout 每次迭代随机丢弃不同单元,等效于训练多个子网络;适当过拟合在一定程度上还能提升泛化能力。Batch Normalization 处理的是层数升高后特征尺度差异过大的问题。
3. 数据集划分
| 划分 | 用途 |
|---|---|
| 训练集 | 计算损失并学习参数 |
| 验证集 | 调超参数(网络结构、学习率、迭代次数),决定何时停止 |
| 测试集 | 方案确定后评价泛化表现 |
划分的目的正是避免过拟合、避免依据测试结果反复修改方案而使评估偏乐观。
4. 一个开放问题
课堂留了一道思考题:大模型时代通过自监督获得了海量训练数据,数据量几乎可以无限供应,这是否意味着过拟合不再存在?授课教师明确说答案不一定,建议查论文。可以确定的是,“过拟合”的定义依赖于对“真实分布”和“评价基准”的界定;当动作表现已全面超过人类参照时,用是否超过人类来判断过拟合本身就不成立了。
七、大模型时代的训练数据构建
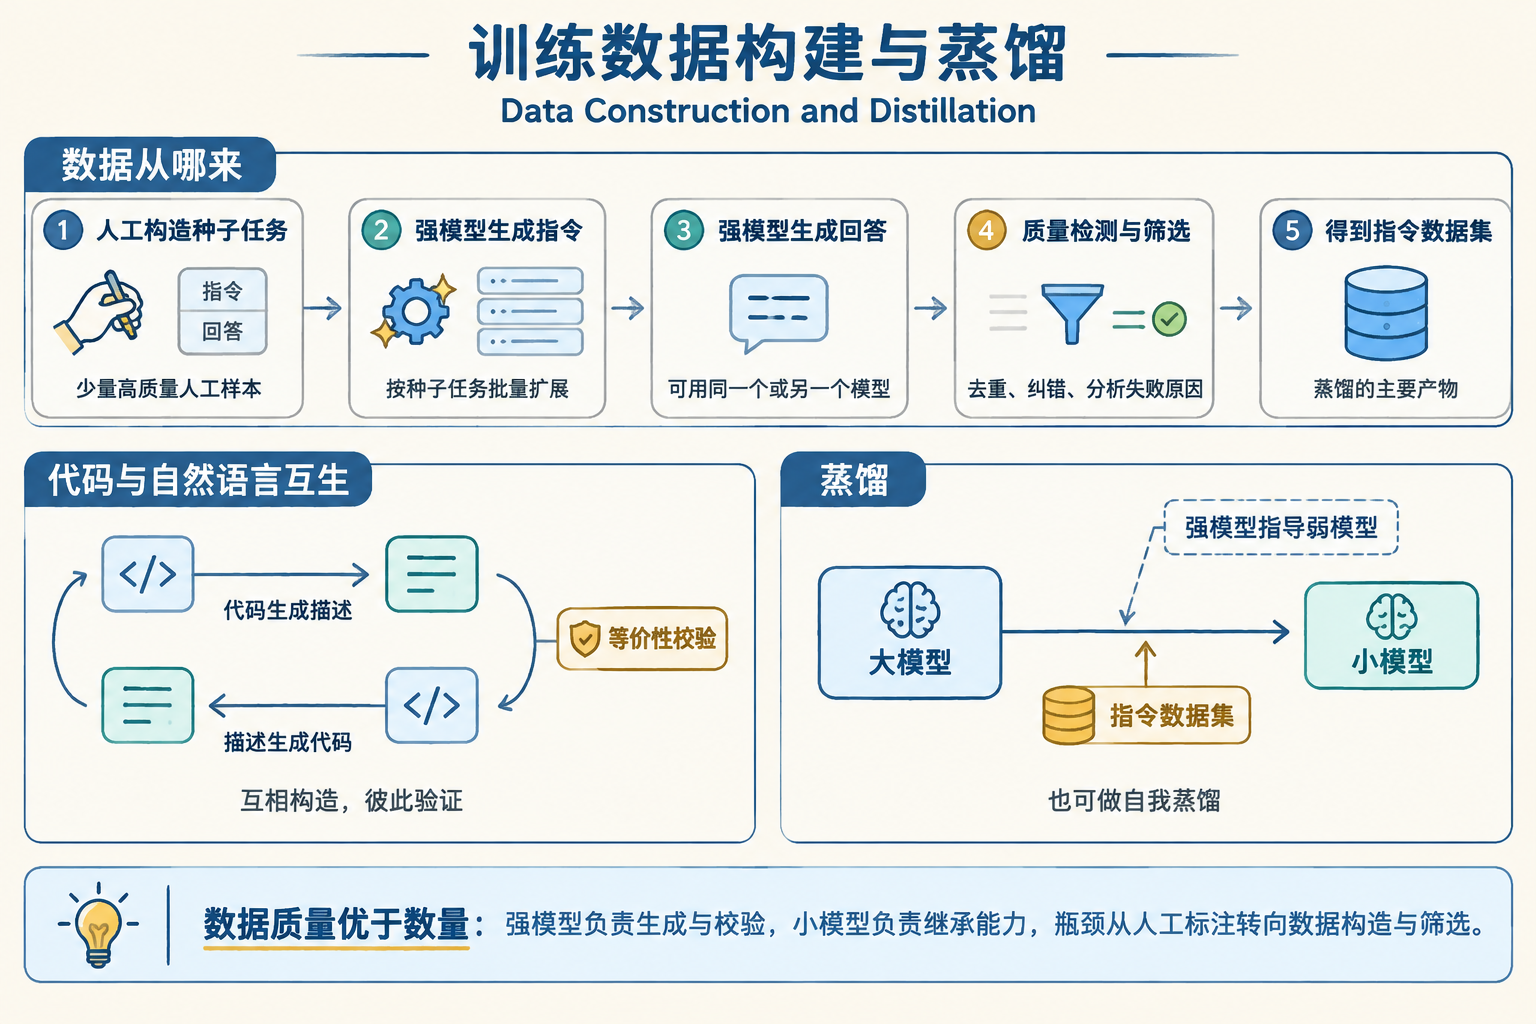
1. 合成指令数据
课堂给出一套可操作的流程:
- 人工构造少量种子任务,以指令—回答的形式给出高质量范例。
- 用强模型根据种子任务批量生成更多指令。
- 让强模型(或另一个模型)为这些指令生成回答。
- 做质量检测:对测试集去重、分析失败原因、补充修正数据,把人工标注的经验固化成检测脚本。
开源代码也可以作为种子来源:搜集多层次问题、总结出问题与答案,缓解指令数据不足;代码与自然语言还能互生——先用模型把代码总结成自然语言描述,再用另一个模型根据描述重新生成代码,若两者等价、描述与功能一致,就得到一批新样本。这种方式用等价性校验替代了人工标注。
2. 蒸馏
强模型生成指令与回答的整套产物,本质上就是一份数据集;拿这份数据去训练自己的小模型,就是蒸馏。课堂举的例子是:先让一个大模型根据自定义任务生成大量指令,再让这些指令去驱动另一个模型产生回答,从而得到训练小模型所需的数据集。模型也可以对自身做自我蒸馏。
八、网络设计是一组可调的选择
课堂把可调的部分归为四类:网络结构(层数、每层宽度、连接方式)、激活函数、损失函数、训练用的 $(X,Y)$ 对。训练效果不好时,通常从这几处分别调整再试验。
同时给出两条经验边界:
- 深度与宽度不必然更好。课堂举例,56 层的网络误差反而高于 20 层;不是越深越好,也不是越宽越好,一切要经过验证。
- 这是个体力活。调结构、换激活、改损失需要大量试错,年轻人的精力优势在这里能直接转化成产出。
大模型时代网络结构的变化更灵活,但本节的基本框架——正向传播算预测、损失衡量差距、反向传播回传误差、优化器更新参数——没有改变。
九、后续安排
课堂预告下节课进入卷积神经网络、循环神经网络、持续学习、大模型架构与网络轻量化。假期期间的安排是阅读群里发布的论文并分组准备分享,预习卷积与循环神经网络及典型网络结构,了解评价指标(如目标检测中的 mAP、IoU),并思考“大模型海量数据下是否仍存在过拟合”。授课教师说明典型网络本身不会逐层细讲,重点放在评价指标上。
参考资料
课堂内容依据本次《多层神经网络训练与优化核心要点》转写整理。参数量表、梯度曲线、激活函数对比图、过拟合示意与合成数据流程为补充推演与整理;课堂运行例子的分层计数在转写中不能唯一确定,相关位置已注明。
- Goodfellow、Bengio、Courville,Deep Learning,Chapter 6:Deep Feedforward Networks。用于对照反向传播的推导与计算图。
- Michael Nielsen,Neural Networks and Deep Learning,Chapter 2。用于对照链式法则在两层网络上的完整推导。
- Srivastava、Hinton、Krizhevsky 等,Dropout: A Simple Way to Prevent Neural Networks from Overfitting,JMLR 2014。
- Ioffe、Szegedy,Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,ICML 2015。
- Ramachandran、Zoph、Le,Searching for Activation Functions,2017。Swish 的出处。
- Hendrycks、Gimpel,Gaussian Error Linear Units (GELUs),2016。