· 人工智能导论 / 机器学习 / 神经网络
人工智能导论 Day4:从对抗搜索到基于学习的方法
RedMoon · 2026-09-29 · 课堂笔记
上节课把盲目搜索、启发式搜索、与或图和博弈搜索走完。这节课前半段给博弈搜索收尾:先请同学把井字棋的极大极小完整讲了一遍,再走了一次 Alpha-Beta 剪枝;后半段转到机器学习,开头是一个很朴素的说法——所谓学习,就是从大量的 $(X, Y)$ 对里把参数 $W$ 拟合出来。两段内容放在一起看,分野不在“聪不聪明”,在知识从哪里来。
一、规则式方法与学习式方法
| 维度 | 规则式方法 | 学习式方法 |
|---|---|---|
| 代表 | Minimax、Alpha-Beta、A*、汉诺塔的任务分解 | 线性回归、SVM、神经网络、大模型 |
| 知识来源 | 人根据经验定义的规则与估价函数 | 数据中的 $(X, Y)$ 对 |
| 可调整的部分 | 改写规则、更换启发函数 | 优化参数 $W$ |
| 效果怎么衡量 | 逻辑推演是否正确 | 损失函数是否下降、测试集表现 |
| 主要风险 | 规则覆盖不到的情形 | 分布变化、过拟合、标注成本 |
课堂的原话是“很难讲它是 learning based 的方法,因为它是根据人的经验提炼出来的”。这不等于规则式方法不重要:Minimax 为什么正确、Alpha-Beta 为什么能剪,都可以一步步讲清楚;换成学习式方法后,必须补上损失函数、优化方法与泛化条件才敢下结论。后面所有模型换的是架构与规模,“任务—经验—性能”这个框架没有变。
二、井字棋:估价函数与极大极小倒推
1. 估价函数怎么定
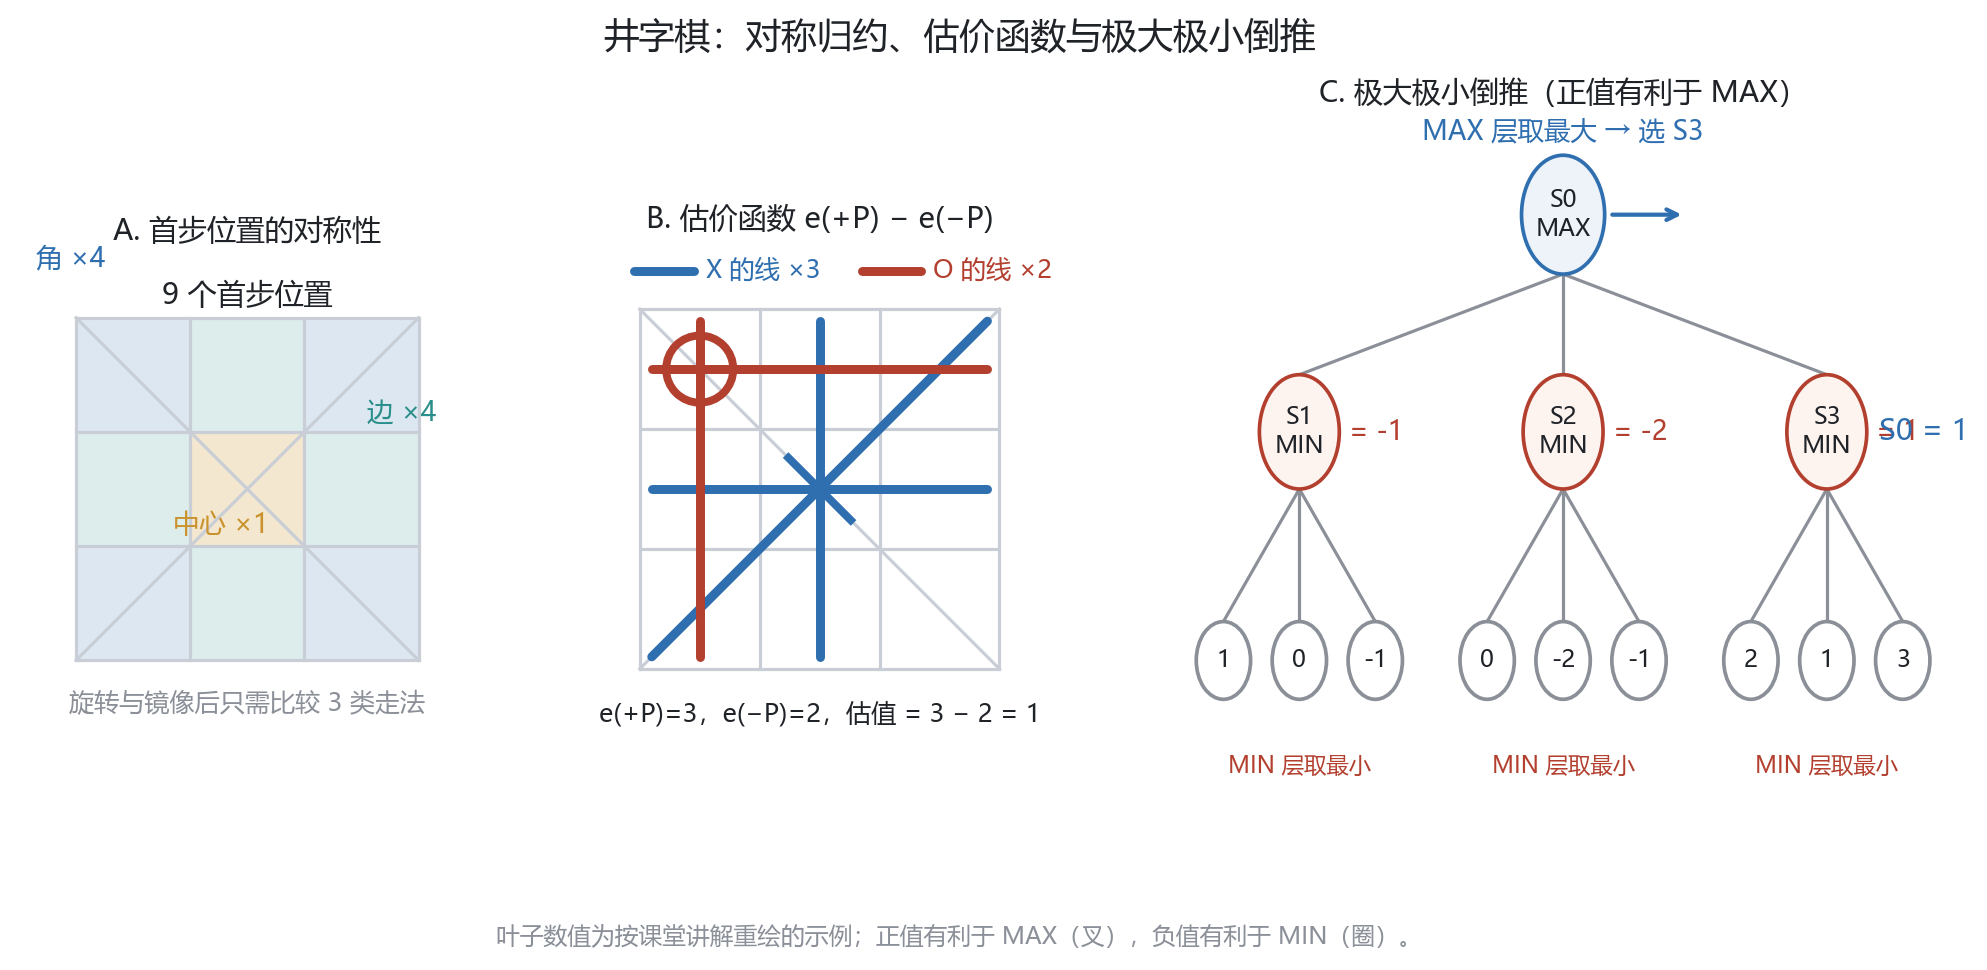
倒推需要知道每个终局值多少钱,但 $19\times 19$ 的棋盘不可能算到终局,于是引入估价函数给当前局面打一个静态分。课堂用的是线路计数:把双方仍有可能连成三子的线路数之差作为局面分。
空格棋盘共有 8 条线:3 行、3 列、2 条对角线。每落一子,自己会新增若干条可用线路,同时可能挡掉对方几条。设 $e(+P)$ 为 MAX 一方仍可连成的线路数,$e(-P)$ 为 MIN 一方的对应数目,则
\[\text{估值}=e(+P)-e(-P).\]估值为正有利于 MAX,为负有利于 MIN。以“X 占中心、O 占左上角”为例:X 还剩中间行、中列、右上—左下那条对角线 3 条;O 还剩上行、左列 2 条,它所在的左上—右下对角线已被 X 占住。于是一件很局部的事被压成一个数 $3-2=1$。
这个估价的含义要留意:它数的是“还有几条路”,不是“几步之内能赢”。线路被挡掉后计数会下降,课堂里“被别人堵一下就从八条变成六条”说的就是这件事。
2. 对称性把 9 个首步压成 3 类
$3\times 3$ 棋盘的第一步有 9 个位置,但棋盘在旋转与镜像下等价:4 个角同类,4 个边同类,中心单独一类。真正需要比较的只有 3 种走法,搜索树的第一层从 9 个分支降到 3 个。
课堂由同学讲完整棵树:根节点 $S_0$ 由 MAX(叉)走,下设 $S_1$、$S_2$、$S_3$ 三个 MIN(圈)节点。倒推规则是 MAX 层取子节点最大值,MIN 层取子节点最小值,一路回传到根:
\[S_1=-1,\qquad S_2=-2,\qquad S_3=1,\qquad S_0=\max\{-1,-2,1\}=1.\]MAX 在对手的最佳回应里取对自己最好的那个,所以选 $S_3$。若换成“每一步都穷举”,$3\times 3$ 还能算,$19\times 19$ 的围棋完全不可行——课堂在这里点明:五子棋可以靠专家级穷举把人类高手压在下面,围棋的可能性太多,只能另找办法。
3. 复杂度的量级差别
同一个“先生成博弈树、再算每个节点倒推值”的思路,代价随棋盘急剧上升:
| 棋盘 | 可用线路数 | 能否穷举 |
|---|---|---|
| $3\times 3$ 井字棋 | 8 条 | 可以,加上对称归约后很小 |
| 五子棋 | 随连子路径快速增长 | 专家级穷举可行,人类难以取胜 |
| $19\times 19$ 围棋 | 每一步的合法落点已极多 | 现有算力无法穷尽 |
课堂同时提醒,AlphaGo 那批论文里也用到了这类非常简单的规则,只是另外叠加了更多加速搜索的技巧。搜索部分到此结束,后续结合 AlphaGo 系列与 Nature 上的新论文再看蒙特卡洛树搜索、策略网络与价值网络。
三、Alpha-Beta:把不影响选择的分支砍掉
1. α 与 β
剪枝不是在生成完整树之后做,而是边生成博弈树边计算倒推值,一旦发现某分支已无必要就停止扩展。为此维护两个界:
- $\alpha$:当前搜索上下文中,MAX 已经能够保证的下界;
- $\beta$:当前搜索上下文中,MIN 已经能够保证的上界。
2. 剪枝条件
当 $\alpha\ge\beta$ 时,这条分支再算下去也不能改变祖先节点的相关选择,可以整支剪掉。分节点类型表述更直观:
- MAX 节点 $N$:若某个子节点的倒推值不能使 $N$ 的取值超过已有的 $\alpha$,该子节点以下的剩余子树可以停止搜索;
- MIN 节点 $N$:若某个子节点的倒推值不能使 $N$ 的取值低于已有的 $\beta$,该子节点以下的剩余子树可以停止搜索。
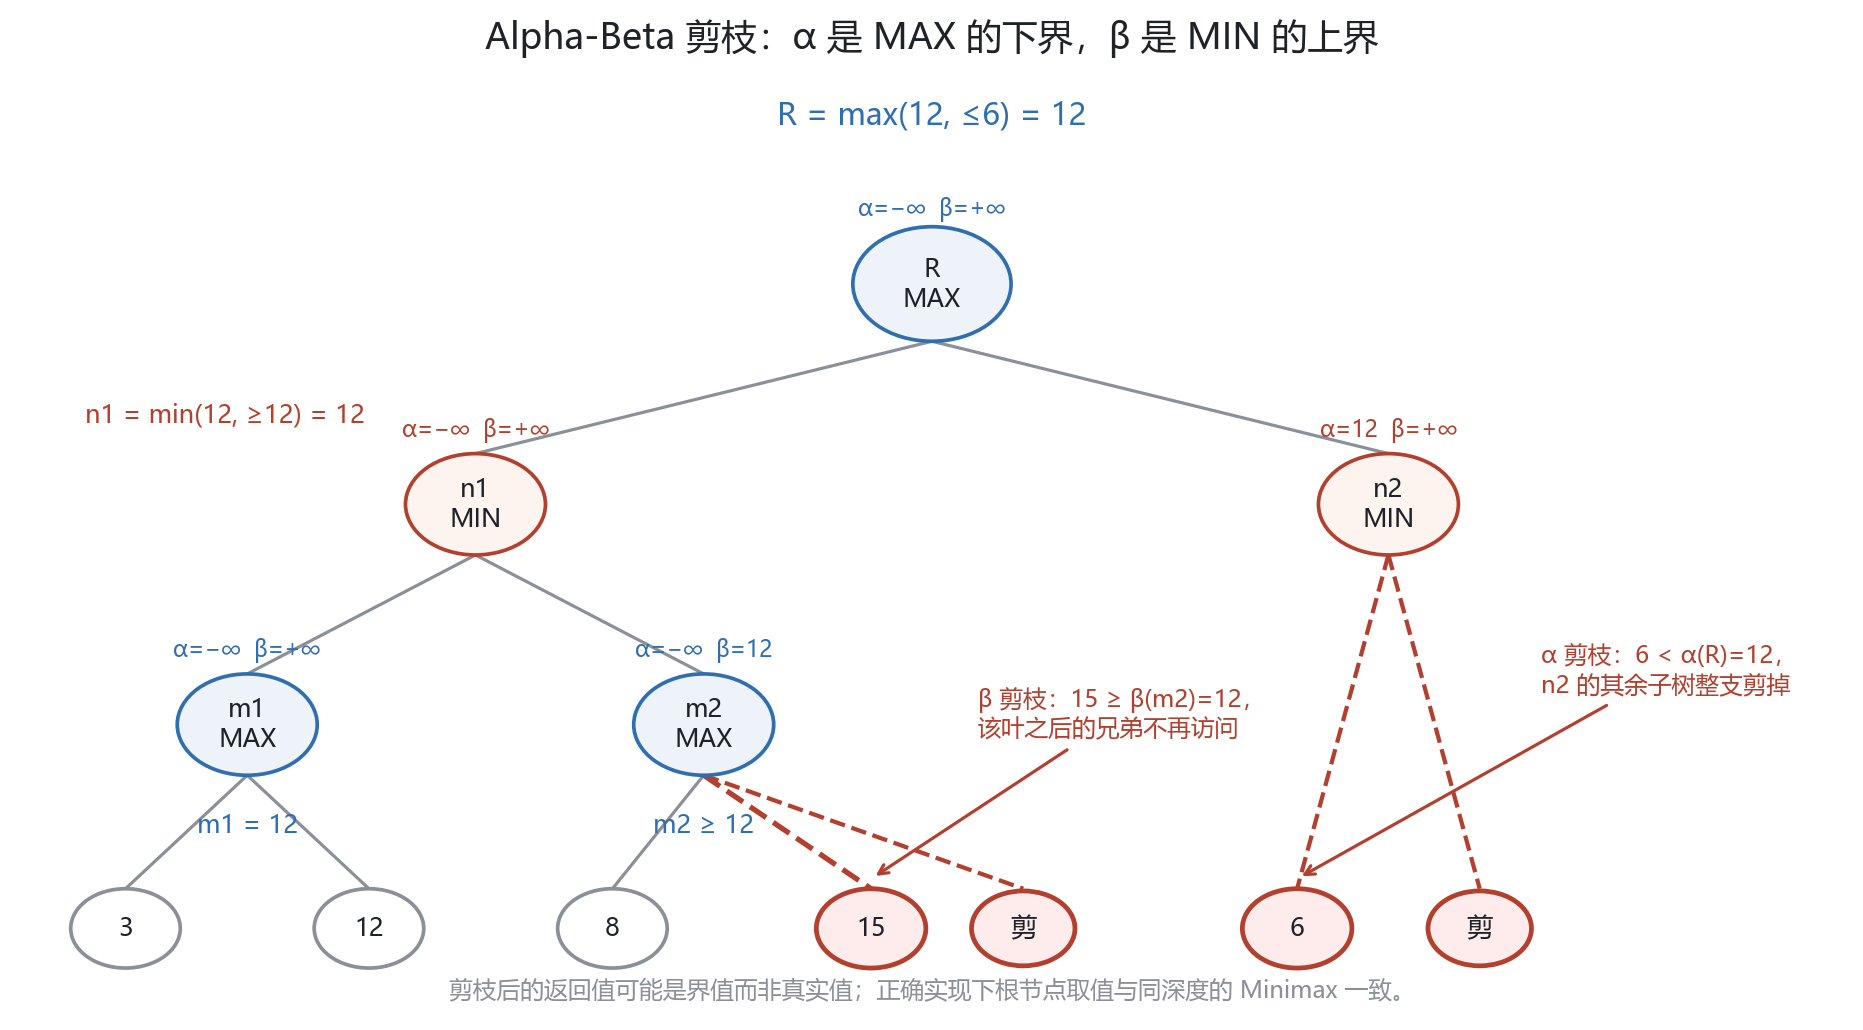
下面这棵自拟的小树把两种剪枝都走一遍。根 $R$ 为 MAX,$n_1$、$n_2$ 为 MIN,$n_1$ 下挂 $m_1$、$m_2$ 两个 MAX 节点。
- $m_1$ 的叶子为 3、12,得 $m_1=12$,于是 $n_1$ 的上界 $\beta(n_1)=12$。
- $m_2$ 继承 $\beta=12$,先看到叶子 8;再看叶子 15 时 $15\ge\beta(m_2)=12$,触发剪枝,$m_2$ 只返回一个不小于 12 的界值,其后的兄弟不再访问。$n_1=\min(12,\ge 12)=12$,于是 $\alpha(R)=12$。
- $n_2$ 继承 $\alpha=12$,第一个叶子就是 6,$6<\alpha(R)=12$,整支剪掉。最终 $R=\max(12,\le 6)=12$。
3. 走法顺序决定收益
剪掉多少取决于子节点的生成顺序:
- MAX 节点若估值最高的子节点最先生成,剪枝最多;
- MIN 节点若估值最低的子节点最先生成,剪枝最多。
这种顺序称为最优 $\alpha$-$\beta$ 剪枝。对于分支因子 $b$、深度 $d$ 的近似均匀树,理想情况下复杂度可从 $O(b^d)$ 降到约 $O(b^{d/2})$,相当于有效搜索深度加倍;最坏情形仍是 $O(b^d)$。“平方根级别”是特定理想口径下的结论,不是每棵树都有的固定收益。
4. 返回值可能是界值
剪枝发生时节点返回的往往只是界值,不是真实倒推值——图 2 中 $m_2$ 返回“$\ge 12$”而不一定是 15。只要实现正确,根节点的取值与同深度、同估价函数下的 Minimax 一致;相同最优值的走法可能因遍历次序不同而选得不同。这一点在把搜索嵌进更大系统时容易出错:中间节点拿到的数不能直接当成该局面的确定评分。
5. 课堂走的更深的例子
课堂上另走了一个更深的例子,剪枝的触发方式与上面一致:从 $S_0$ 出发按深度优先先搜左支;左支第一个孩子已由叶子 4 得到下界 4,而它的另一个孩子是 MIN 节点且已经出现 1,于是那一支被剪掉;左支第二个孩子出现 5 并已达到 $\beta=4$,同样被剪掉;于是左支回传 4 成为 $\alpha(S_0)$。右支的子树被判定不超过 0,小于 $\alpha=4$,整支剪掉,根取左支的值。
同一个“把不重要的东西砍掉”的思路也出现在模型压缩里。课堂举的例子是 DeepSeek 的轻量化:一路是用并联的 Transformer 加路由,让每个领域知识只走其中几路;另一路是剪枝,把一部分参数置零使其不参与计算,计算量与存储量随之下降。搜索里的剪枝砍的是分支,模型里的剪枝砍的是参数,省的是同一种东西。
四、机器学习的定义:T、E、P 与 $Y=f(W,X)$
课件引用 Tom Mitchell 在《Machine Learning》(1997)中的定义:
A computer program is said to learn from experience E with respect to some class of tasks T and performance measure P, if its performance at tasks in T, as measured by P, improves with experience E.
翻译过来:一个程序如果能从经验 $E$ 中学习,并在任务类 $T$ 上以性能度量 $P$ 衡量时表现随 $E$ 改善,就称它学习了。课堂把这个定义拆成四个可指认的部分:
| 符号 | 含义 | 具体例子 |
|---|---|---|
| $T$ | 任务,从 $X$ 得到 $Y$ | 人脸识别输出姓名、翻译中德互转、由人脸输出表情 |
| $E$ | 经验,大量的 $(X,Y)$ 对 | 上亿条输入输出对构成数据集 |
| $P$ | 性能度量,即损失函数 | 比较 $W X$ 与真实 $Y$ 的差距 |
| $W$ | 待学参数 | 训练阶段调节,推理阶段固定 |
于是学习被写成一个拟合问题:
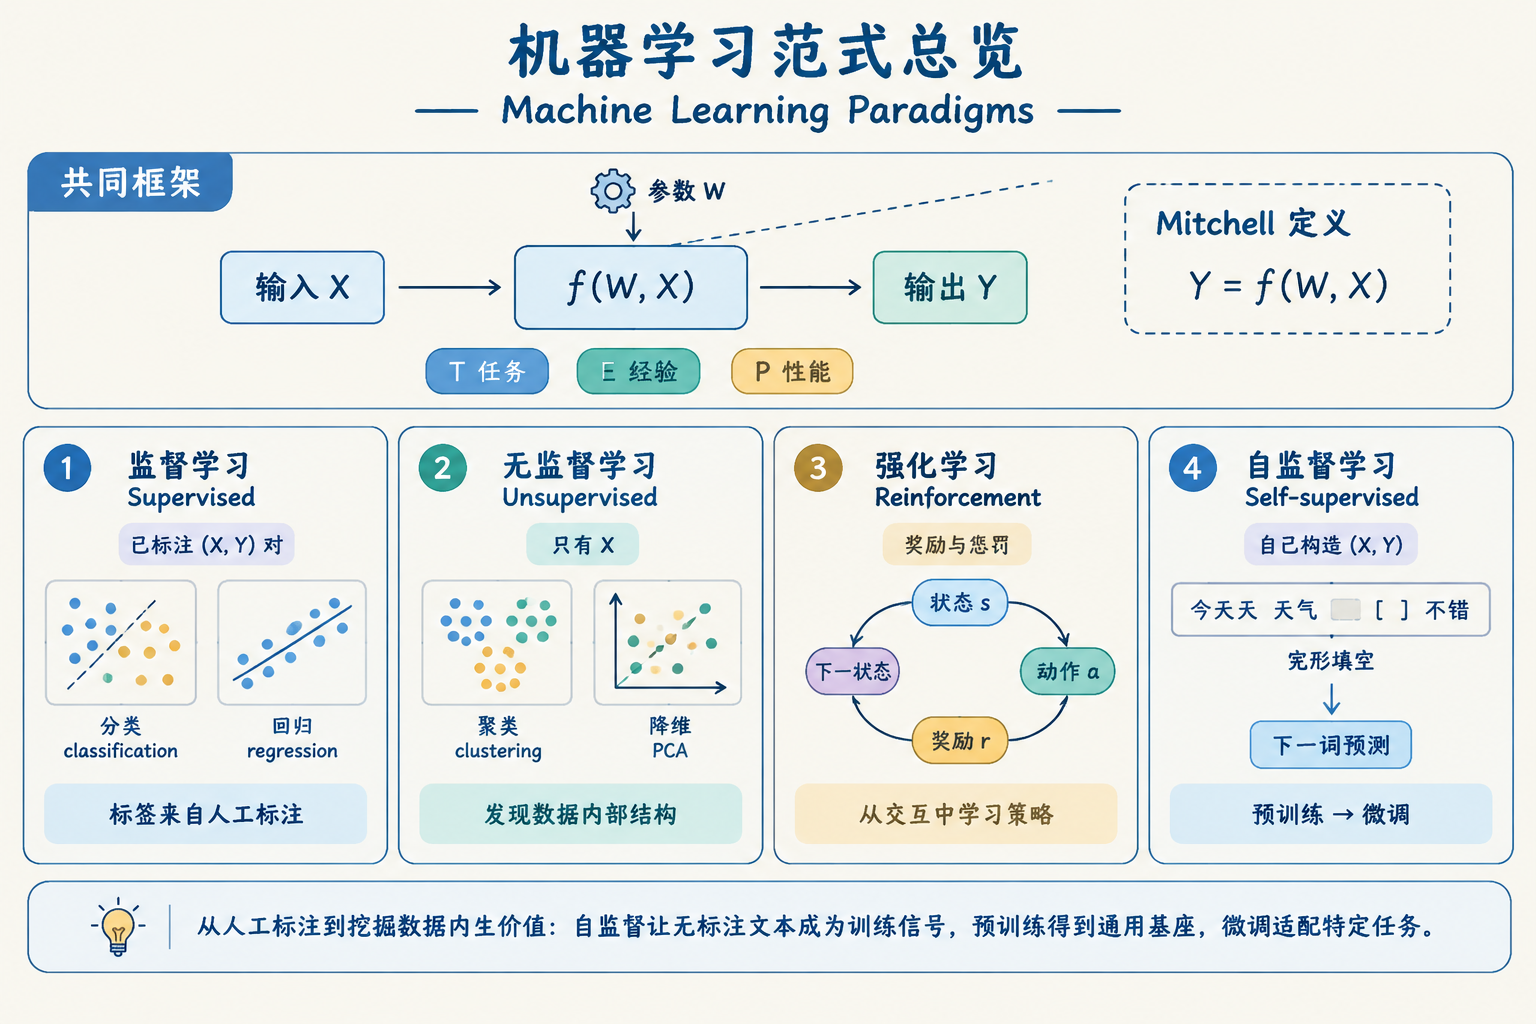
\[Y=f(W,X).\]训练阶段给定 $X$ 与 $Y$,调节 $W$;测试阶段只给新的 $X$,用它算出结果再与真实值比对。课堂把后者称为推理阶段,也叫部署阶段、使用阶段——用人脸识别举例,校内学生都训练过,校外人员没训练过,来了识别不上就说明泛化不到位。
需要说明的是,“训练—测试”这条流水线是当前主流技术的主要形态,但不是全部;课堂特意补了一句,有些模式识别方法完全是规则式的,不能一律归成“学 $W$”。
五、监督学习
1. 分类与回归
给定输入输出对,学习从输入到输出的函数。按输出形式分成两类:
| 任务 | 输出 | 课堂与课件例子 |
|---|---|---|
| 分类 classification | 离散类别 | 是否下雨(二分类)、数字 0–9(多类)、两万名学生的人脸识别(两万类) |
| 回归 regression | 连续值 | 房价预测、快递到达时间预测 |
课件中“是否下雨”的例子把湿度与气压作为两维输入,最后一列是标签;模型要找的是能把两类点分开的界面。Hypothesis(假设)指我们相信或希望与真实函数相近的那个候选函数,训练就是从训练集中实例化一个假设 $h$,测试时对新样本 $x$ 输出 $h(x)$。
2. 从最近邻到线性分类器
- 最近邻分类:给定输入,选离它最近的那个数据点的类别。
- $k$ 近邻分类:选离它最近的 $k$ 个点中占多数的类别。课堂的说法是“物以类聚,人以群分”——不了解一个学生,就看他周围几个学生的类别,用投票定类。
- 线性分类器:在输入空间里找一个超平面。以湿度、气压为例,
把权重组记成 $W=(w_0,w_1,w_2)$,输入组记成 $X=(1,x_1,x_2)$,判断就写成内积 $W\cdot X$。把偏置 $b$ 并进权向量、同时在输入里补一个常数 1 的技巧称为 bias trick,于是 $f(x,W)=Wx+b$ 与 $f(x,W)=Wx$ 可以统一书写。
3. 感知机:用误差更新权重
课件给出的学习规则是
\[w_i\leftarrow w_i+\alpha\,(y-h_w(x))\,x_i,\]其中 $\alpha$ 是学习率,$y$ 是实际值,$h_w(x)$ 是当前估计。误差为正就沿该输入的方向加大权重,误差为负则相反,沿最速下降的方向反复更新,直到分界面稳定。单个神经元配上合适的损失函数就是一个线性分类器,可以实现二分类的 Softmax 或 SVM。
4. SVM:最大间隔
支持向量机取最大间隔分离器,即让边界到任一侧数据点的距离都尽可能大的那条分界线。课件同时提到它可以通过核方法处理非线性问题。
5. 线性分类器的一般形式
把输入看成向量、权重组看成矩阵,就是深度学习里最常见的写法:
\[f(x,W)=Wx+b.\]课件以 CIFAR-10 为例:一张 $32\times 32$ 的彩色图是 $32\times 32\times 3=3072$ 个数(每个数在 0–255 之间,0 黑 255 白),分成 10 类,则输入为 $3072\times 1$,输出为 10 个类别得分,参数量为 $10\times 3072$ 再加 10 个偏置。同一个形式往下推就是多类 SVM 损失与 Softmax 分类器。
6. 过拟合与正则化
假设在训练集上表现很好、在新数据上变差,就是过拟合。正则化的做法是惩罚复杂假设、偏向简单假设:
\[\operatorname{cost}(h)=\operatorname{loss}(h)+\lambda\cdot\operatorname{complexity}(h),\]其中 $\lambda$ 是正则化强度,属于超参数。课件列举的常见手段有权重衰减式的 L2、L1、L1 与 L2 结合的 Elastic Net,以及 Dropout、Batch Normalization、Stochastic depth、fractional pooling 等。
7. 监督学习的两个现实困难
一是需要标注数据,标注本身有成本;二是它依赖一个关键假设——训练样本与测试(未来)样本同分布。课件明确指出,真实应用中这个假设经常被违反,这是该领域的常见挑战之一。
六、损失函数:把差距变成可优化的数
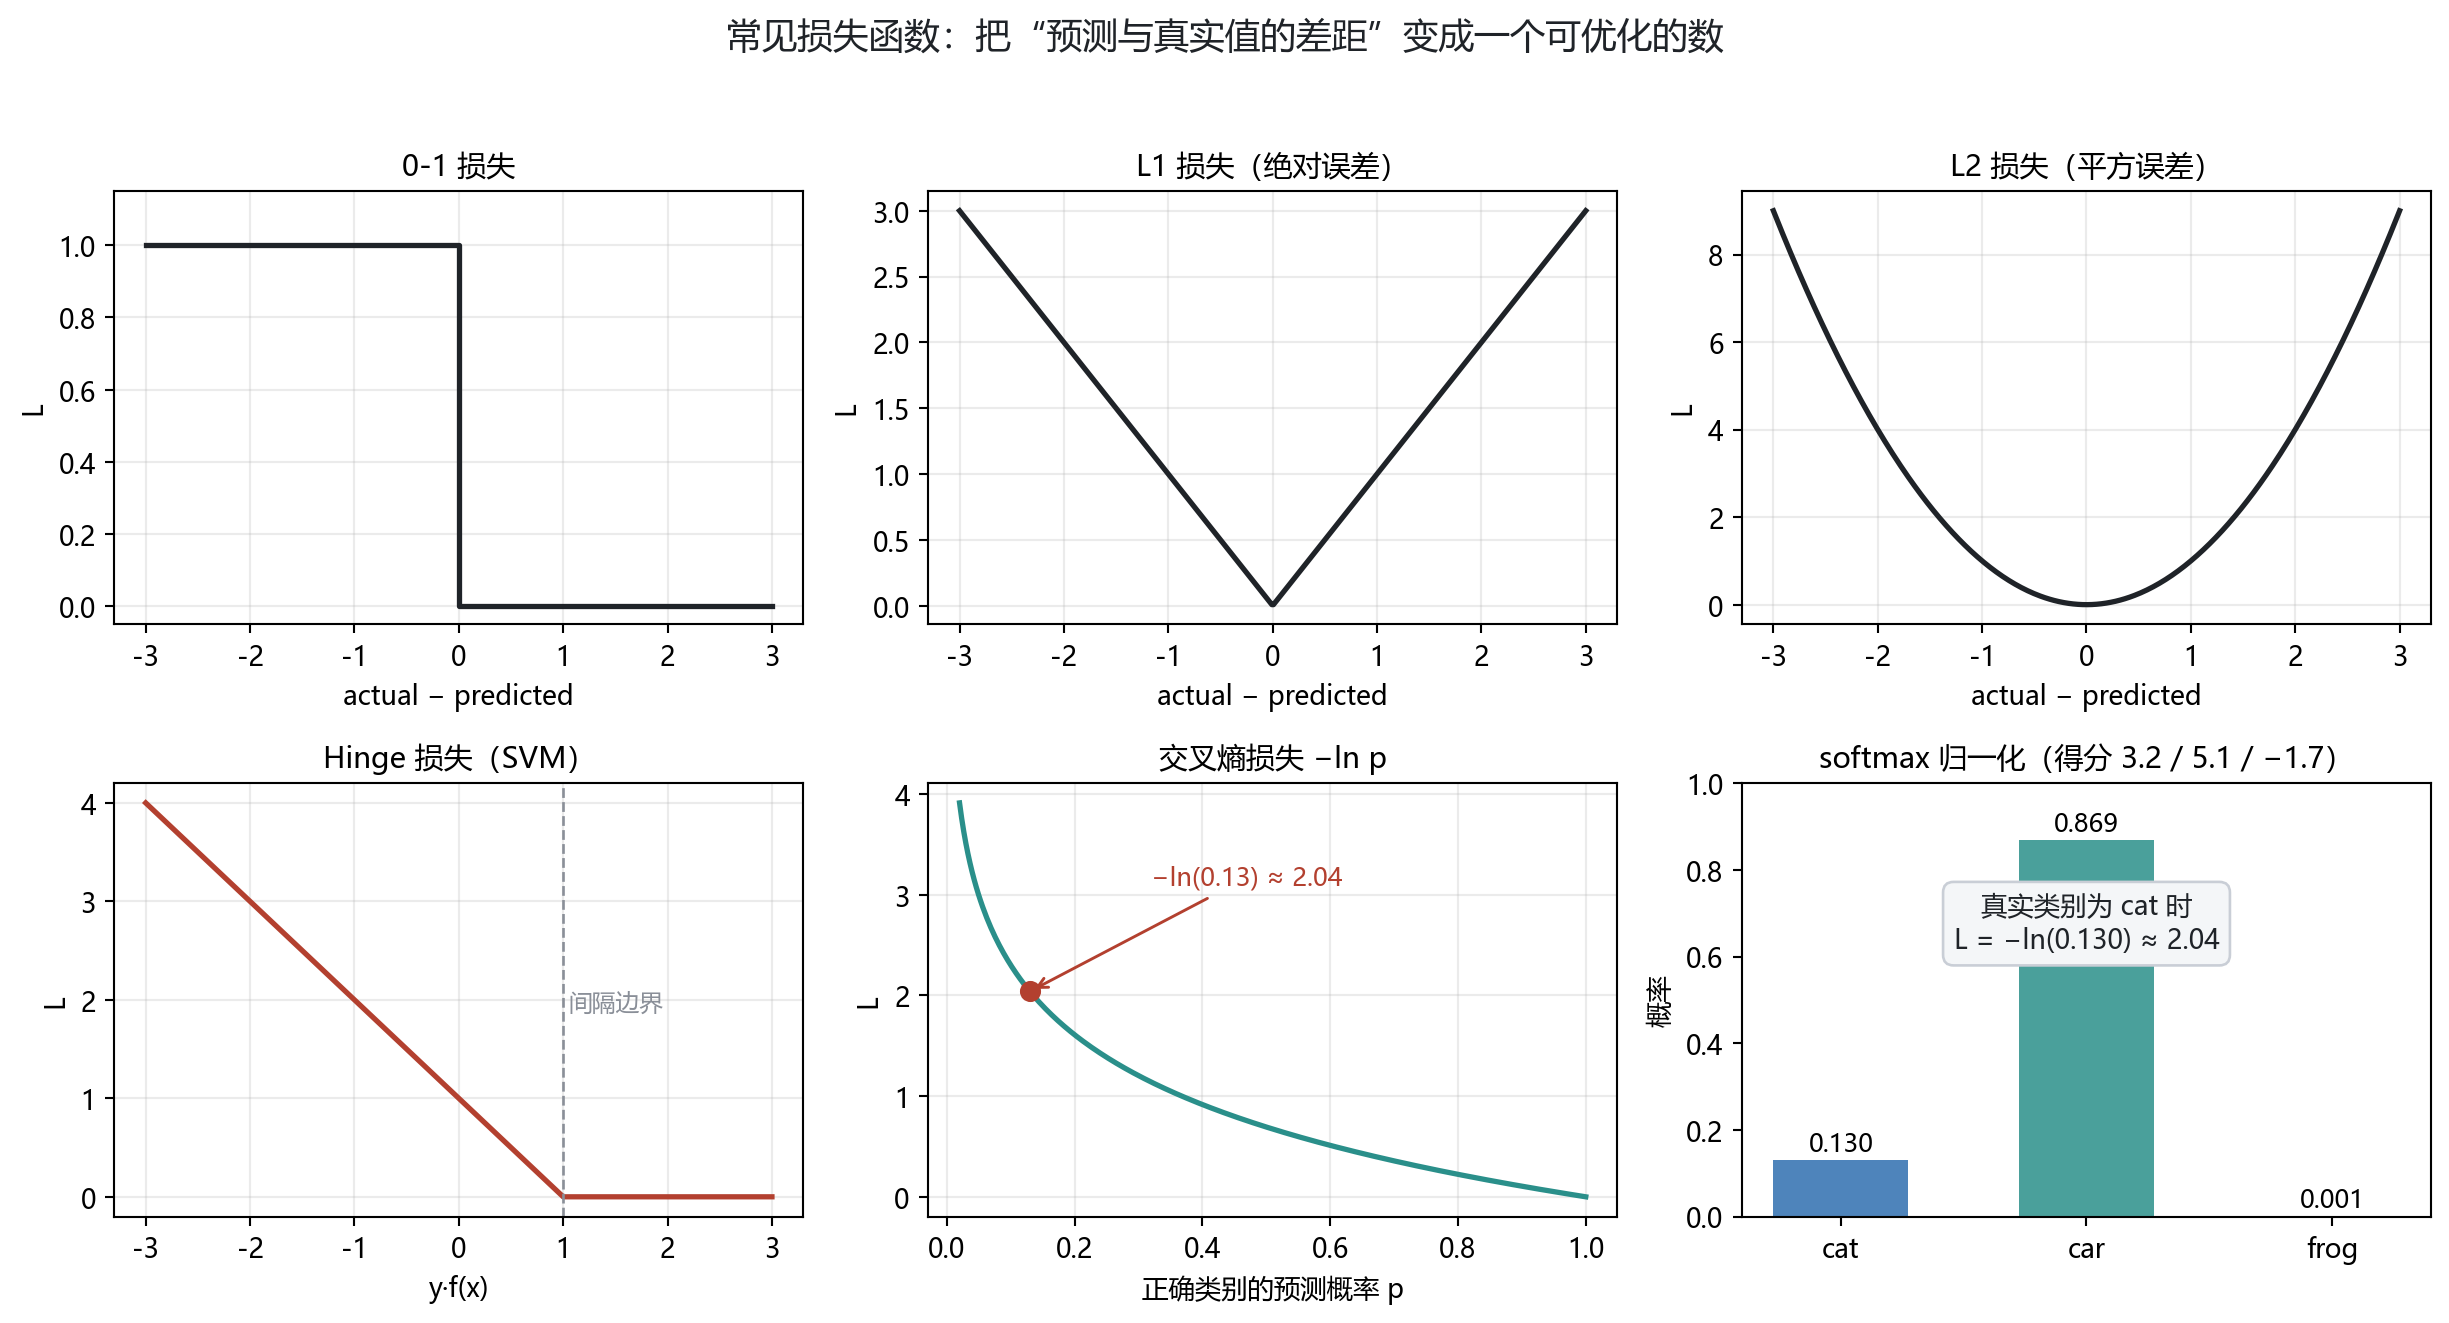
损失函数衡量一组参数 $W$ 有多好:依据是它产生的分数与训练数据中真实标签的一致程度。损失高表示做得差,低表示做得好。常见形式如下,横轴统一取“实际值 − 预测值”(hinge 取 $y\cdot f(x)$):
| 损失 | 形式 | 特点 |
|---|---|---|
| 0-1 损失 | 预测正确取 0,否则取 1 | 不可微,难以直接优化 |
| L1 损失 | $L=\lvert \text{actual}-\text{predicted}\rvert$ | 对离群点不如 L2 敏感 |
| L2 损失 | $L=(\text{actual}-\text{predicted})^2$ | 课堂说明:假设误差服从高斯分布 |
| Hinge 损失 | $L=\max(0,\,1-y\,f(x))$ | 多类 SVM 使用,只有进入间隔内才计损失 |
| 交叉熵损失 | $L=-\ln P_W(y_i\mid x_i)$ | 分类任务主流,与 Softmax 配合 |
Softmax 先把得分转成概率:
\[P_W(c\mid x_i)=\frac{e^{s_c}}{\sum_j e^{s_j}}.\]概率必须非负且总和为 1。以得分 3.2、5.1、−1.7 三类为例,归一化后约为 0.130、0.869、0.001;若真实类别是第一类,则 $L_i=-\ln(0.130)\approx 2.04$。课件该页写作 $-\log(0.13)=0.89$,与自然对数不符,此处按常用定义取自然对数。
七、无监督、强化与自监督
1. 无监督学习
只给输入 $X$、不给任何额外反馈,从数据内部找规律。两种典型任务:
- 聚类:把对象分组,使相似的对象倾向于落在同一组。$k$-means 反复做两件事——把点指派到簇、更新簇中心。应用包括基因研究、图像分割、市场研究、社交网络分析。
- 降维:课件以 PCA 为例,做特征分解后取最大特征值对应的特征向量保留,其余扔掉,数据维度随之降低。
课堂对这段历史的评价是:PCA 与聚类是 2005 年之前最热门的方法,如今作用已相当有限。这是授课教师的观点,用来说明技术热点的迁移,不等于 PCA 与聚类在今天没有用途——课件自己也列出无监督学习的两个用途:数据探索与发现,以及为下游监督学习提供表示。
课件还区分了两个容易混的概念:
- 自监督学习:依靠只用无标注数据就能构造的代理任务(pretext task)来学习的一般框架;
- 半监督学习:同时使用有标注与无标注样本的一类算法,通常假设两类样本来自相同或相近分布。
2. 强化学习
给定奖励或惩罚,学习未来该采取什么动作。课件的模型是马尔可夫决策过程,由四部分构成:
| 组成 | 含义 |
|---|---|
| 状态集 $S$ | 环境可能处于的情形 |
| 动作集 $\mathrm{Actions}(s)$ | 状态 $s$ 下可执行的动作 |
| 转移模型 $P(s’\mid s,a)$ | 执行动作后到达下一状态的概率 |
| 奖励函数 $R(s,a,s’)$ | 该步获得的回报 |
Q-learning 学一个函数 $Q(s,a)$,估计在状态 $s$ 执行动作 $a$ 的价值,初始化为 0,每次交互后更新:
\[Q(s,a)\leftarrow Q(s,a)+\alpha\bigl(r+\gamma\max_{a'}Q(s',a')-Q(s,a)\bigr).\]行动时以概率 $1-\varepsilon$ 选当前估计最好的动作,以概率 $\varepsilon$ 随机选一个,用于平衡探索与利用。状态-动作对太多时,改用函数逼近(把若干特征组合成函数)而不是为每一对存一个值。课堂强调前两类是静态的,强化学习要从动态交互中学习。
3. 自监督学习:大模型时代的主流范式
只给 $X$、不给 $Y$,就自己从数据里构造 $(X,Y)$ 对。课堂举了几种构造方式:把一句话做完形填空;用新闻的正文作 $X$、标题作 $Y$;图片与其描述文字配对;甚至用“左耳朵当 $X$、右耳朵当 $Y$”这类自身部件互为输入输出的做法,类似左右手自我博弈。
互联网上几十 T 的文本没有标注,但可以从中自动生成大量 $(X,Y)$ 对,预训练得到一个通用的基座模型。课堂对这个结果的描述是“中庸”——它不能直接面向特定任务;要面向特定任务,还需要用该任务的 $X$ 与 $Y$ 再做一遍监督式微调。按经典分类,预训练属自监督,微调属监督,两者串起来才是大模型的常见训练流程。
从监督到自监督的变化,本质上是标注的来源从人变成了数据本身。
八、课件延伸:神经网络与深度网络
以下三份课件为后续课程的主体内容,本次课堂只在结尾作了引出。此处按课件整理,作为预习与查阅材料;课堂未逐页讲授的部分不表示为当天已完成。
1. 单个神经元
人工神经网络是对生物神经网络的简化模拟。生物神经元由树突接受传入信息,经细胞体整合后沿轴突传到末梢,通过突触把信号交给下一个神经元。人工模型里,每个输入相当于树突接受的外部刺激,连接权重相当于带权轴突,输出相当于轴突末梢传递的信息;网络分为输入层、输出层与若干隐层。
一个神经元做两件事:对前一层各输入加权求和,再经激活函数判断是否“兴奋”输出。课件同时提醒,加权求和部分与激活判断部分的命名在不同教材中不一致(transfer function / activation function / output function 混用),阅读时以具体公式为准。
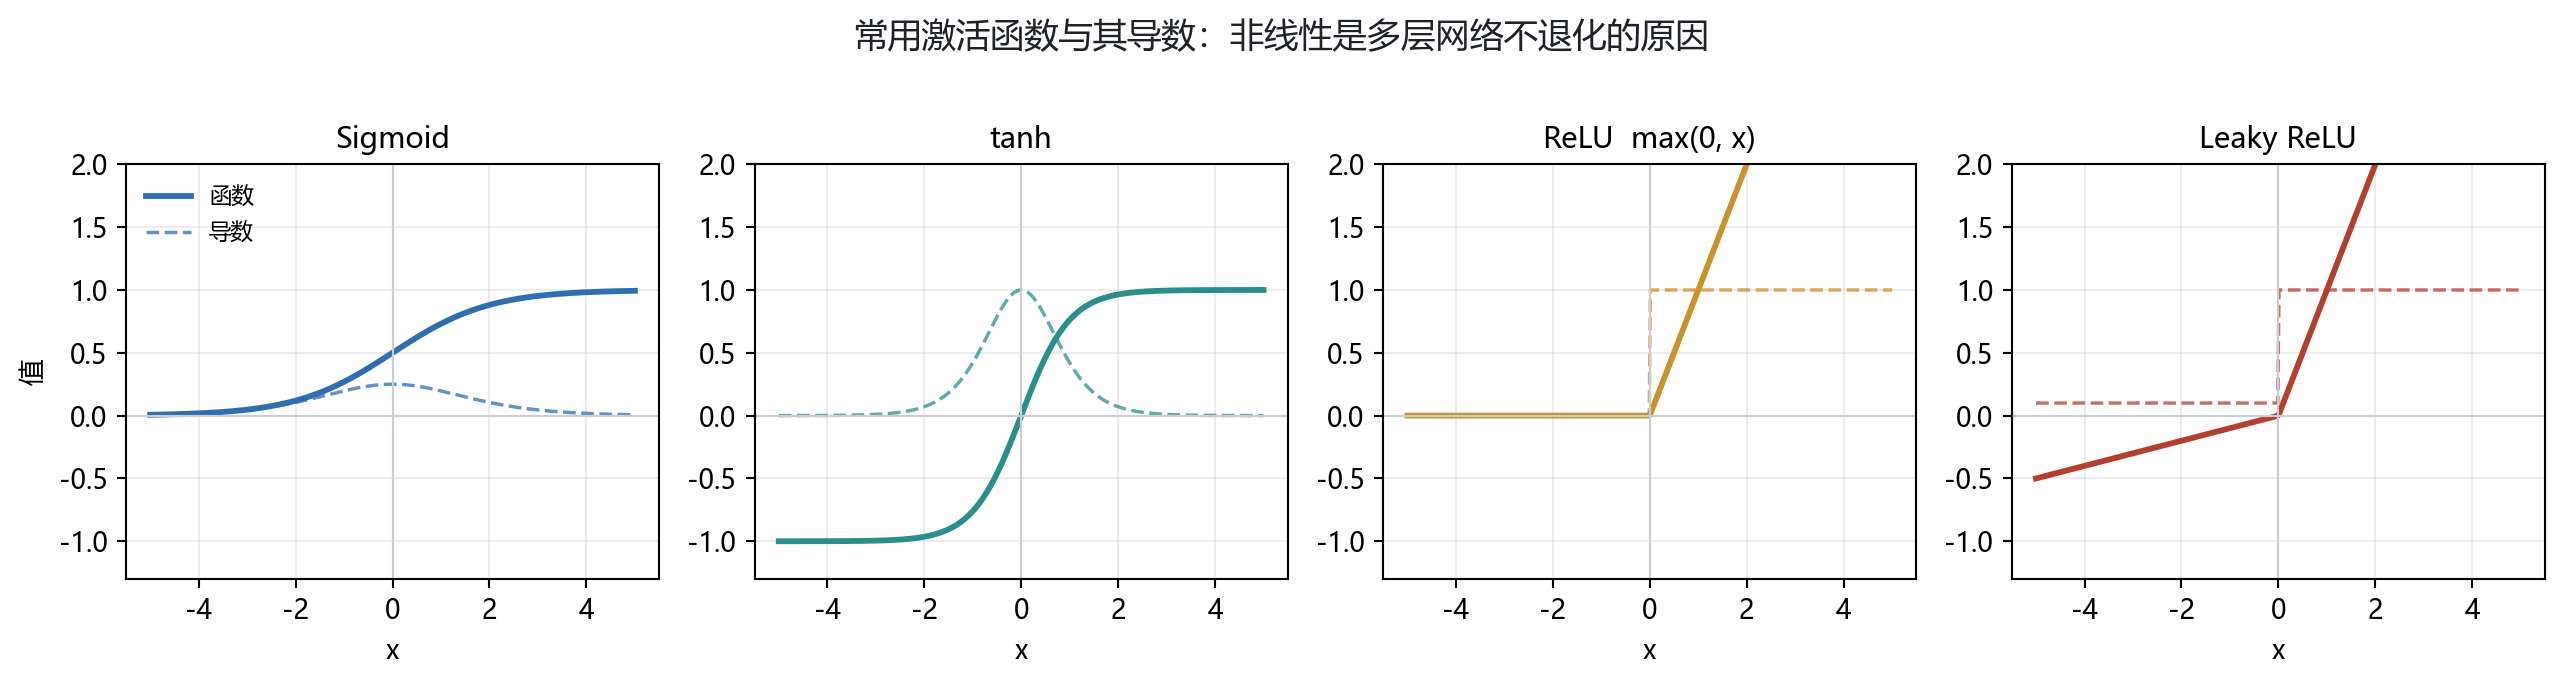
2. 激活函数与非线性
| 激活函数 | 形式与范围 | 主要问题 |
|---|---|---|
| Sigmoid | $\sigma(x)=1/(1+e^{-x})$,压到 $[0,1]$ | 饱和区梯度消失;输出非零中心;$\exp$ 计算开销 |
| Tanh | $\tanh(x)=2\sigma(2x)-1$,压到 $[-1,1]$ | 零中心,但饱和时同样杀死梯度 |
| ReLU | $f(x)=\max(0,x)$ | 正区不饱和、计算高效,课件称实践中收敛可比 sigmoid/tanh 快约 6 倍;输出非零中心 |
| Leaky ReLU | 负区给小斜率 | 不饱和、不会“死” |
| ELU | 负区指数饱和 | 兼有 ReLU 好处,输出更接近零均值,对噪声更稳健 |
| Maxout | 取若干线性组合的最大值 | 推广 ReLU 与 Leaky ReLU,但参数量翻倍 |
没有激活函数引入的非线性时,一个神经元等价于线性分类器,多层网络等价于单层网络。这是多层结构必须配非线性的直接原因。
3. 全连接前馈网络与训练
相邻两层之间两两全连接,同一层内不设连接。训练分三步:前向计算得到输出与损失;把误差沿计算图反向传播,用链式法则求每个参数的梯度;按梯度反方向更新参数。
计算图里几种门的梯度模式值得单独记:加法门是“梯度分配器”,把上游梯度原样分给各支路;乘法门是“梯度切换器”,把上游梯度乘以另一侧的取值;最大值门是“梯度路由器”,只把梯度送给取得最大值的支路。反向传播在向量与矩阵情形下要注意维度:直接推导误差信号、避免显式构造巨大的局部导数,保持索引约定一致,并用维度分析自查。
4. 表达能力:宽度与深度
具有全连接层的神经网络定义了一族由权重参数化的函数。至少有一个隐层的网络是通用逼近器,在隐层神经元足够多时可以逼近任意连续函数。但“能逼近”不等于“好用”:Eldan 与 Shamir 在 COLT 2016 的工作给出例子,某个三层网络可表达的函数,二层网络除非宽度随维度指数增长否则无法逼近。深度带来的是另一种效率,不是通用逼近性的必要条件。
课件还提到特征可视化:卷积网络从低层边缘、中层部件到高层任务相关表示的层次,各层联合训练,逐层从上一层输出中提取特征。
5. 卷积网络与后续架构
卷积层用卷积核在输入上滑动,需要四个超参数:卷积核个数 $K$、核尺寸 $F$、步幅 $S$、零填充 $P$。输入 $W_1\times H_1\times C$ 经卷积得到 $W_2\times H_2\times K$,其中
\[W_2=\frac{W_1-F+2P}{S}+1,\qquad H_2=\frac{H_1-F+2P}{S}+1,\]参数量为 $F^2CK$ 加 $K$ 个偏置。彩色图有多个输入通道时,每个通道各用一个核,再把各通道结果相加。$1\times 1$ 卷积不识别空间模式,只融合通道,等价于一个输入输出维度给定的全连接层。池化层分最大池化与平均池化,无可学习参数,逐通道作用,输出通道数等于输入通道数。
架构演进的主线:
| 网络 | 年份 | 关键点 |
|---|---|---|
| LeNet | 1998 | 卷积块加平均池化,$5\times5$ 核、$2\times2$ 窗、步幅 2 |
| AlexNet | 2012 | 更大更深的 LeNet;ReLU、Dropout、数据增强;参数量约为 LeNet 的 11 倍,计算量约 250 倍 |
| VGG | 2014 | 重复使用 $3\times3$ 卷积(pad 1)加 $2\times2$ 最大池化构成 VGG 块 |
| NiN | 2013 | 用 $1\times1$ 卷积与全局平均池化替代全连接层,缓解最后一层的参量负担 |
| GoogLeNet | 2014 | Inception 块四条支路并行,沿通道拼接;5 个阶段 9 个 Inception 块 |
| ResNet | 2015 | 残差连接,使极深网络可训练 |
课件对这一段的小结是:AlexNet 与 VGG 说明更大更好;GoogLeNet 开始关注效率;ResNet 解决了极深网络的训练;此后重点转向高效网络与移动端小网络,架构设计也可由神经架构搜索自动完成。
6. 序列模型
数据不总是独立同分布,还可能按顺序到来,甚至需要把序列续写下去,这对应循环神经网络。RNN 按时间步维护隐状态并向前传播,反向传播要穿过整个序列,称为 BPTT。普通 RNN 结构简单但效果有限,梯度反向流动时可能爆炸或消失:爆炸可用梯度裁剪控制,消失则靠加性交互的门控结构缓解。LSTM 设置遗忘门、输入门与输出门,门控信号通常取 sigmoid(值在 0 与 1 之间,模拟开合);GRU 结构比 LSTM 更简单。课件的结论是:只要遗忘门保持打开,记忆与输入以相加方式进入,影响就不会消失。
7. 框架
课件最后留了一张深度学习框架的对比页,本次未展开。
九、课程安排
课堂开头用了一段时间讲小组分享的安排,转写中可确认的部分如下:建议每组 4–5 人,总组数控制在 20 组以内,系统登记约 15 组;第三周确定分组与选题并填入系统表格,两组选题重复的需要分开;每组准备约半节课时间,讲一篇最新论文。可选方向包括搜索算法进阶(AlphaGo 系列)、强化学习、Transformer 架构与智能体应用。授课教师同时提到,跨学科背景同样能做出成果,学校已有中文、体育、化学、物理等方向的模型尝试。
具体论文清单、登记入口与截止时间在转写中不够明确,此处不代为确认。