· Jev / TypeSafe / 决策模型 / 概率校准 / AI前沿
Jev:从聊天模型到软件决策模型
RedMoon · 资料截至 2026 年 9 月 24 日。本文讨论 TypeSafe AI 的 Jev。
假设一家网店收到一封邮件,顾客说商品发错了,希望换货。客服系统首先得判断:这封邮件该交给谁?它可能还要检查订单号是否齐全、要不要人工介入。
Jev 就是用来做这类判断的 AI 模型。开发者给它邮件内容,再列出“物流、付款、退换货”等选项,它返回所选部门和各选项的概率。程序拿到结果,就能把邮件分过去。这类直接决定软件下一步操作的模型,称为“决策模型”。[1][2]
聊天模型通常围绕“怎样回答用户”组织输出,Jev 则把选择、评分和是非判断做成了专门的接口。这里的“接口”,就是程序向模型提交问题、接收结果的方式。Jev 适合处理大量重复的短判断;写长文、展开解释等任务,仍有生成式模型的位置。[1][2]
一、Jev 从哪里来
Jev 由 TypeSafe AI 开发。这家公司成立于 2024 年,创始人为 Diogo Almeida、Erik Gafni 与 Sasha Sheng。2026 年 9 月 15 日,公司公开亮相,宣布获得由 DCVC 领投的 4,000 万美元种子轮融资,并向部分用户开放 Jev 的早期访问。[1][3]
发布前,团队在《The Bitterest Lesson》中提出了一个问题:训练模型去做的事,和产品实际需要它做的事,是否一致?例如,客服系统要的是“把邮件分给哪个部门”,模型却可能花费时间生成一整段分析。团队认为,应该先选好训练任务,再讨论算法、数据和算力。[4]
| 时间 | 公开进展 | 具体内容 |
|---|---|---|
| 2024 年 | TypeSafe AI 成立 | 开始公司的发展历程 |
| 2026-09-10 | 《The Bitterest Lesson》 | 讨论为什么要先选对训练任务 |
| 2026-09-15 | Jev 亮相,公布融资 | 受限早期访问 |
| 2026-09-16 | Vercel AI Gateway 接入 | 增加调用渠道 |
| 2026-09-17 | LangChain 公布集成 | 在开发工具中接入分类与自动任务判断 |
| 2026-09-18 | OpenRouter 标注 Jev 1.13 发布 | 这是该平台的版本日期;Jev 已于 15 日亮相 |
| 2026-09-21 | LangSmith Evals 宣布支持 Jev | 可以用它评估 AI 应用的输出;同日已有应用预印本 |
上表按公司、投资方和各平台的公告整理。预印本是研究者先公开的论文版本,公开时间与正式同行评审的接收时间是两回事。[3][4][5][6][7][8]
TypeSafe 把这类模型称为“System One”,借用了人类快速判断与仔细推理的区分。这个名称表达的是产品分工:快速模型负责分派任务、分类和筛选,复杂推理与长文本由其他模型处理。它没有描述模型的人类意识结构。[2]
二、Jev 能回答哪三种问题
使用 Jev 时,要提交待判断的材料 state,以及问题 questions。材料可以是一段文字,也可以按字段分好,例如把邮件标题和正文分别存放。JSON 就是这样一种用字段名称组织数据的格式,程序很容易读取。[9]
问题有三种基本形式,官方称为“原语”。用普通话说,就是选一项、打一个分,以及判断一件事是否成立。[10][11][12]
Choice:做选择题
客服邮件该交给物流、付款还是退换货部门,就可以用 Choice。开发者列好选项,并解释每个选项负责什么。Jev 返回选中的类别 choice、各选项的概率 probabilities,以及后面会讲到的 confidence。当前最多可列 255 个选项,选项名称和说明都会影响结果。[10]
下面是一组便于说明的假设结果。$P$ 表示概率,0.75 就是 75%:
\[P(\text{物流})=0.10,\quad P(\text{付款})=0.15,\quad P(\text{退换货})=0.75.\]按这组结果,概率最高的是“退换货”。程序可以据此分派邮件,也可以在误分代价较高时交给人工确认。
Choice 要求模型从给定选项中作答,这就是“类型约束”在这里的作用。它保证答案的形式符合要求,至于部门选得对不对,还得看判断本身。如果有些邮件无法归入现有部门,就应增加“其他”或“信息不足”。否则模型只能在几个不合适的选项里选一个。
Score:按写好的标准打分
Score 先要求开发者写清每一档是什么意思,再根据各档的概率计算平均分。可以设置 2 至 10 档,编号从 0 开始。[11]
例如,给搜索结果打相关性分数,可以把 0 分定为“无关”,1 分定为“部分相关”,2 分定为“直接回答问题”。模型先判断每一档有多大可能,再把档位分数乘以相应概率,最后相加。数学上,这叫“期望”或“加权平均”。写成公式就是:
\[s=\sum_{k=0}^{K-1}k\,p_k.\]$K$ 是档数,$k$ 是某一档的编号,$p_k$ 是落在这一档的概率。假设三档概率分别为 $(0.10,0.30,0.60)$,计算过程是:
\[s=0\times0.10+1\times0.30+2\times0.60=1.50.\]结果是 1.50,位于“部分相关”和“直接回答问题”之间。这套三档标准的分数范围是 $[0,2]$。如果程序希望统一用 0 到 1 表示分数,就除以最高分 2,得到 $s/(K-1)=0.75$。这一步叫“归一化”,相当于换了一套分数刻度;0.75 仍然是评分,不能读成“有 75% 的概率答对”。
分数必须和标准一起看。“内容是否相关”“有没有直接证据”“风险有多高”,问的是不同事情。即使都使用 0 到 2 分,也不能只写一个笼统的“质量分”,让模型自己猜标准。
Noul:回答“是不是”
对于“用户是否明确要求退款”这种问题,Noul 返回“是”的概率,数值在 0 到 1 之间。它没有单独的 confidence 字段。[12]
noul=0.02 的意思是,“明确要求退款”的可能性只有 2%,模型很倾向于回答“否”。接近 0.5 时,才是“是”和“否”难以区分。因此,小数值并不总表示模型没把握,得先看它回答的是什么问题。“需要人工复核”和“无需人工复核”方向相反,程序要按实际问题解释结果。
| 类型 | 问题示例 | 返回什么 |
|---|---|---|
| Choice | 交给哪个部门? | 部门、各选项的概率、confidence |
| Score | 这份搜索结果有多相关? | 按等级算出的平均分、各档概率、confidence |
| Noul | 用户明确要求退款了吗? | “是”的概率 |
上表对应三种接口的字段定义。Choice 的选项概率、Score 的评分和 Noul 的“是”的概率,各有各的含义。[10][11][12]
三、从一次请求理解执行方式
下面把开头的换货邮件写成一次请求。英文邮件的意思是“收到了错误的商品,希望换货”。state 装邮件,instructions 写问题,criteria 列出部门和职责。代码示例没有实际请求服务;正式使用时,通过 POST /v1/systemone 提交,并按文档附上验证调用身份的凭证。[9]
{
  "model": "jev-1.13.0",
  "state": {
    "ticket": "I received the wrong item and would like a replacement."
  },
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "shipping": "Tracking, delivery delays, or missing packages",
        "billing": "Charges, invoices, or payment errors",
        "returns": "Wrong items, exchanges, or replacements",
        "other": "Insufficient information or none of these teams"
      }
    }
  }
}
department 是开发者给这道题起的名字,方便程序在返回结果中找到它。模型依据邮件、问题和选项说明作答,这个题目编号本身不参与判断。[9][10]
同一封邮件还可以一起问:用户想怎么处理?是否缺少订单号?商品是否损坏?这些问题共享一份 state,可以同时计算。这就叫“并行”。如果逐题发送、等上一题返回再发下一题,就是“串行”,会多次等待网络往返。[13]
每道题都根据同一份材料独立回答,不会自动读取其他题的答案。比如,退款判断需要订单状态,就得先查数据库,把查到的内容加进 state;也可以等前一步完成,再发起下一次请求。
官方把“把接下来可能用到的问题一起问,再由程序选用结果”称为 speculative fan-out。这样能减少等待,但每道题仍会增加输入量。模型按 token 处理文字,token 可以先理解为切分后的文字单位,它与汉字数或英文单词数并不一一对应。[13]
四、它怎样判断,“有把握”又是什么意思
训练时关注的是判断和概率
Jev 直接针对给定的候选答案输出概率,省去了“先生成解释,再从解释里提取答案”的环节。官方把训练方向称为 RLCD,全称是 Reinforcement Learning for Calibrated Decisions,可译为“面向校准决策的强化学习”。它关注判断是否合适,也关注报出的概率是否可靠。[1][14]
强化学习通过反馈调整模型的行为;“校准”则关系到模型报出的概率,下一节会用例子解释。官方资料讲到了训练目标,但截至资料日期,本文查到的材料还不足以还原完整训练过程:包括使用什么基础模型、具体怎样奖励和更新,以及训练好的模型参数。下面能展开讲清的是接口和概率原理。
以选择题为例,材料、问题和候选项交给模型后,会得到每个选项的概率,这些概率加起来为 1。可以把这个输入输出过程记成:
\[f_\theta(x,q,C)\longrightarrow(p_1,\ldots,p_K), \qquad \sum_{k=1}^{K}p_k=1.\]其中 $x$ 是材料,$q$ 是问题,$C$ 是候选或评分标准,$p_1$ 到 $p_K$ 是各选项的概率。$f_\theta$ 只是“经过训练的模型”的数学记号。这行公式用来说明接口做了什么,不涉及内部网络的具体结构。
想研究训练代码,可以看社区的 eve-rlcd 项目和模型说明。它探索了类似方向,作者也明确说明:这套实现是社区自己的方案,没有声称重现 TypeSafe 的训练方法。[15]
概率校准究竟是什么
假设有一批待判断的邮件,模型对其中一组都报出约 80% 的退款概率。之后核对实际内容,约 80% 的确实要求退款,那么这组概率就比较准。这里要核对的是大量相似任务中的实际比例,单看一封邮件无法判断模型是否校准。[16]
“概率校准”说的就是:报出多少概率,长期核对后就应有多大比例成立。理想情况下,可以写成:
\[\mathbb{E}[Y\mid \hat p=p]=p.\]公式里的 $\hat p$ 是模型报出的概率,$Y$ 是实际结果:成立记为 1,不成立记为 0。把同一概率附近的实际结果取平均,就得到它们真正成立的比例。公式要求这个比例与预测概率一致。
这和准确率有区别。准确率问“选对了多少次”,校准问“概率报得准不准”。一个模型可能多数时候选对,却经常把七成的可能性说成九成九;另一个模型概率报得更准,选对的总次数却未必更多。
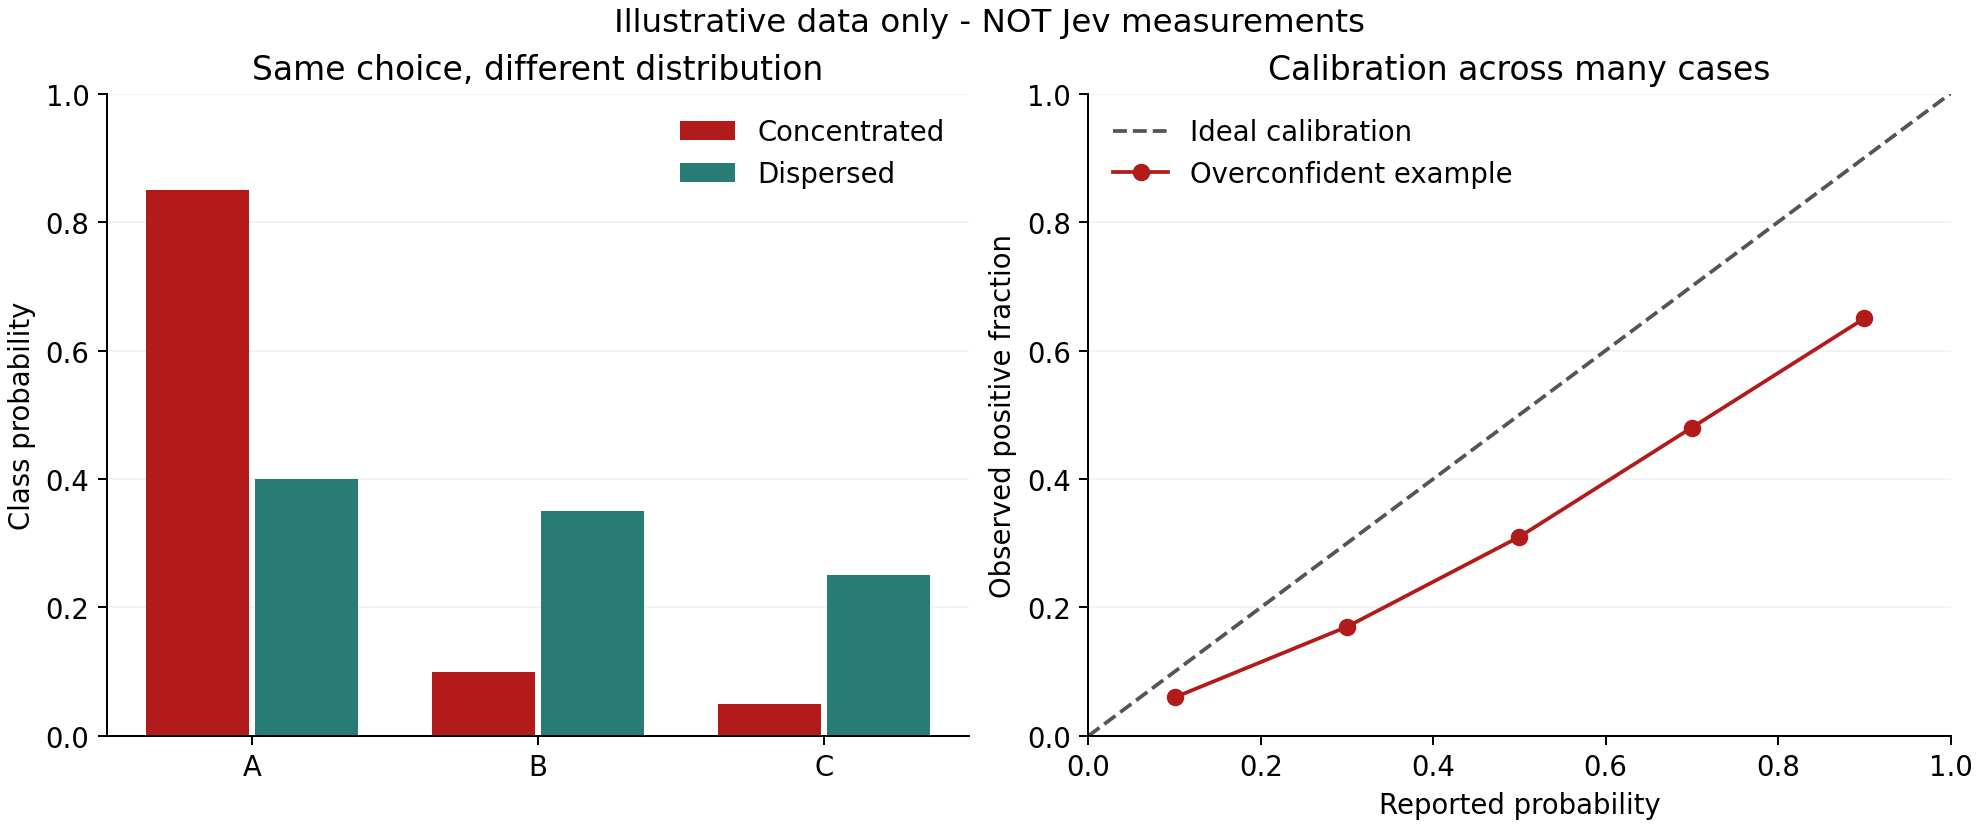
图中使用教学数据,并非 Jev 实测。左图两组结果都选 A,红色给 A 85%,绿色只给 A 40%。右图横轴是模型报出的概率,纵轴是核对后实际成立的比例;越贴近虚线,概率就越准。红线低于虚线,表示模型报高了。
右边这种比较方式叫“可靠性图”。研究者还会计算校准误差,把预测概率与实际比例之间的差距汇总成一个数。经典论文讨论过“温度缩放”等方法,用训练之后的调整改善概率。这里介绍的是通用背景,Jev 是否采用这一步并未得到确认。[16]
训练或评估时,也可以对概率本身打分。例如 Brier score:用预测概率减去实际结果,把差值平方,再对所有样本取平均。公式是:
\[\mathrm{BS}=\frac{1}{N}\sum_{i=1}^{N}(\hat p_i-y_i)^2.\]这里 $N$ 是样本数,$\hat p_i$ 和 $y_i$ 分别是第 $i$ 个样本的预测概率与实际结果。这种算法会对“判断错了,还报得特别确定”的情况扣更多分,Brier score 越小越好。[17]
它属于 proper scoring rule,也就是“适当评分规则”。严格适当的评分规则有一个理论性质:如实报告概率,长期平均得分最好。训练数据有限、模型能力有限时,最终表现仍要实际检验。Brier score 在这里用于解释怎样评价概率,官方没有据此公开 Jev 的具体训练损失。[17]
confidence 又是什么
Choice 和 Score 还会返回 confidence,通常译为“置信度”。它把一整组概率概括成一个数:概率集中在哪些选项、不同等级相隔多远,都可能影响这种概括。Choice 与 Score 的具体解释有所不同。[18]
这个数来自已经得到的概率分布,没有另一个独立模型再去核查“答案到底对不对”。所以,拿它决定哪些邮件自动处理、哪些转人工之前,需要在自己的材料上测试。设定一道分界值后,要同时看自动处理了多少、其中错了多少,并固定语言、任务和模型版本。
五、速度和价格:数字对应哪场实验
TypeSafe 在公开评测中给出了提速 193.6 倍、成本优势 444.6 倍的数字。对应的是四类任务:安全事件、检查 AI 自动执行任务的过程、处理发票,以及客服。官方材料把第二类称为“Agent 轨迹观测”;Agent 是能连续执行任务的 AI 程序,“轨迹”就是执行过程的记录。[19]
这些任务由官方团队设计,参考答案由指定的强模型回答汇总而来,没有全部换成人工确认的标准答案。模型设置、是否要求输出完整的概率列表、输出有多长,都会改变耗时和费用。因此,这两个倍率描述的是那组测试;要估计自己的业务能省多少,得按相同材料和要求重新比较。[1][19]
官方另一个教程比较了两种问法:把 13 道题打包发送,或一道答完再问下一道。它使用 jev-1.12,重复测试 5 次。打包约需 0.27 秒、0.000497 美元;逐题串行约需 2.71 秒、0.006090 美元。两边用的是同一版本,差别主要在提问安排。这项测试说明打包能减少串行等待;如果逐题请求也同时发送,耗时差距就会变化。[20]
截至资料日期,官方 jev-1.13.0 标价为每百万输入 token 0.042 美元,输出免费。按这个单位算,100 万次请求、每次恰好计费 1,000 个输入 token,模型输入费约为:
这里算的是给定输入量下的模型费用。邮件之外,问题和评分标准也要计入输入;实际系统还可能产生资料检索、请求重试、第三方平台调用和人工复核的费用。输出免费指模型不按输出 token 收费,返回结果仍要打包成 JSON,并通过网络传回来。[9][21]
六、其他人测出来怎样
研究者已经把 Jev 用在事故记录、AI 记忆和邮件判断等任务上。下面列的是论文和公开实验作者报告的成绩,本文没有重跑实验。它们使用的材料与评价方法不同,适合分别看各自回答了什么问题。
把事故文字记录整理成可统计的数据
《Calibrated Decisions at Scale》筛查了 499,500 条事故叙述,再用 27 个问题处理其中的 195,857 条。这样,一段段文字就能变成按固定项目填写的数据,便于后续统计。研究用 2,416 个盲评人工判断来核对结果,报告 Jev 对人工标签的 F1 为 0.908。[22]
F1 同时考虑两件事:找出来的结果有多少是对的,该找出来的又漏掉了多少。它适合评价这类识别任务,但 0.908 不能直接当成“全部记录有 90.8% 正确”。论文还比较了概率校准,发现表现因模型而异;对概率重新调整后的成绩,也与原始输出分开报告。[22]
选项的名字会不会干扰判断
《Type-Safe Is Not Error-Free》调整了选项名称与评分说明的对应关系,检验模型到底按说明判断,还是受选项名字影响。通过线上服务调用 Jev 的那组实验中,AUC 从 0.8146 降至 0.5806。[23]
AUC 衡量模型区分两类结果的能力,常见二分类评估中越接近 1 越好,0.5 相当于随机排序的水平。这里的下降说明:输出虽然都在允许的选项内,判断却明显变差了。尤其当名字带有“是”或“否”的含义,而说明又与之冲突时,名称本身就可能干扰判断。论文还测试了开放参数的 Jev-like 模型,上述两个数字只对应线上 Jev。[23]
帮 AI 决定该记住和调用哪些信息
Jev-Mem 把 Jev 用于判断记忆类型、选择处理路径、给候选记忆打分,以及决定什么时候停止。复杂推理交给另一层模型。论文在 LoCoMo 测试中报告,整个系统的 LLM-as-a-Judge 得分为 0.777。[24]
LLM-as-a-Judge 的意思是“用大语言模型给结果评分”。所以 0.777 是这套记忆系统在该评价方法下的成绩,不能读成 Jev 单独有 77.7% 的准确率。这个系统展示了一种分工:Jev 反复处理短判断,其他模型负责组织答案和推理。[24]
同一个问题,换种问法会怎样
jev-calibration-audit 公开了报告和逐条记录。在 400 个 KoBBQ 测试项目中,把同一判断写成 Noul,或写成只有两个选项的 Choice,两种概率的平均绝对差为 0.125,也就是平均相差 12.5 个百分点。分别问正面和反面命题时,两边的概率相加也没有始终等于 1。[25]
同一项目的另一组实验用了 250 个测试项,把每次只问一题改成每次一起问 16 题。目标问题的置信度平均绝对变化为 0.008,延迟中位数从 257 毫秒增至 271 毫秒。[25]
这组结果里,多题打包增加的等待较少,问法变化对概率的影响却值得留意。应用如果改用另一种问题类型,就需要重新检查自动处理与转人工的分界值。分别回答两个问题,也不能保证它们的概率自动满足所有数学关系。
另一个钓鱼邮件实验使用了 2,000 封合成邮件,即为数据集生成的邮件内容。要求模型直接判断邮件是否有问题时,Jev 的准确率为 62.6%,Claude Haiku 4.5 为 81.3%;Jev 在这组设置中更快、费用更低。[26]
实验还报告了 10-bin ECE:Jev 为 0.154,Claude Haiku 4.5 为 0.097。这个指标把预测按置信度分成 10 组,比较每组的置信度和实际正确率,再按样本量汇总差距,越小越好。仓库提供了代码和汇总指标,逐条邮件响应没有公开,因此重新核算完整实验还需要再次请求服务。[26]
这些结果涉及不同版本、提问方式与数据集。实际选型时,应让候选模型判断同一批业务材料,用同一份人工标准核对,再比较可接受错误范围内的耗时和费用。
七、适合怎么用
把任务分给合适的处理流程
工程里常说的“路由”,就是决定一项任务接下来交给谁。客服分派、选择搜索流程、给工单加标签,都能写成有固定选项的问题。模型选完,程序再执行对应操作。
涉及账户权限、金额、收件人和可用工具时,仍由普通代码按规则核验。官方的能力边界文档列出了算术、计数、日期比较、间接推理和过多无关文本等问题,也包括故意误导模型的内容。比如材料中夹带命令、试图让模型偏离任务,这类问题叫“提示注入”;答案格式受约束,并不能消除这种影响。[27]
给搜索结果排序,检查回答是否满足要求
搜索系统先找出一批文档,再按与问题的相关程度重新排序,这一步叫“重排”。Score 可以给候选文档打分。若要检查一段回答是否满足某条要求,则可以把参考材料和回答一起交给 Noul。无论哪种用法,评分标准都应写出具体检查什么,便于和人工判断核对。
官方教程使用 CLERC 的 40 个查询和 3,565 个候选文档。先由 BM25 这种常用文本检索方法选出前 30 个结果,再让模型重排。这是一个规模较小的组合示例,展示了怎样接入流程;效果对应这批查询和候选文档。[28]
从文字里找到需要的值
提取日期、金额等信息时,程序可以先用文本规则找到候选值,让 Jev 选择哪一个符合要求,最后由程序原样复制并整理格式。官方教程采用了这种分工,Jev 负责选择已有内容,无需自己重新生成一遍字符串。[29]
以发票为例,可以设计成这样的流程:程序列出所有日期及附近文字,模型挑出“到期日”,程序再检查日期是否合法、是否晚于开票日。选择日期含义和精确计算分别处理,出现错误时也比较容易找到是哪一步出了问题。
哪些任务用普通代码,哪些交给模型
选择工具时,可以先看需要处理的是哪类问题:
| 需求 | 优先考虑 |
|---|---|
| 格式校验、精确日期比较、明确的业务规则 | 普通代码和文本处理工具 |
| 类别固定、有足够训练数据、需要在自己的设备上运行 | 为该任务训练的分类模型 |
| 需要理解文字、从给定选项中快速判断,而且问题经常调整 | 评估 Jev 这类决策模型 |
| 写长文、分多步解释、回答没有固定选项的问题 | 生成式或推理模型 |
大语言模型也能按格式返回数据。比如 Structured Outputs,即“结构化输出”,会在生成时限制可输出的内容,使正常完成的结果符合受支持的格式要求。程序仍要处理拒绝回答或生成中断等情况。[30]
因此,选 Jev 还是生成式模型,要比较具体任务上的判断质量、概率是否可靠、耗时和费用,以及接入流程是否方便。两者都能提供机器可读的结果。
八、使用前还要知道什么
截至 2026 年 9 月 24 日,官方稳定版本是 jev-1.13.0。jev-latest 与 jev-preview 是方便调用的别名,当时都指向这个版本;别名以后可能随更新改变。若已经根据测试设好了自动处理的概率分界值,就应记录并固定实际版本,升级后重新检查。[21]
它接收文本,一次请求的材料加全部问题最多为 64k token,同时材料加最长的那道题不能超过 32k。这里 k 表示千,限制的是切分后的 token 数,不能直接按汉字数计算。[21]
官方文档说明英语表现最好,中文、日文、韩文需要用实际业务材料测试。输入中加入大量无关文字,也可能影响判断,所以应优先提供与问题有关的材料。[27]
开发者可以用 TypeSafe 提供的 Python、JavaScript SDK,也就是封装好调用操作的工具包。Vercel Gateway、OpenRouter 和 LangChain/LangSmith 也提供了接入方式。各家的用法有差别:OpenRouter 示例走专门的 decisions 接口,Vercel 使用实验性的 evaluate 能力,不能直接照搬普通聊天接口的请求格式。[5][6][7][8][31]
这些 SDK 的代码公开了,但模型权重,也就是训练得到的参数,是另一回事。数据会保存多久、哪些情况下不留存,要查看实际调用渠道的约定和合同。
真正接入前,可以留出一批由人工核对过的材料,看看模型选对多少、报出的概率与实际结果差多少。设置自动处理和转人工的分界值后,再统计能自动完成多少任务,以及整个流程花费的时间和费用。版本、问题写法和选项说明都要一并记录,否则下次结果改变时,很难判断原因。
参考资料
编号对应正文引用。接口和价格以 2026 年 9 月 24 日查阅的文档为准。
- TypeSafe:Introducing System One Models & Jev
- TypeSafe:System One
- DCVC:TypeSafe emerges from stealth
- TypeSafe:The Bitterest Lesson
- Vercel:Jev now available on AI Gateway
- LangChain:Building a harness with Jev
- OpenRouter:Jev 1.13;接口介绍
- LangChain:Jev in LangSmith Evals
- TypeSafe:API reference;State
- TypeSafe:Choice
- TypeSafe:Score
- TypeSafe:Noul
- TypeSafe:Speculative fan-out
- TypeSafe:Machine learning primer
- 社区项目 eve-rlcd,固定提交
- Guo et al.:On Calibration of Modern Neural Networks,ICML 2017
- Gneiting & Raftery:Strictly Proper Scoring Rules, Prediction, and Estimation,2007
- TypeSafe:Confidence
- TypeSafe:公开评测
- TypeSafe:Parallel questions cookbook
- TypeSafe:Models
- Rafe & Das:Calibrated Decisions at Scale,arXiv:2609.24052v1
- Sun & Xu:Type-Safe Is Not Error-Free,arXiv:2609.26758v1
- Jiang et al.:Jev-Mem,arXiv:2609.23986v1
- jev-calibration-audit:固定版本实验报告
- jev-phishing-bench:固定版本报告与代码
- TypeSafe:Jev 1.13 jaggedness
- TypeSafe:Rerank cookbook
- TypeSafe:Pre-parsed value extraction
- OpenAI:Introducing Structured Outputs in the API
- TypeSafe Python SDK;JavaScript SDK;LangChain provider 文档