· 智能计算系统 / 神经网络 / 梯度下降
智能计算系统 Day3:神经网络怎样预测、学习与表示特征
RedMoon · 整理于 2026-09-24 · 课堂阅读笔记
给出房屋面积,预测价格;输入一张照片,判断画面中的物体。这两类任务的输入和输出不同,却可以沿着同一条思路理解:先用一个带参数的函数计算预测,再衡量预测与目标的差异,最后根据差异调整参数。
本节从线性模型讲起,逐步加入分类、非线性激活和隐藏层。理解这几步,就能把神经网络的公式与实际计算对应起来,也能看清它为什么需要大量矩阵运算、数据存储和硬件支持。
一、人工智能、机器学习与神经网络的关系
人工智能是较大的研究范围,涉及感知、推理、规划和行动等能力。机器学习研究怎样利用数据或经验改善系统表现;决策树、支持向量机和神经网络都是其中的方法。
神经网络的基本计算受到生物神经元的启发:接收多个输入,把它们加权汇总,再产生输出。数学模型保留了这种计算思路,具体实现不需要复现真实神经元的电化学过程。
深度学习通过多层可训练的表示处理数据。在本课讨论的前馈网络中,增加隐藏层就增加了连续变换的层次。“超过四五层才算深度学习”可以帮助建立浅层与深层的直觉,但层数没有统一的硬性分界,计数时还要说明是否包含输入层。
强化学习是按反馈方式划分的学习范式,神经网络是模型形式。强化学习可以使用表格,也可以使用神经网络;采用深度神经网络时,通常称为深度强化学习。图学习同样包含多种方法,不能整体归为非神经网络方法。
课堂还讨论了大模型与智能体。大模型负责处理输入、生成输出;基于大模型构建的智能体系统还可以连接搜索、数据库和其他工具,依据工具结果继续执行任务。模型参数中的知识与工具取得的实时信息是两种来源,知识截止日期由具体模型和版本决定,并不存在所有模型统一在每年九月更新的规则。
二、先分清训练、评价和使用
以监督学习为例,一条样本由输入 $x_i$ 与目标 $y_i$ 组成。模型记为 $f_\theta$,其中 $\theta$ 代表待学习的参数。对输入计算:
\[\hat y_i=f_\theta(x_i).\]$y_i$ 是数据给出的目标,$\hat y_i$ 是模型算出的预测。两者之间的差异由损失函数衡量。
训练时,用样本反复计算预测和损失,并调整参数。评价时,检查模型在未参与参数训练的数据上表现如何。实际使用时,把新输入交给已经训练好的模型,得到预测。
这里的“使用”指参数固定的普通推理。测试也会执行推理,只是测试集还有目标值,可以据此计算指标。
| 数据划分 | 用途 | 是否参与参数更新 |
|---|---|---|
| 训练集 | 计算损失并学习参数 | 是 |
| 验证集 | 选择超参数、比较模型或决定何时停止训练 | 通常不直接参与 |
| 测试集 | 在方案确定后评价泛化表现 | 否 |
表中的超参数是训练前或训练过程中由外部选择的设置,例如学习率和网络层数,区别于通过训练学习的权重。
训练损失低,表示模型拟合训练样本的程度高。泛化则关心它能否处理新的样本。若反复根据测试结果修改方案,测试集的信息就参与了选择,最终分数也会偏乐观。[1]
三、线性回归:从输入算出预测
1. 一个特征与多个特征
只用面积预测房价时,可以写成:
\[\hat y=wx+b.\]$w$ 控制面积变化对预测价格的影响,$b$ 是偏置。增加楼层等数值特征后:
\[\hat y=w_1x_1+w_2x_2+\cdots+w_dx_d+b =w^\top x+b.\]其中 $x,w\in\mathbb R^d$。向量形式把一串乘加运算写得更紧凑,计算内容没有改变。朝向、城市等类别特征需要先编码,不能默认类别编号之间具有大小或距离意义。
有时把偏置并入参数:令 $\tilde x=(1,x_1,\ldots,x_d)^\top$,$\tilde w=(b,w_1,\ldots,w_d)^\top$,就有 $\hat y=\tilde w^\top\tilde x$。多出来的常数 $1$ 让偏置也能写进点积。
2. 损失怎样衡量误差
对第 $i$ 条样本,残差定义为:
\[e_i=\hat y_i-y_i.\]直接累加残差会出现正负抵消。例如一次高估 10、一次低估 10,和为零,两次预测却都存在误差。常见处理是平方或取绝对值:
\[\operatorname{MSE}=\frac1n\sum_{i=1}^{n}e_i^2,\qquad \operatorname{MAE}=\frac1n\sum_{i=1}^{n}|e_i|.\]MSE 是均方误差,较大的残差受到更大的惩罚;MAE 是平均绝对误差,对大残差的惩罚按绝对值线性增加。任务目标和数据特点决定选择哪一种。
普通最小二乘回归中的残差沿输出方向计算。 在面积与价格的二维图上,它是同一面积处预测价格与真实价格之差,也就是竖直差值。点到直线的最短垂直距离属于另一种几何误差,不能直接混用。
课堂用概率分布解释平方与绝对值的来源:若误差独立且服从零均值、相同固定方差的高斯分布,最大化数据似然等价于最小化残差平方和;对应的拉普拉斯误差模型会得到绝对值误差和。这是损失的一种统计解释。使用平方损失本身,不要求先证明误差严格服从高斯分布。
四、梯度下降怎样更新参数
把所有训练样本的损失汇总为 $L(\theta)$,训练目标写成:
\[\theta^\star=\arg\min_\theta L(\theta).\]梯度 $\nabla_\theta L$ 由各参数的偏导数组成,描述损失对参数变化的局部敏感程度。在通常的欧氏距离度量下,负梯度是局部最陡下降方向。梯度下降据此更新:
\[\theta_{t+1}=\theta_t-\eta\nabla_\theta L(\theta_t), \qquad \eta>0.\]$\eta$ 是学习率,控制一次走多远。方向正确也需要合适的步长:步长太大会越过低损失区域,甚至使损失增大;太小则需要更多次迭代。
1. 手算一次更新
补充一个最小算例:只有一条样本 $x=2,y=5$,模型是 $\hat y=wx+b$,损失取:
\[L=\frac12(\hat y-y)^2.\]这里的 $1/2$ 是为了让求导后的系数简洁。初始 $w=1,b=0$,则 $\hat y=2$,残差为 $-3$,损失为 $4.5$。由链式法则:
\[\frac{\partial L}{\partial w}=(\hat y-y)x=-6,\qquad \frac{\partial L}{\partial b}=\hat y-y=-3.\]取学习率 $\eta=0.1$,同时更新为 $w=1.6,b=0.3$。新的预测为 $3.5$,损失降至 $1.125$。
# 一个样本的一次梯度下降,用来核对上面的手算过程。
x, y = 2.0, 5.0
w, b = 1.0, 0.0
lr = 0.1

prediction = w * x + b
error = prediction - y
loss_before = 0.5 * error ** 2

# 两个梯度都根据更新前的同一次预测计算。
grad_w = error * x
grad_b = error
w -= lr * grad_w
b -= lr * grad_b

loss_after = 0.5 * (w * x + b - y) ** 2
print(f"w={w:.1f}, b={b:.1f}")
print(f"loss: {loss_before:.3f} -> {loss_after:.3f}")
assert abs(loss_after - 1.125) < 1e-12
预期输出为 w=1.6, b=0.3,损失从 4.500 降到 1.125。这是一次更新的演示,不代表模型已在独立数据上得到验证。
2. 全量、单样本与小批量
| 方法 | 一次更新使用的数据 |
|---|---|
| 全批量梯度下降 | 全部训练样本 |
| 严格意义的随机梯度下降(SGD) | 随机抽取一条样本 |
| 小批量随机梯度下降 | 一小批样本,即 mini-batch |
小批量方法常被简称为 SGD。它可以减少单次更新需要处理的数据,同时利用矩阵运算并行处理多个样本。批量大小影响内存、吞吐和梯度噪声,需要结合任务与设备选择。
普通线性回归的平方损失对参数是凸函数,不存在比全局最优更差的局部极小值;多层神经网络的目标通常非凸,优化困难还包括鞍点、平坦区域和不同方向曲率差异。课堂的局部最优类比适合建立直觉,不能套用到所有模型。
五、感知机:用一个边界做二分类
感知机先计算分数:
\[z=w^\top x+b,\]再根据正负号输出类别。采用 $y\in{-1,+1}$ 的标签约定时,分类边界为:
\[w^\top x+b=0.\]二维输入下,这个边界是一条直线;更高维时称为超平面。偏置改变边界的位置。
1. 为什么损失里会出现负号
判断分类是否正确,可以看目标标签与分数的乘积:
\[y_i(w^\top x_i+b).\]标签和分数同号,乘积为正,分类正确;异号时为负,分类错误。感知机损失的一种常见写法是:
\[L(w,b)=\sum_i\max\left(0,-y_i(w^\top x_i+b)\right).\]负号把错误分类对应的负乘积变成正惩罚,外层 $\max$ 让正确分类的样本贡献零损失。例如 $y=-1,z=2$,损失为 $2$;若 $z=-2$,损失为 $0$。
因此,不能去掉 $\max$ 或“只对误分类点求和”的限制,再把目标理解成让所有样本的损失无限变负。边界上 $yz=0$ 时,损失为零,但分类还没有正间隔;经典感知机算法常将这种情况也纳入更新:
\[w\leftarrow w+\eta yx,\qquad b\leftarrow b+\eta y.\]课堂从误分类点到超平面的距离引出目标。几何距离包含 $|w|$ 的归一化因子;上式则是用于感知机学习的代数目标,二者需要区分。
2. 一个线性边界为什么分不开 XOR
XOR(异或)的规则是两个二进制输入不同时输出 1,相同时输出 0:
| $x_1$ | $x_2$ | 目标 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
同类点位于正方形的对角,任何一条直线都无法把两类完全分开。这是模型表达能力的限制,增加训练轮数不能改变单个线性边界的形状。
六、隐藏层与非线性如何增加表达能力
1. 多层网络是一组函数的复合
一个含两个隐藏层的前馈网络可以写成:
\[h^{(1)}=\phi(W_1x+b_1),\] \[h^{(2)}=\phi(W_2h^{(1)}+b_2),\] \[z=W_3h^{(2)}+b_3.\]$h^{(1)}$ 和 $h^{(2)}$ 是中间表示。“隐藏”表示它们处在输入与输出之间,没有直接作为数据集标签提供;它们在程序中都有具体数值。
$\phi$ 是逐元素激活函数。输出 $z$ 如何转换为预测取决于任务:回归可以直接输出数值,二分类可以接 Sigmoid,多分类可以接 Softmax。
如果两层之间没有非线性:
\[W_2(W_1x+b_1)+b_2 =(W_2W_1)x+(W_2b_1+b_2).\]它仍然只是一次仿射变换。反复堆叠乘法与加法,无法单靠层数得到 XOR 所需的非线性划分。[2]
2. 一个可以逐项检查的 XOR 网络
为看清非线性的作用,补充下面这个手工设定的网络:
\[s=x_1+x_2,\qquad h_1=\operatorname{ReLU}(s),\qquad h_2=\operatorname{ReLU}(s-1),\] \[\hat y=h_1-2h_2.\]四组二进制输入的 $s$ 分别为 $0,1,1,2$,代入后得到 $0,1,1,0$,恰好符合 XOR。隐藏层改变了样本的表示,原先不能用直线分开的两类,在新的表示中可以用线性输出区分。
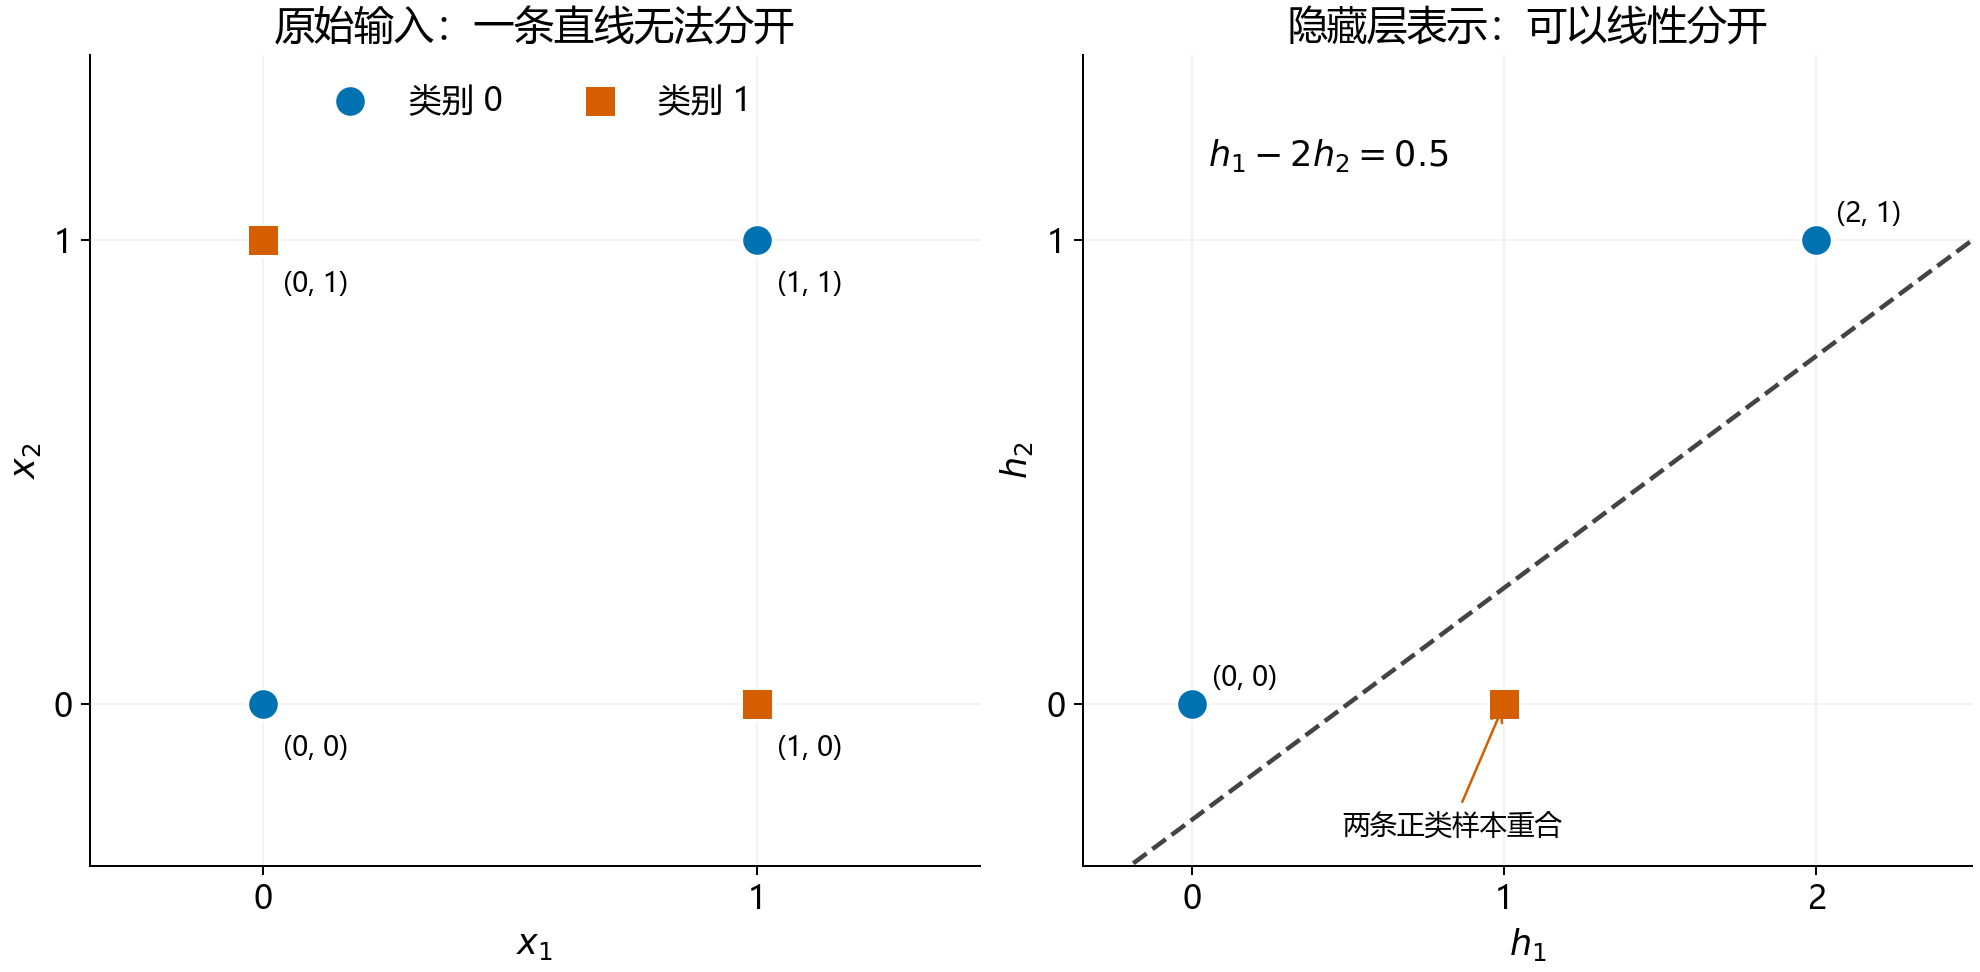
左图两类点交错;右图中两条正类样本重合在 $(1,0)$,负类位于 $(0,0)$ 和 $(2,1)$。虚线是输出值等于 $0.5$ 的分类边界。
def relu(value):
    # 负输入输出 0,正输入保持原值。
    return max(0.0, value)


def xor_network(x1, x2):
    # 隐藏层的两个单元采用不同偏置。
    total = x1 + x2
    h1 = relu(total)
    h2 = relu(total - 1.0)
    # 输出层线性组合两个隐藏单元,不再加激活函数。
    return h1 - 2.0 * h2


samples = [(0, 0, 0), (0, 1, 1), (1, 0, 1), (1, 1, 0)]
for x1, x2, target in samples:
    prediction = xor_network(x1, x2)
    print((x1, x2), "->", prediction)
    assert prediction == target
这里的参数由公式直接给出,用于证明这个小网络能够表达 XOR。让训练算法从样本中找到参数,是另一个问题。
七、激活函数与输出概率
1. Sigmoid、ReLU 与梯度
Sigmoid 把实数映射到 $(0,1)$:
\[\sigma(z)=\frac{1}{1+e^{-z}},\qquad \sigma'(z)=\sigma(z)(1-\sigma(z)).\]输入绝对值很大时,输出靠近 0 或 1,导数接近零,这称为饱和。反向传播会连续相乘各层的局部导数,小导数可能使前面层获得的梯度很弱。
阶跃函数或符号函数适合表达硬分类决定,但在大部分位置导数为零,跳变位置不可导。Sigmoid 提供了平滑的过渡,适合构造可微的概率输出。
ReLU 定义为:
\[\operatorname{ReLU}(z)=\max(0,z).\]它在正半轴的导数为 1,负半轴为 0;零点不可导,实现中通常约定一个值,常用 0。ReLU 的计算简单,正半轴不会像 Sigmoid 那样饱和;若某个单元长期对所有输入都落在负半轴,则可能出现难以恢复的零梯度状态。[2]
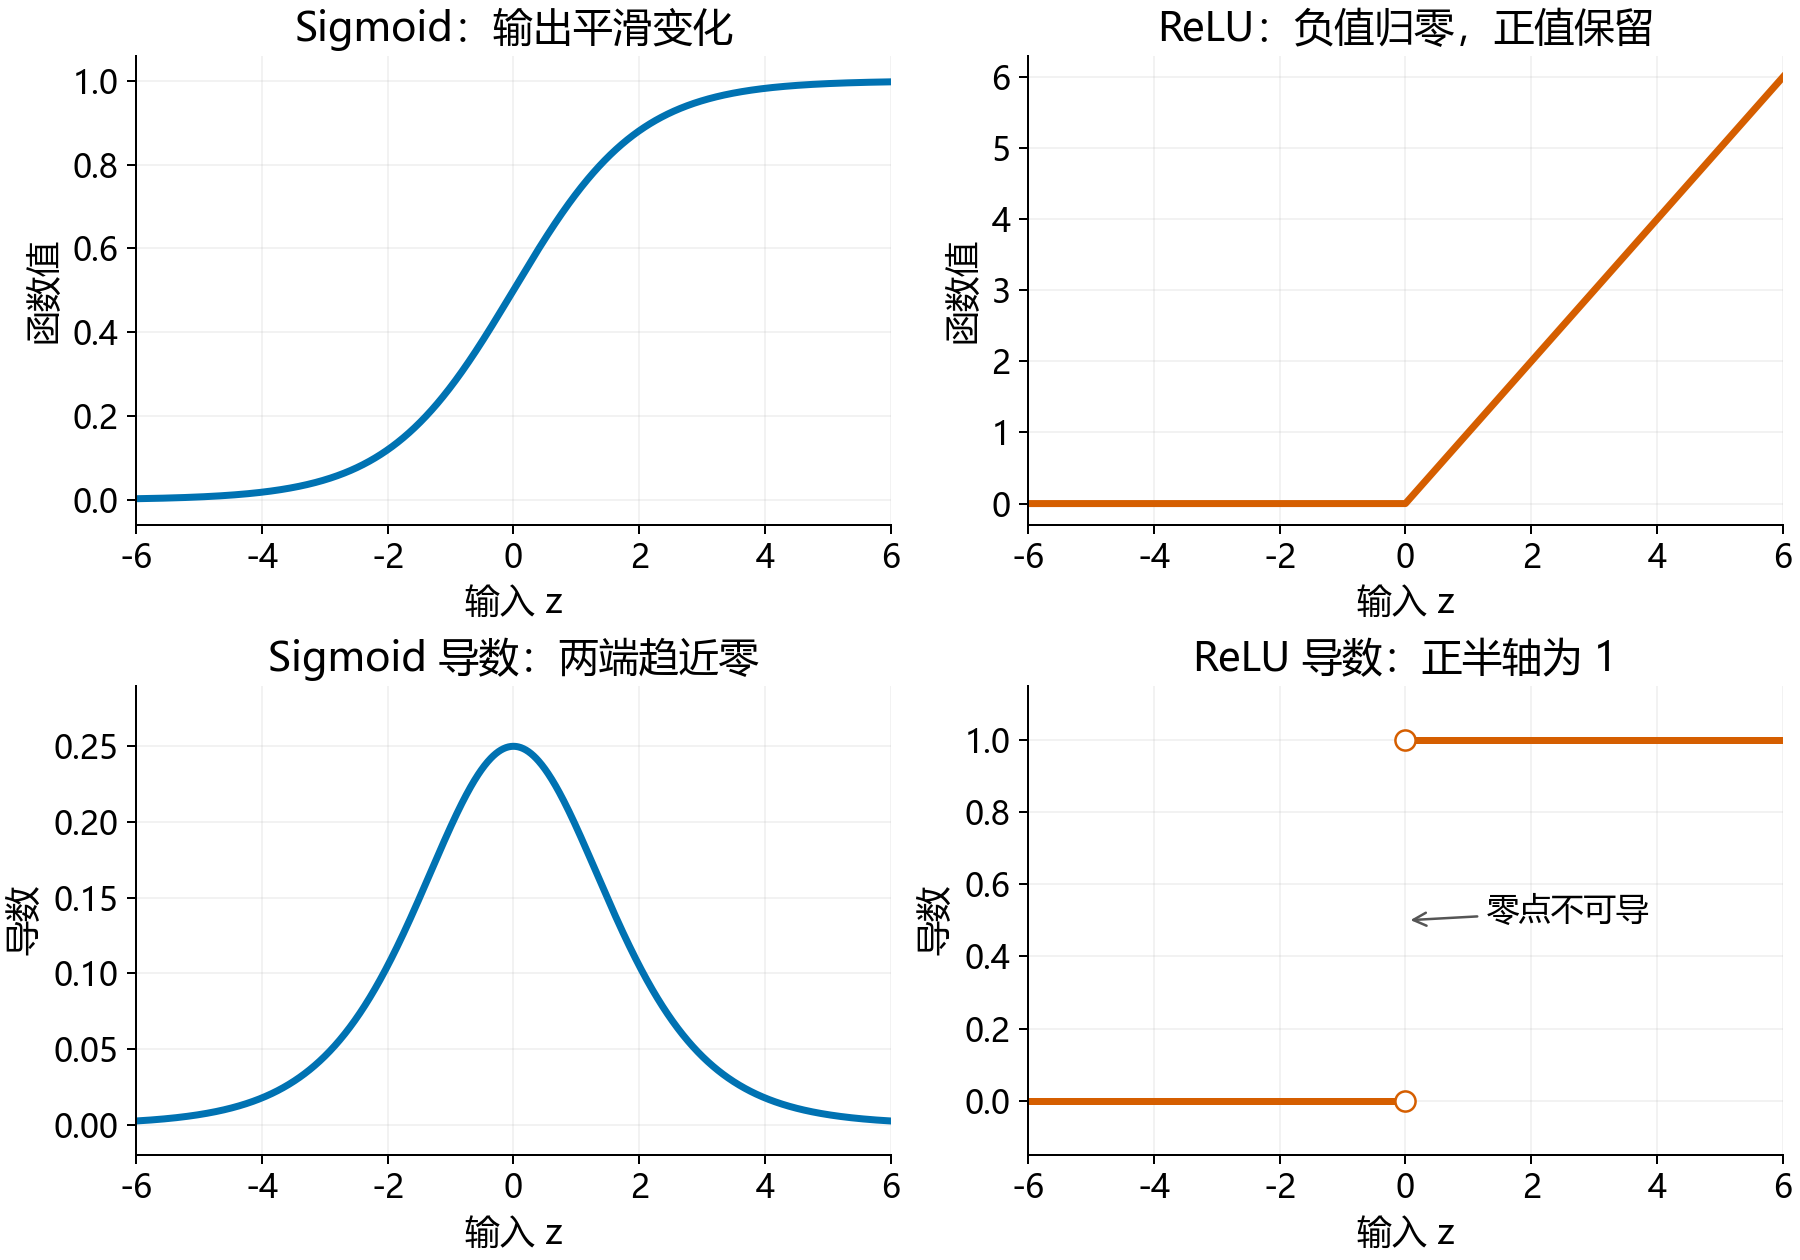
ReLU 输出零可以形成稀疏激活,但数值为零不等于硬件必然跳过计算。普通稠密矩阵运算仍可能处理这些位置;要把稀疏性变成实际加速,需要相应的算子、数据格式或硬件支持。输出零的比例也不固定为一半。
2. Softmax、交叉熵与 KL 散度
Softmax 同时处理一组类别分数 $z_1,\ldots,z_K$:
\[p_k=\frac{e^{z_k}}{\sum_{j=1}^{K}e^{z_j}}.\]每个 $p_k$ 为正,所有类别概率之和为 1。实践中可先从每个分数减去同一个最大值,再计算指数,结果不变,数值更稳定。
单标签多分类常配合交叉熵:
\[L=-\sum_{k=1}^{K}y_k\log p_k.\]若目标采用 one-hot 编码,真实类别对应位置为 1,其余为 0,损失就简化为 $-\log p_{\text{真实类别}}$。真实类别的概率越大,损失越小。
课堂提到了 KL 散度。目标分布为 $q$、预测分布为 $p$ 时:
\[H(q,p)=H(q)+D_{\mathrm{KL}}(q\|p).\]$H(q,p)$ 是交叉熵,$H(q)$ 是目标分布自身的熵,$D_{\mathrm{KL}}(q|p)$ 衡量两个分布的差异。固定目标分布后,$H(q)$ 不随模型变化,所以最小化交叉熵等价于最小化这里的 KL 散度。平方误差、感知机损失和交叉熵对应不同建模选择,不能仅凭式子里有负号就把它们当成同一种损失。
隐藏层激活与输出层概率变换也要分开看。Sigmoid 可以用于二分类概率,Softmax 可以用于互斥类别的概率;生成模型同样可能在输出端使用 Softmax。“Sigmoid 管生成、ReLU 管分类”不是有效的任务划分规则。
八、反向传播负责算梯度,优化器负责更新
一次训练迭代包含连续的计算步骤:
- 前向传播:从输入逐层计算隐藏表示和预测。
- 计算损失:把预测与目标比较,得到标量损失。
- 反向传播:沿计算依赖反向应用链式法则,求出各参数的梯度。
- 优化器更新:使用梯度和学习率等信息调整参数。
以 $h=\phi(wx+b)$、$L=\ell(h,y)$ 为例:
\[\frac{\partial L}{\partial w} =\frac{\partial L}{\partial h} \frac{\partial h}{\partial z} \frac{\partial z}{\partial w}, \qquad z=wx+b.\]三个因子分别描述输出变化怎样影响损失、激活输入怎样影响输出、权重怎样影响加权和。把各步的影响相乘,就得到权重对最终损失的影响。
BP(反向传播)高效地计算这些梯度,SGD 等优化器决定怎样使用梯度。更换优化器不意味着换掉链式法则,也不意味着前向计算消失。
九、深度、宽度与计算成本
1. 逐层表示在学习什么
视觉网络中,前面层可能对边缘、方向和局部纹理响应,后续层组合出部件和更贴近任务的表示。这提供了一种理解多层网络的方式,具体每层学到什么取决于结构、数据和训练目标。[2]
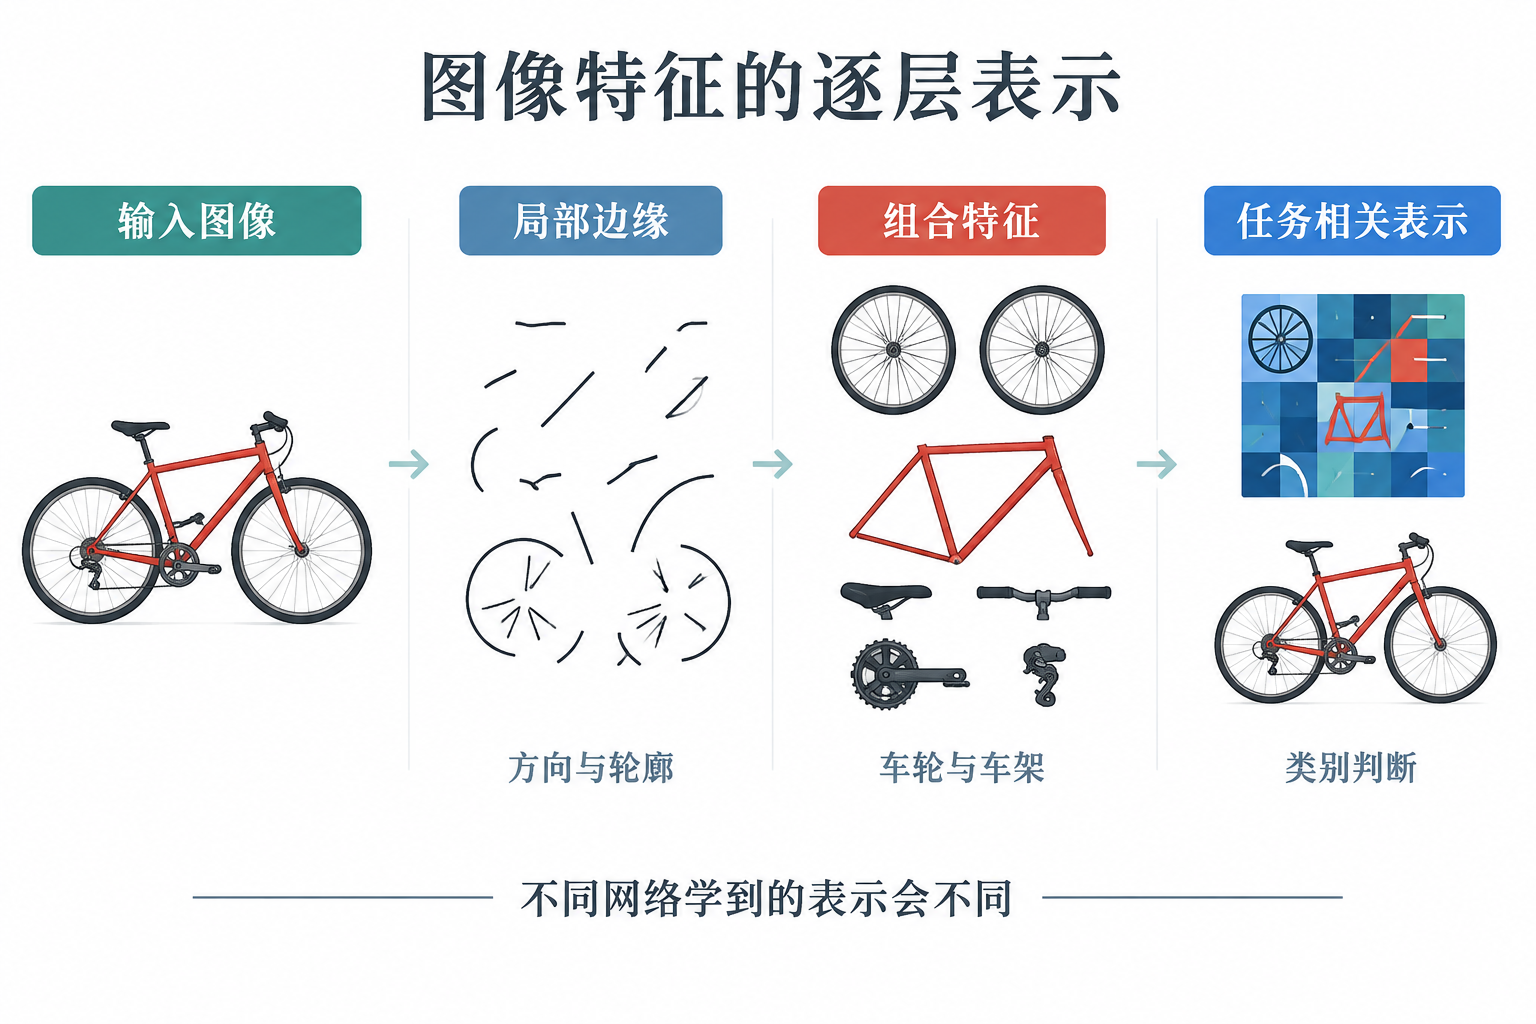
这张图是概念示意,没有展示某个实际训练模型的中间激活。抽象表示可以是连续数值,也可以保持或增加维度;“更抽象”并不要求逐层变成 0 和 1,或逐层降低维度。
2. 浅层网络也能逼近函数,为什么还需要深层
经典通用逼近结果说明,在合适的激活函数等条件下,拥有足够多隐藏单元的单隐藏层网络,可以在紧致输入域上任意精确地逼近连续函数。有限闭区间就是一维紧致域的例子。[2]
这个结论说明某种表示存在,没有直接给出需要多少单元、多少训练数据,以及优化算法能否找到它。某些具有组合结构的函数可以由深层网络更紧凑地表示;但增加层数也会增加连续计算步骤,并可能使训练更困难。
因此,深度与宽度要结合参数量、计算量、存储、并行方式和任务效果讨论,不能直接推出“深层一定更省算力”。
3. 从矩阵形状数参数
一个全连接层有 $d_{\mathrm{in}}$ 个输入、$d_{\mathrm{out}}$ 个输出,采用列向量约定时:
\[W\in\mathbb R^{d_{\mathrm{out}}\times d_{\mathrm{in}}}, \qquad b\in\mathbb R^{d_{\mathrm{out}}},\] \[N_{\mathrm{params}} =d_{\mathrm{in}}d_{\mathrm{out}}+d_{\mathrm{out}}.\]例如输入维度为 3,两个隐藏层的宽度都为 2,输出维度为 1:
| 层 | 权重形状 | 权重数 | 偏置数 | 参数小计 |
|---|---|---|---|---|
| 输入到隐藏层 1 | $2\times3$ | 6 | 2 | 8 |
| 隐藏层 1 到隐藏层 2 | $2\times2$ | 4 | 2 | 6 |
| 隐藏层 2 到输出 | $1\times2$ | 2 | 1 | 3 |
| 合计 | 12 | 5 | 17 |
大图像能体现全连接层的成本。$2000\times2000$ 的 RGB 图像有 400 万像素、1200 万个通道数值;若每个通道存 1 字节,未压缩数据约 12 MB。若直接展平并连接到 1000 个隐藏单元,仅第一层就有约 120 亿个权重,FP32 权重约占 48 GB。
图像自身的大小与连接它的网络权重大小是两回事。这个例子说明为什么实际视觉模型需要考虑局部连接、参数共享或其他结构设计,也说明课堂中的“大输入”必须结合网络连接方式来估算成本。
十、把模型放回计算系统
从本节公式可以直接看出系统要执行什么:全连接层进行矩阵乘加,激活函数逐元素变换数据,损失函数汇总误差,反向传播继续计算梯度。训练还需要保存中间结果、梯度以及优化器状态,因此开销超过单次前向推理。
算法决定计算结构,数据决定训练所覆盖的经验,硬件与软件决定计算怎样执行。预训练可以从较大规模的数据中学习表示,随后通过微调等方式适配具体任务;最终效果需要在目标任务的数据上评价。
课堂也提到了神经网络研究与科学应用获得的奖项。2024 年诺贝尔物理学奖授予 John J. Hopfield 和 Geoffrey Hinton,表彰使人工神经网络机器学习成为可能的基础性发现与发明。[3] 同年的化学奖一半授予 David Baker 的计算蛋白质设计工作,另一半共同授予 Demis Hassabis 和 John Jumper 的蛋白质结构预测工作。[4] 这两项奖对应的研究对象和贡献不同。
复习问题
- 对一条样本,分别指出输入、目标、预测、参数和损失是什么。
- 为什么普通线性回归的残差与点到直线的最短距离不同?
- 不看代码,重新算出示例中的两个梯度和更新后的损失。
- 感知机中的 $yz$ 正负分别表示什么?边界点怎样处理?
- 为什么纯线性层堆叠后仍然是线性分类边界?隐藏层怎样改变 XOR 的表示?
- 分清激活函数、Softmax、损失函数、反向传播和优化器各自的作用。
- 为什么 ReLU 输出零不保证实际运算量减半?
- 给定一层的输入与输出维度,怎样计算参数量和权重存储量?
参考资料
课堂内容依据本次《神经网络基础与深度学习核心原理》转写整理。梯度下降的数值算例、XOR 网络与参数量表为补充推演;配图中的概念示意与实际计算图已分别说明。
- Goodfellow、Bengio、Courville,Deep Learning,Chapter 5:Machine Learning Basics。用于对照训练、泛化与数据划分。
- Stanford CS231n,Neural Networks Part 1。用于对照前馈计算、激活函数、层数约定和通用逼近。
- Nobel Prize,The Nobel Prize in Physics 2024。
- Nobel Prize,The Nobel Prize in Chemistry 2024。