· CS336 / BPE / 资源核算 / RoPE / GQA / RMSNorm / SwiGLU
CS336 前三讲:从分词、张量核算到现代 Transformer
CS336 Lecture 1–3:文本如何分词,训练需要多少资源,以及 Transformer 各组件的作用。
前言
之前跟着 Karpathy 的课,我们已经能把一个小模型从分词到训练完整跑通。但跑通之后回头看,很多选择我说不出理由:为什么很多模型用 BPE 分词?训练一个模型需要多少显存、多少计算量?Pre-Norm、RMSNorm、SwiGLU 和 RoPE 各自解决了什么问题?
这次开始跟斯坦福 CS336,才刚听了 3 节课,正好讲到了这些问题。第一讲讨论怎样把文本切成模型能处理的单元;第二讲计算这些数据和模型需要多少存储与运算;第三讲再解释,资源限制和训练稳定性如何影响模型设计。
笔记按这个顺序展开。代码用于演示合并规则、张量操作和数值计算;架构效果的比较则对应课件及文末论文。Python 示例都在 CPU 上运行,涉及张量的示例需要 PyTorch;BPE 编码一节接着使用上一段训练得到的 merges。
1. 分词:把文本转换成 token 序列
1.1 词、字符、字节与子词有什么区别
文本进入语言模型前,要先切成一个个 token(词元),再给每个 token 分配整数编号。token 可以是一个词、一个字符,也可以是词的一部分。词表保存 token 与编号的对应关系;模型通过 embedding(嵌入表)把编号转换成向量,再进行计算。
怎么切,会同时影响词表大小和序列长度:
| 分词粒度 | 怎样切 | 主要取舍 |
|---|---|---|
| 词级 | 把一个完整的词作为一个 token | 常见词表示紧凑,但新词可能不在词表中,只能用 UNK(未知词标记)表示 |
| 字符级 | 每个字符一个 token | 有限字符集的词表较小;覆盖更多语言时词表会增大,未收录的字符仍需处理 |
| 字节级 | 先转为字节,每个字节一个 token | 256 种字节值足以表示合法 UTF-8 文本,但一个汉字可能拆成多个 token |
| 子词级 | 常见片段合在一起,少见片段继续拆分 | 用较大的词表换取较短的序列,BPE 就属于这一类 |
序列越长,模型要处理的位置越多。对于全注意力,每个位置都要与其他可见位置计算相关性,这部分计算量随序列长度的平方增长。
BPE(Byte Pair Encoding,字节对编码)反复合并语料中出现次数最多的相邻片段。这里采用字节级 BPE:从 256 种字节值出发,让常见字节串逐渐成为一个 token。BPE 最早是 Gage 在 1994 年提出的数据压缩算法,Sennrich 等人在 2016 年将其用于神经机器翻译(arXiv:1508.07909)。BPE 可以从字符或字节开始;本节的 256 项初始词表对应字节级实现。
「字节级」意味着先看字符串的 UTF-8 字节表示:
s = "A中文🙂"
b = s.encode("utf-8")  # 把字符串转为 UTF-8 字节串,一个字符可能占多个字节
print(len(s), len(b))  # 4 11:本例有 4 个 Unicode 码点、11 个字节
print(list(b))         # 逐个显示字节值,每个值都在 0 到 255 之间
# [65, 228, 184, 173, 230, 150, 135, 240, 159, 153, 130]
本例中,A 占 1 字节,中 和 文 各占 3 字节,🙂 占 4 字节。若每个字节都单独作为 token,就需要 11 个 token。BPE 会把常见字节串合并,从而减少 token 数。课程用“字节数 ÷ token 数”衡量压缩率:同一段文本下,这个比值越大,序列越短;具体计算成本还受词表大小和模型结构影响。
1.2 BPE 训练与编码是两件不同的事
BPE 训练的流程:
- 预分词(pre-tokenization):先把语料粗切成若干片段,再在每个片段内部合并。A1 采用 GPT-2 式正则,讲义所用写法来自 tiktoken PR #234;下方教学例子为方便观察,直接按空格分词。SentencePiece 可以直接处理原始文本,不能简单等同于按空格切分。
- 统计相邻 pair 的加权频次:权重是该预词在语料中出现的次数,统计绝不跨预词。
- 合并最高频 pair 并加入词表。CS336 作业规定频次相同时取字典序更大的 pair;其他实现可能采用不同规则。
- 重复,直到词表达到目标大小,或已经没有可合并的相邻对。按每次合并新增一个词条计算:最终词表大小 = 256 + 实际新增的合并词条数 + special token 数。
special token(特殊词元,如表示文档结束的 <|endoftext|>)有独立编号。训练 BPE 时,以它为界切开文本,各段分别统计和合并,特殊词元本身不参与统计。这样不会把前一篇文档的结尾与后一篇的开头合成一个 token。编码时则把它保留为一个完整 token。具体要求见 A1 讲义 §2.5。
下面这段代码演示官方讲义 §2.4 的 Sennrich 例子。low×5 表示 low 在语料中出现 5 次,因此其中每个相邻对也要累计 5 次。代码只展示六轮合并,输入已经是“单词及其频次”的表:
from collections import defaultdict

corpus = {"low": 5, "lower": 2, "widest": 3, "newest": 6}
# w 是单词,c 是出现次数;如 "low" 变成 (b"l", b"o", b"w")。
# 遍历字节串得到的是整数,bytes([b]) 将它重新包装成可拼接的字节串。
words = {tuple(bytes([b]) for b in w.encode()): c for w, c in corpus.items()}

def count_pairs(words):
    counts = defaultdict(int)  # 尚未出现的相邻对从 0 开始计数
    for w, c in words.items():
        for a, b in zip(w, w[1:]):  # 错开一位配对,只统计当前单词内部
            counts[(a, b)] += c     # 同一单词出现 c 次,就贡献 c 次
    return counts

merges = []  # 按学习顺序保存规则;编码新文本时还要用到这个顺序
for _ in range(6):
    # kv[0] 是相邻对,kv[1] 是频次:先比频次,再用字典序打破平局。
    best = max(count_pairs(words).items(), key=lambda kv: (kv[1], kv[0]))[0]
    merges.append(best)
    new = {}  # 保存本轮合并后的单词表示及频次
    for w, c in words.items():
        out, i = [], 0
        while i < len(w):
            # 先检查右边还有元素,再判断当前位置能否应用本轮规则。
            if i < len(w) - 1 and (w[i], w[i + 1]) == best:
                out.append(w[i] + w[i + 1])  # 拼成一个新的字节串
                i += 2                     # 两个旧片段都已处理,跳过它们
            else:
                out.append(w[i])  # 未匹配就保留原片段
                i += 1
        new[tuple(out)] = new.get(tuple(out), 0) + c
    words = new  # 下一轮基于新片段重新统计相邻对

print([(a.decode(), b.decode()) for a, b in merges])
# [('s', 't'), ('e', 'st'), ('o', 'w'), ('l', 'ow'), ('w', 'est'), ('n', 'e')]
六次合并的加权频次依次是 9、9、7、7、6、6。第一轮中,widest 出现 3 次、newest 出现 6 次,所以 (e,s) 与 (s,t) 都出现 9 次。按作业的平局规则,先合并 (s,t);第二轮再把 e 与刚得到的 st 合成 est。
训练结束后,merges 固定下来。编码新文本时,不再统计新文本里哪个相邻对最常见,而是按已有规则的优先级合并。A1 讲义 §2.6.1 规定按规则的创建顺序应用。下面接着使用上段代码得到的六条规则,从前到后检查,每条规则都在当前单词中从左到右匹配:
def encode_word(word, merges):
    # 新单词也从单字节片段开始,和训练时使用相同的表示。
    seq = tuple(bytes([b]) for b in word.encode())
    for a, b in merges:  # 规则顺序固定,不按新单词的频次重新排序
        out, i = [], 0
        while i < len(seq):
            if i < len(seq) - 1 and (seq[i], seq[i + 1]) == (a, b):
                out.append(a + b)  # 命中规则后用合并片段替换原来的两个
                i += 2
            else:
                out.append(seq[i])
                i += 1
        seq = tuple(out)  # 本条规则处理完,再应用下一条规则
    return seq

for w in ["lowest", "newest", "stone"]:
    # 这里的例子全是 ASCII,逐片段解码是为了显示合并结果。
    print(w, [t.decode() for t in encode_word(w, merges)])
# lowest ['low', 'est']
# newest ['ne', 'west']
# stone ['st', 'o', 'ne']
以 lowest 为例,六条规则逐步得到 l,o,w,e,st、l,o,w,est、l,ow,est,最后得到 low,est。示例返回的是字节片段;完整编码还要查词表,把每个片段换成整数 ID。解码时反过来查出字节串,先拼接,再统一做 UTF-8 解码,因为中文的单个 token 可能只包含某个字符的一部分字节。
词表越大,常见片段越可能合成单个 token,序列通常越短;但输入嵌入表和输出投影矩阵也会变大。例如词表有 $V$ 项、模型向量维度为 $d$,嵌入表就有 $Vd$ 个参数。低频 token 能得到的训练样本也更少。
Lecture 3 第 47 页列举的词表大小包括 GPT-2 的 50257、LLaMA 的 32000、GPT-4 的 100276 和 PaLM 的 256000。课件用这些案例说明:覆盖更多语言的模型往往采用更大的词表。这些是具体模型的配置,不能作为所有同系列模型的固定值。
2. 资源核算:张量、计算量与显存
2.1 张量:shape、stride、storage、dtype
分词后得到的整数序列会被组织成张量。张量可以理解为多维数组:向量是一维张量,矩阵是二维张量,一批文本的隐藏表示常是三维张量。训练中还有几类张量:
- 参数是模型通过训练调整的数值,例如线性层权重。
- 激活值是前向计算产生的中间结果,反向传播会用到其中一部分。
- 梯度描述损失对参数或中间变量的变化率,用来计算参数更新。
- 优化器状态保存更新参数所需的历史信息,例如 Adam 的梯度均值与平方均值。
PyTorch 张量的数值存储在 storage 中,元数据描述怎样读取这些数值。shape 表示各维长度,stride 表示沿某一维移动一步要跨过多少个存储元素,dtype 表示元素类型。视图与原张量共享存储,只改变访问方式:
import torch

x = torch.arange(12, dtype=torch.float32).reshape(3, 4)  # 0 到 11,排成 3 行 4 列
y = x.T            # 转置为 4 行 3 列,仍然使用 x 的底层存储
z = y.reshape(-1)  # -1 表示自动推断长度;这个布局展平时需要复制数据

# 连续张量的存储顺序与默认的逐行访问顺序一致。
print(tuple(x.shape), x.stride(), x.is_contiguous())  # (3, 4) (4, 1) True
print(tuple(y.shape), y.stride(), y.is_contiguous())  # (4, 3) (1, 4) False
print(tuple(z.shape), z.stride(), z.is_contiguous())  # (12,) (1,) True
# 比较底层存储地址,直接验证共享或复制,而不只看 shape。
print(y.untyped_storage().data_ptr() == x.untyped_storage().data_ptr())  # True
print(z.untyped_storage().data_ptr() == x.untyped_storage().data_ptr())  # False
x 的 stride 是 (4, 1):向下一行跨 4 个元素,向右一列跨 1 个元素。转置后,y 的 stride 变成 (1, 4),数据本身没有移动。把 y 按逐行顺序展平则需要重新排列数据,所以本例的 reshape(-1) 创建了副本。reshape 是否复制,取决于原布局能否用新形状直接表示。
dtype 决定存储大小和可表示的数值。FP32 每个元素占 4 字节,FP16 和 BF16 各占 2 字节。动态范围描述能表示多大、多小的数;精度描述相近的数能区分得多细。下面的 eps 是 1 与比 1 大的下一个可表示数之间的间隔:
import torch

for dt in (torch.float32, torch.float16, torch.bfloat16):
    fi = torch.finfo(dt)  # 查询该浮点类型的最大有限值和机器精度
    print(f"{str(dt):18s} max={fi.max:<14g} eps={fi.eps:<12g}")
# torch.float32      max=3.40282e+38   eps=1.19209e-07
# torch.float16      max=65504         eps=0.000976562
# torch.bfloat16     max=3.38953e+38   eps=0.0078125
| dtype | 最大值 | 机器 epsilon | 一句话 |
|---|---|---|---|
| FP32 | ≈3.40e38 | ≈1.19e-7 | 默认基准,稳但占内存 |
| FP16 | 65504 | ≈9.77e-4 | 指数只有 5 位,动态范围窄,易上/下溢 |
| BF16 | ≈3.39e38 | ≈7.81e-3 | 指数位与 FP32 相同,尾数更少 |
FP16 的指数位较少,可表示的范围较窄。训练时常用 loss scaling:先放大损失,让反向传播中的小梯度不容易下溢,再在更新前恢复梯度尺度。BF16 与 FP32 的指数位数相同,动态范围接近,但尾数位更少,区分相近数值的能力较弱。
混合精度让不同计算或存储使用不同 dtype。本节按课堂示例,采用 BF16 参数与梯度、FP32 Adam 状态来估算显存。Adam 状态涉及平方和跨步累积,需要更高精度;实际训练框架也可能保留 FP32 参数或额外的主参数副本,应按真实存储方式计算。
softmax 把一组未归一化分数(logits)转换成概率:
\[p_i=\frac{e^{z_i}}{\sum_j e^{z_j}} =\frac{e^{z_i-m}}{\sum_j e^{z_j-m}},\qquad m=\max_j z_j\]等式成立,是因为分子分母同时除以了 $e^m$。减去最大值后,最大的指数项是 $e^0=1$,可以避免对很大的正数直接求指数:
import torch

logits = torch.tensor([1000.0, 1001.0, 999.0], dtype=torch.float64)
# 手动展开计算:先移到 [-1, 0, -2],再求指数并除以总和。
shifted = logits - logits.max()
exp_scores = shifted.exp()
p = exp_scores / exp_scores.sum()
print([round(v, 4) for v in p.tolist()])  # [0.2447, 0.6652, 0.09]
# 假设正确类别是索引 1,则负对数似然为 -log(该类别的概率)。
print(-torch.log(p[1]).item())            # 0.40760596444438046
这里三个 logits 最大只差 2,问题在于它们的绝对值接近 1000,直接计算 exp(1001) 会溢出。减去 1001 后,概率保持不变,计算也能正常完成。PyTorch 的 torch.softmax 已包含稳定计算;这段手动展开的代码用于说明原理。
2.2 从矩阵乘法到 6ND
FLOPs 是浮点运算次数,衡量一项任务需要多少计算;FLOP/s 是每秒浮点运算次数,衡量计算速度。计算量除以实际计算速度,才得到耗时。
设线性层为 $Y=XW$,$X$ 的形状是 $T\times d$,$W$ 的形状是 $d\times k$。这里 $T$ 是一次处理的 token 数;批量大小为 $b$、序列长度为 $s$ 时,$T=bs$。
输出共有 $Tk$ 个元素,每个元素是两个长度为 $d$ 的向量做点积,约需 $d$ 次乘法和 $d$ 次加法,所以前向计算量约为 $2Tdk$。矩阵 $W$ 有 $dk$ 个参数,因此也可以写成“token 数 × 参数量 × 2”。这与一般矩阵乘法的 $2MKN$ 估算是同一规则。
反向传播需要计算输入梯度和权重梯度。若从下一层传来的梯度是 $G=\partial\mathcal L/\partial Y$,则两项分别是 $GW^\top$ 和 $X^\top G$。它们的矩阵形状不同,但各自都约需 $2Tdk$ 次运算。前向一次、反向两次,合起来就得到系数 6。
\[\text{训练总 FLOPs} \approx 6ND\]这里统一用 $N$ 表示模型参数量,$D$ 表示训练中处理的 token 总数。估算一步训练时,$D$ 取这一步的 token 数;估算整个训练过程时,$D$ 取所有步骤的总量。例如 $10^8$ 个参数处理 $10^9$ 个 token,约需 $6\times10^{17}$ FLOPs。
这个近似适用于线性层计算占主导的稠密模型。长上下文的注意力计算、激活重计算和优化器更新等,需要按具体配置另计。FLOPs 回答的是“要算多少”,下面再计算“要存多少”。
2.3 训练显存:参数、梯度、优化器状态与激活
Adam 为每个参数保存两份历史统计:一阶矩 $m$ 是梯度的指数移动平均,二阶矩 $v$ 是梯度平方的指数移动平均。它们与参数、梯度一起,构成这里核算的训练状态。
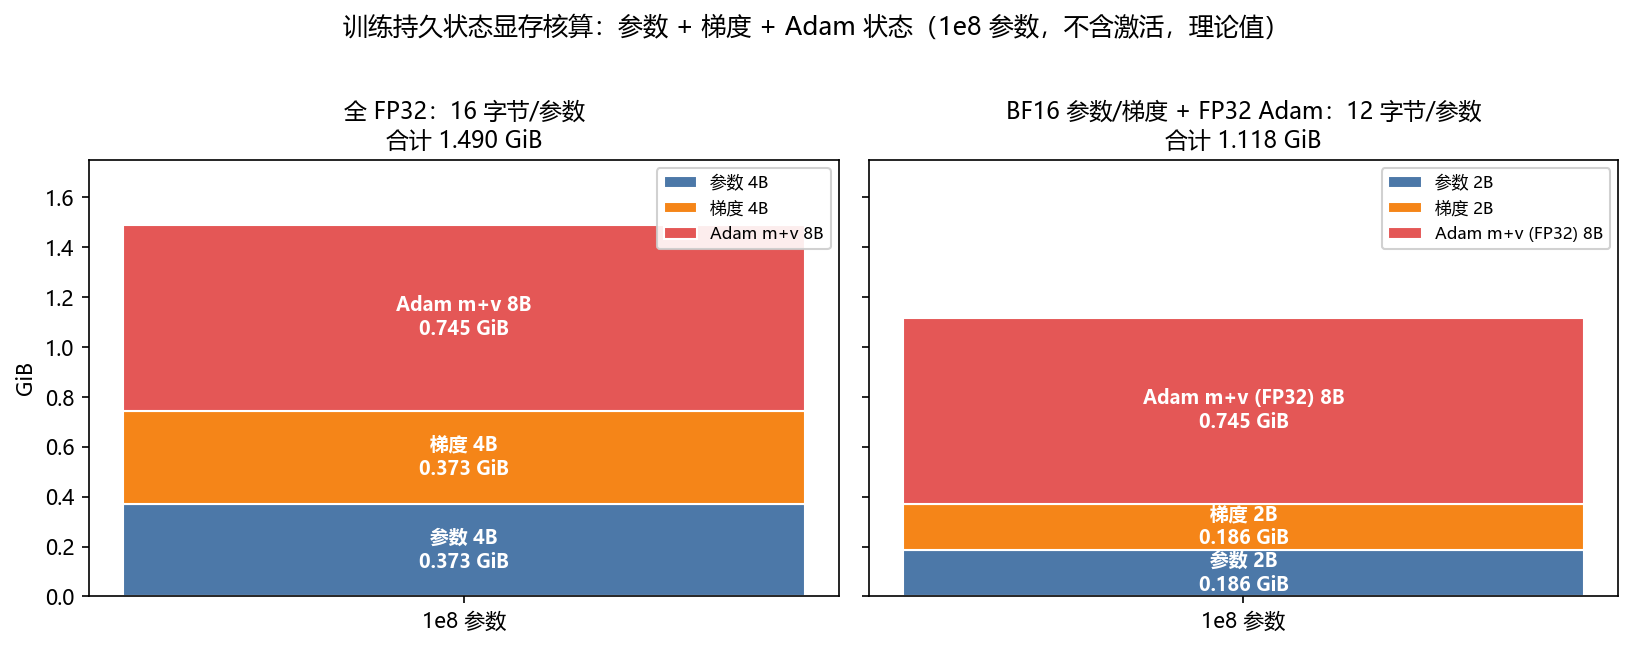
全 FP32 时,参数、梯度、$m$、$v$ 各占 4 字节,合计 16 字节/参数。若参数和梯度用 BF16,两个 Adam 状态仍用 FP32,则是 $2+2+4+4=12$ 字节/参数。这两种计算都没有包含激活和临时缓冲;如果还保存额外的 FP32 主参数副本,每参数需再加 4 字节。
以一亿个参数为例,GiB 的换算单位是 $2^{30}$ 字节:
N = 100_000_000  # 一亿个参数;下划线只为方便阅读
# 括号内依次是参数、梯度、Adam 的 m/v 所占字节,除以 2**30 转为 GiB。
print((4 + 4 + 8) * N / 2**30)  # 1.4901161...:全 FP32
print((2 + 2 + 8) * N / 2**30)  # 1.1175870...:BF16 参数/梯度,无主参数副本
即全 FP32 约 1.490 GiB,混合精度约 1.118 GiB。
课堂还举了 8 张 80 GB H100 的例子。按每参数 12 字节、训练状态能在八张卡之间完全分片计算,总容量上限是 $8\times80\times10^9/12\approx53.3$ 十亿参数;单卡是约 6.67 十亿参数。GB 在这里按 $10^9$ 字节计算。实际还需给激活、通信和临时张量留空间,不能直接把这个上限当作可训练规模。
多张卡也不一定会减少每卡的状态占用。普通数据并行(DDP)让每张卡保存完整模型和优化器状态,各自处理不同数据,再同步梯度。ZeRO 则逐步将这些状态分片。下面回到全 FP32 假设,计算一亿参数、四张卡时的每卡占用:
N, w = 100_000_000, 4  # N 为参数量,w 为数据并行卡数
# 未分片的项保留原字节数;分片的项除以 w,得到每卡持有的份额。
print((4 + 4 + 8)         * N / 2**30)   # 1.4901  DDP(不切)
print((4 + 4 + 8 / w)     * N / 2**30)   # 0.9313  ZeRO-1(切优化器状态)
print((4 + 4 / w + 8 / w) * N / 2**30)   # 0.6519  ZeRO-2(再切梯度)
print(((4 + 4 + 8) / w)   * N / 2**30)   # 0.3725  ZeRO-3(连参数一起切)
ZeRO-1 分片优化器状态,ZeRO-2 再分片梯度,ZeRO-3 再分片参数。阶段越高,持久保存的状态越少,但计算时需要更多状态收集与通信安排。表中的公式给出理想均匀分片后的持久占用,实际峰值还包含激活、通信缓冲和临时收集的参数。
2.4 算术强度与 Roofline:判断计算速度的瓶颈
GPU 做计算前要读取数据,计算后要写回结果。运行速度既受计算能力(FLOP/s)限制,也受显存带宽(字节/秒)限制。算术强度 $I$ 定义为“浮点运算次数 ÷ 搬移字节数”,表示每搬运 1 字节做多少计算。
Lecture 2 使用的 H100 示例取 BF16 稠密算力约 $989.5\times10^{12}$ FLOP/s、HBM(高带宽显存)带宽 $3.35\times10^{12}$ 字节/秒,两者相除约为 295 FLOPs/字节。这个临界值对应这组硬件和精度条件。
- 低于临界值时,理想模型下主要受带宽限制。例如 BF16 的 ReLU 对 $m$ 个元素各读写一次,共搬移 $4m$ 字节;把每次比较记作一次操作,算术强度约为 $m/(4m)=0.25$。即使每个元素做 20 次运算,强度也只有 5,仍远低于 295。
- 高于临界值时,理想模型下主要受计算能力限制。边长为 $m$ 的矩阵相乘,搬移量约为 $O(m^2)$,计算量为 $O(m^3)$,因此强度随 $m$ 增长。大矩阵能更充分地复用读入的数据,这也是批量矩阵运算适合 GPU 的原因。
Roofline 模型把这两种限制写成一个性能上限:
\[\text{可达到的 FLOP/s}\leq \min(\text{峰值 FLOP/s},\ I\times\text{显存带宽})\]图的横轴是算术强度,纵轴是 FLOP/s。左侧上限随算术强度增加,右侧则受到峰值算力限制。实际程序还会有调度、通信等开销,所以可能低于这个上限。
MFU(模型 FLOPs 利用率)用模型有效计算量衡量训练效率:
\[\mathrm{MFU}= \frac{\text{模型每步 FLOPs}/\text{每步耗时}} {\text{所用 GPU 的总峰值 FLOP/s}}\]分子通常不计激活重计算等额外工作,分母要采用相同计算精度下的峰值。课堂把 0.5 作为较好的训练参考值,并指出纯矩阵乘法可能达到 0.8 以上的峰值利用率。较低的 MFU 值得排查,但必须结合模型规模和硬件判断,不能仅凭 0.1 或 0.5 判定程序对错。
2.5 梯度累积与激活重计算:降低激活显存
梯度累积把一个大批次拆成若干微批次。每个微批次计算完就释放其计算图,但保留参数梯度,等全部处理完后再更新一次参数。
假设 8 个样本拆成两个大小为 4 的微批次,各自平均损失为 $\mathcal L_1$、$\mathcal L_2$,那么全批次平均损失是 $(\mathcal L_1+\mathcal L_2)/2$。因此,每个微批次的平均损失都要除以 2,再反向传播。下面比较两种方式得到的梯度:
import torch

torch.manual_seed(0)  # 固定本例的随机初始化与输入
lin = torch.nn.Linear(3, 2, bias=False)  # 每个样本由 3 维映射为 2 维
x = torch.randn(8, 3)                   # 8 个样本,每个样本有 3 个特征
chunks = (x[:4], x[4:])                 # 拆为两个等大的微批次

# 全批次:用均方误差让两个输出都接近 1,记录基准梯度。
lin.zero_grad()
loss_full = ((lin(x) - 1) ** 2).mean()
loss_full.backward()
g_full = lin.weight.grad.clone()  # 复制数值,留作比较

# 累积前清零一次;循环内不清零,也不更新权重。
lin.zero_grad()
for chunk in chunks:
    loss_micro = ((lin(chunk) - 1) ** 2).mean()
    (loss_micro / len(chunks)).backward()  # backward 会把梯度加到已有的 .grad 上
print(torch.allclose(g_full, lin.weight.grad))  # True:在数值容差内相等
本例每个样本独立计算,两个微批次等大,按 $1/k$ 缩放后可以得到相同梯度。若微批次大小不同,应按样本数占比加权;语言模型按有效 token 求平均损失时,应按有效 token 数占比加权。包含 BatchNorm 等跨样本运算时,拆批次还会改变前向计算。梯度累积主要降低激活峰值显存,总计算量并不会因此直接减少。
激活重计算(activation checkpointing)减少的是另一部分存储:前向时只保留部分中间结果,反向时重新计算缺失结果。例如一个各层大小相近的 $L$ 层串行网络,每隔约 $\sqrt L$ 层保留一个检查点,反向时逐段重算,保存的检查点和单段临时激活都约为 $O(\sqrt L)$,额外计算总量约为一次前向,即 $O(L)$。课堂“省一半”的例子针对线性层加 ReLU 的特定存储方案,不能直接用于所有 Transformer。
数据较大时,memmap 可以将文件映射到内存地址空间,按需读取所用部分。GPU 通常异步执行,使用 CPU 时钟测量 GPU 操作前后,应调用 torch.cuda.synchronize() 等待相关任务完成,否则可能只测到任务提交时间。固定随机种子用于控制随机源;完整复现还取决于算法是否确定、软件版本和硬件环境。
3. Transformer 架构:各组件解决什么问题
前两讲说明,序列长度、矩阵形状和数据搬移都会影响成本。Lecture 3 进一步讨论模型组件:怎样在这些资源限制下稳定训练,并学习到有效的表示。
一个 Transformer block 通常先做注意力计算,再做前馈网络(FFN)计算。注意力让不同 token 交换信息;FFN 对每个 token 的向量分别变换。残差连接把子层输出加回输入,归一化则调节向量尺度。
3.1 Pre-Norm:归一化放在子层之前
把注意力或 FFN 子层记作 $F$。残差连接的形式是 $x+F(x)$,即把输入 $x$ 与子层算出的变化量相加。Pre-Norm 与 Post-Norm 的区别,在于归一化放在哪里:
\[\begin{aligned} \text{Post-Norm:}\quad &y=\operatorname{Norm}(x+F(x))\\ \text{Pre-Norm:}\quad &y=x+F(\operatorname{Norm}(x)) \end{aligned}\]Post-Norm 对相加后的整个结果做归一化。Pre-Norm 只先归一化传入 $F$ 的那一份输入,直接相加的 $x$ 保持不变。因此,Pre-Norm 的梯度中有一项可以通过恒等连接传回前层,不必经过子层或归一化运算。这有助于深层网络中的梯度传播。
把它分别应用到注意力和 FFN,就得到一个串行 Pre-Norm block:
\[\begin{aligned} h&=x+\operatorname{Attention}(\operatorname{Norm}_1(x))\\ y&=h+\operatorname{FFN}(\operatorname{Norm}_2(h)) \end{aligned}\]第一步把注意力结果加回 $x$,得到 $h$;第二步以 $h$ 为输入,把 FFN 结果加回 $h$。两次残差连接各自保留本子层的输入。
Xiong 等人(2020)的实验显示,Pre-Norm 在其研究设置中可以减少对学习率预热的依赖。预热指训练初期逐渐增大学习率;现代训练仍常保留这一步,以适应整体优化配置。
另一种选择是在子层计算后、残差相加前归一化,即 $y=x+\operatorname{Norm}(F(x))$。它与上面的 Post-Norm 不同,通常称为 non-residual post-norm。Lecture 3 第 13 页列出 Grok、Gemma 2 等前后都加归一化的变体,以及仅采用 non-residual post-norm 的 OLMo 2。理解这类结构时,应直接看归一化作用于哪一条分支。
3.2 RMSNorm 与去偏置:简化归一化和线性层
LayerNorm 在每个 token 的特征维度上减去均值,再除以加入稳定项后的标准差,最后应用可学习的缩放和平移。RMSNorm 使用均方根(root mean square)调节尺度,省去减均值和平移:
\[y = \frac{x}{\sqrt{\frac{1}{d}\sum_i x_i^2 + \varepsilon}} \cdot \gamma\]其中 $d$ 是向量维度,$\varepsilon$ 是避免分母为零的小常数,$\gamma$ 是每个特征上的可学习缩放系数。均方根的计算顺序就是“平方、求平均、开平方”。
课程引用的实验中,RMSNorm 保持了相近的建模效果,并减少了运算与参数。归一化需要读取、归约和写回向量,FLOPs 少也可能耗时:课堂结合 Ivanov 等人(2023)的图表,举出统计归一化约占 0.17% FLOPs、特定工作负载下却可占约 25% 运行时间的例子。具体加速幅度取决于模型形状和算子实现。
下面暂取 $\gamma=1$,只观察除以均方根这一步:
import torch

def rmsnorm(x, eps=1e-6):
    # 最后一维是每个 token 的特征;keepdim 保留该维,便于逐 token 广播。
    mean_square = x.pow(2).mean(dim=-1, keepdim=True)
    inv_rms = torch.rsqrt(mean_square + eps)  # rsqrt(a) = 1 / sqrt(a)
    return x * inv_rms                       # 本例省略可学习的 gamma

torch.manual_seed(0)
x = torch.randn(2, 5, 8)  # 2 条序列,每条 5 个 token,每个 token 为 8 维
# 沿特征维重新计算 RMS,输出形状为 (2, 5),每个 token 对应一个值。
rms = rmsnorm(x).pow(2).mean(dim=-1).sqrt()
print(rms)  # 本例各值保留 4 位小数为 1.0000;eps 使它们略小于 1
线性层的偏置也可以省去:把 $xW+b$ 改为 $xW$,就少了一组参数和一次加法。课程列举的 Llama 类模型常采用无偏置线性层。这种简化在相关训练实验中有效;它是否加快某个程序,还取决于偏置加法是否已经融合到矩阵乘法中。
3.3 SwiGLU:前馈网络中的门控与参数量
普通 FFN 先把 token 向量从 $d_{model}$ 维映射到 $d_{ff}$ 维,经过激活函数,再映射回来。使用 ReLU 时,公式是 $\max(0,xW_1)W_2$,其中 ReLU 将负数置零,正数保持原值。
SwiGLU 增加一条并行分支,两条分支的结果逐元素相乘,再投影回原维度:
\[FF_{SwiGLU}(x) = \big(\text{SiLU}(xW_{gate}) \otimes (xW_{up})\big) W_{down}\]$\otimes$ 表示对应位置的数相乘。$xW_{up}$ 生成中间特征,$\operatorname{SiLU}(xW_{gate})$ 生成调节这些特征的系数,最后由 $W_{down}$ 映射回 $d_{model}$ 维。这里 $\operatorname{SiLU}(u)=u\,\operatorname{sigmoid}(u)$,$\operatorname{sigmoid}(u)=1/(1+e^{-u})$。门控系数会随输入变化,也不只取 0 和 1。
Shazeer(2020,arXiv:2002.05202)在控制参数量的实验中比较了 GLU 变体,SwiGLU、GeGLU 等相对 ReLU/GELU 基线表现更好。GPT-3 使用的非门控 FFN 也能有效训练;门控是改变前馈层表达方式的一种选择。
为什么 SwiGLU 常把中间维度设为约 $2.67d_{model}$?忽略偏置,普通 FFN 的两个矩阵共有 $2d_{model}d_{ff}$ 个参数;取 $d_{ff}=4d_{model}$ 时,就是 $8d_{model}^2$。SwiGLU 有三个矩阵,共 $3d_{model}d_{ff}$ 个参数。令二者相等:
\[3d_{model}d_{ff}=8d_{model}^2 \quad\Longrightarrow\quad d_{ff}=\frac83d_{model}\]因此,“缩到原来的 $2/3$”来自等参数量比较。实际配置可以不同:课件第 38 页列出的 Qwen 14B 比例为 2.67、Yi 34B 为 2.85、PaLM 为 4、Mistral 7B 为 3.5。采用门控后是否节省计算,要结合所选中间维度判断。
3.4 RoPE:用旋转表达相对位置
注意力通常从每个 token 的隐藏向量生成 Q(query,查询)、K(key,键)和 V(value,值)。Q 与 K 的点积给出相关性分数,softmax 将分数转换成权重,再用权重对 V 加权求和。
如果既没有位置编码,也没有因果掩码等顺序约束,全注意力只根据内容计算:把输入重新排序,输出也随之按相同方式重排。这叫置换等变。语言需要区分先后和距离,因此模型通常显式加入位置信息。因果掩码限制“只能看当前位置及之前”,位置编码则进一步表示具体位置或间距。
原始 Transformer 将正弦位置向量加到输入上,GPT-2 使用可学习的绝对位置向量,T5 则按相对距离给注意力分数加偏置。RoPE 采用另一种方式:直接旋转参与点积的 Q 和 K。
RoPE(Su et al. 2021,arXiv:2104.09864)把向量坐标两两配对,每对按“位置 × 频率”旋转;不同坐标对使用不同频率,形成不同变化尺度的位置特征。设 $R_i$ 是位置 $i$ 对应的旋转矩阵,固定内容向量为 $q,k$,则:
\[(R_iq)^\top(R_jk)=q^\top R_i^\top R_jk=q^\top R_{j-i}k\]两个位置共同增加相同的偏移时,$j-i$ 不变,点积也不变。点积仍然取决于内容向量 $q,k$,只是其中的位置影响通过相对距离出现。RoPE 在各注意力层的 Q、K 上应用旋转,与在输入上加位置向量的做法不同。
用一个二维对就可以把两个核心性质演示出来(真实实现里每个维度对用不同频率,这里取频率 1):
import math
import torch

def rot(v, pos, freq=1.0):
    a = pos * freq  # 位置乘频率,得到弧度制旋转角
    c, s = math.cos(a), math.sin(a)
    # 二维旋转矩阵左乘向量:改变方向,保留向量长度。
    return torch.tensor([[c, -s], [s, c]], dtype=torch.float64) @ v

# 固定内容向量,只改变位置,才能单独检验位置编码的性质。
v = torch.tensor([0.6, 0.8], dtype=torch.float64)
w = torch.tensor([-0.3, 0.5], dtype=torch.float64)

print(v.norm().item(), rot(v, 7).norm().item())  # 1.0 1.0,旋转前后长度相同
# @ 对两个一维向量表示点积;item() 将单元素张量转成 Python 数值。
print((rot(v, 2) @ rot(w, 3)).item())           # -0.3355278,位置差 1
print((rot(v, 10) @ rot(w, 11)).item())         # -0.3355278,位置差仍为 1
print((rot(v, 2) @ rot(w, 11)).item())          # -0.4229926,位置差改为 9
第二、三次输出相同,因为内容向量没变,位置差也都是 1。这里不能换成任意两对词再断言点积相同,不同内容对应的 Q、K 可以不同。
上述性质描述的是固定 Q、K 的旋转后点积;整个语言模型还包含上下文相关的隐藏状态和掩码。长度外推,即处理比训练时更长的序列,也需要单独验证或采用位置缩放、插值等方法。课件第 33 页还介绍了仅旋转部分坐标的变体;滑动窗口与 RoPE/NoPE 的组合见 3.7。
3.5 超参数:前馈维度、注意力头数与层数
超参数是训练前选定的配置,例如层数、向量维度、注意力头数,与通过梯度更新的权重不同。Lecture 3 结合模型配置表和参数扫描实验给出参考范围:
- 前馈比例:普通 FFN 常取 $d_{ff}=4d_{model}$,等参数量的 GLU 常取约 $2.67d_{model}$。Kaplan 等人(2020)在所测试配置中发现,比例约为 1 到 10 时损失变化较小。T5 11B 则取 $65536/1024=64$,希望利用更大的矩阵提高硬件利用率;后续 T5 v1.1 采用了更接近常见配置的 2.5。硬件利用率高与总计算成本低,是两个不同指标。
- 头维度与头数:常见配置满足 $d_{head}h=d_{model}$,即所有头拼接后的维度等于模型维度。例如 8 个头、每头 64 维,拼接后就是 512 维。这个等式是常用配置,不是矩阵计算的必要条件;课件列出的 T5 和 LaMDA 比率分别为 16 和 2。
- 宽深比:$d_{model}/n_{layer}$ 比较隐藏向量维度与层数。课件列出的 GPT-3 为 128、LLaMA 为 102、PaLM 为 156、BLOOM 为 205,也有低于 100 的模型。增加深度会增加串行计算和层间并行安排的难度;固定预算下增加宽度,则会改变能分配给深度的参数量。应把配置与硬件效率一起考虑。
- 正则化:Dropout 在训练时随机屏蔽部分激活,权重衰减则在更新时使参数趋向较小的值。在大规模、单遍、计算受限的预训练设置中,课程所列许多模型不使用 Dropout,但仍使用权重衰减。Andriushchenko 等人(2023)的实验表明,权重衰减还会与优化器和学习率调度相互作用,影响收敛,而不只是控制过拟合。
3.6 训练稳定性:z-loss、QK-Norm 与 soft-capping
语言模型中有两类 softmax:输出端把词表分数转换为下一个 token 的概率,注意力端把 QK 分数转换为各位置的权重。2.1 节的减最大值解决指数计算溢出;下面的方法进一步约束训练中的分数尺度。
输出端的 z-loss 在原损失上增加 $\lambda(\log Z)^2$,其中 $Z=\sum_j e^{z_j}$,$\lambda$ 控制惩罚强度。所有 logits 同时加上常数,softmax 概率不变,但 $\log Z$ 会改变;z-loss 因而能约束这部分漂移,使 $\log Z$ 接近 0。实现时仍要稳定计算 $\log Z$。课件第 54 页将这一方法追溯到 Devlin(2014),并列出 PaLM、Baichuan 2、DCLM、OLMo 2/3 等采用案例。
注意力端的 QK-Norm 在 Q、K 做点积前分别归一化,例如使用 RMSNorm,从输入向量的尺度控制打分幅度。课件第 55 页介绍了视觉、多模态模型中的相关工作,并列出 DCLM、OLMo 2、Gemma 2、Qwen3 等语言模型案例。它与 block 入口处的 Pre-Norm 作用位置不同。
logit soft-capping 直接把分数 $x$ 变换为 $c\tanh(x/c)$,其中 $c>0$ 控制范围。变换后的分数位于 $(-c,c)$,接近边界时平滑饱和。课程以 Gemma 系列说明这种方法,并讨论了它对分数表达范围的约束:限制过强会妨碍模型拉开分数差距。课程转述的比较实验中,QK-Norm 的效果略优于仅做 soft-capping。
这些方法作用不同:减最大值改变计算方式而保留概率;z-loss 增加训练目标;QK-Norm 调节 Q、K;soft-capping 直接改变进入 softmax 的分数。
3.7 推理效率:KV Cache、GQA 与滑动窗口
训练时,完整文本已经给定,可以并行计算多个位置的预测。普通自回归解码时,同一条序列的下一个 token 依赖刚生成的 token,因此逐步进行;不同请求仍可组成批次一起处理。
KV Cache 保存各层历史 token 的 K、V,避免每一步重新计算历史表示。新 token 进入一层后,生成自己的 Q、K、V,将新 K、V 加入缓存,用 Q 与可见的 K 计算权重,再对 V 加权求和。缓存大小会随已处理的序列长度增加。
解码每步处理的新位置很少,却要读取模型权重和历史缓存,因此容易受带宽限制。Lecture 3 第 60 页在 $n<d$、投影计算占主导的简化假设下,估算生成长度为 $n$ 的序列所需计算量为 $O(bnd^2)$,访存量为 $O(bn^2d+nd^2)$。其中 $b$ 是批量大小,$d$ 是隐藏维度。两者相除:
\[I\sim\frac{bnd^2}{bn^2d+nd^2} =\left(\frac nd+\frac1b\right)^{-1}\]这里省略了常数和每元素字节数。增大批量会减小 $1/b$ 项,提高权重的复用程度;序列变长会增加读取缓存的负担。这个简化式描述上述假设下的比例关系,不能直接当作任意长上下文的完整耗时公式。
KV Cache 容量可以按各维相乘计算:
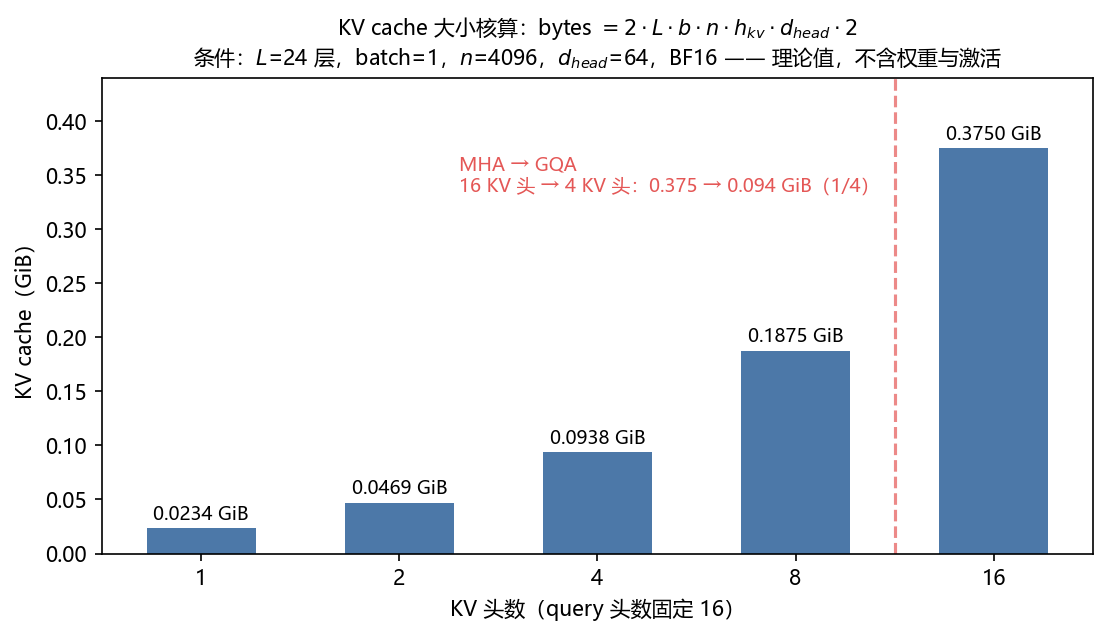
\[\text{KV Cache 字节数}=2Lbn h_{kv}d_{head}s\]$L$ 是层数,$b$ 是批量大小,$n$ 是缓存长度,$h_{kv}$ 是 KV 头数,$d_{head}$ 是每个头的维度,$s$ 是每个元素的字节数。最前面的 2 表示 K 和 V 两份。这里各层配置相同,缓存未量化:
def kv_bytes(layers, batch, length, kv_heads, head_dim, element_bytes=2):
    # 单层 K 的形状可写作 (batch, kv_heads, length, head_dim)。
    # V 同样大,故乘 2;再乘层数与每元素字节数,得到总字节数。
    return 2 * layers * batch * length * kv_heads * head_dim * element_bytes

# 保持 24 层、1 条序列、4096 个位置、每头 64 维,只改变 KV 头数。
# element_bytes 默认是 2,对应 BF16 或 FP16;除以 2**30 转为 GiB。
mha = kv_bytes(24, 1, 4096, 16, 64) / 2**30  # MHA:16 个查询头配 16 个 KV 头
gqa = kv_bytes(24, 1, 4096, 4, 64) / 2**30   # GQA:16 个查询头共享 4 个 KV 头
print(mha, gqa, mha / gqa)                    # 0.375 0.09375 4.0
减少 KV 头数,可以直接减少缓存。三种注意力的差别是:
- MHA(多头注意力):每个查询头有对应的 K、V 头。
- MQA(多查询注意力):所有查询头共享一组 K、V。Shazeer(2019)用它减少解码访存;模型质量可能随共享程度和任务发生变化。
- GQA(分组查询注意力):保留多个 KV 头,同组查询头共享 K、V。例如 16 个查询头配 4 个 KV 头,每 4 个查询头共享一组 K、V。Ainslie 等人(2023,arXiv:2305.13245)的实验中,GQA 质量接近 MHA、速度接近 MQA;将已有 MHA 模型继续训练为 GQA,使用了约 5% 的原预训练计算量。
同一条件下 KV 头从 16 降到 4,缓存正好缩到 1/4:
滑动窗口注意力(SWA)从另一个方向降低开销:每个位置只关注附近固定窗口中的 token。全序列注意力的交互数为 $O(n^2)$,窗口大小为 $w$ 时则为 $O(nw)$。单层窗口之外的位置无法直接交互,多层堆叠可以逐步扩大信息覆盖范围。
课件第 65 页以 Cohere Command A 为例:每四层中一层使用全注意力,其余三层使用滑窗;全局层采用 NoPE(不额外加入显式位置编码),局部层使用 RoPE。课件还列举了 LLaMA 4、Gemma 3/4、OLMo 3 中局部与全局层组合的设计。具体窗口和位置编码安排应以相应模型配置为准。
另一类混合模型用不同的序列模块替代局部注意力,例如课件提到的 Qwen3-Next 使用门控 DeltaNet 与全注意力交替。这里的共同思路是让较低成本的层处理多数变换,再通过部分全注意力层建立全局交互。
4. 分词、资源与架构之间的关系
分词决定同一段文本需要多少 token,也决定嵌入表有多大。序列长度和参数量进一步影响计算量与显存。架构设计则在这些约束下,选择归一化、前馈层和注意力的具体形式:
| 内容 | 要回答的问题 | 代表结论 |
|---|---|---|
| 文本表示 | 文本怎样切分,词表需要多大 | BPE 在词表规模与序列长度之间取舍;特殊词元单独处理 |
| 资源核算 | 需要多少计算和存储,速度受什么限制 | $6ND$ 估算稠密训练量;按 dtype 逐项计算显存;用 Roofline 分析算力与带宽限制 |
| 架构选择 | 怎样稳定训练并控制推理成本 | Pre-Norm 改变梯度路径;RMSNorm 简化归一化;GQA 减少 KV 缓存;滑窗减少注意力交互 |
例如,更大的词表可以缩短输入序列,却会增加嵌入表和输出层参数;更多 KV 共享可以减少缓存,却会改变注意力的表达方式;激活重计算可以减少显存,却会增加计算量。比较配置时,需要同时说明改变了哪个量,以及其他条件是否保持一致。
CS336 A1(Version 26.0.3,Spring 2026)将这些内容对应到 BPE 分词器、Transformer、交叉熵和 AdamW 等实现任务。前三讲提供的依据分别是:文本表示规则、资源计算方法,以及组件选择的原理和实验经验。
附 · 参考与延伸
课程与官方材料
- CS336 课程主页(2026 春季),Lecture 1/2/3 分别为 Overview+Tokenization、PyTorch+资源核算、架构与超参数
- 官方讲义仓库 stanford-cs336/lectures(lecture_03.pdf)与 assignment1-basics(A1 讲义 Version 26.0.3)
论文(正文引用处已标注)
- Sennrich et al., Neural Machine Translation of Rare Words with Subword Units(BPE 引入 NLP): arXiv:1508.07909
- Shazeer, GLU Variants Improve Transformer: arXiv:2002.05202
- Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding(RoPE): arXiv:2104.09864
- Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models(GQA): arXiv:2305.13245
- Kaplan et al., Scaling Laws for Neural Language Models: arXiv:2001.08361;Xiong et al. 2020(Pre-LN 收敛)、Andriushchenko et al. 2023(权重衰减)、Ivanov et al. 2023(归一化运行时间占比)见课件引用