· makemore / WaveNet / CNN / 感受野 / FlattenConsecutive / BatchNorm / PyTorch
Day10:不用 Conv1d,手拼一台层级 CNN——感受野 1→2→4→8
前言
这次我想把上下文从 3 个字符拉长到 8 个。沿用前面的 MLP 当然能做,但首层输入也跟着变宽了,有没有另一种组织方式?
最省事的办法是把 8 个字符拍平直接喂 MLP——但首层就是 8×24 的全连接,每个字符跟其他字符平等相待,模型必须自己从零发现「相邻字符更像一家人」这件事实。这一讲的做法恰好相反:先固定「相邻成对」这个局部结构,再让它逐层放大。不引入 torch.nn.Conv1d,只用 FlattenConsecutive + 共享 Linear 就能手拼出一台「逐级两两合并」的层级 CNN,感受野 1→2→4→8。
上一篇刚手写完 26 个梯度,这一篇正好练手:看清「为什么能这样堆」,比记住「怎么堆」更重要。
1. 主角:FlattenConsecutive
先说这一讲唯一的新零件。它做的事情一句话能说完:把时间上相邻的 n 个位置并成一行更宽的特征。
输入 (B,T,C),输出 (B, T/n, C×n)。无参数、无新数据,只是 view 重新解释内存——所以它对可解释性、对梯度都没有任何额外影响。上加两个小处理:
- 只剩一行时
squeeze(1)去掉中间维,好接只认 2D 的自定义Linear; - 与
torch.nn.Flatten的区别:后者把整个样本拍成一长向量,前者只做「局部两行合并」,保留 batch、时间维减半。
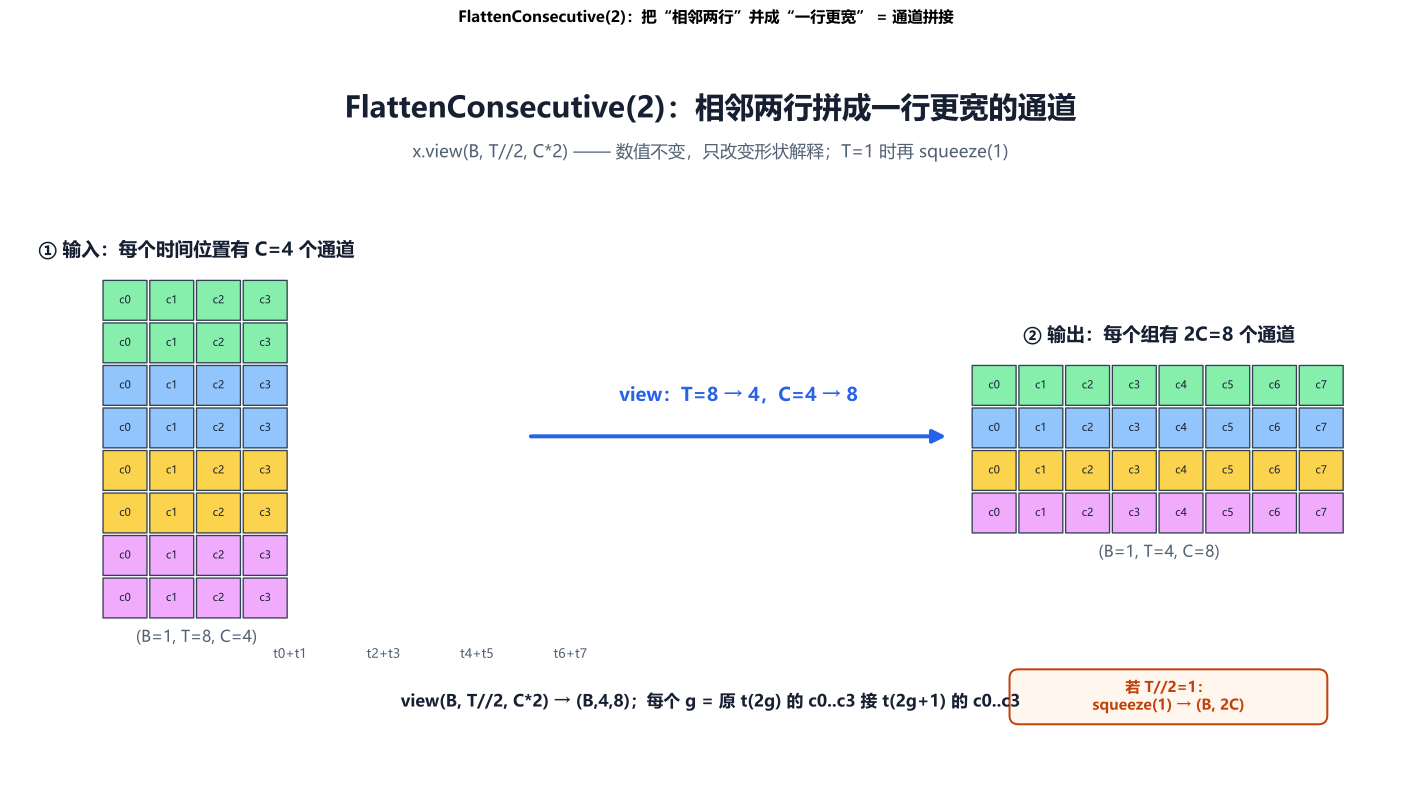
图 1:左为 view 前 (T=8,C=4),同色两行将被拼成一组;右为 view 后 (T=4,C=8),每组 =
t_{2g}的 c0..c3 接t_{2g+1}的 c0..c3——数值一个没变,只是形状重解释。
2. 它「等于」一个卷积
把 (B,T,C) 当成一张一维特征图,FlattenConsecutive(2) + Linear(2C→H) 的组合可以写成一行公式:
每个时间组都用同一份权重做 W·[x_t; x_{t+1}]——这正是 kernel=2、stride=2、无 padding 的一维卷积。也就是说这套写法在数学上等价于:
nn.Conv1d(in_channels=C, out_channels=H, kernel_size=2, stride=2, padding=0)
两处对应关系值得记住:
- 权重共享 → 平移等变。同一个
Linear在所有组上复用,跟卷积核在整条序列上滑动的效果一致; - 权重可以逐项对应。
Linear(48→128)有48×128=6144个权重;本例设置了bias=False,没有额外偏置,与后面的参数表一致。
三层堆叠就是三层 stride-2 的卷积树,宏观上和膨胀卷积、小波树是同一类结构。不用先吃透卷积的推导,只用这 20 行代码就能摸到 CNN 的数据流——这是它作为教学素材的价值所在。
3. 感受野 1→2→4→8
三层合并的信息流很有节奏感:
- 第一次合并,每个输出组拿到 2 个字符的信息;
- 第二次把两个「2 字符组」并成「4 字符组」;
- 第三次得到「8 字符组」。
信息不是一次看全,而是两两配对、逐层加宽。低层只认局部小模式(某两个相邻字符的组合),高层才有资格把它们组合成更长范围的规律——这就是「感受野」直观的来历。
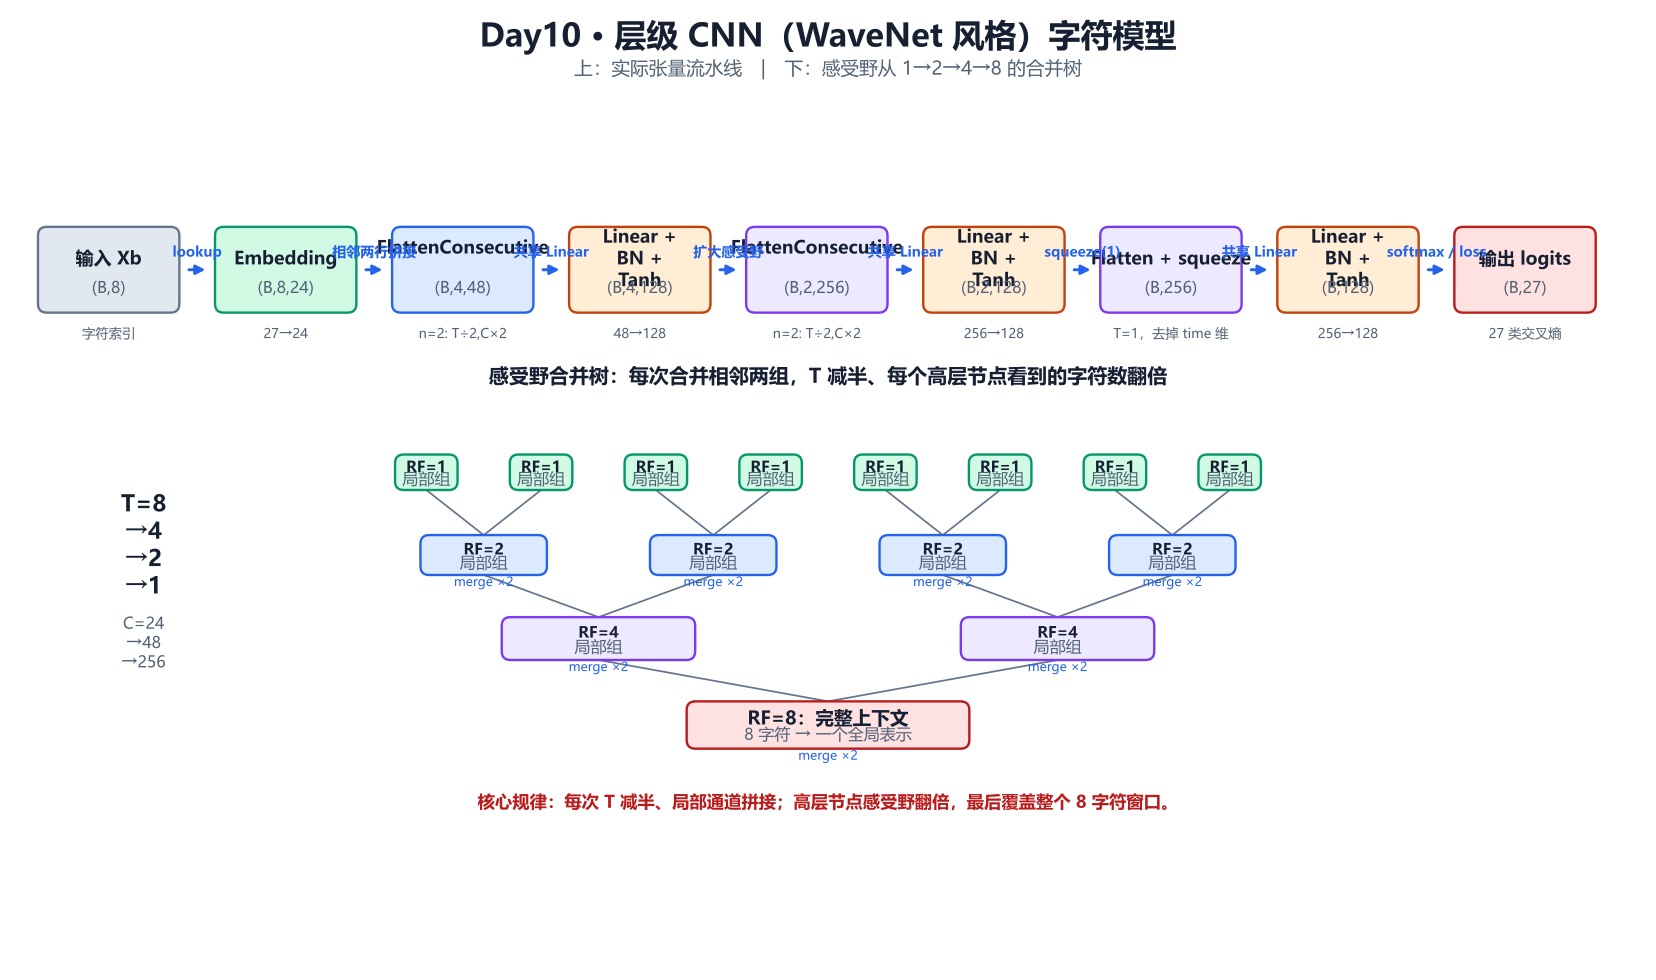
图 2:逐级两两合并的数据流。绿=embedding(24)、蓝=两字符拼接(48)、橙=隐层(128)、紫=4/8 字符拼接(256)、红=logits;左侧感受野 1→2→4→8。
顺带讲一个被这一讲逼出来的改动:BatchNorm 的 3D 分支。这一期中间量全是 (B,T,C),手写 BatchNorm1d 必须新增 ndim==3 → dim=(0,1):统计量在 batch 与 time 一起归一(等价于把 B×T 个样本当同一批)。若仍按 2D 的 dim=0 归一,time 维根本不会被标准化——这正是不用 nn 模块的代价,也是好处:被迫看清框架平时替你藏了哪些细节。
4. 搭模型:逐层形状与参数账
模型非常克制的四层结构:
Embedding(27→24)
→ Flatten(2) → Linear(48→128) → BN → Tanh     # (B,8,24)→(B,4,48)→(B,4,128)
→ Flatten(2) → Linear(256→128)→ BN → Tanh     # (B,4,128)→(B,2,256)→(B,2,128)
→ Flatten(2) → Linear(256→128)→ BN → Tanh     # (B,2,128)→(B,1,256)→squeeze→(B,256)→(B,128)
→ Linear(128→27)                                # (B,27)
| 层 | 输入 | 输出 | 参数 |
|---|---|---|---|
| Embedding(27,24) | (B,8) | (B,8,24) | 648 |
| FlattenConsecutive(2) | (B,8,24) | (B,4,48) | 0 |
| Linear(48,128) | (B,4,48) | (B,4,128) | 6,144 |
| BatchNorm1d(128) | (B,4,128) | 同左 | 256 |
| FlattenConsecutive(2) | (B,4,128) | (B,2,256) | 0 |
| Linear(256,128) | (B,2,128) | (B,2,128) | 32,768 |
| BatchNorm1d(128) | 同左 | 同左 | 256 |
| FlattenConsecutive(2) | (B,2,128) | (B,1,256)→(B,256) | 0 |
| Linear(256,128) | (B,256) | (B,128) | 32,768 |
| BatchNorm1d(128) | (B,128) | 同左 | 256 |
| Linear(128,27) | (B,128) | (B,27) | 3,483 |
| 合计 | 76,579 |
这里藏着本次扩容能成功的核心原因:每个 Linear 只连「两个小向量」,fan_in 始终是 48 或 256,不随上下文长度增长。反观整窗 MLP,8 字符就要 8×24 的首层参数,且字符之间毫无结构先验。
两个复用旧结论的细节:
- 三个卷积层都
bias=False——紧邻 BatchNorm(自带 β 作偏置),再加 bias 是冗余(Day8 结论); - 代码里留了一份注释掉的 original network(整窗 MLP:8 字符拍平进 300 隐层)当对照,本期真正用的是 hierarchical network。
5. 训练:三处与之前不同
训练配置大部分沿用前几期:200k 步、batch 32、SGD 无动量、lossi 记 log10 并 1000 步平均。只有三处跟着架构调整:
| 改动 | 之前 | 本期 | 为什么 |
|---|---|---|---|
| lr 衰减点 | 100k | 150k | 结构更深,前期多学一会儿 |
| 随机源 | 独立 generator | 全局 manual_seed(42) |
本期不需要 Day9 那种「手写 vs autograd 对账」的独立随机流 |
| block_size | 3 | 8 | 上下文从 3 个字符扩到 8 个,样本仍是 18.2 万个 |
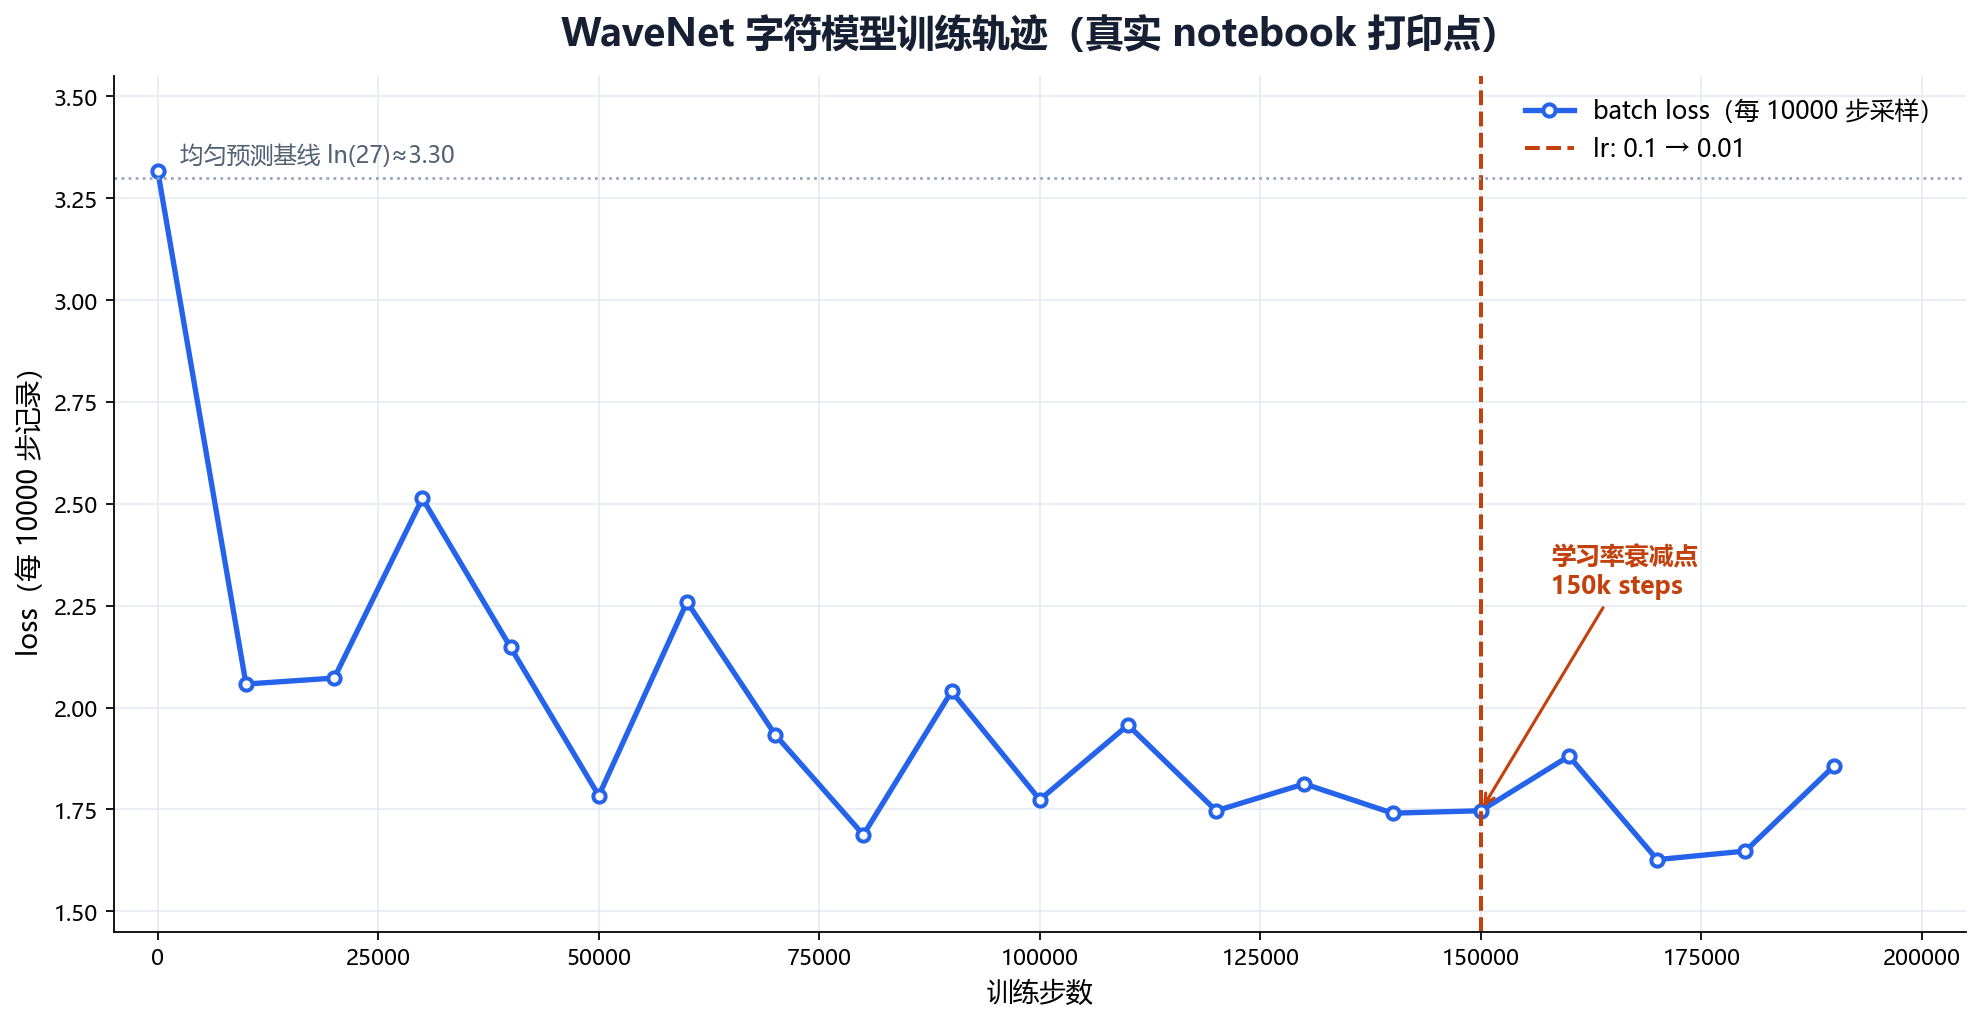
图 3:配图使用 notebook 训练 cell 每 10000 步打印的真实 loss 点重新绘制;橙色虚线是 150k 步学习率衰减点。起点≈3.3,随后在 1.6–2.5 区间波动;batch=32 带来的抖动是正常梯度噪声。
6. 评估与采样:val 从 ~2.17 到 ~1.99
- 切 eval 模式有个坑:自定义层没有
.train(),得遍历所有层把training置False(尤其要让 BatchNorm 改用 running 统计)。框架不代劳,这类事就得自己记着; - 结果:train 1.7690 / val 1.9937;
- 采样与前几期完全一致(context 滑窗 +
torch.multinomial),这一期已经能产出像模像样的完整长名了:hendrix. jamylie. jayce. aubreana. marianah.
7. 与之前项目的对比
| 维度 | 前几期(Day5–Day9)MLP | 本期层级 CNN |
|---|---|---|
| 上下文长度 | 3 | 8 |
| 首层如何看输入 | 整窗拍平、一次全连接 | 两两合并、逐级加宽(1→2→4→8) |
| 局部结构 | 无(字符平等相处) | 有(相邻配对,低层小模式、高层组合) |
| 与卷积的关系 | 无关 | ≈ 三层 kernel=2/stride=2 的 1D 卷积 |
| 中间张量维度 | 2D (B,H) | 3D (B,T,C) |
| BatchNorm | 只归一 batch 维 | 归一 batch+time(新增 3D 分支) |
| Embedding 维 | 10 | 24 |
| 隐层 | 单层 200/300 | 3 级 ×128 |
| 参数 | ~12k | 76,579 |
| lr 衰减点 | 100k | 150k |
| 随机源 | 独立 generator(尤其 Day9) | 全局 seed |
| val loss | ~2.17 | ~1.99 |
差异背后的「为什么」(三句话版):架构换了,所以能吃 8 字符长上下文且代价小,val 随之变好;中间量变 3D,BatchNorm 就必须把 time 维一起归一到同一批;不需要手写梯度对照,就回归全局 seed,训练更长,lr 衰减点跟着后移。
8. 总结与延伸思考
这里的两种写法可以逐项对应:nn.Conv1d 做的局部线性变换,也能拆成 Flatten + 共享 Linear。拆开以后,每一层的时间维和特征维变化都显式呈现在数据流中。
三个可操作的结论:
- 局部两两合并 + 权重共享 = 卷积:先并列变宽再矩阵乘,与滑窗逐项等价;
- 感受野逐级翻倍,每层 Linear 的输入宽度由相邻两组特征决定;继续扩展上下文需要增加层数,总参数量也会相应增长;
- 手写层要自己处理 3D 归一、维度 squeeze 这类 PyTorch 替你做了的事。
结构对比中的三个问题:
FlattenConsecutive(2)换成一次合 4 个字符、或混合步长,等于换一种膨胀卷积树,效果会怎么变?- 本期 stride=2 不重叠,真正的
Conv1d可以 stride=1 重叠——重叠/膨胀版本是信息增益还是过拟合? - 与逐级收缩相比,Transformer 用注意力在允许访问的位置之间直接混合信息,完整注意力矩阵的计算与存储随序列长度呈 O(T²) 增长。固定局部结构与随输入变化的权重,分别适合怎样的信息依赖?
附 · 资料下载
本篇配套 notebook 与一键重跑全部技术示意图的配图脚本:
- WaveNet.ipynb(本期完整 notebook,exec 1–17 全量运行)
- make_figures.py(重绘 CNN 架构图、Flatten 机制图与 loss 采样曲线,需 matplotlib + numpy)
说明:notebook 需与
names.txt放在同一目录运行;配图脚本请放在自身所在目录执行,输出到同级img/。