· makemore / 反向传播 / autograd / BatchNorm / softmax / PyTorch
Day9:MLP的另外一项收尾——重写反向传播
前言
(居然过了这么多节课还不能进入下一步吗?)
ok啊,上次说好的把MLP收个尾,结果还没收好,还有一个点值得细细推敲——loss.backward()。调用它就能得到梯度,可它到底怎么算出来的?这次我把 26 个梯度逐个写出来,与 autograd 对照。softmax 加交叉熵、BatchNorm 这两段尤其长,展开算一遍后,再看融合公式就有来路了。
图 1:前向 + 反向传播全变量计算图(SVG 矢量,可编辑)。上:前向数据流(蓝箭头,边标运算);下:反向梯度流(红箭头,边标梯度规则)。盒内三行为变量/梯度名(形状);橙=参数、灰=数据、红=loss。凡广播、索引取行、多路分支处梯度必须累加——logits / counts / bndiff / hprebn / C 五处
+=即是,手推最容易漏。
1. 对账尺 cmp() 与”防作弊”初始化
实现要点:
cmp(s, dt, t)三个指标:exact(逐元素相等)、approximate(allclose 容差)、maxdiff(最大绝对误差);- 参数刻意非标准初始化(
b1*0.1、W2*0.1、bngain≈1±0.1)——原注释说得直白:全零初始化会掩盖错误的反向实现,参数各异,写错立刻在对账表上现形; - 对 19 个中间量
t.retain_grad()再loss.backward(),一次性拿到全部”参考答案”。
2. 前向拆链(20 个变量)
前向传播被刻意”碎片化”(chunkated):emb → embcat → hprebn → {bnmean, bndiff → bndiff² → bnvar → bnvar_inv → bnraw} → hpreact → h → logits → {logit_maxes → norm_logits} → counts → counts_sum → counts_sum_inv → probs → logprobs → loss。
3. Exercise 1:26 个梯度
沿数据流反向计算,可分成下面五组:
① softmax 链:dlogprobs 是稀疏散布(只有 n=32 个目标位拿到 -1/n);log 的导数是 1/p;广播乘法的反向是对广播维求和(压回 32×1);x⁻¹ 的导数是 -x⁻²;dcounts 两路相加(直连路 + sum 的”全 1 广播”路);exp 的导数还是 exp 本身;logits - logit_maxes 的反向把 -dlogit_maxes 广播给整行,而 max 只把值路由给 argmax 列(用 F.one_hot 掩码加回)。
② 矩阵乘法三规则(h @ W2 + b2,W1 同理):dh = dlogits @ W2.T、dW2 = h.T @ dlogits、db2 = dlogits.sum(0)——口诀:转置重排、对广播维求和。
③ tanh:dhpreact = (1 - h²) * dh——局部梯度 1-tanh²(x),正好用输出 h 表示;这就是 Day8 诊断 tanh 饱和用的同一把尺子。
④ BatchNorm 链(8 个变量):γ/β 广播到 batch 维 → 反向对 batch 维求和;x^(-1/2) 的导数是 -0.5·x^(-3/2);dbndiff2 = 1/(n-1) * dbnvar——Bessel 校正在这里落地;dbndiff 两路相加(bnraw 直连路 + 平方路);dhprebn 也两路(bndiff 路 + 均值路,均值路经 sum 广播回全 batch)。
⑤ Embedding 查表:C[Xb] 索引取行,同一行被 batch 内多个位置查到 → scatter-add:dC[ix] += demb[k,j],双层 for 最直观。
公式:loss 对 logits 的融合梯度(Exercise 2 预告)
\[\frac{\partial L}{\partial\ \mathrm{logits}} = \frac{1}{n}\left(\mathrm{softmax}(\mathrm{logits}) - \mathrm{onehot}(Y_b)\right)\]结果:26 个变量全部 exact: True, maxdiff: 0.0——手写反向传播与 autograd 逐比特一致。
梯度的累加贯穿广播、索引取行和多路分支。这里共五处 +=:dcounts(sum 支路)、dlogits(max 支路)、dbndiff(平方支路)、dhprebn(均值支路)、dC(索引重复)。漏掉任一支路都会使结果与 autograd 不一致。
4. 数值算例:3 个小例子走通 softmax 链
取 logits=[2.0, 1.0, 0.5]、目标类 Y=0、n=1:softmax 后 p=[0.6285, 0.2312, 0.1402],loss = -ln p0 = 0.4644。
| 步骤 | 数值 |
|---|---|
| dlogprobs | [−1, 0, 0](只有目标位) |
| dprobs = dlogprobs/p | [−1.591, 0, 0] |
| dcounts_sum_inv | counts·dprobs 求和 = −1.591 |
| dcounts(两路相加) | [−0.591, 0.231, 0.140] |
| dnorm_logits = counts·dcounts | [−0.3715, +0.2312, +0.1402] |
与融合公式 (softmax − onehot)/n 的结果完全一致(maxdiff=0)。
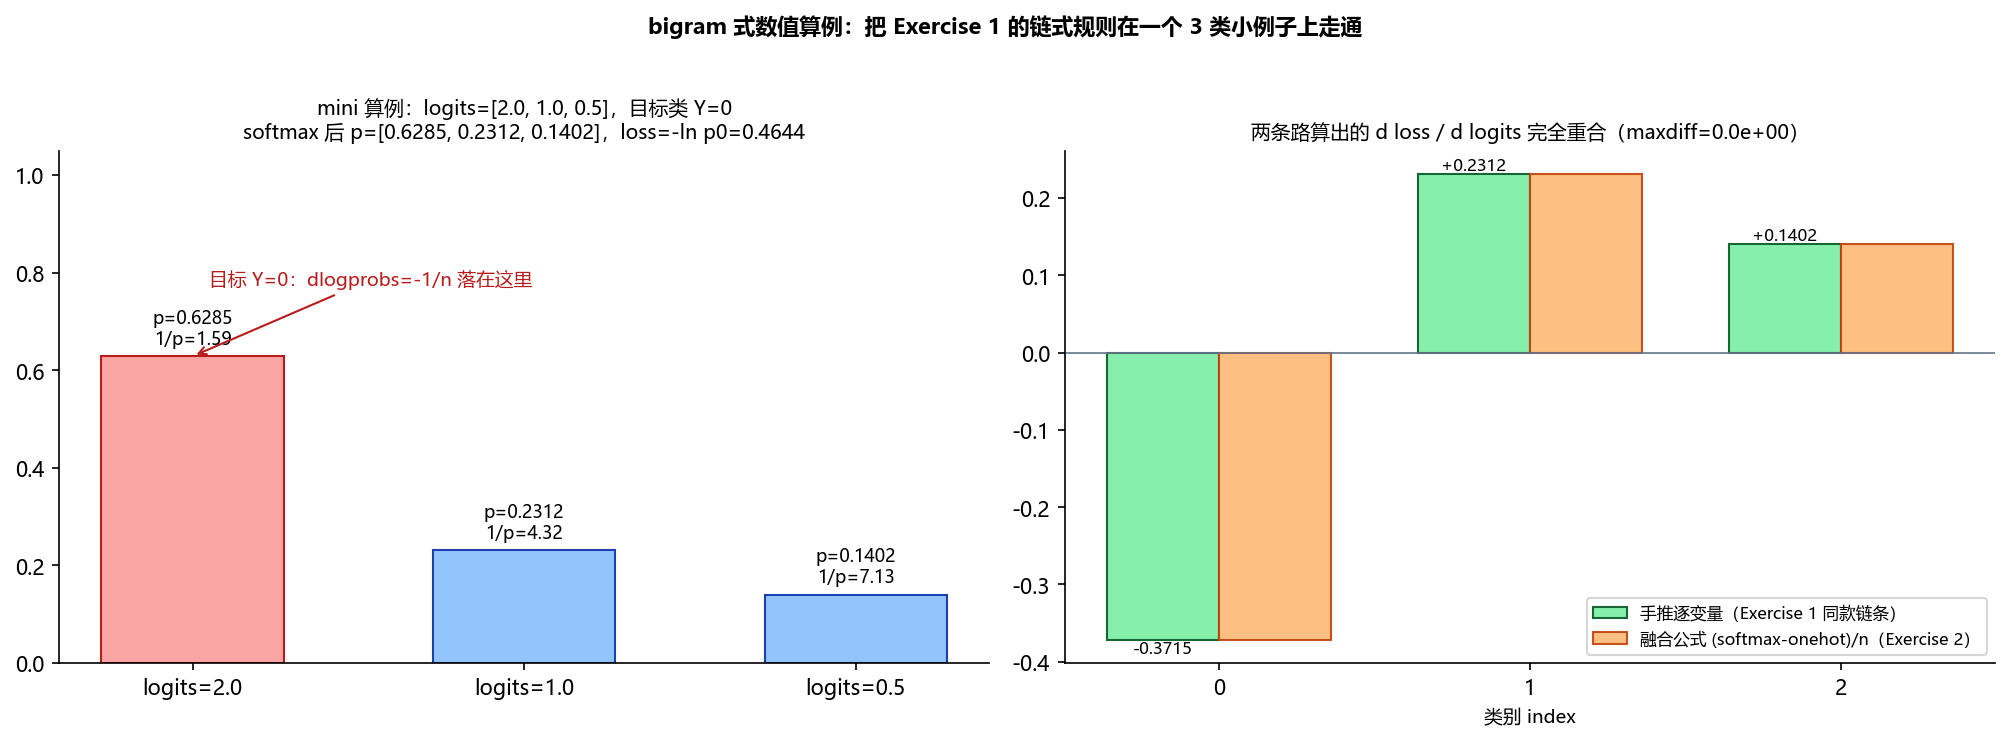
图 2:左——3 类概率与各位置的 1/p 局部梯度(目标位标红,−1/n 落在这里);右——手推逐变量结果 vs Exercise 2 融合公式的对比条形图,两条路完全重合。
5. Exercise 2:softmax + 交叉熵融合成一行
把整条 softmax 链代入 loss 化简,得到开头那条融合公式——”预测概率减目标指示,除以 n“,代码三行:F.softmax(logits, 1) → 目标位 -1 → /= n。
实现要点:cmp 只到 approximate: True(maxdiff≈6e-9)——融合式跳过了 norm_logits / counts_sum_inv 等中间步骤,浮点运算顺序不同。这恰好划清了界限:exact 只属于逐变量手推,融合公式只能力争近似。
6. Exercise 3:BatchNorm 反向压缩成一行
\[\frac{\partial L}{\partial\ hprebn} = \frac{\gamma \cdot bnvar\_inv}{n}\left(n\cdot dhpreact - \sum_i dhpreact_i - \frac{n}{n-1}\cdot bnraw \sum_i (dhpreact_i \cdot bnraw_i)\right)\]括号内三项:直通项(γ·inv 缩放)、均值项(减 μ 的反向)、方差项(除 σ 的反向,系数 n/(n−1) 来自 Bessel 校正)。这一行合并了 Exercise 1 中 8 步链式计算的结果。
7. Exercise 4:接进训练循环
按代码注释里的 TODO 补全四件事:
# YOUR CODE HERE :)填入手写反向(与 Exercise 1-3 同一套公式,逐 batch 重算);loss.backward()按注释 “delete it later!” 删除,梯度全部来自手写公式;- 更新行启用
p.data += -lr * grad(swole doge),旧p.grad写法留作注释对照; - 删除
if i >= 100: break早停,跑满 200000 步(10 万步后 lr 0.1 → 0.01)。
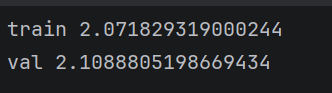
接进 200k 步训练后,保存的评估输出为 train 2.0718、val 2.1089。Notebook 文末注释里的 2.0719 / 2.1162 是另一组参考结果,和这次输出分开记录。
8. 收工小结
- 两个融合范本(softmax+CE、BatchNorm)示范了”长链化简成一行”的推导套路;
- “肌肉记忆”:转置重排、对广播维求和;广播/索引/多路分支处梯度必须累加。
附 · 资料下载
- MLP的另外一项收尾——重写反向传播.ipynb:本期 notebook——前 12 个 cell 为干净内核全量输出(Exercise 1 对账 26 个梯度全部 exact: True),Exercise 4 训练段代码已按 TODO 补全