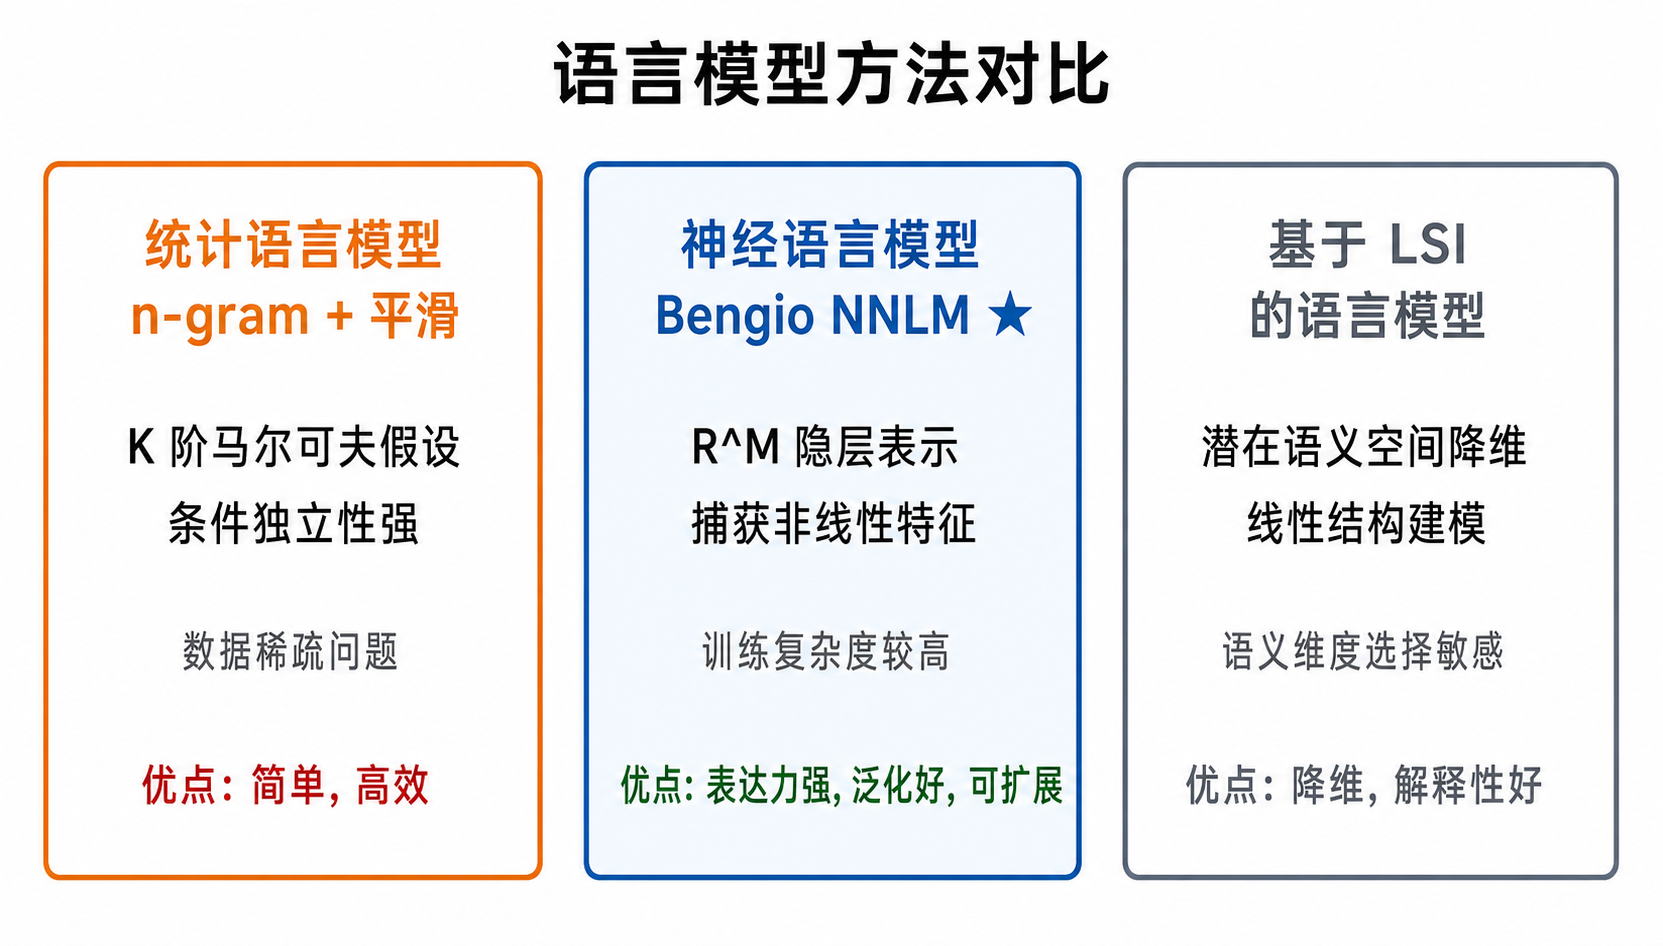
· makemore / Bengio / MLP / Embedding / BatchNorm / PyTorch
Day5:字符级 MLP 实战——把 Bengio 的图跑通在名字上
前言
刚准备开始看卡帕西的MLP部分,结果视频打开上来就告诉我这篇论文讲的不赖,那我势必要去阅读一下了。
Day3 的 bigram 给每个字符存了一行转移概率。这次我想弄清楚,换成一个可学习的向量 C(i) 后,模型多了什么能力。Bengio 2003 把词向量和预测下一个词的网络放在一起训练,正好能接上这个问题;后面再把词换成字符,用名字数据搭一个 MLP。
0. 这篇论文讲了什么
词向量与语言模型联合训练后,查表得到的表示也能随预测目标更新。字符级实现沿用这套结构,将查表、拼接、隐藏层和 softmax 接到字符数据上。
0.1 预备:先把符号一次性讲清(看到后面不再卡住)
本节把论文里反复出现的
V, m, C, g, R, n, h, U, H, W, b, d, x, y用一句话讲清含义、形状与来龙去脉,后面再出现就直接用,不再展开。
| 符号 | 怎么读 | 它是什么 | 形状/取值 | 一句话通俗理解 |
|---|---|---|---|---|
V |
Vocabulary | 词表:所有允许出现的词的集合 | $\lvert V\rvert$,如 17 000 或 100 000 | 一本词典的“目录页”,共 $\lvert V\rvert$ 个词 |
| $R^m$ | R 的 m 次方 | m 维实数向量空间 | $m = 30/60/100$,远小于 $\lvert V\rvert$ | 每个词的“坐标系”,m 是坐标轴根数 |
C |
C 矩阵 | 查表:词 i → 向量 C(i) 的映射表 |
$\lvert V\rvert\times m$ 矩阵,行是词,列是特征 | 一张“词→坐标”的大表格,第 i 行就是词 i 的向量 |
C(i) |
C of i | 词 i 的向量 |
m 维,如 [0.1, -0.3, ...] |
cat 的坐标 |
g |
g 函数 | 神经网络:把上下文向量算成概率 | 输入 $(n-1)m$ 维,输出 $\lvert V\rvert$ 维 | 一台“概率计算器”,输入旧词向量,输出下一个词的概率分布 |
n |
n | 上下文窗口 | 如 3/5/8 | 每次看前面 n-1 个词来猜第 n 个 |
h |
hidden | 隐藏单元数 | 如 50/100 | 隐藏层的“神经元个数” |
H |
H 矩阵 | 隐藏层权重 | h × (n-1)m |
把长向量 x 压进隐藏层的“投影仪” |
U |
U 矩阵 | 隐藏→输出权重 | $\lvert V\rvert\times h$ | 把隐藏层信号“翻译”回词表大小 |
W |
W 直连 | 输入→输出直连权重 | $\lvert V\rvert\times(n-1)m$,可省略 | 一条“捷径”,让 x 直接对输出投票(论文称直连) |
b |
bias 输出偏置 | 输出偏置 | $\lvert V\rvert$ 维 | 每个词的“基础人气分” |
d |
bias 隐藏偏置 | 隐藏偏置 | h 维 |
隐藏层的“起点偏移” |
x |
x 向量 | 上下文拼接向量 | (n-1)·m 维 |
n-1 个词向量排成一排 |
y |
y 向量 | 未归一化分数(logits) | $\lvert V\rvert$ 维 | 每个词的“原始票数”,进 softmax 前 |
y_i |
y 的第 i 维 | 词 i 的分数 |
标量 | 词 i 比别人高多少分 |
| $\lvert V\rvert\times m$ 类记号 | — | 矩阵形状 | 行×列 | 如 $17000\times30$ 就是 51 万个参数 |
三条快速区分
Cvsg:C是记忆(查表得向量),g是计算(向量→概率),合起来f = g∘C才是完整语言模型。C(i)vs $R^m$:C(i)是一个具体向量(如cat的坐标),$R^m$ 是所有这类向量住的空间($m$ 维实数空间)。H/UvsW:H/U走“隐藏层弯路”(非线性,能力强),W走“直连高速路”(线性,快但简单);论文实测直连有益但非必须,核心是C→H→U的主干。
读法小贴士:$R^m$ 读“R 的 m 次方”即 $m$ 维实向量;$C\in\mathbb{R}^{\lvert V\rvert\times m}$ 表示
C住在 $\lvert V\rvert\times m$ 的矩阵空间里。
0.2 这篇论文解决了什么
n-gram 靠“背诵短语”泛化,神经模型靠“词的相似性”泛化。
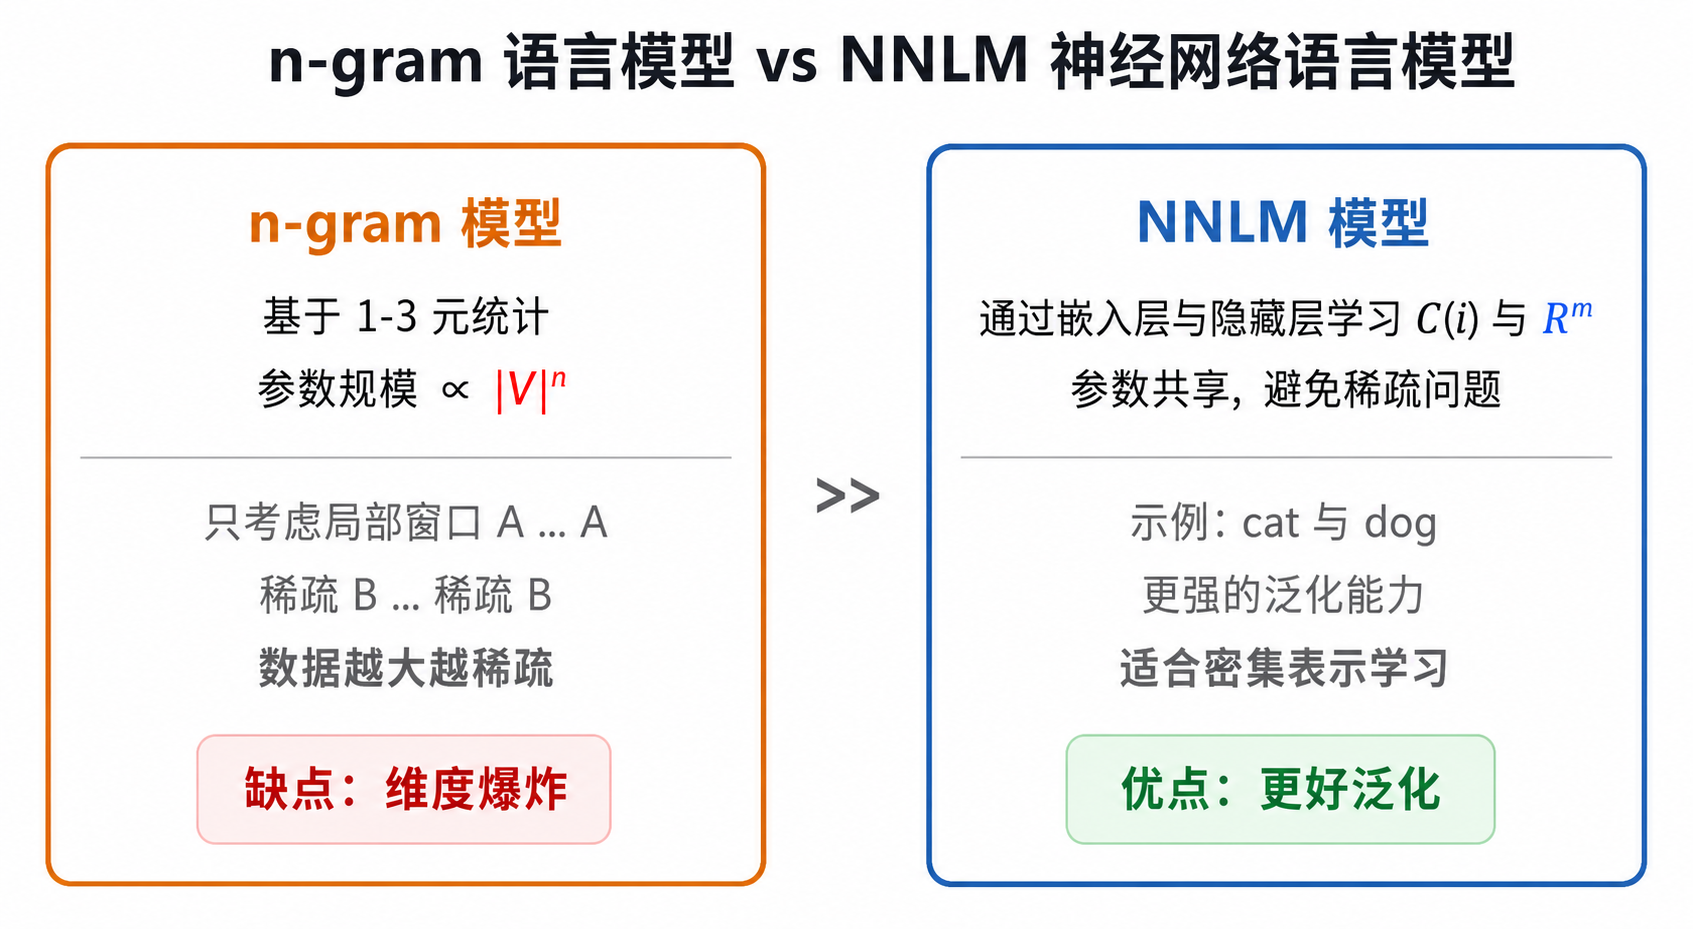
某种意义上,相当于给模型真正加入了“语义”这一概念。
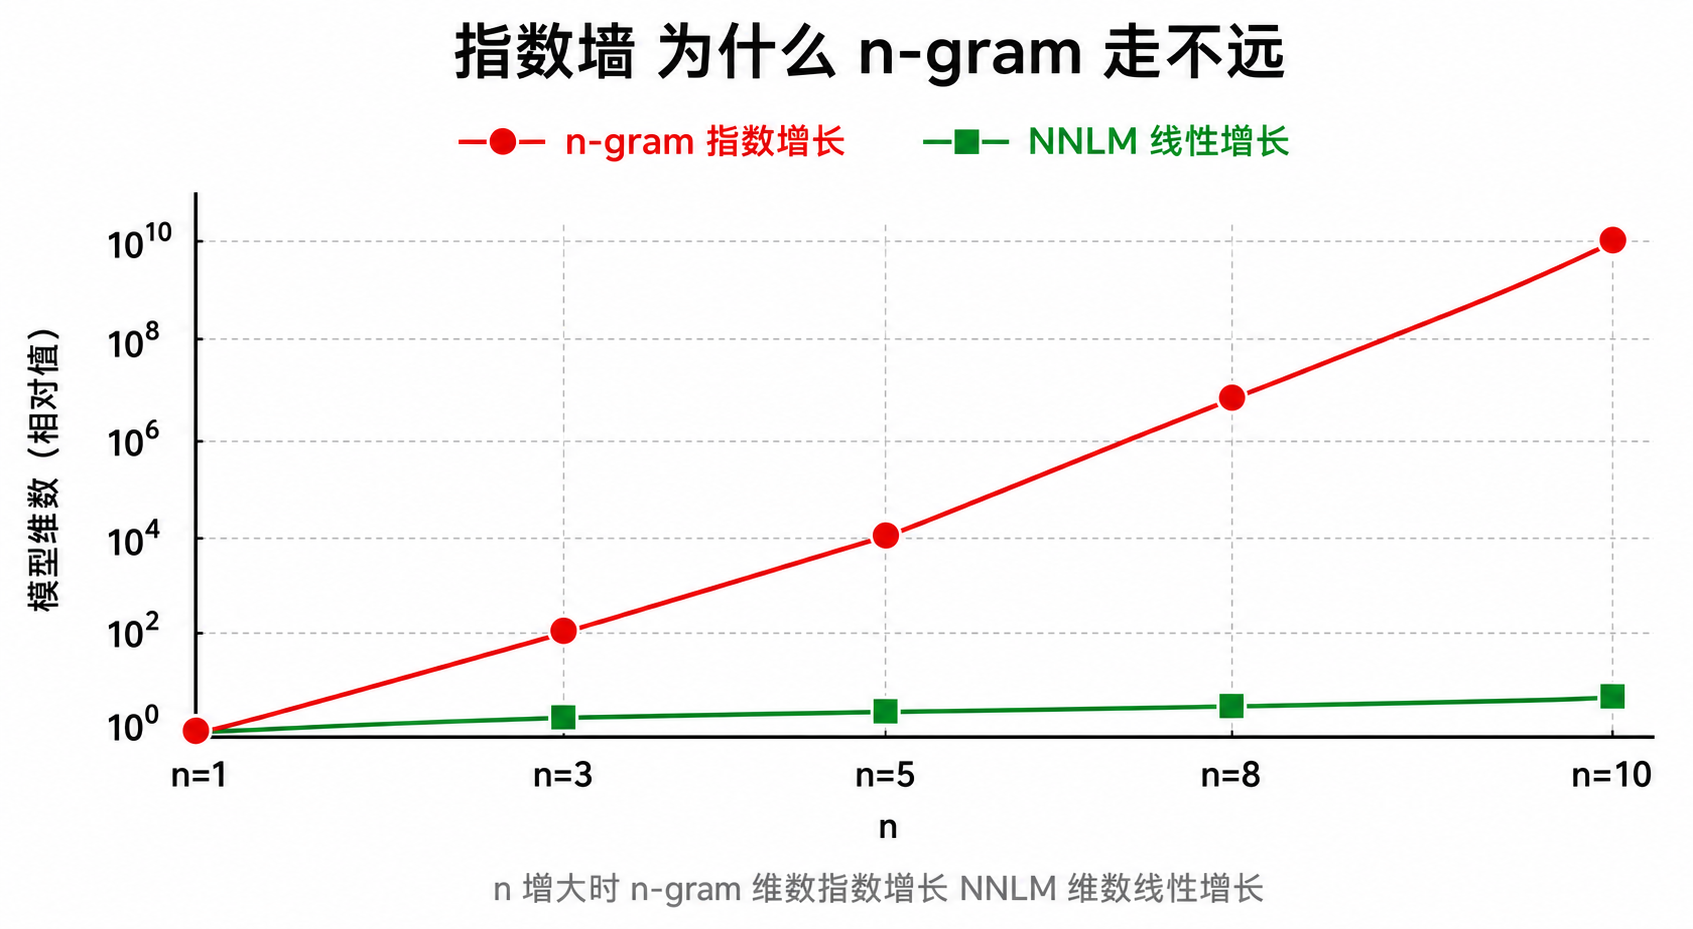
1. 维度灾难:为什么离散建模注定走不远
原文关键内容:For example, if one wants to model the joint distribution of 10 consecutive words … with $\lvert V\rvert=100,000$, there are potentially $100000^{10}-1 = 10^{50}-1$ free parameters.
翻译:若想对词表 $\lvert V\rvert=100000$ 的连续 10 个词的联合分布直接建模,自由参数数量是 $100000^{10}-1 = 10^{50}-1$。
解释:
想象词表是 10 万个抽屉,10 个词的句子就是从 10 万个抽屉里连续抽 10 次,有 $100000^{10}$ 种抽法。为了给每种抽法都单独学一个概率,你需要 $10^{50}$ 个独立旋钮——比地球原子数还多,根本学不完。
核心矛盾是:离散空间没有“中间地带”。连续世界里 3.01 和 3.02 很近,学了前者就能猜后者;但离散世界里 cat 和 dog 是两个毫不相干的编号,cat 的统计结果分不到 dog 半点好处。
为什么重要:这一段给出了全文的立论基石:只要还是离散 one-hot/计数表,参数就会随上下文长度 n 指数爆炸,后续所有 n-gram 技巧(back-off、平滑、聚类)都是在“修补”这个根因,但这个病因是所谓的痼疾,根本没法修正。
2. 核心方案
原文关键内容:1. associate with each word … a distributed word feature vector in $R^m$, 2. express the joint probability function … in terms of the feature vectors, 3. learn simultaneously the word feature vectors and the parameters of that probability function.
翻译:1. 为每个词关联一个 m 维实值分布式特征向量;2. 用这些特征向量来表达词序列的联合概率;3. 同时学习词向量与概率函数的参数。
解释:
把每个词从“门牌号”变成“坐标”:$C(\mathrm{the})=[0.2,-1.1,\ldots,0.5]$,$m$ 通常 30/60/100,远小于 $\lvert V\rvert=17000$。然后所有概率都基于这些坐标来算,而坐标本身和算概率的神经网络一起被反向传播更新——词的意义是在预测下一个词的任务中“顺带”学会的。
注意“同时”二字的分量:不是先用别的办法把词向量训好,再去训语言模型;而是端到端一起学。这让词向量天生就对“预测下一个词”最有用,而不是对“统计共现”最有用。
为什么重要:这是实现 MLP 时 nn.Embedding(vocab, m) + MLP 的精确对应。
关键思想提炼:表示学习与概率建模联合优化。$C(\lvert V\rvert\times m)$ 是知识载体,g(MLP)是概率计算器,二者共享梯度,泛化源于 $向量近\approx语义近\approx概率近$。
3. 为什么能泛化:一个训练句照亮指数个邻居
原文关键内容:if we knew that dog and cat played similar roles … we could naturally generalize from “The cat is walking in the bedroom” to “A dog was running in a room” and many other combinations … because the probability function is a smooth function of these feature values, a small change in the features will induce a small change in the probability.
翻译:若已知 dog/cat、the/a、bedroom/room 扮演相似角色,就能从第一句自然泛化到第二句及大量组合——因为概率函数是特征值的光滑函数,特征小变化只会引起概率小变化。
解释:
论文把句子看成“词向量序列在空间中的路径”:路径上每个点抖一点点,整条路径的概率就抖一点点。训练集只采了几条路径,但路径周围的指数条“抖动的”路径都被照亮了——这就是“一个训练句顶一群语义邻居”的来源。
关键思想提炼:泛化不靠“背更多短语”,靠 向量空间的度量 + 光滑函数的连续性,实现组合式(compositional)外推。
4. 模型全貌:C 表 + g 网络
原文关键内容:We decompose $f(w_t,\ldots,w_{t-n+1})=\hat{P}(w_t\mid w_{t-n+1}\ldots w_{t-1})$ in two parts: 1. A mapping $C$ from any element $i$ of $V$ to $C(i)$ in $R^m$ ($\lvert V\rvert\times m$ matrix). 2. The probability function $g$ maps $(C(w_{t-n+1}),\ldots,C(w_{t-1}))$ to a distribution over $V$.
翻译:把条件概率 $f$ 拆成两部分:1. 查表 $C$ 把词编号 $i$ 映成向量 $C(i)\in R^m$;2. 函数 $g$ 把上下文 $(n-1)$ 个向量映射成词表上的概率分布。
公式:
\[f(i, w_{t-1}, ..., w_{t-n+1}) = g(i, C(w_{t-1}), ..., C(w_{t-n+1}))\]约束:对任意上下文,$\sum_{i=1}^{\lvert V\rvert} f(i, \cdot) = 1$,$f > 0$。
4.1 逐层数据流(以 n=3 为例,m=2 可视化)
输入 $w_{t-2}\ w_{t-1}\to w_t$,词表 $\lvert V\rvert=5$(a, cat, dog, in, bedroom):
Day3 vs NNLM:
Day3 bigram one-hot×W |
Bengio NNLM | |
|---|---|---|
| 查表 | $W\in\mathbb{R}^{27\times27}$,one-hot 选行,等价于查表 | $C\in\mathbb{R}^{\lvert V\rvert\times m}$,编号查表 |
| 上下文 | 只看前 1 个词 (n=2) |
看前 n-1 个词,拼接成长向量 |
| 非线性 | 无(线性+softmax) | tanh 隐藏层,学复杂交互 |
| 参数共享 | 无 | C 在所有位置、所有样本间共享 |
为什么重要:C 在各位置之间共享。同一个词出现在不同位置,都会查到同一行向量;反向传播时,各位置对这行参数的梯度累加起来,方向不必相同。
关键思想提炼:查表(记忆)+ 函数(推理)分离,但参数共享。C 学“词是什么”,g 学“词怎么组合成句”,二者拼接即 $f=g\circ C$。
4.2 维度与复杂度
- 参数量:$C:\lvert V\rvert\times m$ 主导(如 $17000\times30=510k$),$H:h\times(n-1)m$,$U:\lvert V\rvert\times h$,$W:\lvert V\rvert\times(n-1)m$(直连可省)。总数百万级,2003 年已算“大模型”。
- 计算量:每预测一次只算一次前向,与 $\lvert V\rvert^n$ 无关,因此
n可从 trigram 的 3 轻松提到 5/8。 - 训练目标:最大化对数似然 $\sum_t \log f(w_t\mid w_{t-n+1}\ldots w_{t-1})$,等价于最小化困惑度(perplexity)。
5. 与 n-gram、聚类、LSI 的边界
n-gram:离散拼接短块,$P(w_t\mid w_{t-n+1}\ldots w_{t-1})$ 直接查计数表 + 回退/插值平滑。泛化靠“多看短块”,天花板是数据稀疏与上下文长度。
词聚类 n-gram(Brown 等):把词硬/软分到 K 个离散类,类内共享计数。已在利用相似性,但类是离散跳变,类内一视同仁、类间老死不相往来,不够细腻。
LSI/信息检索:也学连续词向量,但目标是“文档级共现”,且往往固定向量再训分类器。论文的差异在于为“预测下一个词”而联合学习,向量直接对困惑度负责,效果显著更好(作者试过冻住 LSI 向量去训,效果差)。
神经文本压缩/语音合成:已有用神经网络预测下一个字符/音素,但规模小、未证实可训动大词表语言模型。本文首次把规模做到“能跟 state-of-the-art trigram 打,且把 trigram + 模型插值后还能再降困惑度”。
6. 训练:“能训动”本身就是贡献
- 样本量:百万到千万词,上下文滑窗每步一个样本,远超当时常见的 UCI 小表。
- 优化:随机梯度下降 + 权重衰减(weight decay,岭回归思想),梯度需穿过
softmax → U/W → tanh → H → C,C的梯度是多个位置的和(共享带来的聚合)。 - 提速技巧:论文已讨论用重要性采样/层次 softmax 逼近归一化分母(完整 softmax 需对 $\lvert V\rvert$ 求和,$O(\lvert V\rvert)$ 是瓶颈),这为后来的层次 softmax、负采样埋下伏笔。
7. 关键公式
联合概率分解(链式法则,n-gram 马尔可夫近似):
\[\hat{P}(w_1^T) = \prod_{t=1}^{T} \hat{P}(w_t | w_1^{t-1}) \approx \prod_{t} f(w_t, w_{t-1}, ..., w_{t-n+1})\]NNLM 前向(论文式):
\[\begin{aligned} x &= [C(w_{t-n+1}); ...; C(w_{t-1})] \in \mathbb{R}^{(n-1)m} \\ h &= \tanh(d + Hx), \quad y = b + Wx + U\tanh(d+Hx) \\ \hat{P}(w_t = i | \cdot) &= \frac{e^{y_i}}{\sum_j e^{y_j}} \end{aligned}\]训练损失:
\[L = -\frac{1}{T}\sum_t \log \hat{P}(w_t | w_{t-n+1}...w_{t-1}) + \lambda\|\theta\|^2\]过渡:其实感觉这篇论文的核心概念就是“学习语义”——在学习某些语义相近的句子的过程中,模型自然而然的学会某些语法。但涉及到一些数学公式的推导可能还是看不太懂。没关系,因为卡帕西说了,下一节课虽然和这篇论文说的不一样,但整体思路完全一致:从词的级别下降到字母的级别(降低维度),方便实操。前面看不懂的,向后看着看着或许就看懂了。
MLP 实战:把 Bengio 的图跑通在字符上
8. 上下文窗口:block_size=3
类比: 模型是“滑窗猜下一个字母”。block_size=3 就是窗口宽度——每次只看前 3 个字符来猜第 4 个。像玩填空:... → e、..e → m、.em → m,哪怕名字很长,也是一格一格滑过去的。
公式: 训练集构造
\[\mathcal{D} = \{(X_i, Y_i)\}_{i=1}^{N},\quad X_i\in\{0..26\}^{3},\; Y_i\in\{0..26\},\quad N\approx 228146\] \[\text{emma}: [\_,\_,\_]\!\to\!e,\; [\_,\_,e]\!\to\!m,\; [\_,e,m]\!\to\!m,\; [e,m,m]\!\to\!a,\; [m,m,a]\!\to\!.\]实现要点:
context = [0]*block_size滑窗 →X,Y,全量build_dataset()再做Xtr/Xdev/Xte = 8:1:1切分——思路与Day3 §8.1的emma5 样本拆解一致。
9. Embedding 查表:C 是字典
Day3 的代码用 one-hot 乘 W 选行,本质上还是查表;MLP 里直接 C[X] 就是查表——C 是 27×m 的“字符字典”,C[5] 就是字母 e 的 10 维坐标。梯度可以直接更新这本“字典”,使字符表示与预测网络一起训练。
公式: 查表前向(m=10 版更贴近实战)
实现要点:
C[X]批量查表——C是27×m字符字典,C[5]即e的向量;与Day3 §9.2的one-hot @ W选行等价,只是此处的W有了m=10的瓶颈。
10. 拼接:cat 与 view
emb 是 (B,3,10),要喂给 W1(30×200),需要拼成 (B,30)。torch.cat([emb[:,0,:],emb[:,1,:],emb[:,2,:]],dim=1) 会创建拼接后的张量;这里的连续存储也允许直接用 emb.view(B,-1)。view 通过形状和步长重新解释同一块内存,不搬动数据;两种写法的区别在于是否创建新的数据存储。
公式: 形状变换
\[\text{emb}\in\mathbb{R}^{B\times 3 \times 10}\ \xrightarrow{\text{view}}\ x\in\mathbb{R}^{B\times 30},\quad x_b = [\text{emb}_{b,0};\text{emb}_{b,1};\text{emb}_{b,2}]\] \[\text{cat 版:拼接 }3\times(B\times10)\quad\text{vs}\quad\text{view 版:重解释 }(B\cdot3\cdot10)\text{ 连续内存}\]实现要点:
emb为(B,3,10),view(-1,30)零拷贝拼为(B,30)再进W1(30×200);cat/unbind直观但多一次拷贝。
11. tanh 隐层
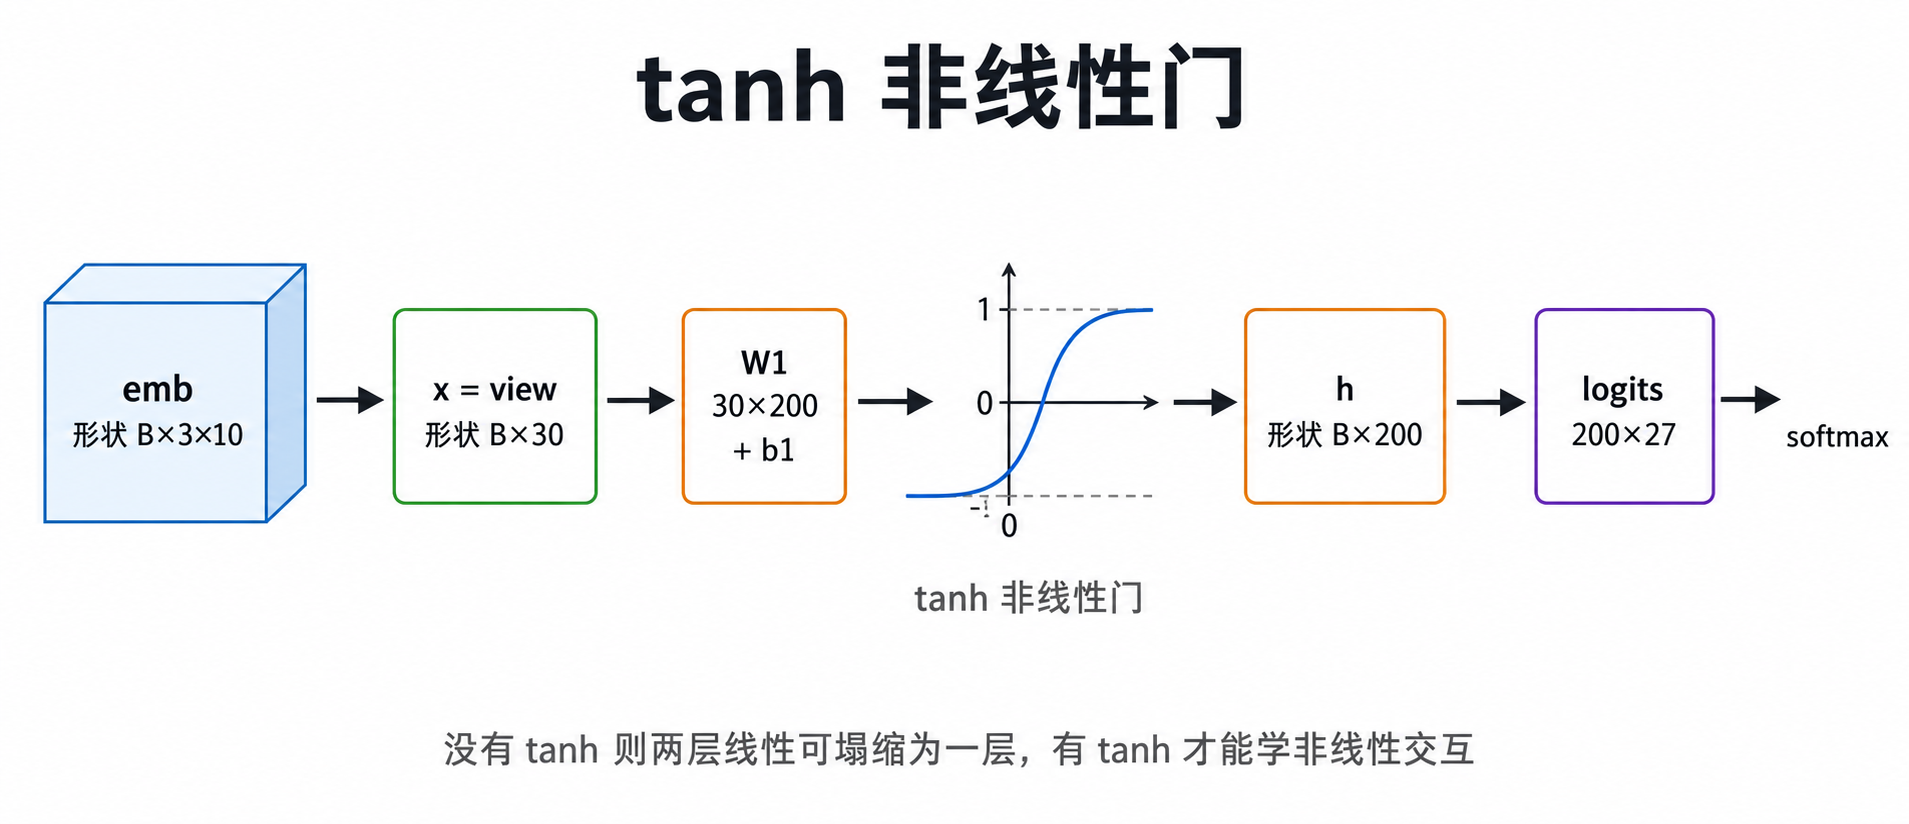
x @ W1 + b1 再线性到 logits,整体还是线性映射,3 个字符的非线性交互学不出来。tanh 让 (e,m) 和 (m,m) 这种组合能产生非线性响应。对应 Bengio 论文里的 h = tanh(d+Hx),这里使用 h = tanh(xW1+b1),形状从 (B,30) → (B,200)。
公式: 隐层前向(论文 ↔ MLP 对照)
\[\text{论文: } h = \tanh(d + Hx),\; y = b + Wx + Uh \qquad\Longleftrightarrow\qquad \text{MLP: } h = \tanh(\text{emb.view}(B,30)W_1 + b_1),\; \text{logits}=hW_2+b_2\] \[W_1\in\mathbb{R}^{30\times 200},\; b_1\in\mathbb{R}^{200},\; W_2\in\mathbb{R}^{200\times 27}\]实现要点:
h = tanh(emb.view(B,30)W1 + b1),形状(B,30)→(B,200);去掉tanh则退化为Day3的线性 bigram。
12. 小批量梯度
全量 228k 样本算一次梯度的开销较大,这里采用小批量训练。每步 ix=torch.randint(0,Xtr.shape[0],(32,)) 随机抽取 32 个名字片段,以小批量梯度估计全量梯度,降低单步计算量;C[Xtr[ix]] 的梯度只涉及这 32 个片段所用的 Embedding 行。
公式: 小批量交叉熵
\[\mathcal{L}_{\text{batch}} = -\frac{1}{32}\sum_{i\in\text{ix}}\log \frac{\exp(\text{logits}_{i,Y_i})}{\sum_j\exp(\text{logits}_{i,j})},\quad \text{ix}\sim\mathcal{U}[0,N)\] \[\theta_{t+1}=\theta_t - \eta \nabla_{\theta}\mathcal{L}_{\text{batch}}(\theta_t)\]实现要点: 小批量
randint(0,N,(32,))随机捞 32 行,F.cross_entropy等价手写log_softmax+NLL——与Day3 §9.3同构。
13. 学习率与 loss 曲线
学习率也会影响训练结果:这组设置下,lr=1.0 发散、lr=0.001 进展较慢、lr=0.1 则较合适。Karpathy 演示的测试方法是先用 lre=linspace(-3,0,1000), lrs=10**lre 做指数扫描,每种学习率进行一次训练的前向反向传播,画 loss.log10() 找拐点。随后固定 lr=0.1 跑 5 万步,stepi/lossi 曲线从 ~2.5 → ~2.0 平滑下降。
公式: 学习率扫描
\[\text{lrs}=10^{\text{linspace}(-3,0,1000)},\quad \mathcal{L}(\eta)=\text{CrossEntropy}(\theta - \eta\nabla\mathcal{L}),\quad \eta^* \approx 0.1\]
以上为概念图,实际的曲线是一个先下后上的曲线,大概有点像对勾函数吧,然后最低点在0.1处左右:
—
14. 采样复盘:multinomial 如何“写”出新名字
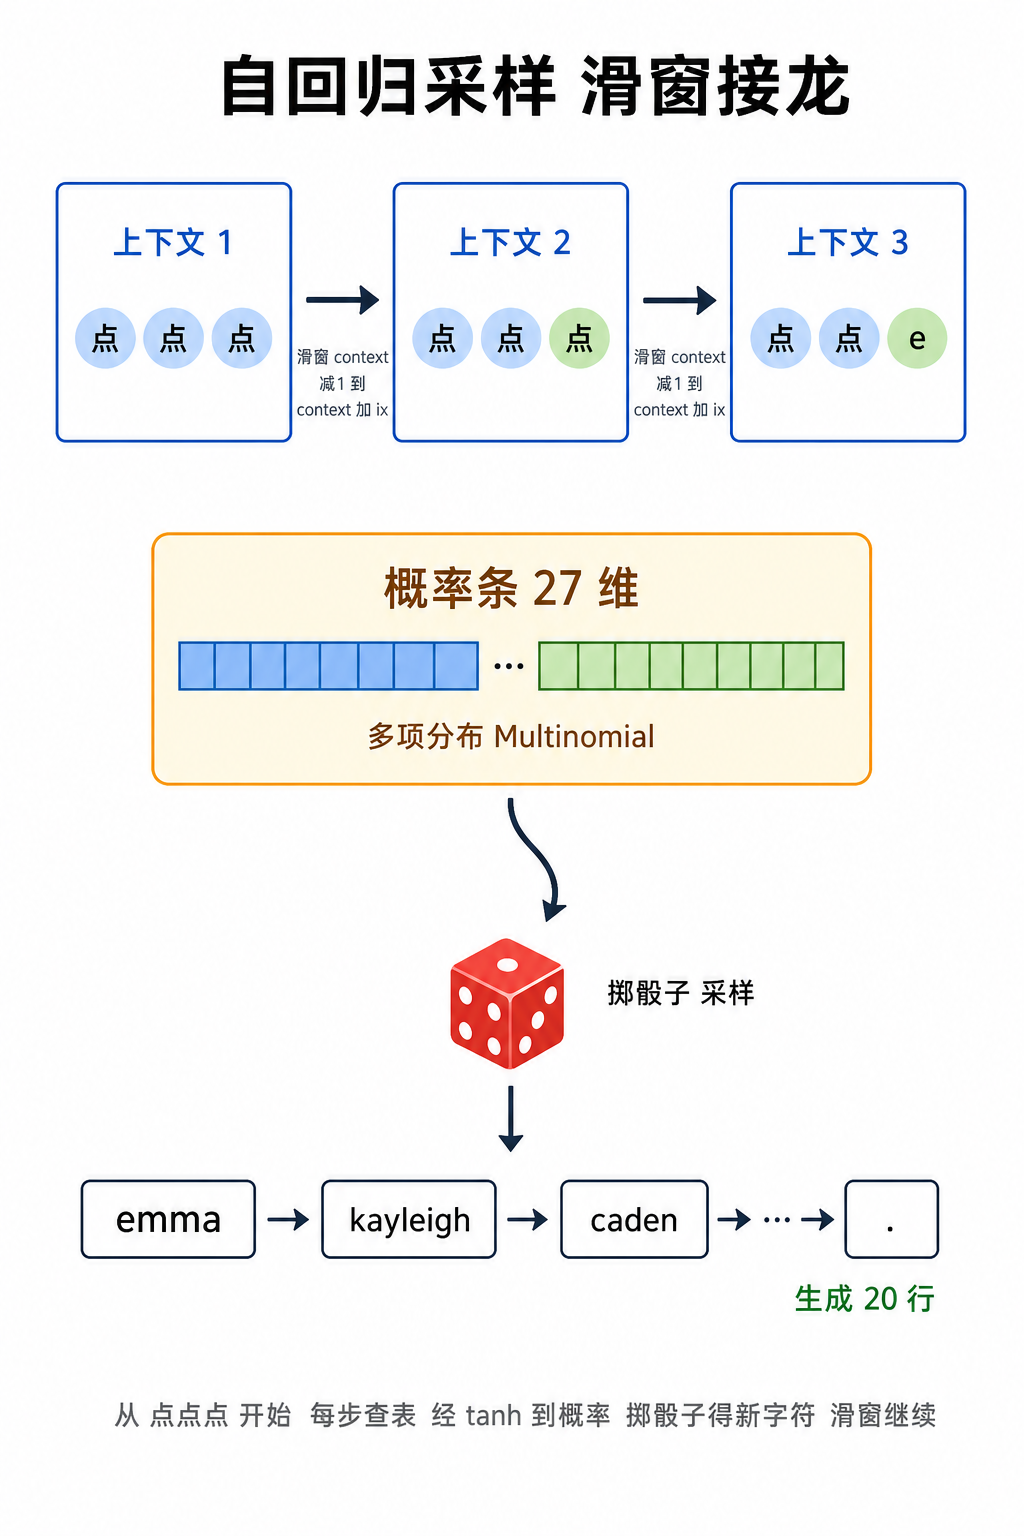
训练完的模型像一个“接龙”:从 [.,.,.] 开始,每步把上下文喂进去得到 probs,再 multinomial 掷骰子抽下一个字符,滑窗 context = context[1:]+[ix] 继续。比起bigram 只能看 1 个字符,MLP 看 3 个字符后生成的名字明显更像人名。
公式: 自回归采样
\[p(\cdot\mid c_{t-2},c_{t-1},c_t)=\text{softmax}(hW_2+b_2),\quad c_{t+1}\sim\text{Multinomial}(p),\quad \text{context}_{t+1}=[c_{t-1},c_t,c_{t+1}]\]实现要点:
context=[0]*3 → emb=C[context] → tanh → softmax → multinomial接龙 20 行,与Day3 §6的multinomial采样同源。
17. 收工小结:N-gram → Bengio → MLP 的递进
- N-gram:
N[27,27]把转移次数摆在桌上,按行归一就是概率,窗口稍长参数会指数爆炸。 - Bengio:
C(|V|×m)把离散编号压进连续空间,g=C→H→U的光滑函数让“相似词相似句”自动泛化,C与g联合端到端优化。 - MLP:
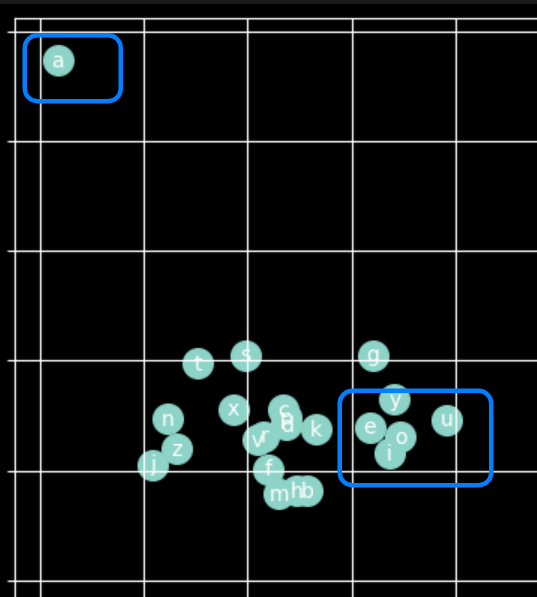
C[X] → view 拼接 → tanh(30→200) → logits(200→27) → cross_entropy在32的小批量下用lr≈0.1跑 5 万步,图中可见部分元音字母的表示聚集。后续重训未得到相同的聚集效果,原因尚未确认,不能把这次可视化当成稳定结论。
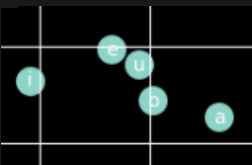
不妨再附上一次重新训练过的话,虽然这五小只没有成功聚集到一起,但是还是有四只重新聚集到一起了QAQ:
附 · 资料下载
本篇配套的 Bengio 精读与 MLP 字符级实战代码、图示,可直接下载。
完整实验代码与笔记
- MLP.ipynb:注释版 MLP(在原始课程跟写版上新增 123 行中文注释)
- MLP_original.ipynb:原版备份(无注释原版,含输出)