· micrograd / 反向传播 / Karpathy / autograd / 零基础
Day1:从零手写 autograd:micrograd 全记录
前言
作为一个将要步入大三的软件工程的学生,对AI对这个专业的冲击的感受是很深的。
回顾大三前的两年吧,大部分时间也不过是在随波逐流,用传统的软工思维学着SpringBoot,SpringCloud,SpringAI,以及衍伸出去的MyBatis-Plus,Redis,RabbitMQ,FlyWay,再到后面的FastAPI,Langchain等等,也包括跟敲了黑马的机器学习,深度学习,NLP等内容,期间也重拾了初中信竞相关内容,在蓝桥杯混了个国二。
整体看起来履历相当丰富了,但我还是焦虑——有了AI的辅助,我的代码可以说95%以上均是由AI辅助生成的,现在整个行业给我的感觉就是你只需要知道什么时候用什么技术栈,整体项目的架构当如何就可以了,剩下的全链路都可以用AI来实现。而由于AI介入过多,我对某些知识理论的掌握又往往十分浅层,很多也算是学过就忘了……
那么该当如何呢?
前两天和一个学长出去吃饭,学长提到一个很有趣的观点:“AI领域,不是菜鸟就是高手。”仔细一想好像确实如此,感觉真正掌握AI的人与我隔着一道天堑。学长提到,以后AI大部分行业,要么就是智能体开发,要么就是预训练与后训练。智能体开发呢,本质上与后端开发类似,感觉慢慢会成为前后端+智能体的全栈。而预训练与后训练则需要极高的入门成本与知识积累,但我想,这帮人才是在AI冲击下能活的最久的一批人吧。
而我呢,我前两个学年浑浑度日,绩点不算低也不算高,保研外校是没希望了,但是实习经历也是一点没有。那么我就不得不面临着保本校以后该如何前行的问题。基于我个人的想法,我肯定是想成为那一批“不会被淘汰的人”的。但是我之前黑马上听的机器学习深度学习,现在也只剩下一层表面了,且不说这些知识与将来实际领域是否存在巨大差异,但基础还是需要巩固的。那么谨以此篇开始,我将以不同角度,切入曾经学过的知识权当复习,并且在AI的辅助下逐步探索更前沿的AI知识。在AI的建议下,就从卡帕西的Micrograd开始吧。
0. 这个项目从什么讲到了什么
micrograd 是一个 约 100 行的标量级 autograd 引擎,用一个紧凑的实现串起计算图、链式法则和参数更新:
导数的直观定义 → 计算图与 Value 包装类 → 运算符重载搭图
→ 闭包挂载局部梯度规则 _backward → 拓扑排序 + 全图反传 backward()
→ 手搓神经元(tanh)→ 与 PyTorch 对比 → Neuron/Layer/MLP 三件套
→ 训练循环(前向→清零→反向→更新)→ loss持续下降
PyTorch 的 .backward() 同样沿计算图反向传播并累加梯度。张量运算和工程实现更复杂,micrograd 则把这一过程展开在标量运算上。
1. 导数与梯度:一切从割线开始
导数的数值定义: \(f'(x) = \lim_{h \to 0} \frac{f(x+h) - f(x)}{h}\)
取 $f(x) = 3x^2 - 4x + 5$,在 $x = 2/3$ 处用 $h = 0.01$ 做数值近似:
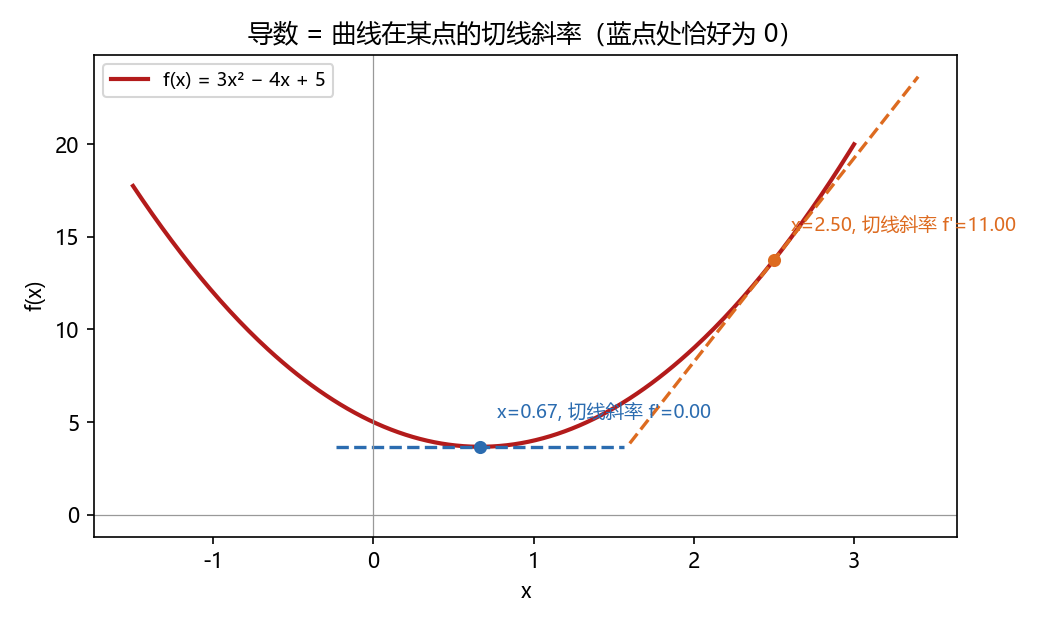
蓝点处恰好是抛物线顶点,切线水平,数值导数算出来 ≈ 0.03($h$ 不够小带来的误差),已经很接近 0。导数 = 该点的切线斜率 = 函数在这个点的瞬时变化率。 偏导:多元函数 $d = a \cdot b + c$,只扰动 $a$、固定 $b, c$:
h = 0.0001
a, b, c = 2.0, -3.0, 10.0
d1 = a*b + c        # 基准
a += h              # 只动 a
d2 = a*b + c
print((d2 - d1)/h)  # ≈ -3.0,正是 b 的值 → ∂d/∂a = b
乘积式的偏导有个好记的规律:求谁谁的搭档留下来(∂d/∂a = b,∂d/∂b = a)。这个”互换”就是后面乘法节点梯度规则的来源。 梯度就是”把每个输入的偏导打包成一个向量”,指 loss 上升最快的方向;负梯度就是下降最快的方向——训练时参数沿它进行逐步变化。
2. 计算图:把表达式记成图
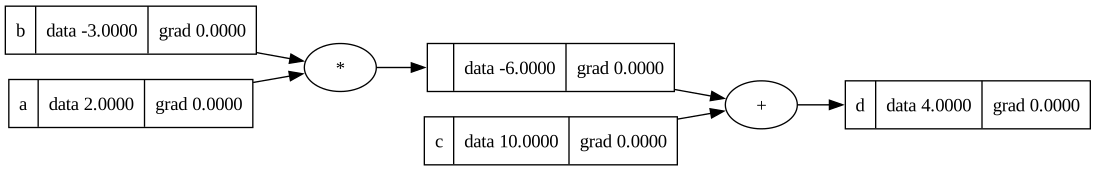
d = a*b + c 在 Python 里一闪而过就没了,但 autograd 需要把求值过程记下来:每个中间值是节点,运算方式是边。做法是把标量包成 Value 类,每次运算自动记录三件事:
class Value:
    def __init__(self, data, _children=(), _op='', label=''):
        self.data = data              # 前向数值
        self.grad = 0                 # ∂最终输出/∂本节点,反传时才填
        self._prev = set(_children)   # 我从哪些节点算出来的(前驱)
        self._op = _op                # 我由什么运算产生('+'/'*'/'tanh'…)
        self.label = label            # 画图用的名字
        self._backward = lambda: None # 本节点的梯度分摊规则(闭包),叶子是空函数

    def __add__(self, other):
        other = other if isinstance(other, Value) else Value(other)  # 兼容 a+1
        out = Value(self.data + other.data, (self, other), "+")
        def _backward():
            self.grad  += 1.0 * out.grad
            other.grad += 1.0 * out.grad
        out._backward = _backward
        return out

    def __mul__(self, other):
        other = other if isinstance(other, Value) else Value(other)  # 兼容 a*2
        out = Value(self.data * other.data, (self, other), "*")
        def _backward():
            self.grad  += other.data * out.grad   # 乘法导数互换
            other.grad += self.data * out.grad
        out._backward = _backward
        return out
三个设计要点:
_prev+_op让表达式”可回放”——画图、反传全靠它;- 每个运算返回的新节点自带
_backward——梯度规则在运算发生的那一刻就被”打包”进图里; _backward是闭包:它捕获了这一次运算的self / other / out,哪怕__add__已经返回,这三个对象的引用依然活着,等反传时调用。计算图里有一百个加法节点,就有一百个各自绑定各自数据的_backward——一份代码模板,绑定无数组具体节点。
3. 画出计算图
用 graphviz 把 d = a*b + c 画出来(矩形 = 数据,圆圈 = 运算,_op 为空的叶子没有圆圈):
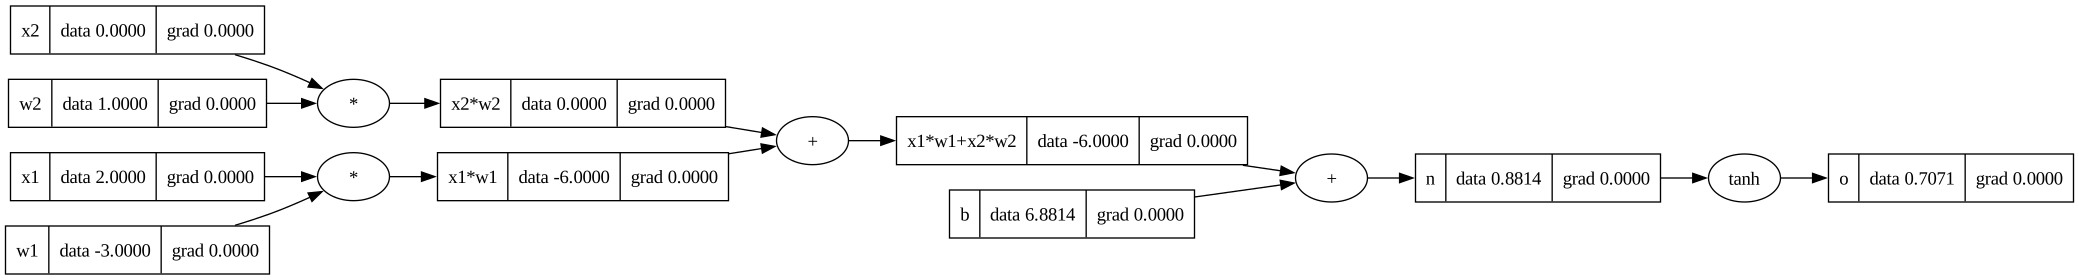
搭一个神经元 $n = x_1 w_1 + x_2 w_2 + b$,$o = \tanh(n)$,反传前每个 grad 都是 0:
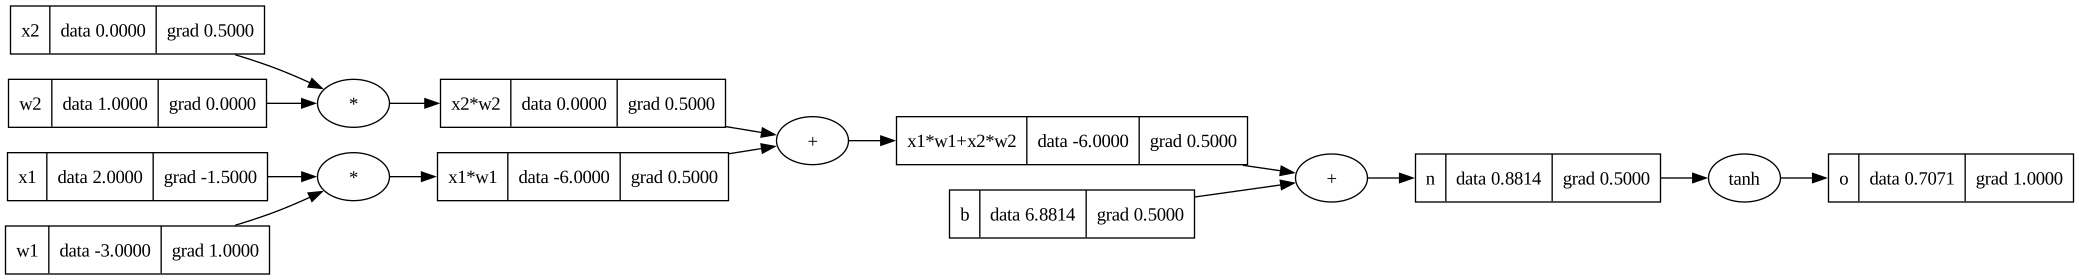
跑 o.backward() 之后再画,所有节点的 grad 全部自动就位:
4. 重点①:为什么需要 __radd__ / __rsub__ / __rmul__
问题:a * 2 能跑(调 a.__mul__),但 2 * a 直接报错。为什么?
Python 处理 x * y 的分派顺序是:
x * y  →  ①试 type(x).__mul__(x, y)
       →  若返回 NotImplemented(或不存在)→ ②试 type(y).__rmul__(y, x)
       →  还不行 → TypeError
2 * a 时,int.__mul__(2, a) 发现 a 不是 int,返回 NotImplemented;Python 于是回头问右边的 a:你会不会算”别人乘你”?这就是 __rmul__(r = reflected,反射运算符):
def __rmul__(self, other):   # 2 * a 走这里
    return self * other      # 换成 a * 2,而 __mul__ 里 isinstance 会把 2 包成 Value
def __radd__(self, other):   # 1 + a 走这里
    return self + other
def __rsub__(self, other):   # 5 - a 走这里:化为 (-a) + 5,复用已有运算
    return (-self) + other
验证:
a = Value(2.0)
2 * a    # Value(data=4.0)  ← 没有 __rmul__ 这里就 TypeError
1 + a    # Value(data=3.0)
本质:__add__/__mul__ 里的 isinstance 包装解决了「Value 在左、裸数字在右」;__r*__ 系列解决「裸数字在左、Value 在右」。两边都通了,写 loss 公式时才能随便写 2*n、(e-1)/(e+1) 这种自然表达式。
5. 重点②:backward() 的三要素
def backward(self):
    # ① 拓扑排序:后序 DFS,保证"孩子排在父亲前面"
    topo, visited = [], set()
    def build(v):
        if v not in visited:
            visited.add(v)
            for child in v._prev:
                build(child)
            topo.append(v)          # 孩子全递归完才 append 自己
    build(self)
    # ② 种子梯度
    self.grad = 1.0                 # ∂o/∂o = 1
    # ③ 逆序调用每个节点的局部反传
    for node in reversed(topo):
        node._backward()
要素一:拓扑排序。 反传时调用 node._backward() 的前提是 node 的 grad 已经被所有下游”攒齐”。拓扑序(逆序后)恰好保证:处理任何节点时,所有指向它的运算都已经处理完了。
要素二:+= 累加。 反例一眼看懂:
a = Value(3.0)
b = a + a        # a 参与了两次加法!
b.backward()
print(a.grad)    # 正确答案 2.0(d(a+a)/da = 2)
如果 _backward 里写 =,第二次加法的梯度会覆盖第一次,得到错误的 1.0。梯度是”所有流经路径贡献之和”,所以必须累加——这也是训练循环里每轮要 grad=0 清零的原因(不清零就跨轮累加)。
要素三:闭包挂载。 见第 2 节——规则在运算时打包,反传时统一调度。规则本地化,调度全局化,PyTorch 的 grad_fn 同款思想。
6. 手推一遍神经元的梯度(链式法则)
以 $o = \tanh(x_1 w_1 + x_2 w_2 + b)$(反传后那张图)为例,数值:$x_1=2, w_1=-3, x_2=0, w_2=1, b=6.8814$,算出 $n = 0.8814$,$o = \tanh(0.8814) \approx 0.7067$。 运用链式法则逐级递推:
\[\frac{\partial o}{\partial n} = 1 - \tanh^2(n) = 1 - o^2 \approx 1 - 0.7067^2 \approx 0.5000\] \[\frac{\partial o}{\partial w_1} = \underbrace{\frac{\partial o}{\partial n}}_{0.5} \cdot \underbrace{\frac{\partial n}{\partial (x_1 w_1)}}_{1} \cdot \underbrace{\frac{\partial (x_1 w_1)}{\partial w_1}}_{x_1 = 2} = 1.0\] \[\frac{\partial o}{\partial x_1} = 0.5 \times w_1 = -1.5, \qquad \frac{\partial o}{\partial x_2} = 0.5 \times w_2 = 0\]对照第 3 节”反传后”的图:w1.grad = 1.0、x1.grad = -1.5、x2.grad = 0、b.grad = 0.5——代码算的和手推的完全一致。
7. tanh 拆成原子运算:分层的自由度
把 tanh 手工展开成 $\dfrac{e^{2n}-1}{e^{2n}+1}$,用 exp/加减除重新搭建后再反传——梯度结果和整体 tanh 版一字不差:

autograd 不关心运算打包过程如何。粗粒度(tanh 一个节点)快,细粒度(exp/除法)灵活,梯度都正确。
8. 与 PyTorch 对比
同一个神经元用 PyTorch 复算:
import torch
x1 = torch.Tensor([2.0]).double(); x1.requires_grad = True   # 叶子默认不求导,须显式开
...
n = x1*w1 + x2*w2 + b
o = torch.tanh(n)
o.backward()
print(x1.grad.item())   # -1.5……与 micrograd 完全一致
对照表:
| micrograd | PyTorch | 备注 |
|---|---|---|
Value(2.0) |
torch.Tensor([2.0]) |
PyTorch 是张量版 |
.grad |
.grad |
名字都一样 |
.backward() |
.backward() |
同名同义 |
p.grad = 0.0 手动清零 |
optimizer.zero_grad() |
同一件事 |
改 p.data 更新参数 |
optimizer.step() |
同一件事 |
9. 重点③:Neuron → Layer → MLP 是怎么搭起来的
三件套就是套娃:神经元 → 层(一排神经元)→ 多层感知机(一摞层)。
class Neuron:
    def __init__(self, nin):
        self.w = [Value(random.uniform(-1,1)) for _ in range(nin)]  # nin 个权重
        self.b = Value(random.uniform(-1,1))                        # 1 个偏置
    def __call__(self, x):
        act = sum((wi*xi for wi,xi in zip(self.w, x)), self.b)      # w·x + b
        return act.tanh()                                           # 非线性激活
    def parameters(self):
        return self.w + [self.b]

class Layer:
    def __init__(self, nin, nout):
        self.neurons = [Neuron(nin) for _ in range(nout)]           # nout 个并列
    def parameters(self):
        return [p for neuron in self.neurons for p in neuron.parameters()]

class MLP:
    def __init__(self, nin, nouts):
        sz = [nin] + nouts                                          # 例:[3,4,4,1]
        self.layers = [Layer(sz[i-1], sz[i]) for i in range(1, len(sz))]
    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)                                            # 上层输出=下层输入
        return x
    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
拿一组真实数据走一遍:MLP(3, [4,4,1]),输入 x = [2.0, 3.0, -1.0]。
输入(3维) [2.0, 3.0, -1.0]
   │  第1层 Layer(3→4):4个神经元,每个做 w·x+b 再 tanh
   ▼
(4维) [tanh(Σwᵢxᵢ+b)]×4        ← 4个神经元各看同一份输入,权重不同结果不同
   │  第2层 Layer(4→4)
   ▼
(4维)
   │  第3层 Layer(4→1):单神经元输出标量
   ▼
(1维) +0.4297(初始随机权重下的输出)
神经元 / 层 / MLP 在这组数据下的具体结构(权重取一组随机初始化值、保留两位小数,方便手算复核):
① 神经元:加权和 + tanh,多进单出。 拎出第 1 层的 1 号神经元,它的全部家当就是 3 个权重 + 1 个偏置:$w = [0.24,\ 0.07,\ -0.27]$,$b = 0.17$。喂入 $x = [2.0,\ 3.0,\ -1.0]$:
\[n = (0.24)(2.0) + (0.07)(3.0) + (-0.27)(-1.0) + 0.17 = 0.48 + 0.21 + 0.27 + 0.17 = 1.13\] \[\text{out} = \tanh(1.13) \approx 0.8110\]不管输入几维,一个神经元永远只吐 1 个数。
② 层:一排同样的神经元并排,各看同一份输入。 Layer(3→4) 里 4 个神经元结构相同、权重各异:
| 神经元 | $w$ | $b$ | 输出 |
|---|---|---|---|
| #1 | [0.24, 0.07, -0.27] | 0.17 | +0.8110 |
| #2 | [-0.67, 0.65, -0.23] | 0.58 | +0.8896 |
| #3 | [0.84, -0.38, 0.98] | -0.59 | -0.7739 |
| #4 | [0.31, 0.82, -0.78] | 0.64 | +0.9998 |
同一份 $x$ 进去,出来的是一个 4 维向量 $[+0.8110,\ +0.8896,\ -0.7739,\ +0.9998]$——权重不同,同一份输入就变成不同的”证据”,这就是”一层放 4 个神经元”的意义。
③ MLP:上一层的输出向量,正是下一层的输入。 把这套权重接成完整网络,前向时数值一路这样流动:
x          = [ 2.0000,  3.0000, -1.0000]              ← 3 维输入
Layer(3→4) → [+0.8110, +0.8896, -0.7739, +0.9998]     ← 4 维
Layer(4→4) → [-0.9397, +0.9253, +0.2977, -0.4723]     ← 4 维
Layer(4→1) → +0.4297                                   ← 标量
两个细节:(a) 第 2 层每个神经元拿到的输入,恰好是第 1 层输出的那 4 个数——层与层之间传的是整个向量;(b) tanh 把每个分量都压进 $(-1,1)$,所以任何一层的输出都不会越界。最后的 $+0.4297$ 是没训练过的网络在胡猜——第 10 节训练循环要做的,就是把下面这 41 个参数一点点挪到 loss 变小的方向。
参数量:第1层 4×(3+1)=16,第2层 4×(4+1)=20,第3层 1×(4+1)=5,共 41 个——len(n.parameters()) 验证一致。每个参数都是 Value,所以 41 个参数全部自动进图、自动拿梯度。
三个工程小细节:__call__ 让 neuron(x) 语法成立;Layer.__call__ 在单神经元时返回标量而非 [标量](最后一层好用);parameters() 层层向上汇总,MLP 一口气交出全部可训练参数。
10. 训练循环:深度学习的“公式”
for k in range(100):
    # ① 前向:预测 + loss
    ypred = [n(x) for x in xs]
    loss = sum((ygt - yout)**2 for ygt, yout in zip(ys, ypred))
    # ② 清零:backward 全是 +=,不清零会累积上一轮梯度
    for p in n.parameters():
        p.grad = 0.0
    # ③ 反向:一次调用,41 个参数的梯度全部就位
    loss.backward()
    # ④ 更新:最朴素梯度下降(改 p.data,不进计算图)
    for p in n.parameters():
        p.data += -0.05 * p.grad
真实跑出来的曲线:
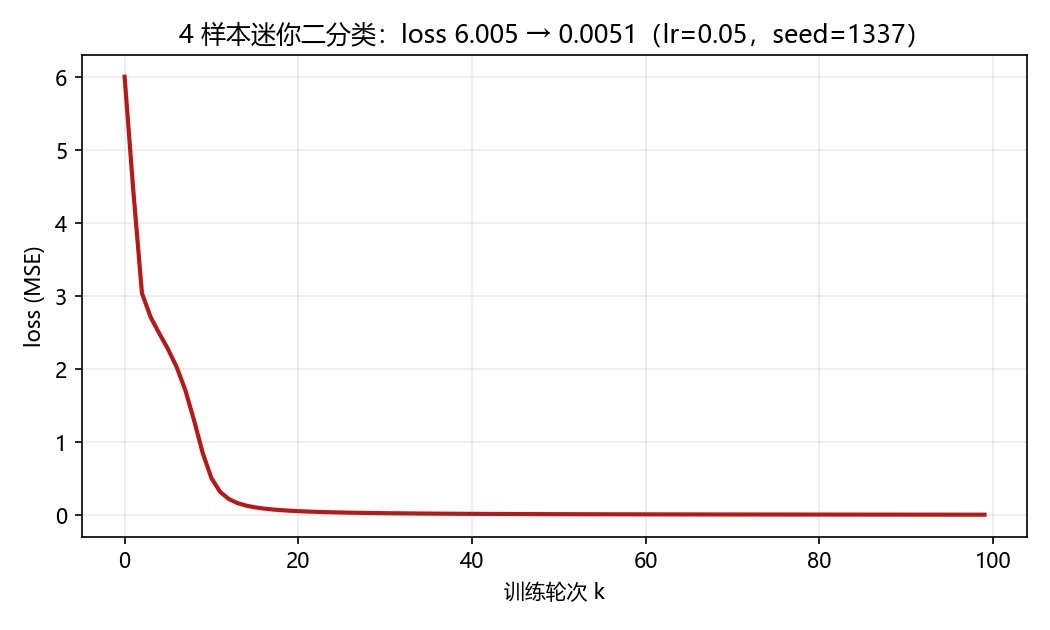
loss 从 6.01 → 0.0051,预测 [0.959, -0.992, -0.960, 0.958] vs 标签 [1, -1, -1, 1]。这个 41 参数的 MLP 通过手写 autograd 引擎完成了 4 个样本的分类拟合。
11. Day 1 收工小结
前前后后花了近六个小时(一直出bug这一块)一天刚好把深度学习的最小闭环搞定了:
- autograd = 把求值过程记成图:
Value用_prev/_op记录“该数据是从哪来的”,最终的表达式就可回放、可求导。 - 反向传播 = 拓扑序 + 链式法则 +
+=:全局调度只是一次逆序遍历,每个节点只管自己的局部规则(链式法则发力);多路径梯度必须累加,所以每轮训练前要清零。 - 网络 = 套娃:Neuron → Layer → MLP,
parameters()层层上交,41 个参数全部自动进图、自动拿梯度;训练简单来说呢,就是四步——前向、清零、反向、更新。