· Transformer / 注意力机制 / BatchNorm / 位置编码 / 多头注意力
Day2:Attention is All You Need——传世经典
前言
今天接着看 Transformer。我曾经跟着黑马程序员敲过 CNN、RNN 什么的,整体感觉都挺公式化的,代码是真的实现了高内聚低耦合,不同版本之间只需要修改少量代码即可训练出不同的模型。虽然我现在忘得差不多了,但偶尔回去翻一翻之前的笔记,应该还是能看懂的吧!这次想顺着往下弄清楚:去掉循环以后,模型怎么处理一个句子?
0. 论文的主要观点
RNN 太慢(必须逐词串行),CNN 看不远(要叠很多层才能看到远处的词),干脆只用注意力——让每个词直接看句子里所有词。
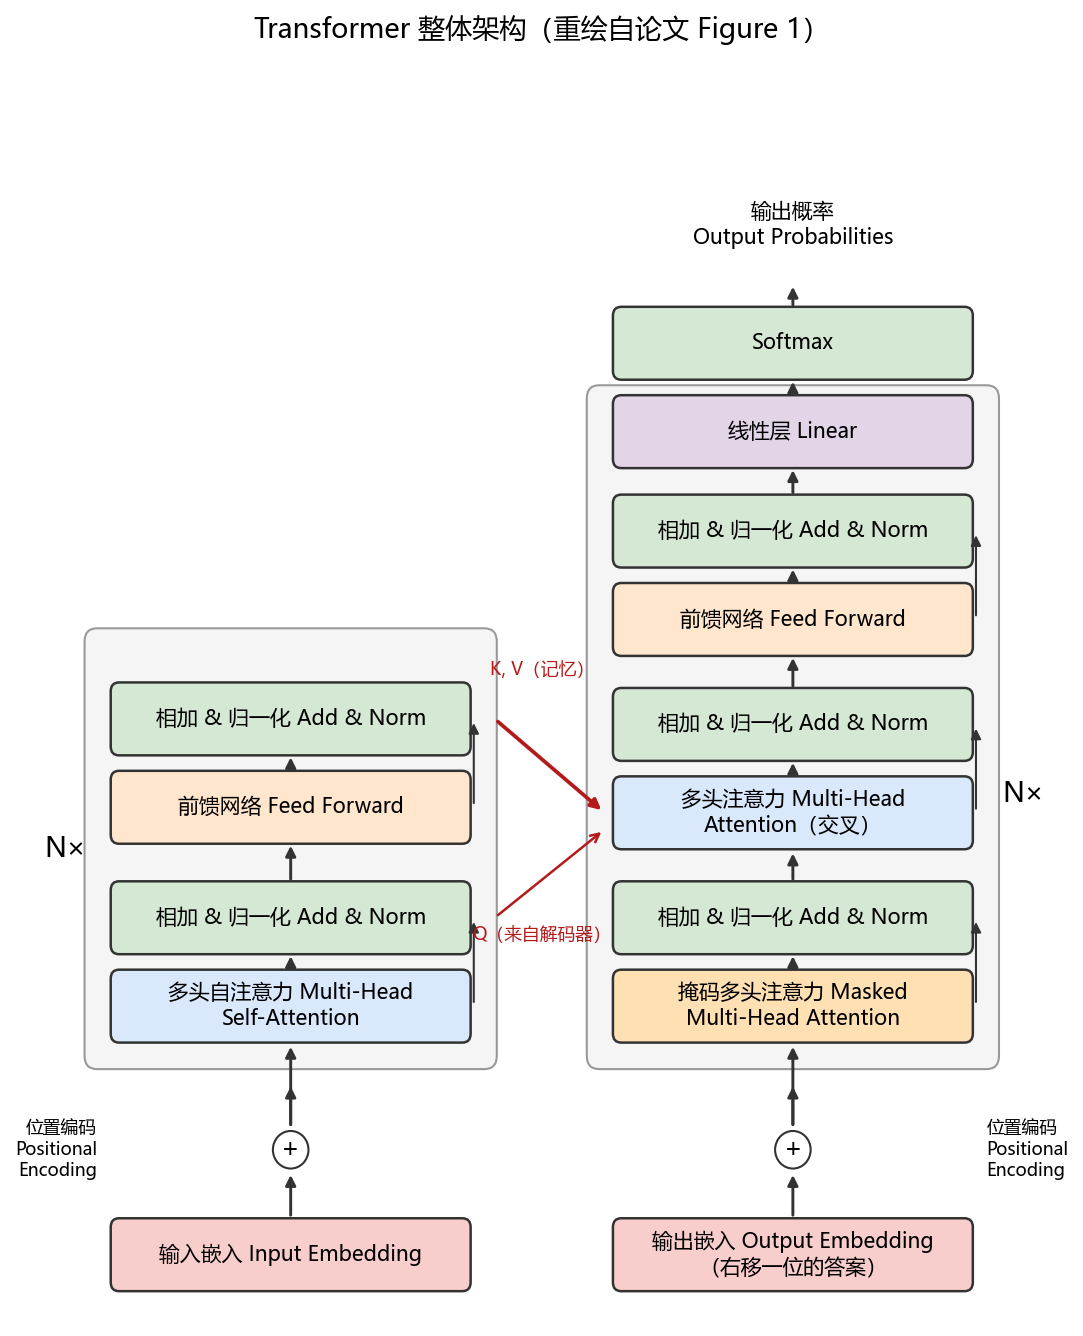
结果:翻译质量更好 + 训练快得多,全靠注意力 + 前馈网络即可训练出来。下面是 Transformer 的架构图:
1. 摘要翻译
占主导地位的序列转换模型基于复杂的循环或卷积神经网络,包括编码器和解码器。表现最佳的模型还通过注意力机制连接编码器和解码器。我们提出了一种新的简单网络架构,Transformer,完全基于注意力机制,摒弃了循环和卷积。在两项机器翻译任务上的实验表明,这些模型质量更优,且更具并行性,训练所需时间显著更少。
我们的模型在 WMT 2014 英语-德语翻译任务上取得了 28.4 的 BLEU 值,比包括集成模型在内的现有最佳结果提高了超过 2 个 BLEU。在 WMT 2014 英语-法语翻译任务上,我们在 8 个 GPU 上训练 3.5 天后建立了新的单模型最先进 BLEU 分数 41.8,这只是文献中最佳模型训练成本的一小部分。我们通过将其成功应用于英语成分分析(无论是使用大量还是有限的训练数据),表明 Transformer 很好地推广到其他任务。
2. 现有问题:RNN 的两大死穴
循环模型通常根据输入和输出序列的符号位置来分解计算。将位置与计算时间的步骤对齐,它们生成一个隐藏状态序列 $h_t$,作为前一个隐藏状态 $h_{t-1}$ 和位置 $t$ 的输入的函数。这种固有的顺序性质阻止了训练样例内的并行化,这在较长的序列长度时变得至关重要,因为内存限制限制了跨样例的批处理。
尽管在编码器和解码器之间已经使用了注意力机制,但是问题依旧存在。
2.1 串行计算:前一个词不结束,后一个词不能开始
$h_t = f(h_{t-1}, x_t)$ 的意思是:想知道第 100 个词的状态,必须先算完第 99 个。整个序列是一条链,$t=1$ 到 $t=n$ 只能排队算,GPU 上千个核心大部分在空闲状态,并没有很好地利用资源。
2.2 内存限制:反向传播还要把整条链保存下来
RNN 训练要把每一步的中间状态都存下来反向传播(BPTT)。序列一长、batch 一大,显存就容易爆,只能砍 batch,GPU 利用率也会更低。
2.3 为什么“已经用了注意力”还是不够
2014 年的 seq2seq + attention(Bahdanau)里,注意力只是编码器到解码器之间的一座桥,主体骨架仍然是 RNN。Transformer 的革命在于:把 RNN 整个替换为注意力机制,这也就是标题 All You Need 的含义。
3. 注意力 Vs 卷积神经网络
卷积神经网络距离远的位置,学习依赖关系会愈发困难;但是注意力机制可以同时关注全文。
自回归:过去的输出作为当前输出值的输入。
- 卷积核一次只能看相邻 $k$ 个词(比如 $k=3$)。第 1 个词和第 100 个词要发生关系,信息必须一层层传:$3\to9\to27\cdots$,要 $\log_k n$ 层才能搭建上联系。距离越远,要叠的层越多,信号沿途衰减。(在后续的时间复杂度中可以窥见一二。)
- 注意力:任意两个词一步直达(Maximum Path Length = $O(1)$),路径越短,梯度流越好,远距离依赖越好学。
3.1 编码器与解码器的关键区别:多头注意力与掩码
解码器比编码器多两样东西:
- 掩码多头自注意力:自己看自己,但只准看已生成的部分,防止作弊偷看答案。
- 交叉注意力:$Q$ 来自解码器,$K/V$ 来自编码器输出,这是两个部分的交流通道。
4. 关键公式:残差连接 + 两个关键超参数
\[\text{LayerNorm}\big(x + \text{Sublayer}(x)\big)\]这里更准确地说,$N=6$ 和 $d=512$ 是 Transformer Base 版本的两个关键超参数:编码器 6 层、解码器 6 层,词向量维度 512。
- 残差连接 $x + \text{Sublayer}(x)$:子层(注意力或 FFN)的输出不直接用,而是加回输入。梯度可以沿着“+”号无衰减地直通底层,网络堆到 6 层、60 层都不容易退化,这是 ResNet 的老思想。
- LayerNorm:把每个词的 512 维向量重新拉回均值 0、方差 1,让每一层的分布稳定,训练才敢开大学习率。
- N=6、d=512:这是论文中 Base 版的配置,不是所有 Transformer 都必须使用的固定数值。
5. BatchNorm Vs LayerNorm
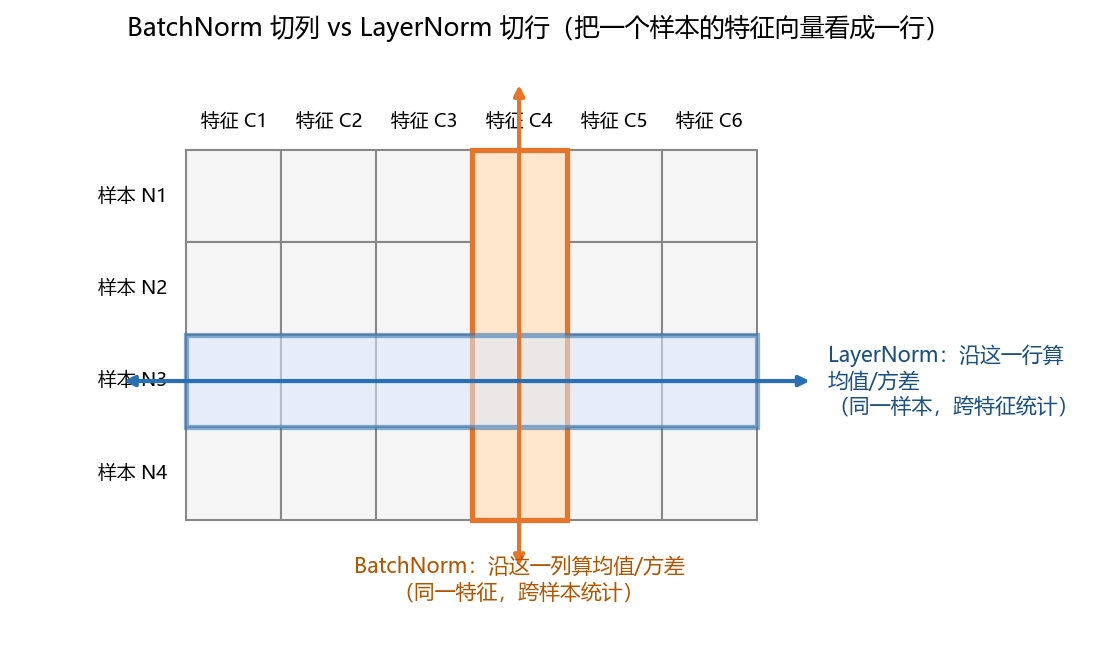
这里先把输入看成三维张量:$(batch \times seq \times feature)$。每个文本的长度可能不一样(seq 不一样),所以需要重点观察两种归一化各自切了哪些位置。
5.1 两者的共同点
都是把一组数拉成均值 0、方差 1。区别只有一个:对哪些数算均值和方差。
5.2 BatchNorm:切列,统计量依赖队友
BatchNorm 对“特征 C3”这个通道,拿 batch 里所有样本的值算均值和方差。统计量依赖队友:batch 越小越不稳;NLP 里句子长短不一,padding 位置会污染统计;推理时还得用训练集的移动平均,训练和推理行为不一致。
5.3 LayerNorm:切行,每个位置自己算
LayerNorm 让每个词的 512 维自己算自己的,它跟 batch 里其他句子、跟句子长度统统无关。“seq 不一样,所以每个样本自己算”说的就是这个意思。
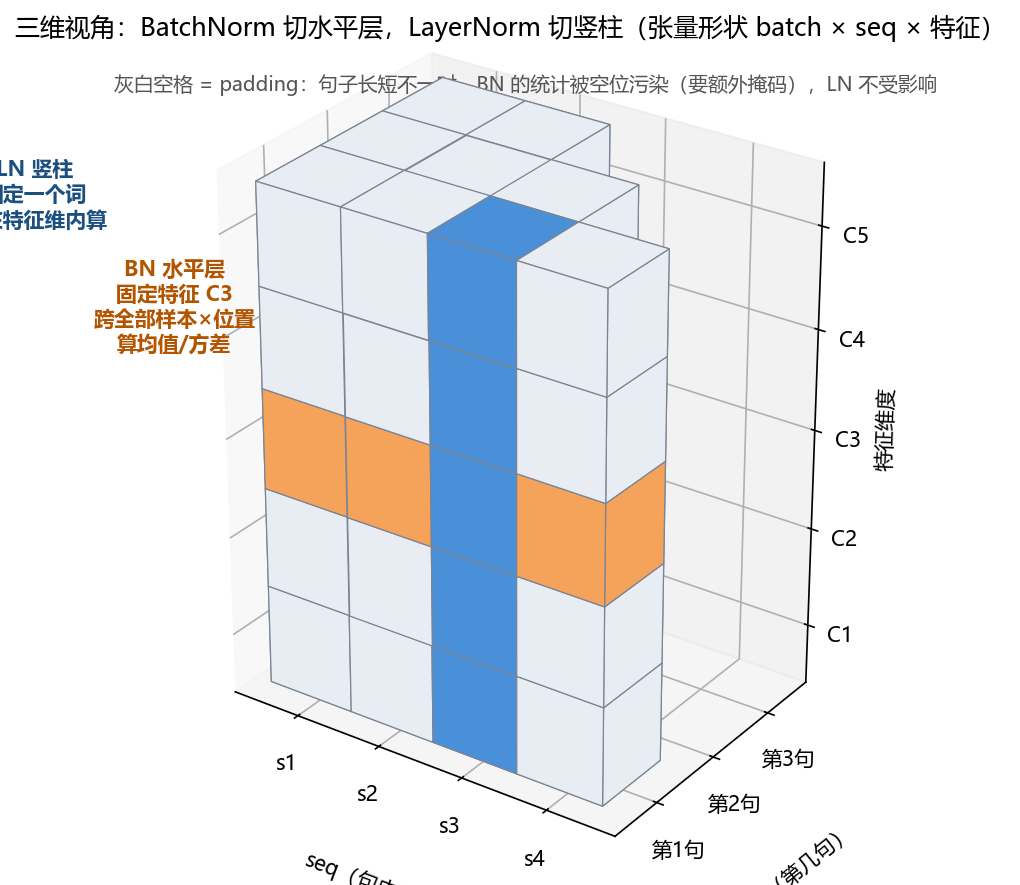
- 整个立方体 = 一个 batch 的张量:x 方向是 seq(句内位置 s1..s4),y 方向是 batch(第 1~3 句),z 方向是特征维度(512 维示意成 5 格)。
- 橙色水平层(BN):固定一个特征通道,把所有句子、所有位置摊在同一层里算均值和方差。
- 蓝色竖柱(LN):固定某一个词,只在它自己的特征维度里算。
- 顶部“台阶”:三句话长度 4/3/2 递减,而空位会混进 BN 的“全层统计”里污染均值和方差;LN 的柱子自己转自己的,长短句、batch 大小统统无关。
6. Q、K、V:注意力的最小单元
同一个 Query 对不同的 Key 会算出不同的相似度,得到不同的权重,最后按不同比例混合各个 Value。
输入由维度为 $d_k$ 的查询和键,以及维度为 $d_v$ 的值组成。计算查询与所有键的点积,每个点积除以 $\sqrt{d_k}$,再应用 softmax 函数,得到 Value 上的权重。批量计算时,一组查询组成矩阵 $Q$,键和值分别组成矩阵 $K$ 和 $V$。输出矩阵为:
\[\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{QK^T}{\sqrt{d_k}} \right) V\]6.1 一个简单的类比
- Query(查询卡):当前查询的问题,例如“它”指的是什么?
- Key(书脊标签):每个位置用于匹配的标签,例如“小猫”“垫子”。
- Value(书的内容):每个位置真正携带的信息。
- 注意力输出:按“标签与查询卡的匹配度”加权,把各本书的内容抄进自己的笔记本。匹配度高的书多抄点,不相关的少抄点。例如一个“小猫形状的坐垫”,就会从小猫和垫子双方各取出不同权重的信息量。
下面是一个简单的计算举例:
| 候选 Key | 点积得分 | 除以 $\sqrt{4}$ | softmax 权重 |
|---|---|---|---|
| 小猫 | 6.0 | 3.0 | 0.82 |
| 垫子 | 2.0 | 1.0 | 0.11 |
| 昨天 | 1.0 | 0.5 | 0.07 |
输出 = $0.82 \cdot V(\text{小猫}) + 0.11 \cdot V(\text{垫子}) + 0.07 \cdot V(\text{昨天})$——“它”的新表示里 82% 是“小猫”的成分。
6.2 为什么要除以 $\sqrt{d_k}$
$q\cdot k$ 是 $d_k$ 项乘积之和,维度越高,数值方差越大($d_k=64$ 时点积动辄几十),softmax 会被推入饱和区:最大值权重趋近 1,其余趋近 0,梯度几乎消失。
6.3 K 和 V 是怎么来的
小贴士:K 和 V 是同一个词的输入向量 $x$(词嵌入 + 位置编码)分别乘以两个不同参数矩阵得到的,同源、独立、互不推出:
\[K = x \cdot W^K, \qquad V = x \cdot W^V, \qquad Q = x \cdot W^Q\]- 训练阶段:海量语料反复修正 $W^Q$、$W^K$、$W^V$——让“该被关注的词”的 $K$ 恰好和 Query 点出高分,且它携带的 $V$ 确实有用。
- 推理阶段:参数冻结,每个词的 $K$、$V$ 由它自己的 $x$ 即时算出。训练学的是“怎么投影”(W 矩阵),不是具体的 K、V 值。
6.4 加型注意力 Vs 点乘注意力
加型注意力用一个小前馈网络算 $q,k$ 的相合度(Bahdanau 2014),点乘注意力就是上面的矩阵乘法。两者理论复杂度相近,但点乘可以写成一次矩阵乘法,吃满 GPU。
两种打分函数都输出一个标量“相合度”,后面的 softmax 流程完全一样:
\[\text{score}_{\text{加型}}(q, k) = v_a^\top \tanh(W_q\,q + W_k\,k)\] \[\text{score}_{\text{点乘}}(q, k) = \frac{q \cdot k}{\sqrt{d_k}}\]先澄清名字:“加型”不是“用加法代替乘法”,而是 $q,k$ 在网络里先相加($W_q q + W_k k$)再过 tanh。
一个小例子($d_k=2$,隐藏维 $d_a=2$,为省事取 $W_q=W_k=I$,$v_a=[1,1]$):
取 $q=[1,2]$,$k=[3,-1]$:
- 点乘得分:$q\cdot k = 1\times3 + 2\times(-1) = 1$
- 加型得分:$q+k=[4,1] \xrightarrow{\tanh} [0.9993,0.7616] \xrightarrow{v_a} 0.9993+0.7616\approx1.76$
两者都得到一个标量,喂给同一套 softmax 就能当注意力权重——打分函数可以换,注意力骨架不变。加型多了可学习的 $W$,理论上更灵活。
| 维度 | 加型注意力 | 点乘注意力 |
|---|---|---|
| 单对 $(q,k)$ 打分 | 两次线性变换 + tanh + 一次点积(约 $2d_kd_a$ 次乘加) | $d_k$ 次乘加 |
| n 个词全配对 | 中间要物化 $n\times n\times d_a$ 的隐藏层张量 | 一次 GEMM 搞定:$QK^T$(n×d 乘 d×n) |
| GPU 契合度 | 小算子串联,访存次数多 | 大矩阵乘,吃满 BLAS / Tensor Core |
从实现上看,点乘注意力能直接利用矩阵乘法库,方便批量计算;两种打分方式的具体效果还要看任务和配置。
6.5 MASK:避免看到未来的东西
实现上,把 $QK^T$ 里“未来的位置”加上 $-\infty$(代码里是 $-10^9$)再 softmax,这些位置的权重就精确等于 0。
训练时解码器接收右移后的目标序列,靠掩码让位置 $t$ 只能看到 $1..t$,并行计算各位置的预测;推理时才真的一个词一个词生成。去掉因果掩码,训练就可能直接用到待预测的未来 token,和生成时的条件对不上。
6.6 多头注意力:同一个词的多种观察视角
先投影到低维,学到不同的投影方法,再把结果融合出来:
\[\text{MultiHead}(Q,K,V) = \text{Concat}(\text{head}_1,\dots,\text{head}_h)W^O\] \[\text{head}_i = \text{Attention}\left(QW_i^Q,\ KW_i^K,\ VW_i^V\right)\]多头数值迷你示例:
- 设某词向量是 4 维:$[0.5,-1.2,0.3,2.0]$,头数 $h=2$,每头 $d_h=2$ 维。
- 头 1 拿前两维 $[0.5,-1.2]$,头 2 拿后两维 $[0.3,2.0]$——相当于把同一个词投影到两个不同的“观察子空间”。
- 头 1 在自己的子空间里算出一套注意力(比如专抓“谁指代谁”),头 2 算出另一套(专抓“动词配什么宾语”),各自加权各自的 Value,最后 Concat 回 4 维,再过 $W^O$ 融合。
- 8 个头 × 64 维 = 512:总计算量和单个 512 维大头几乎一样,但换来了 8 种不同的关系视角,相当于为 Transformer 额外提供了一个可训练视角。
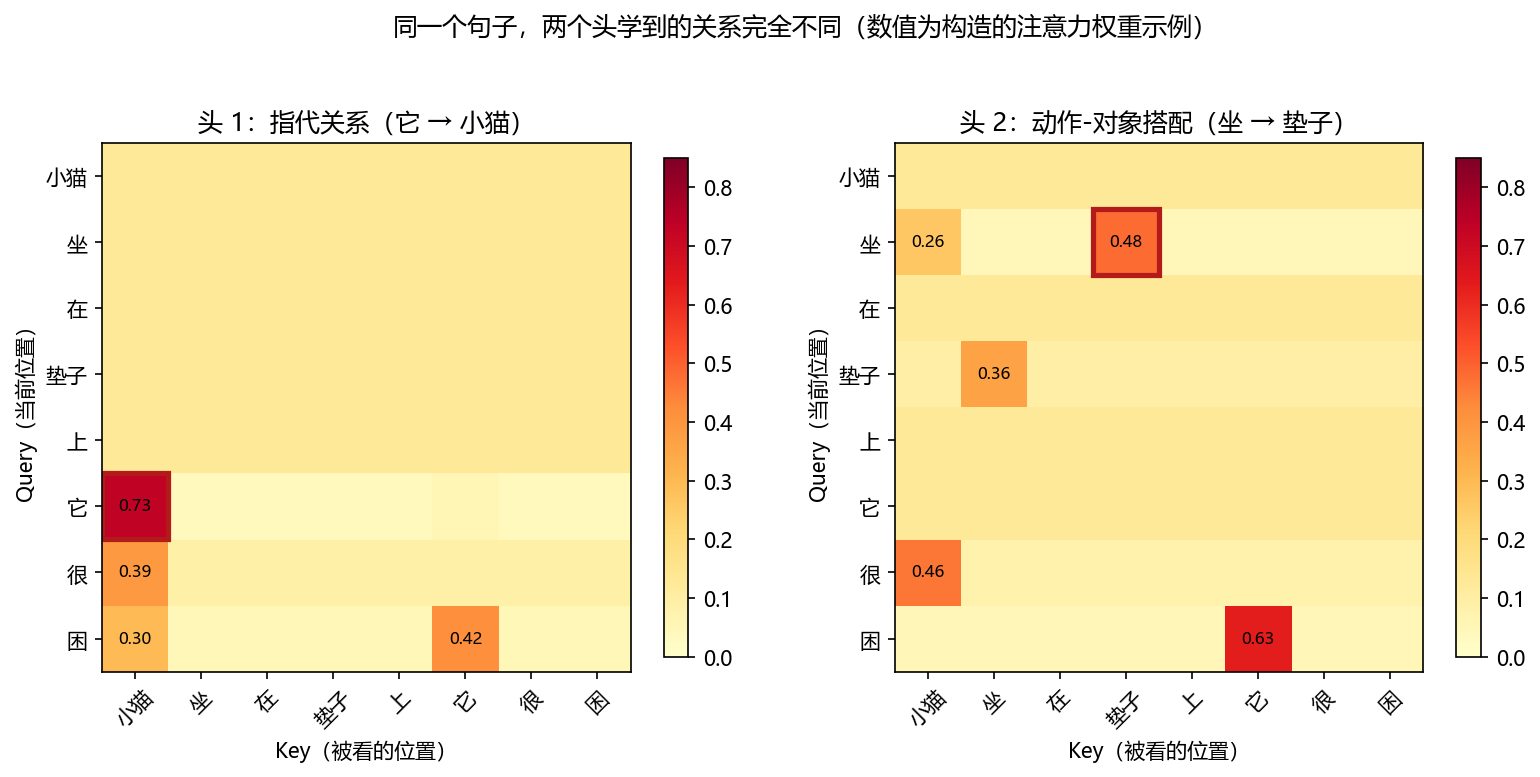
这个示意图怎么读:行 = Query(当前正在更新表示的词),列 = Key(被看的位置),格子值 = 注意力权重,每行和为 1;只给大于 0.25 的格子标了数字,免得太挤。
两个头各自提供了一个视角:
- 头 1(指代):“它”的行 0.73 压在“小猫”上;“很”看“小猫”(0.39)、“困”看“它”(0.42)和“小猫”(0.30)——形容词和谓语都在找自己的主语。
- 头 2(搭配):“坐”的行分给“垫子”0.48、“小猫”0.26(动作找宾语和施事);“困”看“它”(0.63);“垫子”回看“坐”(0.36)。
同一句话、同一层,两个头关注的位置完全不同——这就是“多头 = 多视角”的直观证据。
真实模型里这些数从哪来:$A=\text{softmax}(QK^T/\sqrt{d_k})$,其中 Q、K 是词向量分别乘以该头可学习的 $W^Q$、$W^K$ 之后的产物。“它”的 Query 之所以会和“小猫”的 Key 点出高分,是训练从语料里学出来的;本图相当于“训练成功后权重的理想化快照”。
7. 三种注意力:Q、K、V 分别从哪来
自注意力:Q、K、V 来自同一侧。
整台机器一共就三种接法,区别只在 Q 和 K/V 的来源,下面不妨以中英翻译为例:
| 位置 | Q 来自 | K、V 来自 | 干什么 |
|---|---|---|---|
| 编码器自注意力 | 编码器输入 | 编码器输入(同源) | 每个英文词看全句,互相理解 |
| 解码器掩码自注意力 | 解码器输入 | 解码器输入(同源) | 每个中文词只看已生成的部分 |
| 交叉注意力 | 解码器 | 编码器输出 | 中文词去英文原句上“找对应” |
7.1 交叉注意力:中文 Query 去英文 Key/Value 上取货
下面是第三种注意力的一个注意力分布示意图:
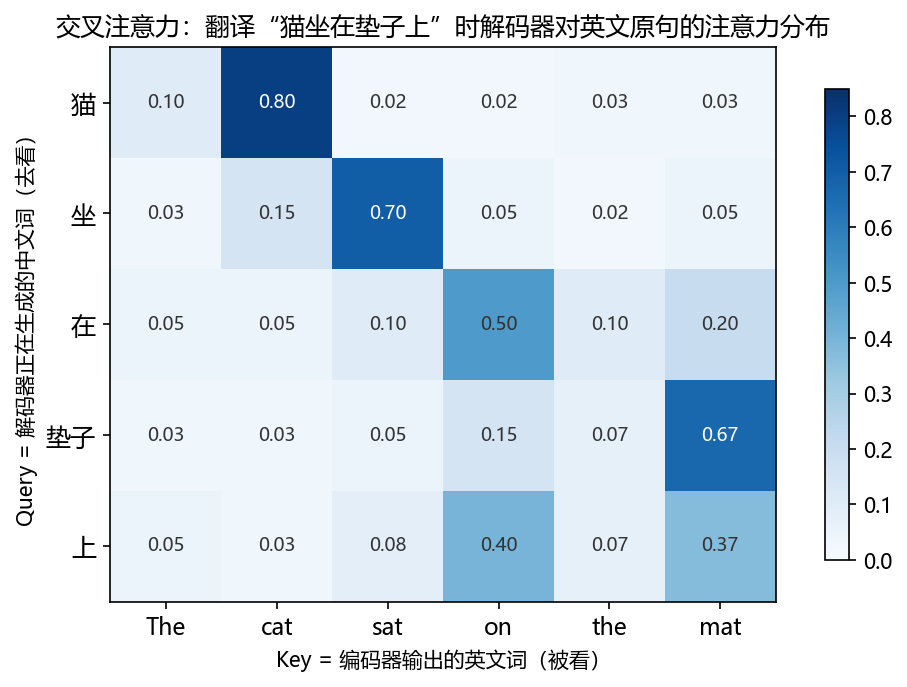
每一行是一个解码器时刻:当前中文词(Query)对 6 个英文词(Key)打分,softmax 后按权重抽取编码器里对应位置的信息。场景是英文原句 The cat sat on the mat 已被编码器读完,解码器正在逐字写出“猫坐在垫子上”,此刻轮到“垫子”。
| 角色 | 概念理解 | 谁提供 | 通俗比喻 |
|---|---|---|---|
| Q 查询 | 生成“垫子”时,需要匹配英文原句中的哪些信息? | 解码器(中文侧) | 当前的问题卡片 |
| K 键 | 各英文词用于匹配的特征,例如 cat、mat 对应的表示 | 编码器输出(英文侧) | 书架上的书脊标签 |
| V 值 | 每个英文词真正携带的语义内容,翻译时要抄的“干货” | 编码器输出(英文侧) | 翻开书后的正文 |
7.2 生成“垫子”的四步
注意:此刻解码器手里只有一段已经生成的序列:[START] 猫坐在,垫子还没出生。
- 打分:当前末位(“在”)的 Q 和 6 个英文词的 K 一一点积,mat 得分最高(0.67),on 其次(0.15)。
- 归一化:softmax 把分数变成权重,权重和为 1。
- 取货:按权重把 6 个英文词的 V 加权混合,打包成“与‘垫子’语义相关”的英文信息包。
- 预测:信息包与“在”位置的表示融合,经输出层在词表上打分——“垫子”得分最高,这才被生成出来。
生成每个中文 token 时,都从英文原句中检索相关信息:Q 表达查询需求,K 提供匹配特征,V 提供被加权汇总的内容。在这个交叉注意力层中,中文侧出 Q,英文侧出 K 和 V。
第 1 步  输入 [START]                    → 预测出“猫”
第 2 步  输入 [START, 猫]                → 预测出“坐”
第 3 步  输入 [START, 猫, 坐]             → 预测出“在”
第 4 步  输入 [START, 猫, 坐, 在]         → 预测出“垫子”   ← 生成“垫子”的时刻
第 5 步  输入 [START, 猫, 坐, 在, 垫子]  → 预测出“上”
7.3 第 4 步的 QKV 分工
- Q:来自当前输入 [START, 猫, 坐, 在] 的最末位置(“在”),语义是“猫坐在___,接下来填什么?”此时,垫子正是要被它问出来的答案。
- K、V:来自编码器对 6 个英文词的输出。
- 参与运算的:中文侧(解码器)的末位 Q + 英文侧(编码器)的 K、V。
一个小思考:中文的 Q 凭什么能和英文的 K 算点积?
两种语言的原始词向量风马牛不相及,但 $W^Q$、$W^K$ 把它们投影到同一个 $d_k$ 维空间。这个公共空间是训练学出来的“语义对齐空间”:语料里“垫子”几乎总和 mat 出现在对齐位置上,梯度就会把“垫子类 Query”和“mat 类 Key”在这个空间里推向相近的方向。
8. FFN:汇聚之后的独立加工
\[\text{FFN}(x)=\max(0,\ xW_1+b_1)W_2+b_2\]为什么 MLP 可以分开独立做?注意力已经做了一次汇聚的过程,各自已经有自己的感兴趣的位置信息,以下是一个简易的示意图,展示 Transformer 与 RNN 的区别,以及为什么 MLP 在 Transformer 里可以各自独立处理。
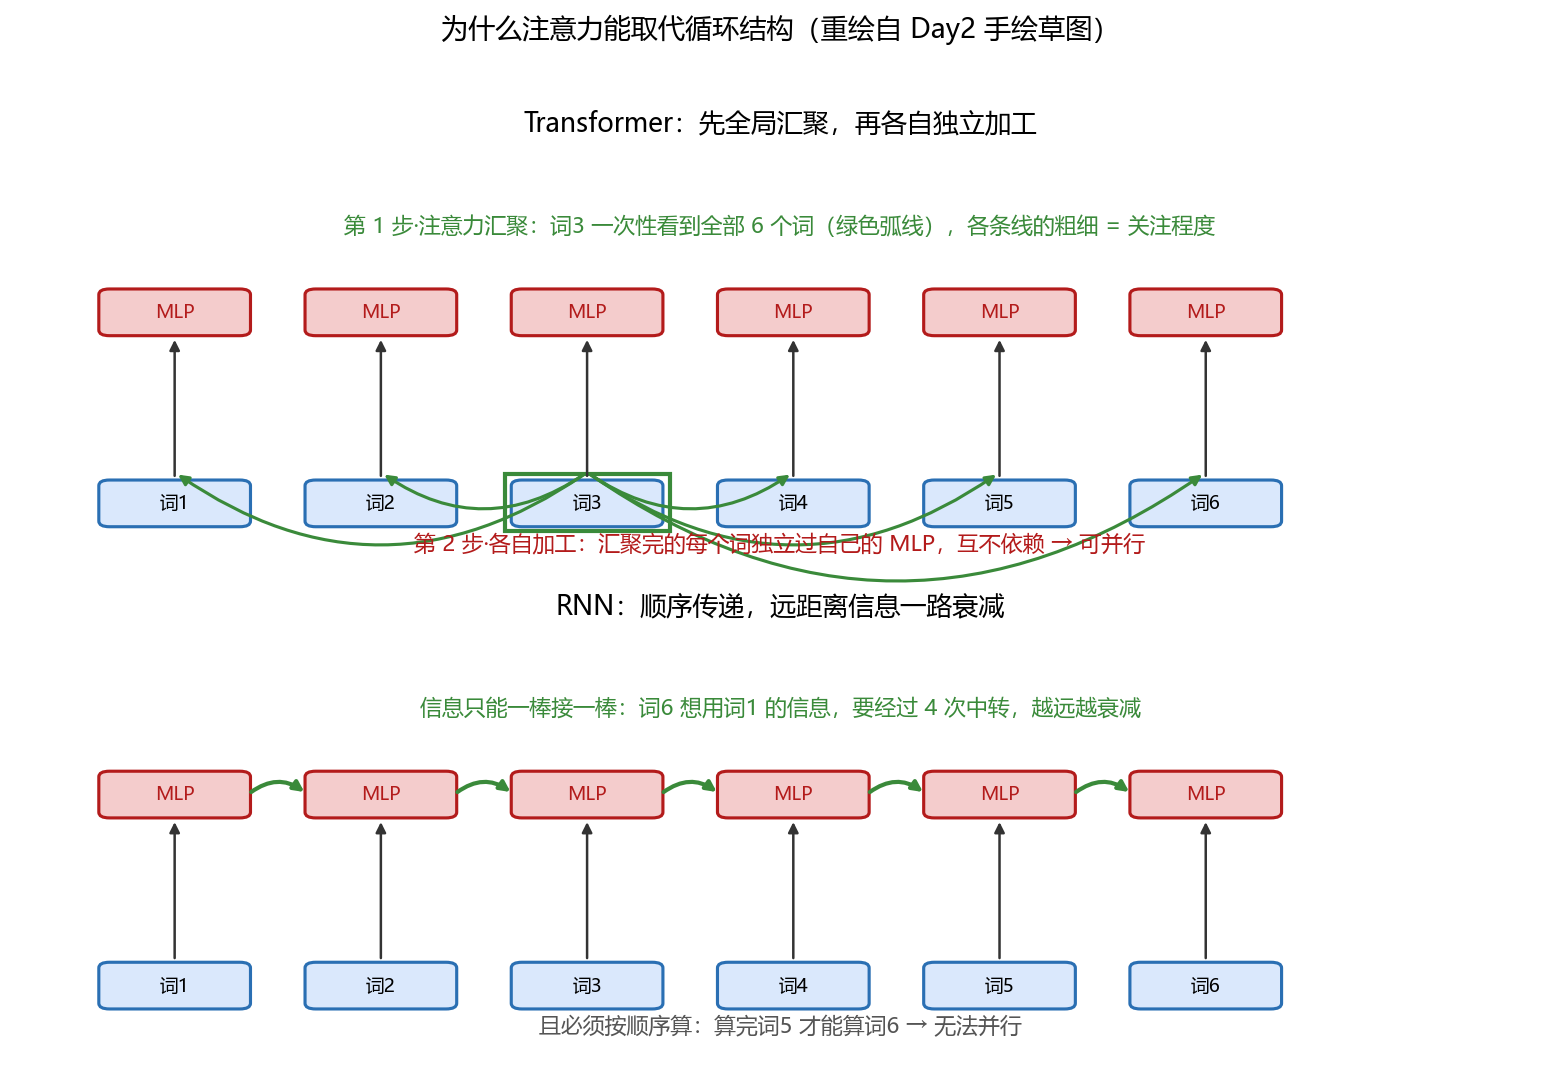
后人对 FFN 的一个有趣解读——两层 MLP 长得像一个巨大的 Key-Value 记忆库:第一层 $W_1$ 是“模式检测器”(Key),第二层 $W_2$ 是“内容库”(Value)。也就是说,注意力在词与词之间做 KV 检索,FFN 在知识层面再做一次 KV 检索——模型的“世界知识”大量被认为存在 FFN 里。
9. 位置编码:给无序的注意力装上顺序感
加入时序信息,是为了防止所有词打乱后结果没有变化。注意力对“顺序”天然失明:把“猫追狗”和“狗追猫”的词集合放在一起,不带位置信息的注意力算出的结果也一样,这在语言里是灾难。所以要把位置做成向量,加到词向量上。
\[PE_{(pos,\ 2i)} = \sin\left(pos / 10000^{2i/d_{model}}\right)\] \[PE_{(pos,\ 2i+1)} = \cos\left(pos / 10000^{2i/d_{model}}\right)\]9.1 这两个公式在做什么
- 把每个位置 $pos$ 映射成一个 512 维“指纹”:不同维度用不同频率的 sin/cos 振荡——低维频率高(像秒针,翻得快),高维频率低(像时针,走得慢)。
- 可以类比二进制计数:最低位 0/1 交替最快,高位慢慢翻。任意一个位置,它的指纹组合独一无二;两个位置的指纹差,还隐含着它们的距离。
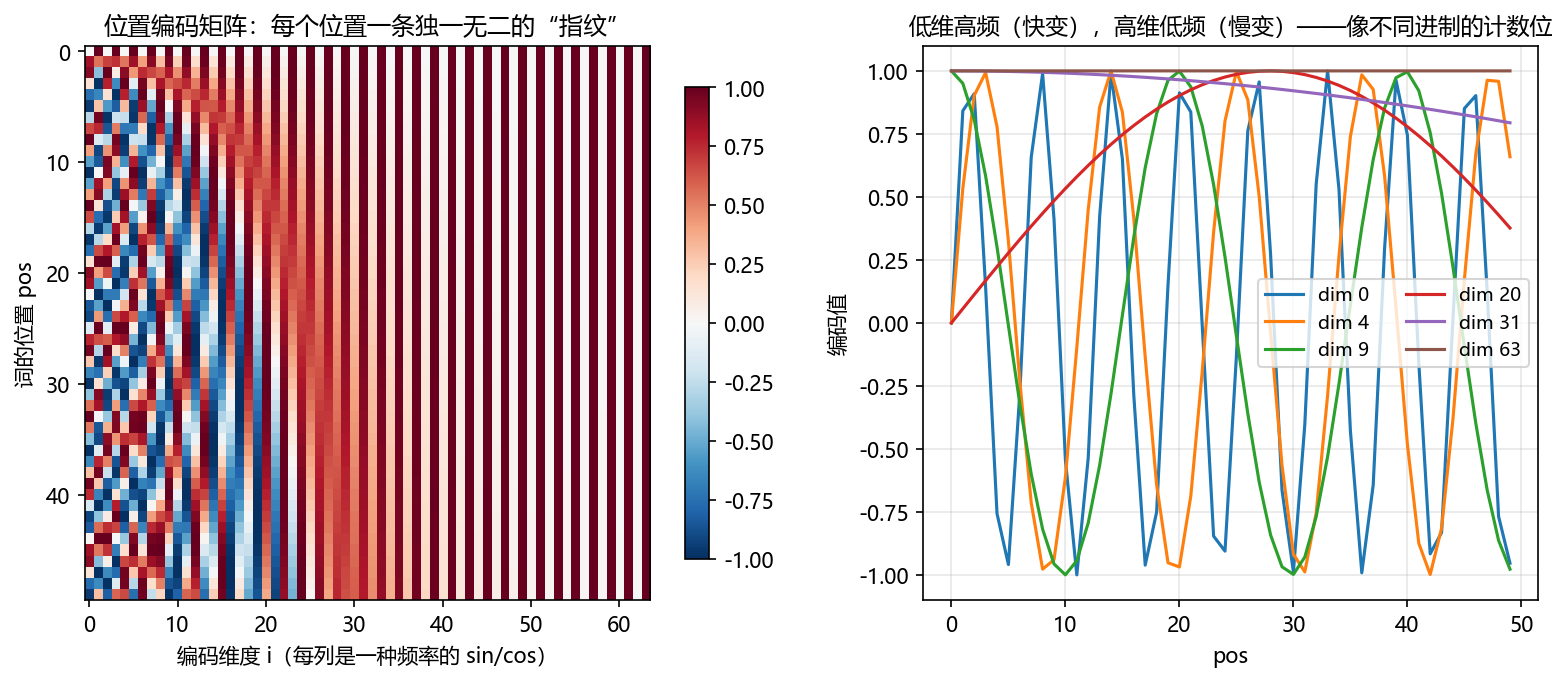
9.2 为什么偏偏选 sin/cos
- 唯一性:不同位置得到不同编码,且值域 $[-1,1]$ 有界,和词向量尺度匹配,不会喧宾夺主。
- 相对位置可学:$\text{PE}(pos+k)$ 可以表示为 $\text{PE}(pos)$ 的线性变换(sin/cos 的旋转性质)。模型想学“右边第 3 个词”这种相对关系时,只需学一个固定的线性映射,非常容易。
- 免训练:不用学参数,直接生成,长句也能外推。
- 论文实测:换成可学习的位置嵌入(BERT 的做法)效果几乎一样,说明重要的是“有位置信息”,而非具体形式。顺带一提,现在主流已换成 RoPE(旋转位置编码)。
10. 复杂度对比
| 层类型 | 每层计算量 | 最少串行步数 | 最大路径长度 |
|---|---|---|---|
| 自注意力 | $O(n^2 \cdot d)$ | $O(1)$ | $O(1)$ |
| 循环 RNN | $O(n \cdot d^2)$ | $O(n)$ | $O(n)$ |
| 卷积 | $O(k \cdot n \cdot d^2)$ | $O(1)$ | $O(\log_k n)$ |
| 自注意力(限窗 $r$) | $O(r \cdot n \cdot d)$ | $O(1)$ | $O(n/r)$ |
这张表把前面关于“速度”和“路径”的讨论压缩成了四个指标:计算量、串行步数、最大路径长度,以及是否能直接并行。
11. 多看不如多做:用简单的实验跑通流程,从中观察数据如何变化,并给出解释
纸上得来终觉浅。前面讲了很多 QKV 的道理,这次直接用 NumPy 造一个最小可训练的注意力模型(无任何框架),跑通“前向 → 反向 → 更新”的完整循环,盯着数据一步步变化,最后反过来读权重。
实验设置:任务 [<pad>, 主语, 很] → 属性(小猫→困 / 垫子→软 / 月亮→亮);模型 = 词嵌入(固定查表)+ 单头自注意力 + 输出层,可训练参数只有 $W_Q/W_K/W_V/W_{OUT}$ 四组($D=8$);训练 300 轮,学习率 $lr=0.5$。
实验问题:为了预测属性,位置 2(“很”)的注意力是否会集中到主语?下面同时观察预测结果与注意力权重。
11.1 核心代码
下面是为了看清数据流而截取的核心代码;参数初始化、词表和 batch 组装省略,完整实现可在文末下载。
import numpy as np


def softmax(x):
    x = x - x.max(axis=-1, keepdims=True)    # 数值稳定:先减去最大值
    e = np.exp(x)
    return e / e.sum(axis=-1, keepdims=True)


def forward(ids):
    X = E[ids]                               # 查词嵌入表(固定不训)
    Q, K, V = X @ W_Q, X @ W_K, X @ W_V      # 同一个 X 的三种投影
    S = Q @ K.T / np.sqrt(D)                 # 打分 + 除以 sqrt(D) 防饱和
    A = softmax(S)                           # 每行归一化 = 注意力权重
    O = A @ V                                # 按权重取货
    h = O[-1]                                # 只取位置 2 的信息包
    logits = W_OUT @ h + B_OUT               # 词表打分
    p = softmax(logits)                      # 概率;loss = -log p[正确词]
    return {"X": X, "Q": Q, "K": K, "V": V,
            "S": S, "A": A, "O": O, "h": h,
            "logits": logits, "p": p}


def backward(cache, tgt):                    # 手推反向(数值梯度已验证)
    X, Q, K, V = cache["X"], cache["Q"], cache["K"], cache["V"]
    A, h, p, O = cache["A"], cache["h"], cache["p"], cache["O"]
    target = np.zeros_like(p); target[tgt] = 1
    dlogits = p - target                     # CE + softmax 的极简形式
    dW_OUT = np.outer(dlogits, h)
    dB_OUT = dlogits
    dh = W_OUT.T @ dlogits
    dO = np.zeros_like(O)
    dO[-1] = dh                              # 只有位置 2 连着 loss
    dV = A.T @ dO
    dA = dO @ V.T
    dS = A * (dA - (dA * A).sum(axis=1, keepdims=True))
    dQ = dS @ K / np.sqrt(D)
    dK = dS.T @ Q / np.sqrt(D)
    return {
        "W_Q": X.T @ dQ,
        "W_K": X.T @ dK,
        "W_V": X.T @ dV,
        "W_OUT": dW_OUT,
        "B_OUT": dB_OUT,
    }


# 训练循环(完整程序会在这里执行 300 轮)
for step in range(300):
    grads = {name: np.zeros_like(param) for name, param in params.items()}
    for ids, target_id in batch:
        cache = forward(ids)
        loss = -np.log(cache["p"][target_id])
        sample_grads = backward(cache, target_id)
        for name in grads:
            grads[name] += sample_grads[name]
    for name in params:
        params[name] -= lr * grads[name] / len(batch)  # 平均梯度更新
完整的可运行代码可在文末下载。这里保留的是最能体现计算链路的核心片段。
11.2 前向与反向的路径
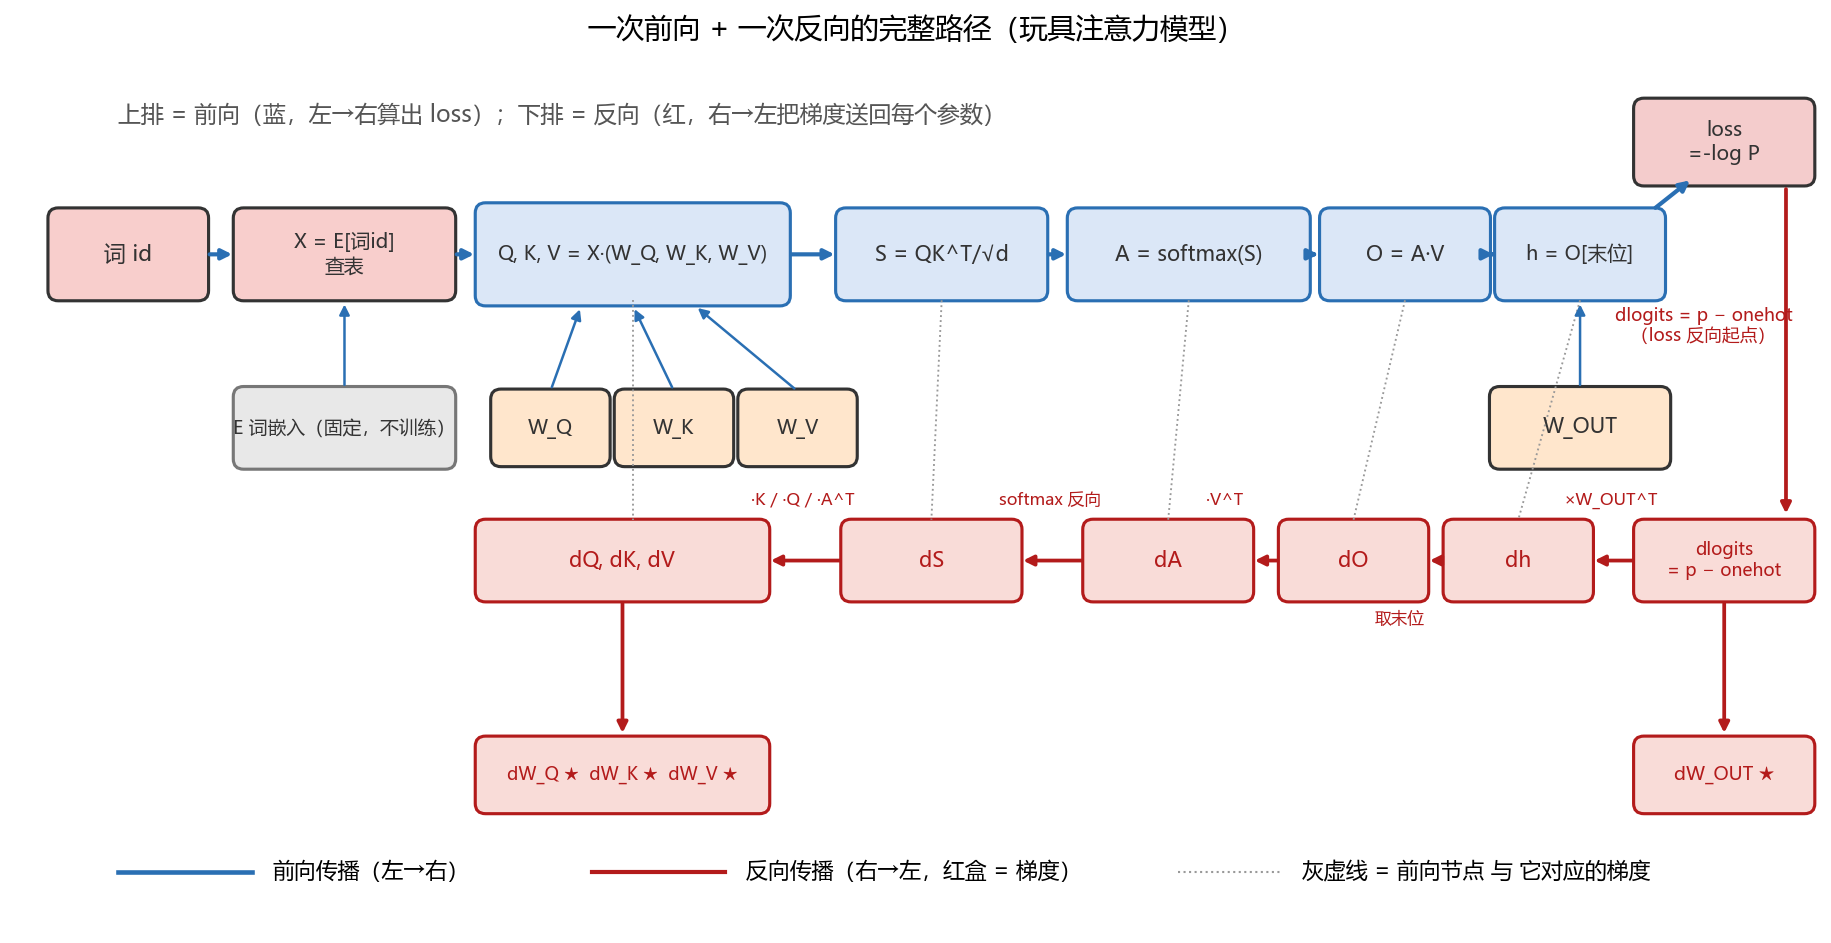
读图时可以把它分成上下两排:上排是前向,从词 id 算到 loss;下排是反向,梯度从 loss 沿原路返回。每个参数盒收集自己的 $dW$,随后执行 W -= lr·dW。E 是固定的,所以没有梯度流过。
11.3 数据如何变化:loss 与正确词概率
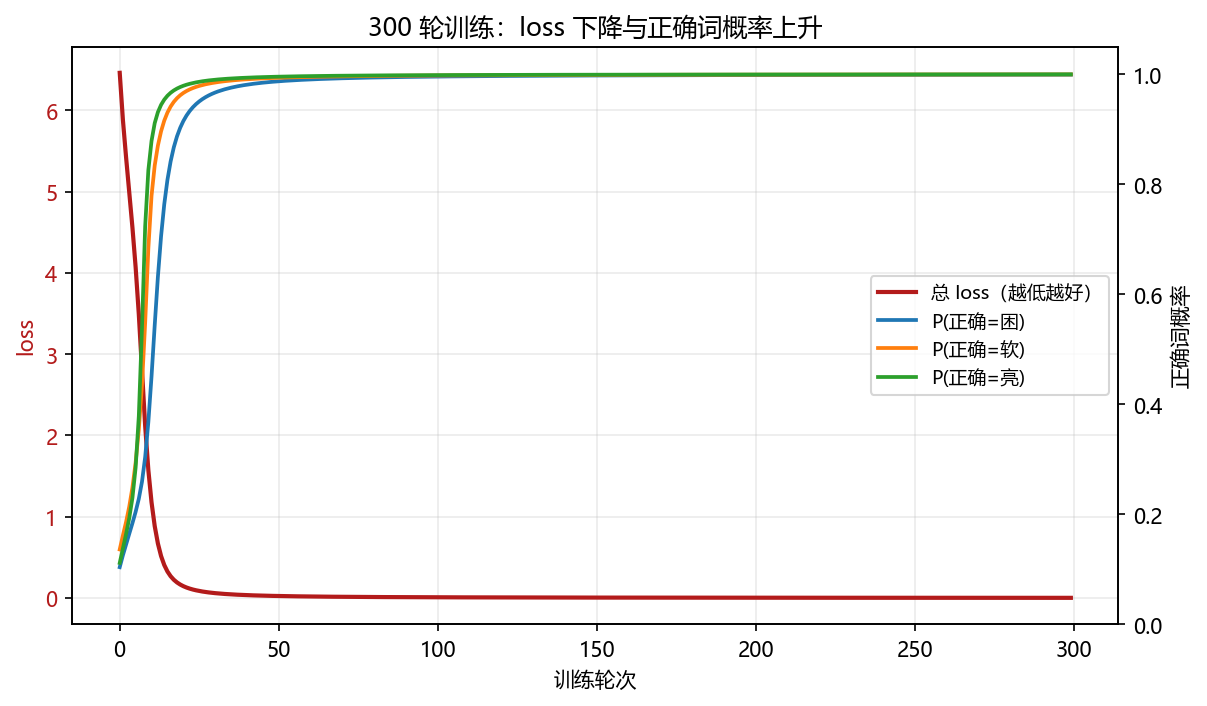
观察:loss 从 6.46 降到 0.002;三个正确词概率在前 10 轮内快速上升,50 轮后逼近 1。
解释:前期骤降主要靠输出层 $W_{OUT}$ 先把 logits 摆正,见效快;注意力参数是慢热型,这也是两次版实验里 $\lVert \mathrm{grad}(W_{OUT}) \rVert$ 远大于 $\lVert \mathrm{grad}(W_Q) \rVert$ 的原因。
11.4 训练后的注意力落在哪里
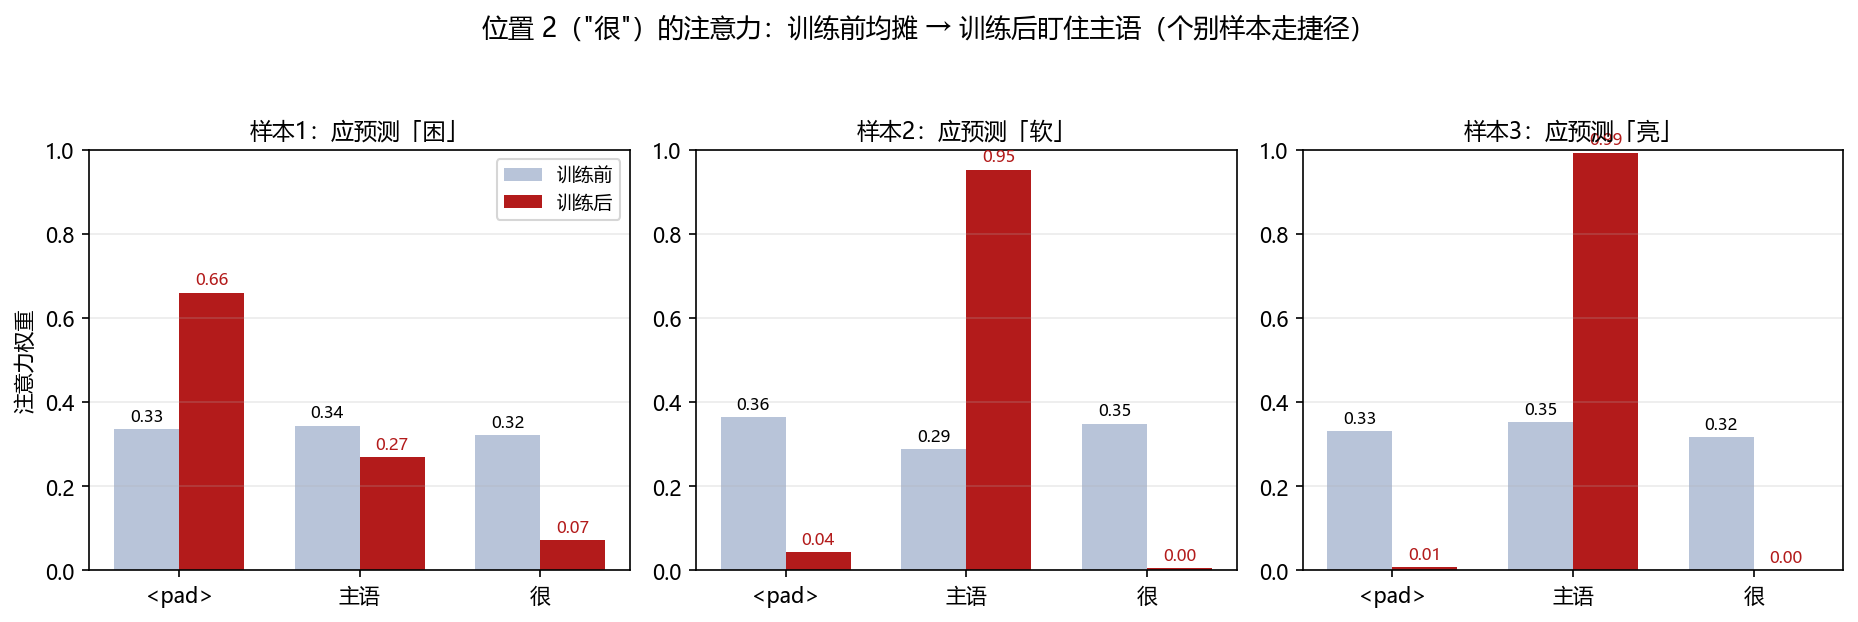
训练前三处接近均摊(约 0.33);训练后的位置 2 注意力如下。表中箭头左侧是训练前,右侧是训练后:
| 样本 | <pad> |
主语 | 很 |
|---|---|---|---|
| 小猫→困 | 0.335 → 0.660 | 0.344 → 0.268 | 0.321 → 0.072 |
| 垫子→软 | 0.364 → 0.044 | 0.288 → 0.952 | 0.348 → 0.005 |
| 月亮→亮 | 0.331 → 0.007 | 0.352 → 0.992 | 0.317 → 0.001 |
垫子和月亮这两条样本的权重集中到了主语,小猫这条却更多落在 <pad> 上,三条样本并未表现出相同模式。最终预测由注意力权重、Value 和输出层共同计算,不能只凭最大的注意力权重解释。
11.5 最终权重的含义:3×3 对齐矩阵
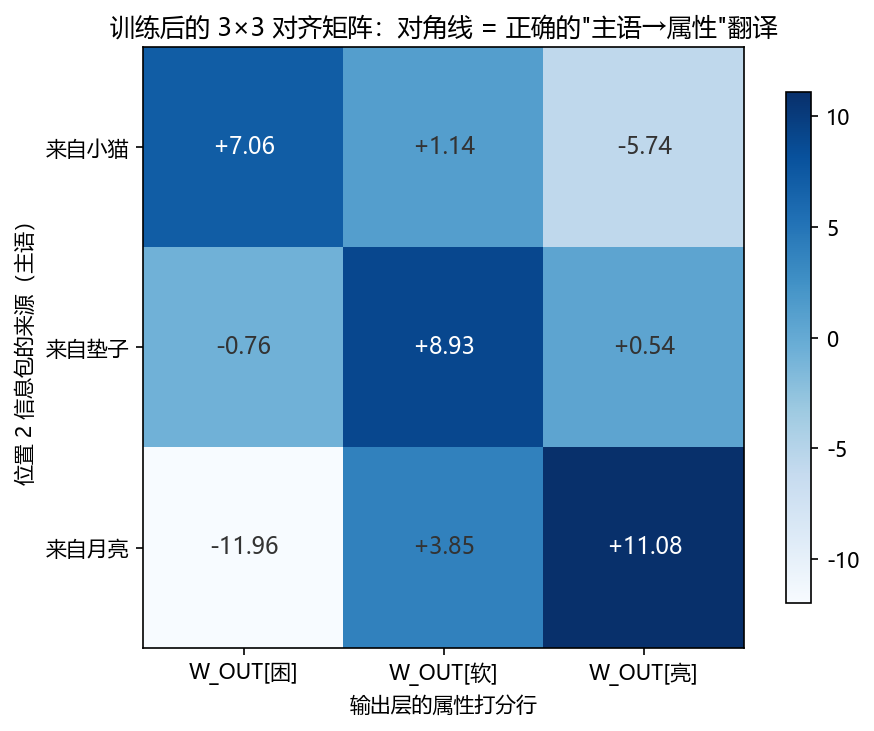
解读:对角线(小猫→困 +7.06、垫子→软 +8.93、月亮→亮 +11.08)全面碾压非对角线。$W_{OUT}$ 学会了把“主语内容”翻译成“正确属性”,模型答对的机制就在这张表里。
11.6 小猫这条样本为什么不一样
发现一:样本 1 走了捷径。
它把 0.66 的注意力放在 <pad> 上,主语还有 0.268,最终 $P(困)$ 仍达到 0.999。正确预测并不要求注意力全部集中在主语上:训练优化的是预测损失,没有额外约束注意力的形状。是否依赖某条捷径,需要通过改变输入或屏蔽位置来检查。
发现二:输出层先动,注意力慢热。
两次版实验里 $\lVert \mathrm{grad}(W_{OUT}) \rVert$ 远大于 $\lVert \mathrm{grad}(W_Q) \rVert$。输出层先把候选词的分数关系摆正,注意力模式则需要更多轮次才稳定下来;真实训练也会出现这种分层收敛。
发现三:早期抖动是正常的。
样本 1 的注意力早期先往 <pad> 偏,不一定代表反向传播写错了。这里的梯度是 batch 中三个样本共同贡献的结果,样本之间会互相拉扯;多训练几步后,整体方向才会逐渐稳定。
发现四:零样本泛化会失败。
换一个训练中没有出现的新主语(比如“石头”),模型就可能懵掉。因为本实验的词嵌入是固定随机数,“石头”没有学到与属性对应的表示。
11.7 实验结果与解释范围
这个单头模型把三条训练样本的属性预测对了,其中两条的注意力明显集中到主语,另一条用了不同的混合权重。训练过程展示了 Q、K、V 的参数变化如何影响注意力权重与最终输出。
多头会给模型多组投影和混合方式。这三个样本展示了权重如何随训练变化,还不足以把某个头定义为“指代头”或“属性头”。
12. 收工小结
- 一个公式:$\text{softmax}(QK^T/\sqrt{d_k})V$——QK 管看哪里,V 管看到什么(根据问题和索引,查阅到具体内容,然后汇总),$\sqrt{d_k}$ 能做到不让 softmax 饱和。
- 三个位置三种接法:编码器自注意力、解码器掩码自注意力、交叉注意力,Q 与 K、V 的来源是唯一区别。
- 两组配角:残差 + LayerNorm 保证训练的稳定性,位置编码纠正注意力的顺序感;FFN 在注意力汇聚后逐位置消化信息(区别 RNN 的传递性,各自独立)。
- 代价:$O(n^2)$ 的计算与显存——这是 Transformer 的软肋。
附 · 资料下载
本篇配套的 300 轮注意力实验代码,以及用于回顾的 CNN / RNN 基础笔记,可直接下载。
300 轮注意力实验
- generate_walkthrough.py:训练 300 轮并生成训练过程拆解
CNN / RNN 基础笔记
- [07卷积神经网络.md](https://github.com/Redmoon-2333/Redmoon-2333.github.io/releases/download/day2-assets/07%E5%8D%B7%E7%A7%AF%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C.md)
- [08循环神经网络.md](https://github.com/Redmoon-2333/Redmoon-2333.github.io/releases/download/day2-assets/08%E5%BE%AA%E7%8E%AF%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C.md)